3
 分享
引言Introduction
GO富集分析是转录组和差异基因研究里的基础步骤,但很多人卡在两点。一是代码流程不熟,二是零代码工具只会点,却不知道参数怎么调。 结果就是,分析能跑出来,结论却不够稳。
1. 为什么GO富集分析不只是“跑出结果”
1.1 GO分析的核心不是图,而是解释能力
GO富集分析本质上是在回答一个问题。你的基因集,是否在某些生物学过程、细胞组分或分子功能上“聚得更密”。
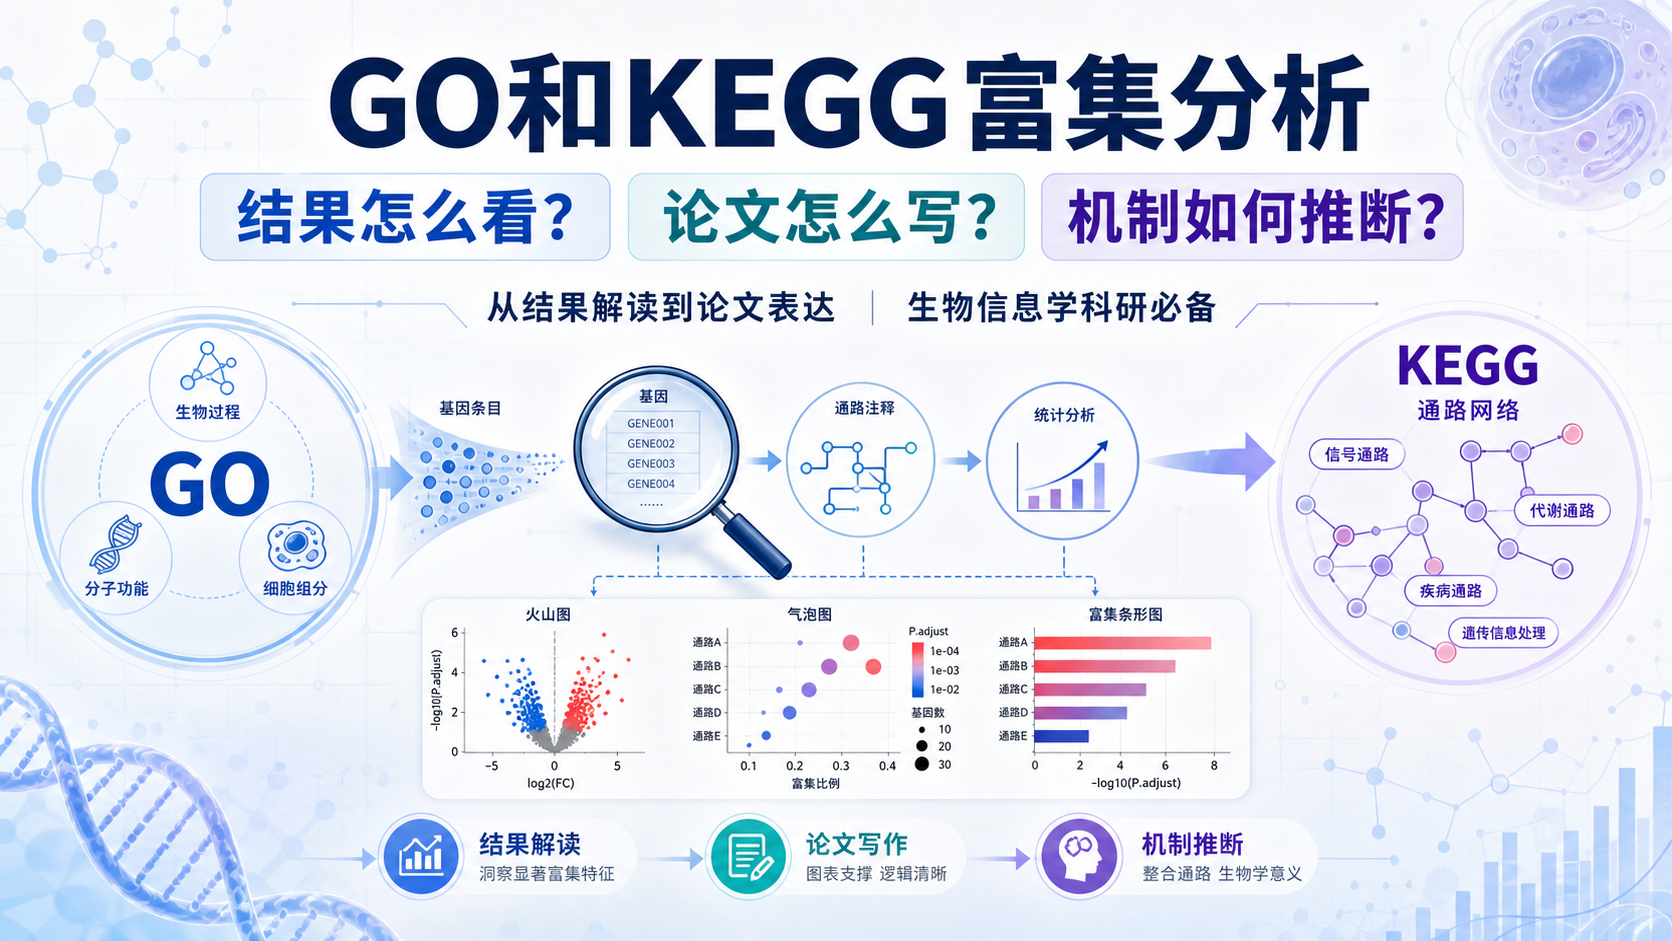
GO分为BP、CC、MF三大类。
- BP,Biological Process,生物学过程。
- CC,Cellular Component,细胞组分。
- MF,Molecular Function,分子功能。
很多初学者只看P值。其实还要同时看基因数、背景集、校正方法和条目层级。否则容易出现“显著但不解释问题”的结果。
1.2 结果可信,取决于输入和参数
GO富集分析代码能不能跑通,不是关键。关键是输入基因ID是否统一,背景集是否合理,阈值是否设置得一致 。
常见问题包括:
- 基因ID类型混乱,Symbol和Entrez混用。
- 背景集直接用全基因组,忽略检测到的表达背景。
- 多重检验校正后,显著条目大幅减少。
- 条目过多,图很好看,但结论没有焦点。
如果你做的是RNA-seq差异表达分析,建议优先用检测到的表达基因作为背景,而不是默认全库。这样更接近真实实验条件。
2. 手搓GO富集分析代码的高阶思路
2.1 代码流程要先清楚,再谈美化
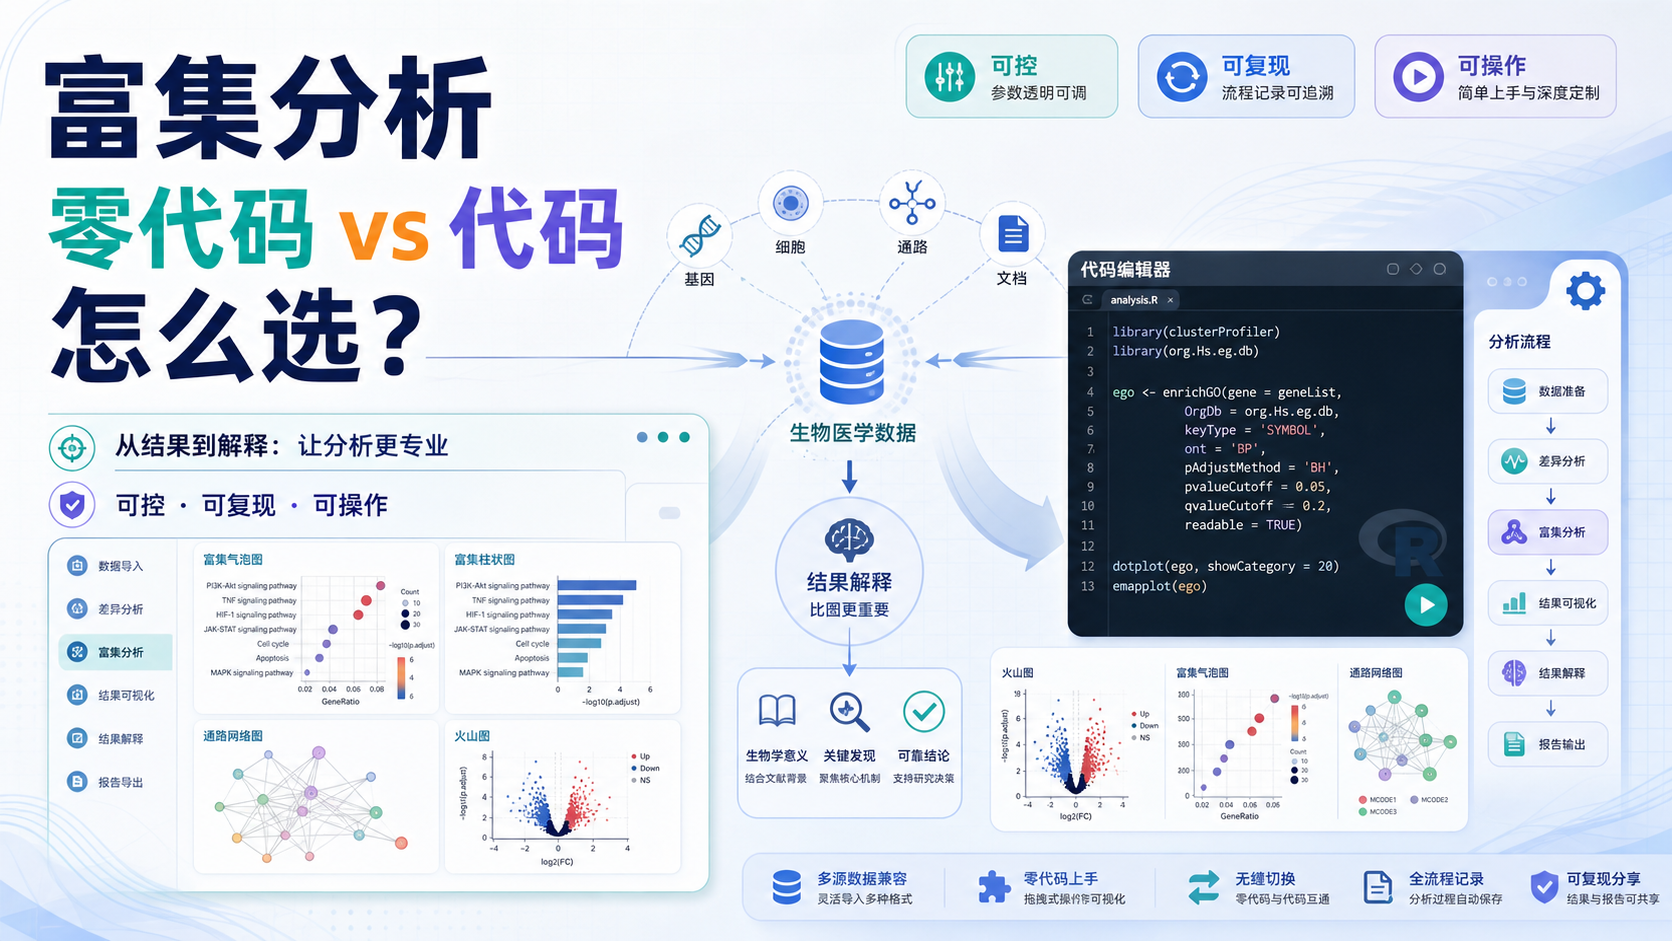
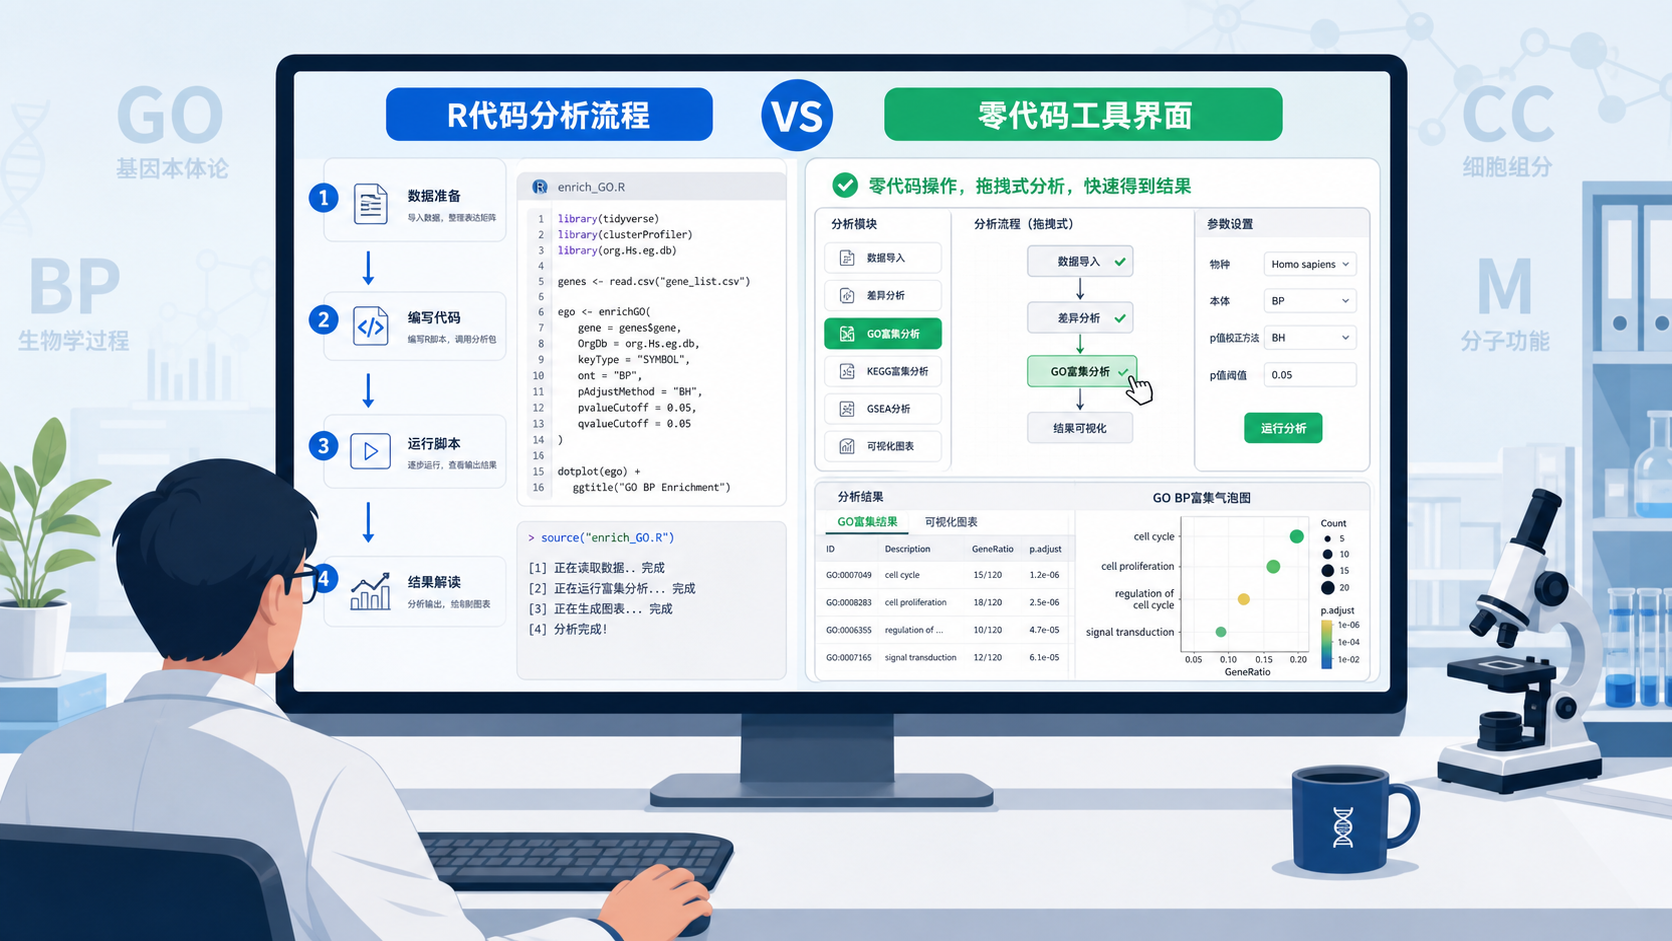
手搓代码最大的价值,不只是“可重复”,而是可控 。你可以精确控制每一步的参数,而不是被界面默认值带着走。
一个标准流程通常包括:
- 准备差异基因列表。
- 统一基因ID。
- 选择注释数据库。
- 执行富集检验。
- 做多重校正。
- 导出表格和图形。
如果用R语言,常见工具是 clusterProfiler、org.Hs.eg.db、enrichplot。如果是Python,也可以通过相关生物信息学库或调用外部接口实现,但在GO分析场景里,R生态仍然更成熟。
2.2 代码分析时最该关注的4个参数
真正决定结果质量的,不是语法,而是参数。
重点看这4类:
pvalueCutoff:原始P值阈值。p.adjust:校正后P值阈值,通常更重要。qvalueCutoff:控制假发现率。minGSSize和maxGSSize:控制基因集大小,避免过小或过大的条目干扰结果。
经验上,基因集太小会导致波动大,太大又容易变得“泛化”。所以参数不是越严格越好,而是要和你的样本量、差异基因数量匹配。
2.3 结果解读要避开两个误区
第一个误区是只盯着Top 10条目。
Top条目未必最重要,可能只是注释最充分。
第二个误区是把GO当成机制终点。
GO更像是线索筛选工具,提示你后续要去做:
- 通路验证。
- 基因表达热图。
- 蛋白水平验证。
- 实验功能验证。
也就是说,GO富集分析代码不是结论本身,而是把研究问题收窄的工具。
3. 零代码GO富集分析为什么更适合高频场景
3.1 零代码不是低阶,而是效率优先
很多人把零代码理解成“不会编程”。这个理解太窄。对医学生、医生和科研人员来说,零代码更像是把重复劳动标准化 。
比如像解螺旋这类工具,核心价值不是替代专业判断,而是让你在短时间内完成规范化分析。对高频场景尤其有用:
- 毕设初筛。
- 课题预分析。
- 多批次样本对比。
- 结果展示和汇报。
会手搓代码的人,用零代码会更快。 因为他们知道自己在看什么,也知道哪里需要修正。
3.2 仙桃式零代码流程的关键步骤
以功能聚类中的GO分析为例,流程通常很直接:
- 进入功能聚类模块。
- 点击GO分析。
- 按格式上传基因ID。
- 支持批量粘贴或Excel导入。
- 点击确认,系统自动输出BP、CC、MF结果。
- 保存记录名称,后续可在结果页查看图表。
这类流程的优势在于,你不必每次重复写代码、装包、调环境。 特别是多人协作时,标准化流程能减少沟通成本。
3.3 零代码与代码不是对立关系
真正成熟的分析策略,不是“只用代码”或“只用零代码”,而是两者配合。
建议这样分工:
- 探索阶段,用零代码快速筛选方向。
- 深入阶段,用代码精细控制参数。
- 汇报阶段,用标准化图形快速输出。
这比单纯追求一种工具更稳。因为科研的目标不是展示工具水平,而是拿到可信结论。
4. 高阶玩家如何把两种方式结合起来
4.1 先用零代码验证思路,再用代码做精修
如果你的目标是发表文章或做课题汇报,建议先用零代码跑一版GO分析,确认差异基因大方向是否合理。然后再回到代码环境中,重新检查:
- 背景基因集。
- 注释版本。
- 校正方法。
- 条目筛选阈值。
这样做的好处是,既保留速度,又保留可解释性。
4.2 图表不要只看漂亮,要看信息密度
GO分析结果常见图形有柱状图、气泡图、条形图。图形越花,不代表越好。
判断标准应该是:
- 是否能看出条目层次。
- 是否能区分显著性和基因数。
- 是否适合论文排版。
- 是否能支撑你的主要结论。
如果一张图上塞了太多条目,读者很难抓住主线。建议保留最相关的条目,通常10到20个以内更利于阅读。
4.3 结果保存和复现同样重要
很多人只关注“跑出来了没有”。但科研里更重要的是“下次能不能复现”。
规范做法包括:
- 记录输入基因版本。
- 记录数据库版本。
- 记录阈值参数。
- 记录分析日期。
- 记录导出文件名。
这一步对文章审稿和课题答辩都很关键。 因为一旦别人问你结果怎么来的,你能清楚说出每个环节。
5. 面向实际研究的建议
5.1 医学生和初学者怎么入门
如果你刚接触GO富集分析代码,不要一开始就追求全流程手写。先理解下面三件事:
- 你的输入是什么。
- 你的背景是什么。
- 你的显著性标准是什么。
把这三点搞清楚,再去看代码,效率会高很多。否则容易陷入“会复制,不会解释”的状态。
5.2 科研人员怎么提高分析效率
对于课题组和平台型工作,最有效的方式是建立统一模板。
模板里应该固定:
- 基因ID格式。
- 物种数据库。
- 统计阈值。
- 输出图形规范。
- 结果命名规则。
这样一来,零代码工具可以负责快速出图,代码流程负责深度控制。两者互补,效率会明显提升。
5.3 解螺旋的价值在于把流程变简单
对于需要频繁做GO富集分析的人来说,最大的痛点不是“不会分析”,而是分析流程太碎,重复操作太多 。解螺旋的思路就是把这类重复环节标准化,让你更快拿到能解释的结果。
如果你已经会手搓代码,可以用它做快速验证和结果整理。如果你正处在入门阶段,也可以借助它先跑通流程,再回头理解参数和原理。这比单纯死磕语法更高效。
总结Conclusion
GO富集分析代码的价值,在于精细控制。零代码工具的价值,在于快速落地。对医学生、医生和科研人员来说,最优解通常不是二选一,而是把两种方式结合起来,先快后稳,先验证再精修。
如果你希望减少重复劳动,同时保留专业分析的可控性,可以试试解螺旋。 它更适合把GO分析、结果保存和图形输出整合到一个更高效的工作流里,帮助你把时间花在真正重要的解释和验证上。
- 引言Introduction
- 1. 为什么GO富集分析不只是“跑出结果”
- 2. 手搓GO富集分析代码的高阶思路
- 3. 零代码GO富集分析为什么更适合高频场景
- 4. 高阶玩家如何把两种方式结合起来
- 5. 面向实际研究的建议
- 总结Conclusion