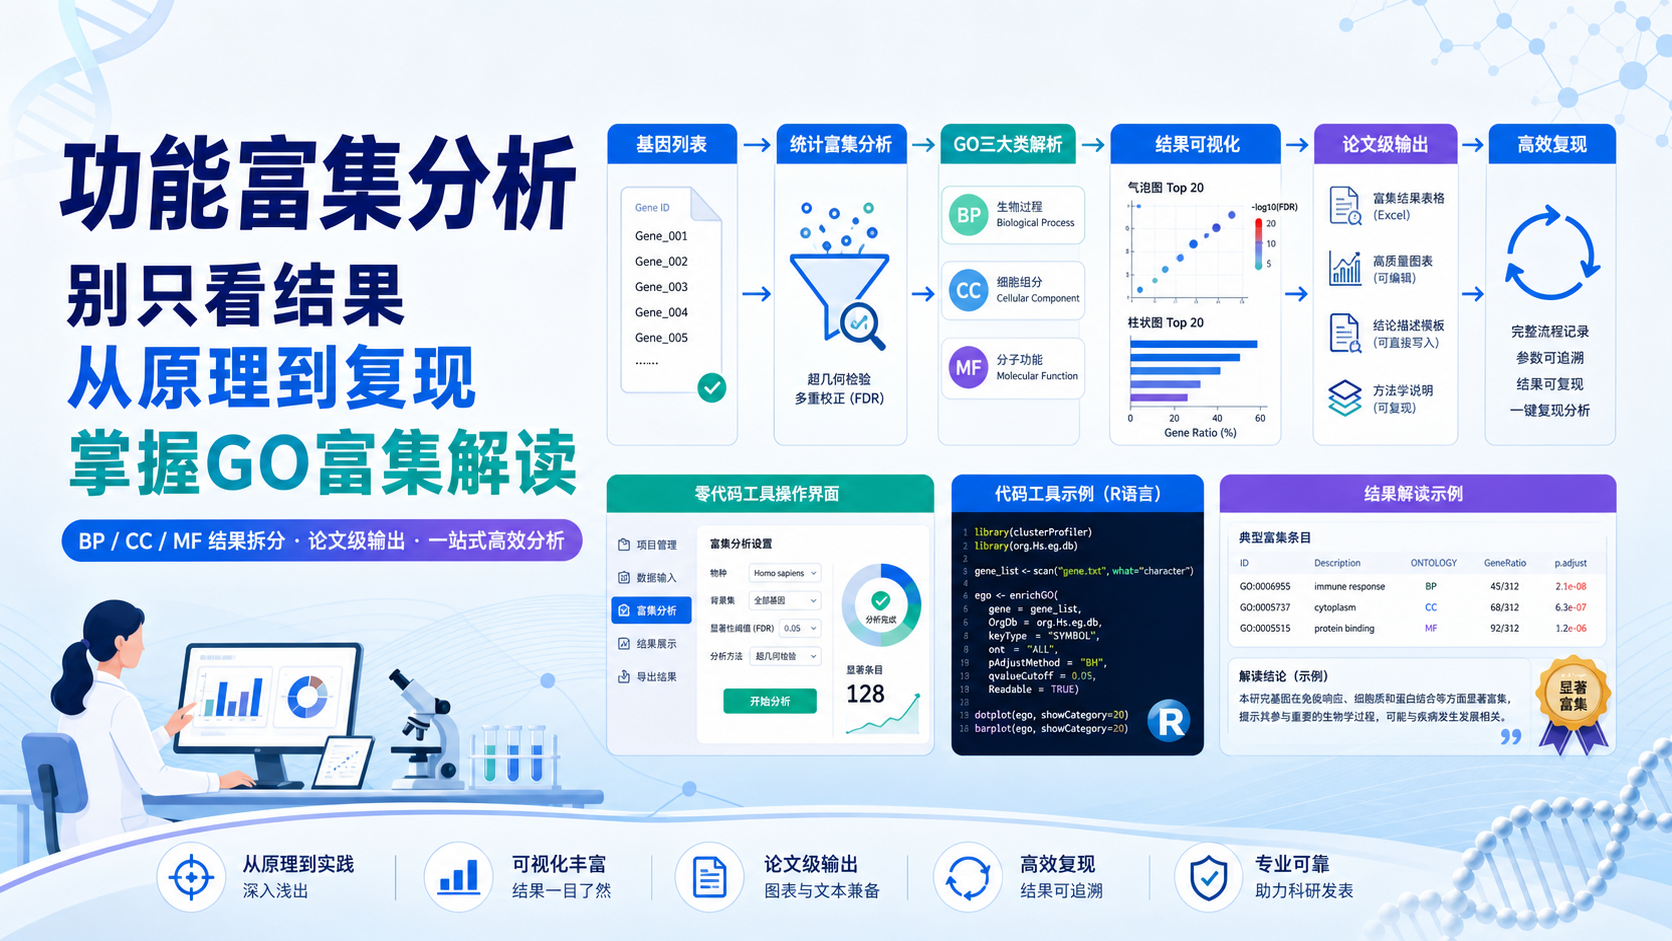
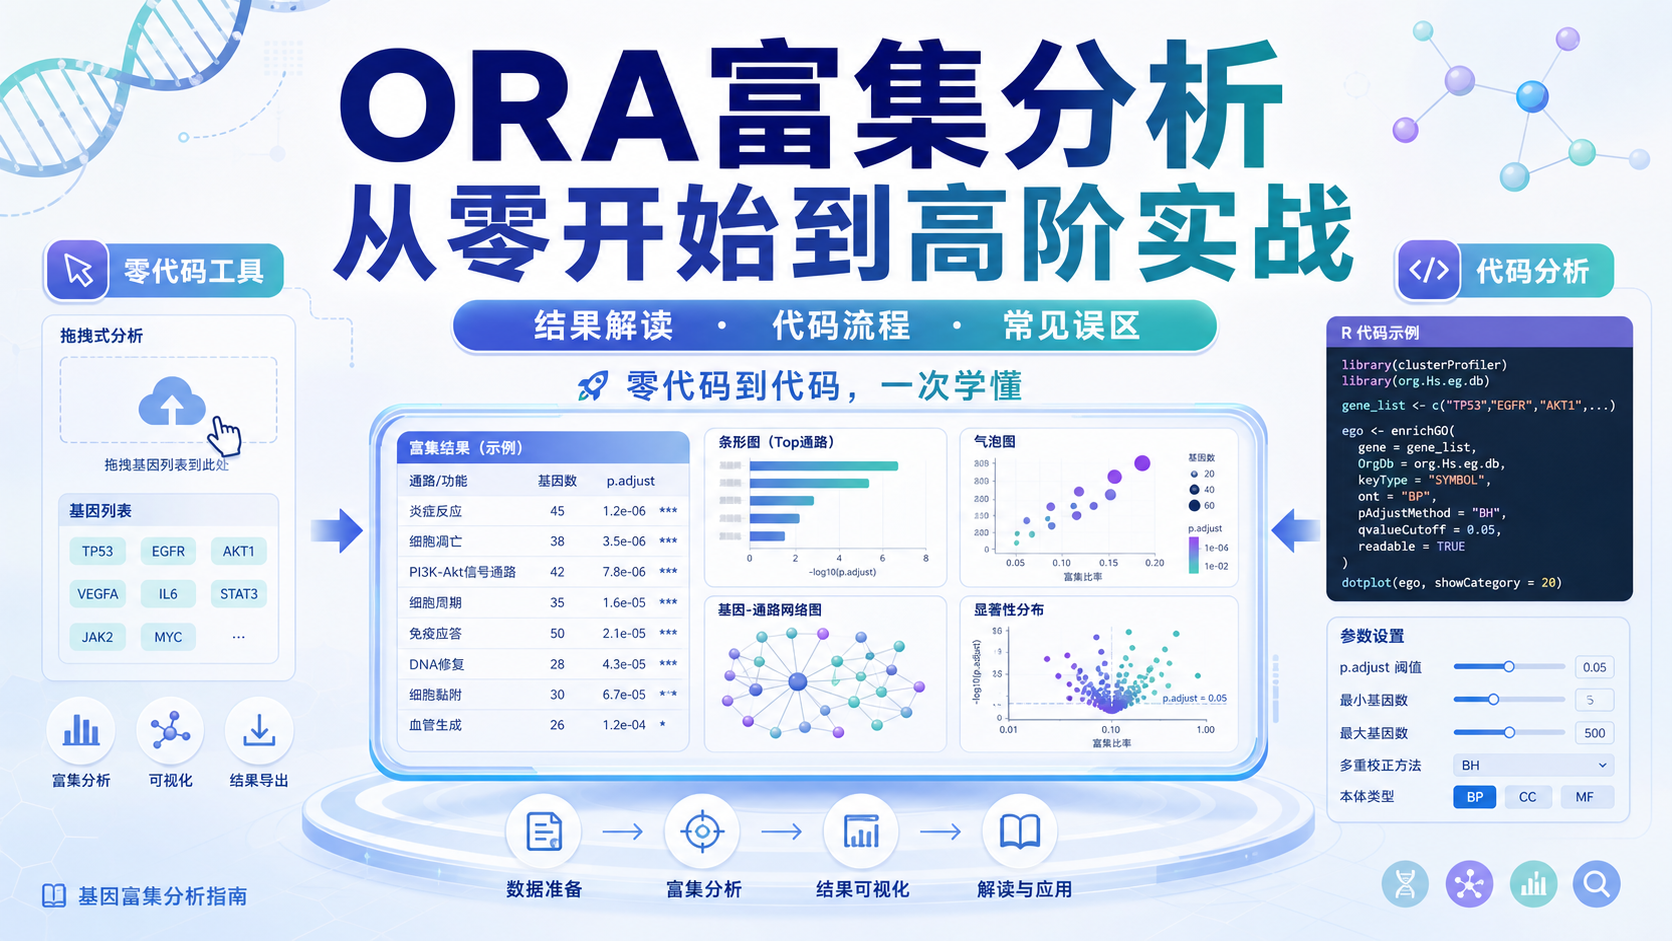
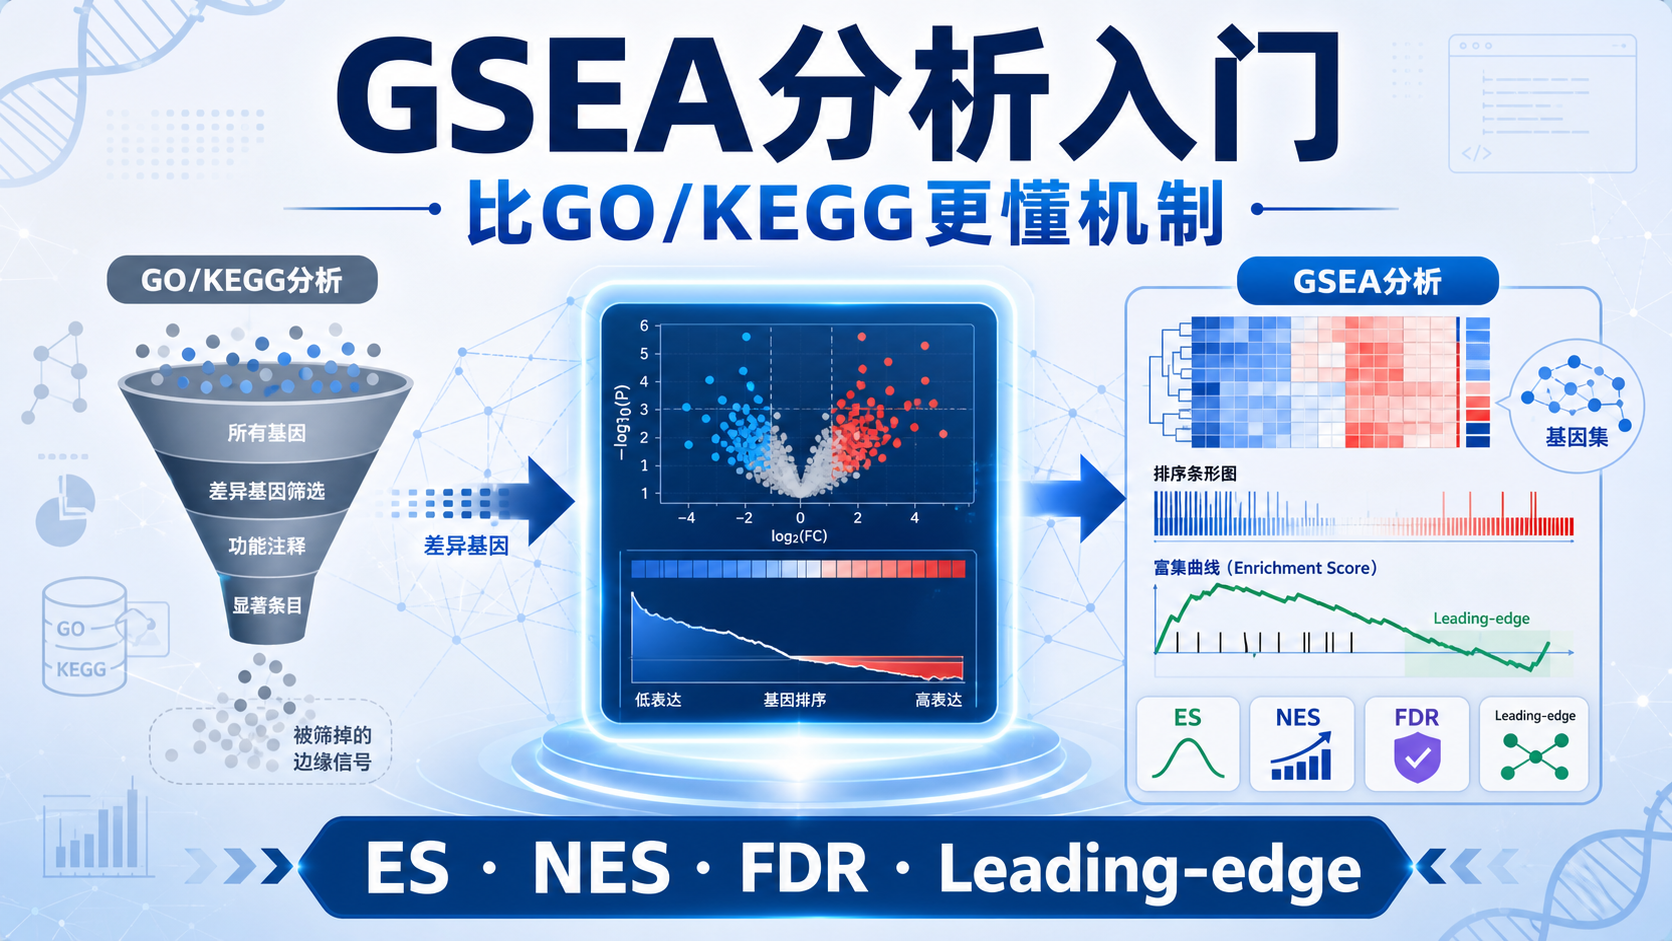
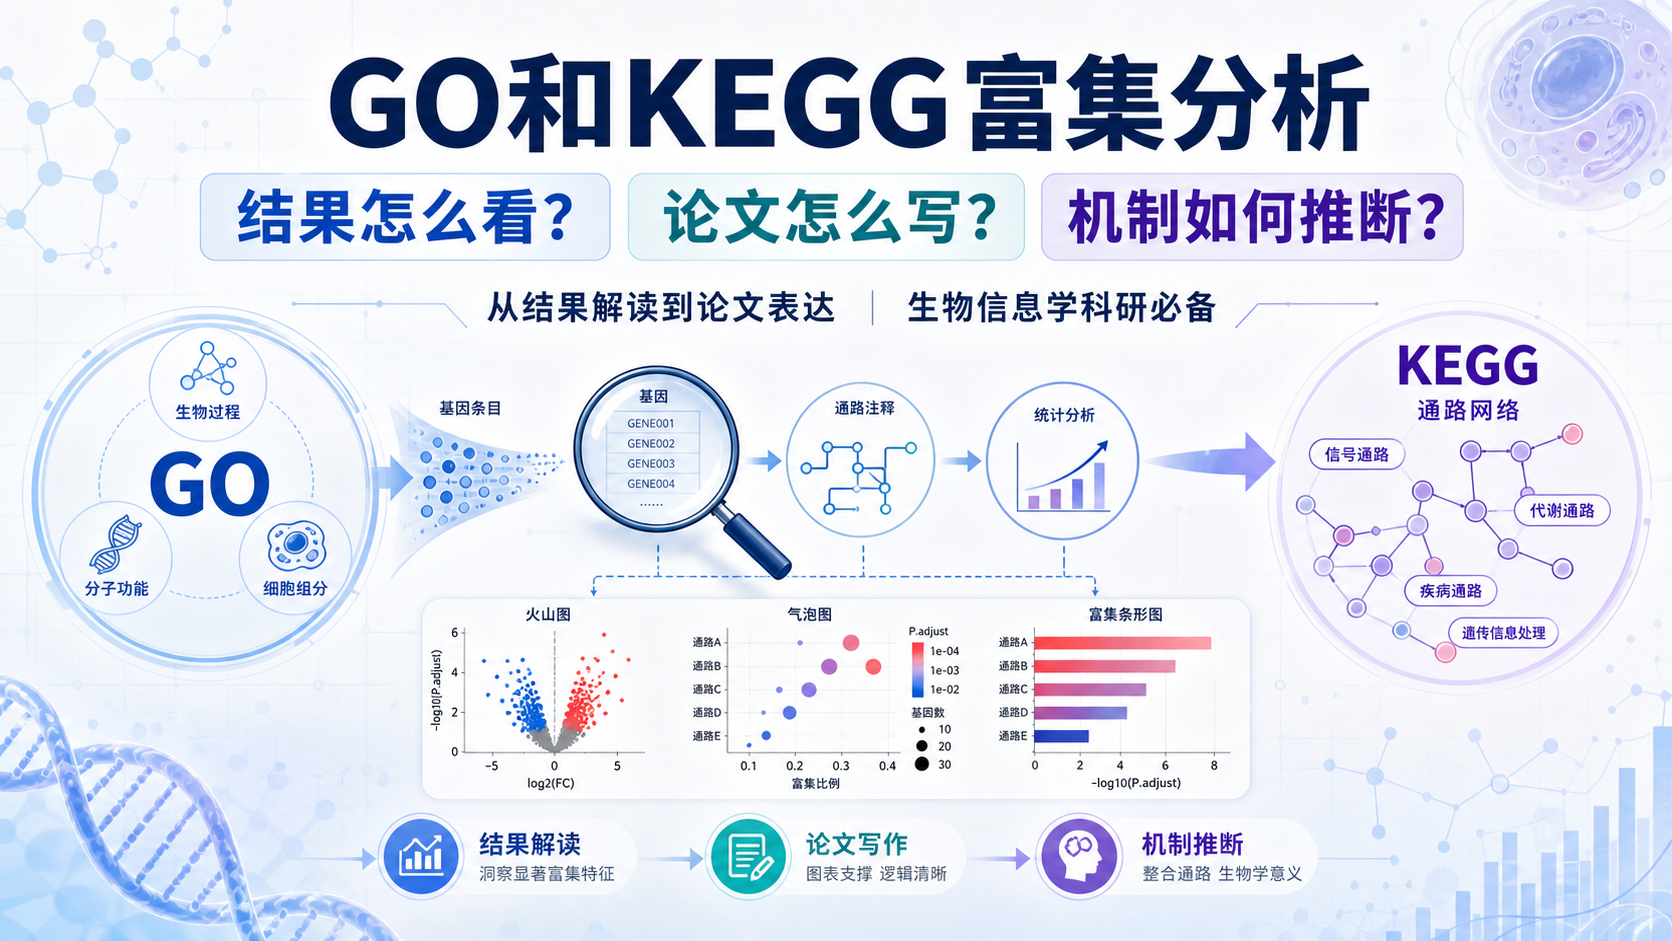
7
 分享
引言Introduction
GSVA常被用来把“基因层面”问题转成“通路层面”问题,但很多人卡在两点。一是算法到底在算什么,二是代码参数该怎么选。 如果这两个环节不清楚,后面的差异分析、热图和通路比较都容易跑偏。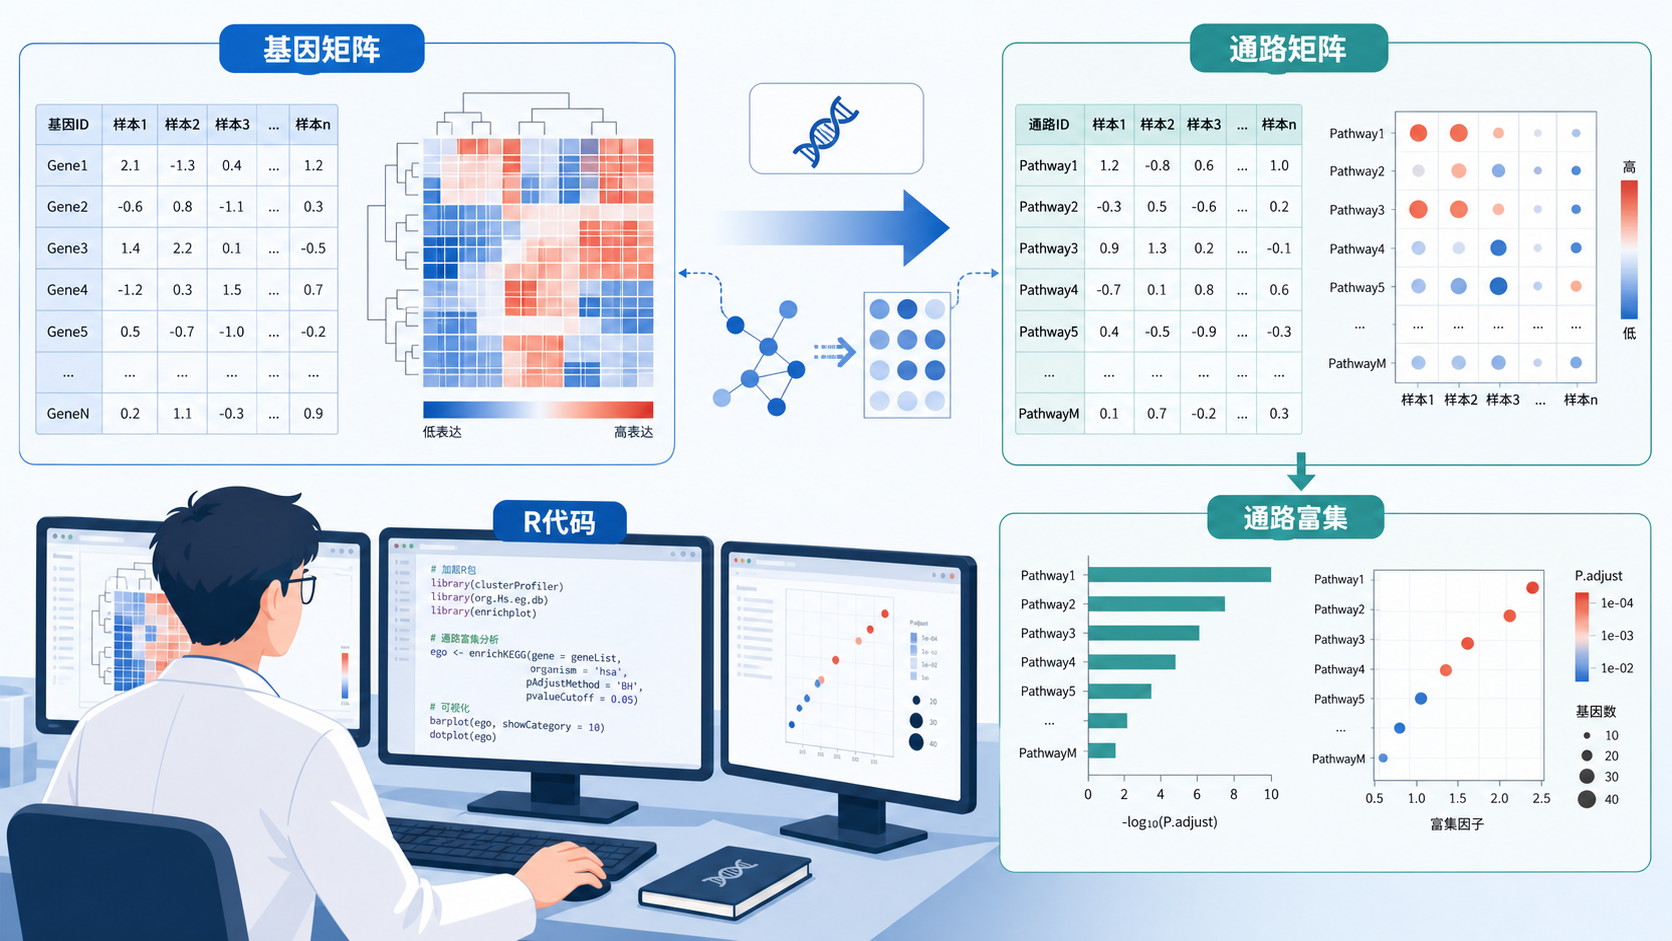
1. GSVA到底解决什么问题
1.1 从基因表达矩阵到基因集矩阵
GSVA,全称是Gene Set Variation Analysis。它的核心作用,是把“基因 × 样本”的表达矩阵,转换成“基因集 × 样本”的富集得分矩阵 。这一步非常关键,因为它改变了分析尺度。
传统差异分析更关注单个基因。GSVA更关注通路或功能模块在每个样本中的活跃程度。这样做的好处是,某些基因层面变化不明显,但通路整体偏移的信号,更容易被捕捉到。
1.2 为什么适合医学生、医生和科研人员
在肿瘤、免疫、代谢和药物反应研究中,单个基因往往解释力有限。同一疾病表型背后,常常是多个基因协同变化。 GSVA把这种协同变化压缩成通路分数,便于后续做分组比较、生存分析、聚类分析和CNV关联分析。
从实践角度看,GSVA特别适合以下场景。
- 比较不同分组的通路活性差异。
- 观察样本是否按通路特征聚类。
- 将通路分数和临床结局做关联分析。
- 作为后续机器学习或多组学整合的输入特征。
一句话概括,GSVA不是替代差异分析,而是把分析层级提升到通路水平。
2. GSVA的算法逻辑
2.1 核心思想是样本内排序与富集打分
GSVA的本质,是一种非参数、非监督 的方法。它不会预设哪一组样本一定上调,也不需要先找差异基因。它会先对每个样本内部的基因表达进行排序,再考察某个基因集中的成员是否集中出现在排序前端或后端,从而计算富集信号。
这个过程可以理解为一种“坐标轴变换”。原始数据中,行是基因,列是样本。GSVA之后,行变成基因集或通路,列仍然是样本。输出的是每个样本在每条通路上的活性得分。
2.2 与GSEA的差别要分清
GSVA和GSEA经常一起出现,但两者并不相同。
- GSEA通常依赖“样本分组后的差异排序列表”。
- GSVA则是对每个样本单独计算通路得分。
换句话说,GSEA更像是“群体层面的排序富集”,GSVA更像是“样本层面的通路打分”。这也是为什么GSVA结果可以直接进入limma做差异分析,因为它已经是一个标准的数值矩阵。
2.3 结果为什么适合后续统计分析
GSVA输出的是连续型得分。这个得分矩阵可以直接用于:
- 分组差异分析。
- 热图可视化。
- 聚类分析。
- 生存分析。
- 通路相关性分析。
这也是GSVA在转化医学研究里非常实用的原因。 它让“通路”从解释概念变成可统计、可比较、可建模的变量。
3. GSVA富集分析代码的核心参数
3.1 输入数据格式必须先理顺
做GSVA前,最重要的是输入矩阵格式。一般要求:
- 行是基因。
- 列是样本。
- 矩阵元素是表达量。
同时还需要一个基因集文件,常见是gmt格式。基因集来源可以是MSigDB,也可以是你自己整理的通路集合。
如果输入格式错了,后面的结果通常会整体失真。这不是小问题,而是决定分析是否成立的前提。
3.2 gsva函数常用参数要理解
GSVA富集分析代码里,最核心的是gsva()函数。下面几个参数最值得关注。
expr。表达矩阵。gset.idx.list。基因集列表。method。方法类型,常见有gsva、ssgsea、zscore、plage。kcdf。核函数分布假设。min.sz和max.sz。控制基因集大小范围。mx.diff。控制富集得分计算方式。verbose。是否输出运行信息。
其中,method="gsva"是默认选择。 如果你处理的是RNA-seq标准化后的表达矩阵,kcdf通常可用Gaussian。如果是未标准化count数据,则需要谨慎,很多情况下更适合先做标准化再进入GSVA流程。
3.3 参数选择的实战原则
参数不是越多越好。实战中最常见的原则是:
- 先保证表达矩阵标准化合理。
- 再确认基因集大小合适。
- 最后根据数据类型调整
kcdf。
不要把GSVA当成“跑一次就出结果”的黑箱。 它对输入数据质量和参数设定都敏感。
4. GSVA富集分析代码怎么写
4.1 基础代码流程
一个标准流程通常包括以下步骤。
- 读取表达矩阵。
- 读取gmt基因集文件。
- 调用
gsva()进行转换。 - 得到基因集×样本的新矩阵。
- 将结果用于后续差异分析或可视化。
示意代码结构如下。
library(GSVA)
library(GSEABase)

expr <- read.table("expression.txt", header = TRUE, row.names = 1, sep = "\t")
geneSet <- getGmt("geneset.gmt")

gsva_res <- gsva(as.matrix(expr),
                 geneSet,
                 method = "gsva",
                 kcdf = "Gaussian",
                 min.sz = 10,
                 max.sz = 500,
                 verbose = TRUE)
这里最重要的不是代码长什么样,而是你是否确认输入数据和基因集格式完全匹配。
4.2 输出结果怎么看
GSVA跑完后,输出矩阵的行不再是基因,而是通路或基因集名称。列还是样本。矩阵数值代表每个样本在对应通路上的富集得分。
读结果时要注意:
- 分数高,不一定代表绝对“高表达”。
- 它代表的是相对通路活性增强。
- 结果要结合分组、临床表型和生物学背景解释。
不要把GSVA分数直接等同于单个基因表达量。
4.3 常见错误点
实战中最容易出问题的地方有三个。
- 基因ID不统一,导致大量基因集无法匹配。
- 输入矩阵方向弄反,行列颠倒。
- 基因集太小或太大,影响稳定性。
建议在正式分析前先检查:
- 重叠基因数量。
- 样本分组是否正确。
- 标准化方法是否与数据类型一致。
5. GSVA结果的下游分析
5.1 用limma做差异分析
GSVA最常见的下游步骤,是把通路得分矩阵交给limma做差异分析。因为GSVA结果已经是连续数值,所以非常适合线性模型框架。
标准流程通常是:
- 构建设计矩阵。
lmFit()拟合模型。eBayes()做经验贝叶斯修正。topTable()提取显著结果。
这一步的本质,是找出哪些通路在不同样本组之间显著不同。
5.2 热图是最直观的展示方式
GSVA差异结果常用热图展示。热图能同时显示:
- 样本聚类。
- 通路聚类。
- 分组差异。
- 通路活性高低。
如果热图上分组边界清晰,说明通路层面的区分能力较强。这比只看少数几个基因更适合解释复杂疾病表型。
5.3 适合连接临床问题
GSVA结果可以进一步和临床变量关联。
- 与分期、分型比较。
- 与生存时间做Cox回归。
- 与免疫浸润评分联合分析。
- 与药物敏感性做相关分析。
这使GSVA不仅是一个富集工具,更是一个通路层面的建模入口。
6. 研究中如何避免误用GSVA
6.1 先看数据,再定方法
GSVA不是所有数据都能直接跑。不同平台的数据,前处理要求不同。芯片、标准化后的RNA-seq、未标准化count数据,处理策略都不完全一样。
如果输入数据本身噪音很大,GSVA只会把噪音转移到通路层面。它不会自动修复低质量数据。
6.2 基因集选择决定解释边界
基因集选择会直接影响结论。常用的是通路数据库、GO集合、Hallmark集合等。基因集越大,解释越稳健,但分辨率可能下降。基因集太小,则可能不稳定。
建议优先选择:
- 注释清晰的公共数据库。
- 与研究问题一致的功能集合。
- 经过文献支持的通路集。
6.3 结果解释要回到生物学
GSVA分数只是统计结果。真正的结论,仍然要回到疾病机制、样本背景和实验设计。如果没有生物学解释,通路得分没有临床意义。
最后,如果你希望把GSVA富集分析代码真正用于项目,而不是停留在“跑通脚本”,关键在于标准化数据、正确选择基因集,并把结果接到差异分析和可视化流程中。对于需要快速落地的研究场景,借助解螺旋的整理版GSVA富集分析代码和分析流程模板,可以更快完成从表达矩阵到通路结论的转换,减少参数误配和格式错误带来的返工。
总结Conclusion
GSVA的价值,在于把基因表达分析提升到通路活性层面。它的核心逻辑是样本内排序、富集打分,并输出可直接用于统计分析的基因集矩阵。理解算法逻辑、理清输入格式、掌握关键参数,是做好GSVA富集分析代码的前提。
对于医学生、医生和科研人员来说,GSVA最有用的地方,不是“多做一步分析”,而是更准确地解释疾病机制、分组差异和临床关联。若你想进一步提升分析效率,并减少代码和参数选择的试错成本,可以关注解螺旋,使用更完整的GSVA分析流程和配套资源,加快你的科研落地。
- 引言Introduction
- 1. GSVA到底解决什么问题
- 2. GSVA的算法逻辑
- 3. GSVA富集分析代码的核心参数
- 4. GSVA富集分析代码怎么写
- 5. GSVA结果的下游分析
- 6. 研究中如何避免误用GSVA
- 总结Conclusion