

 17
 分享
引言Introduction
肿瘤转录调控分析里,很多人卡在TF活性判断这一步。只看差异表达,常常解释不了机制;只做富集分析,又难以落到具体转录因子。TF基序偏差评分 提供了一条更直接的路径,能把“通路变化”进一步收敛到“可能被哪些TF驱动”。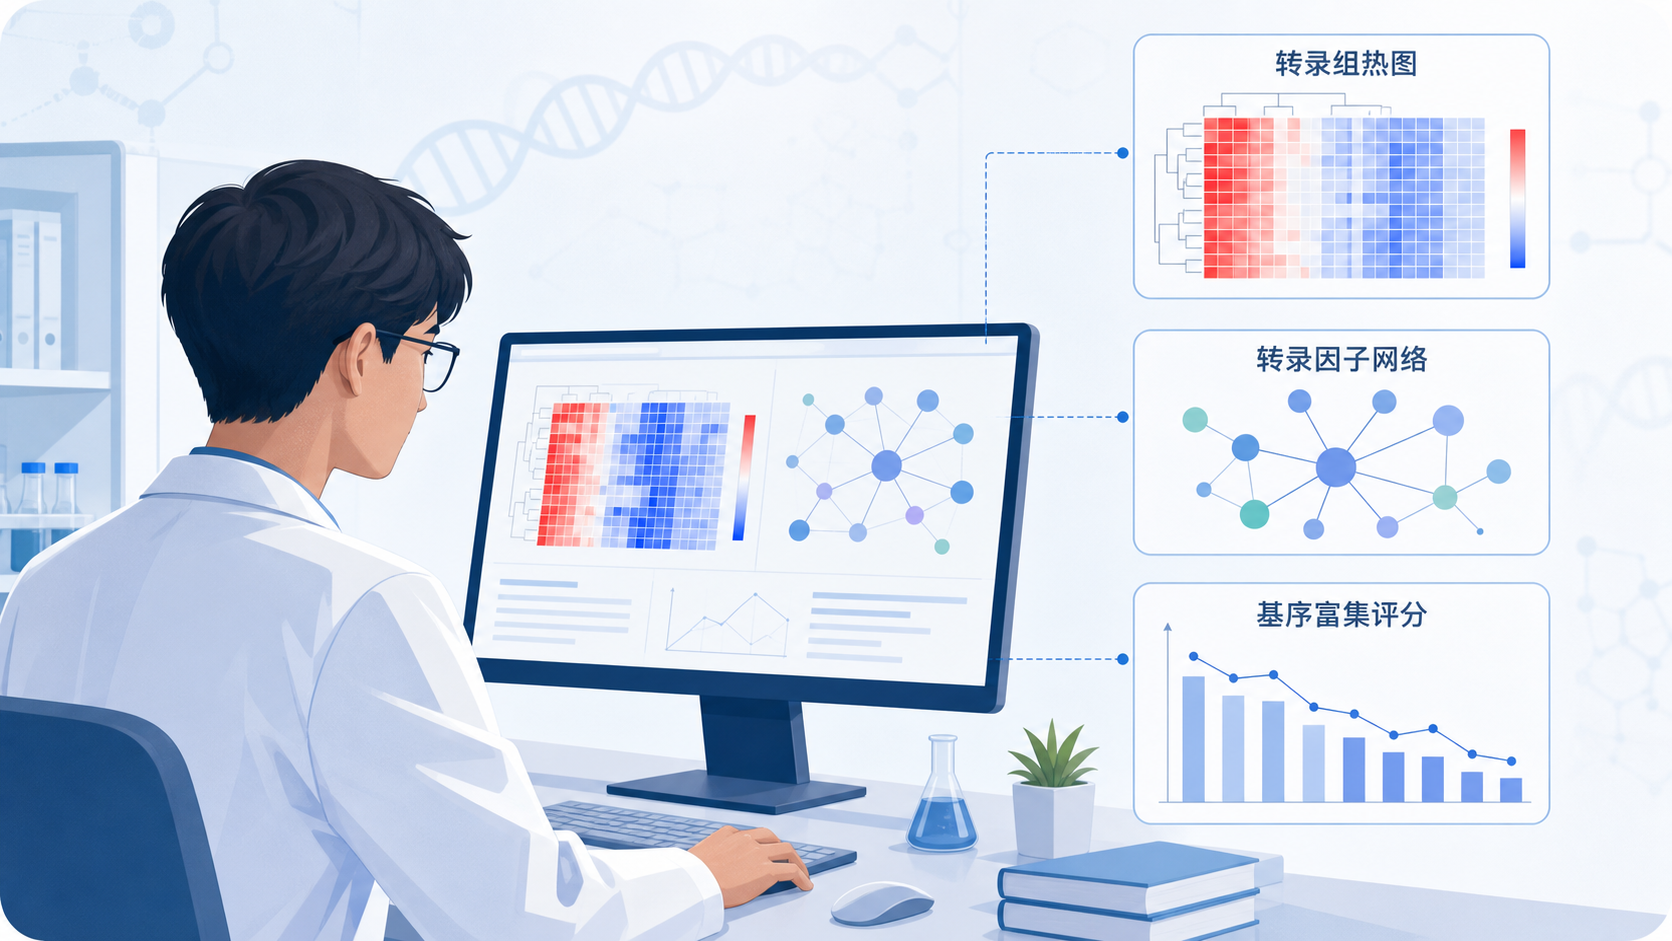
1. TF基序偏差评分是什么,为什么适合科研分析
1.1 从“表达变化”走向“调控变化”
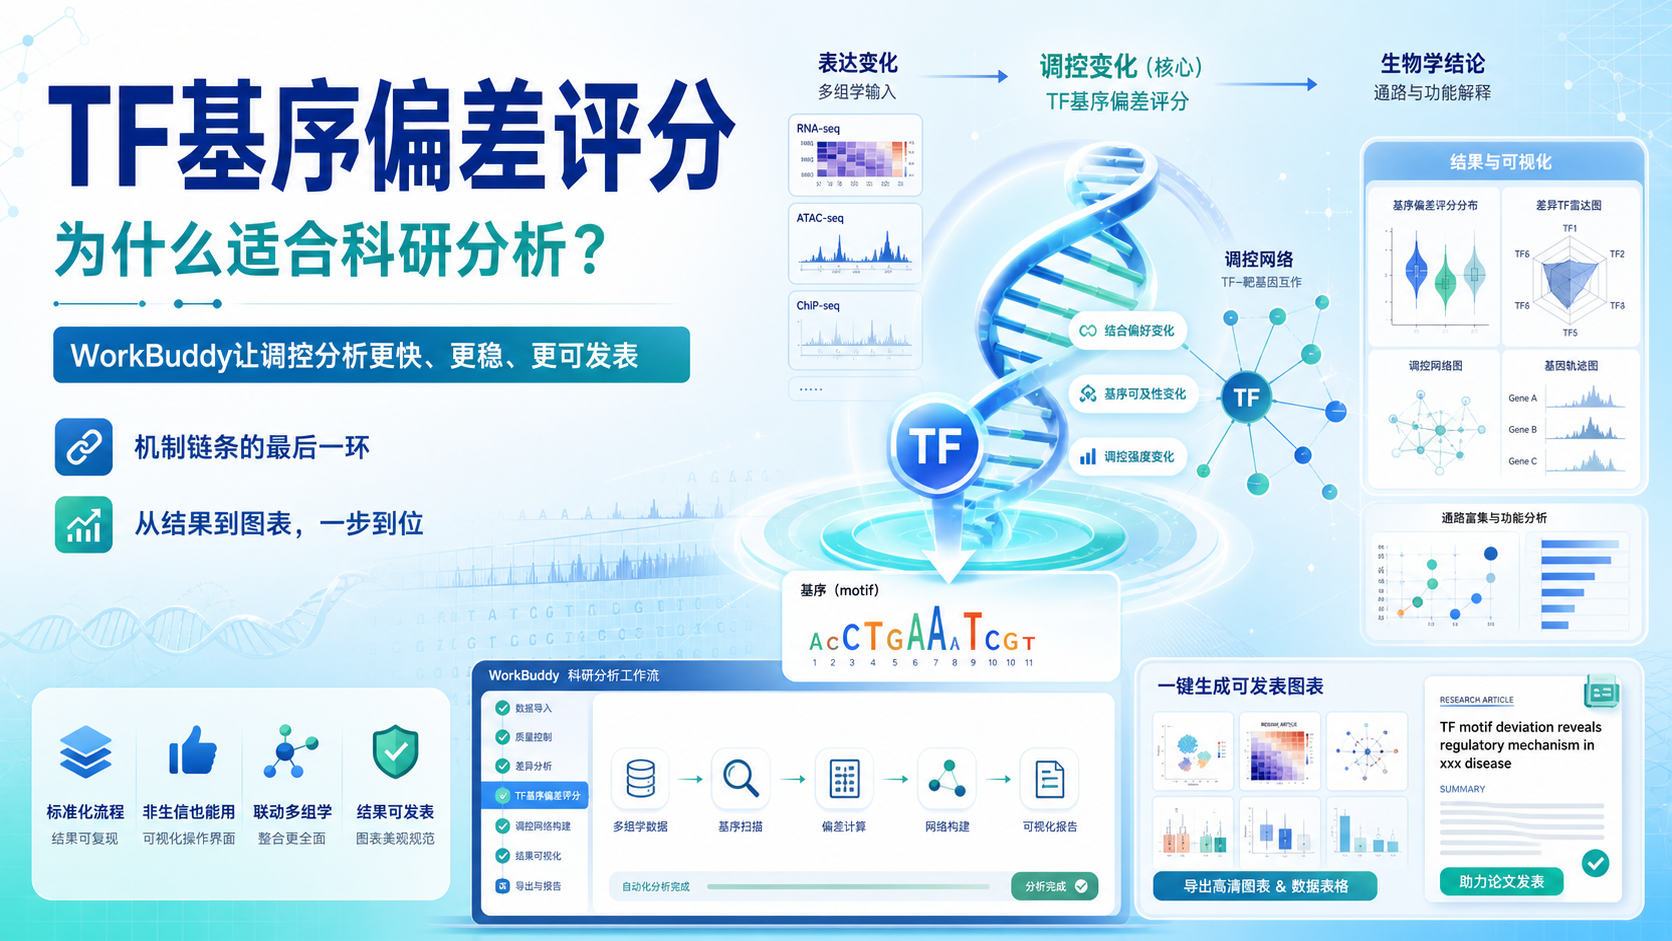
TF基序偏差评分,本质上是基于基因组调控区域中的motif分布,评估某些转录因子相关调控活性是否发生偏移。它关注的不是某个TF本身表达量高不高,而是与该TF结合相关的调控信号是否增强或减弱 。
这点很重要。因为很多TF并不靠自身mRNA显著升高来体现功能变化。相反,它们常常通过磷酸化、核转位、染色质开放状态改变,来影响下游转录程序。只看表达,容易漏掉真实调控层变化。
1.2 为什么它对医学生、医生和科研人员有价值
在肿瘤、炎症、免疫、耐药等研究中,研究者常常会问三个问题。
- 哪些基因变了。
- 哪些通路变了。
- 到底是谁在上游驱动这些变化。
TF基序偏差评分正好适合回答第三个问题。它能帮助你把结果从“现象描述”提升到“机制假设”。这对于二区及以上论文尤其重要,因为审稿人通常不会满足于“某通路上调了”这种层面。
1.3 适用场景很明确
TF基序偏差评分常用于以下场景。
- 转录组差异分析后的上游调控推断。
- ATAC-seq或开放染色质数据的转录因子活性推断。
- 肿瘤耐药机制研究中的转录调控挖掘。
- 免疫微环境变化与转录因子关联分析。
- 单细胞数据中细胞状态转换的调控解释。
如果你的研究已经有了差异基因、GSEA、GSVA,但还缺少“上游驱动者”,TF基序偏差评分是很合适的补强工具。
2. TF基序偏差评分在论文中的核心作用
2.1 它能补上“机制链条”的最后一环
很多文章的问题不是没有数据,而是逻辑断裂。比如你证明了某组样本耐药,证明了某些通路富集,还验证了几个下游基因,但读者仍然会问,为什么这些变化会一起出现。
这时,TF基序偏差评分就能提供桥梁。它可以提示某些TF的调控活性变化,并把上游调控与下游表型连接起来。这类证据非常适合写进Results和Discussion。
2.2 它比单纯差异TF列表更接近“功能推断”
差异表达TF列表只是告诉你,哪些TF的mRNA变了。问题在于,TF的功能不一定由表达量决定。很多TF在低表达状态下依然具有强活性。
而基序偏差评分更偏向功能层面。它基于motif富集偏移或调控区域偏差,推断TF相关活性变化,因此更适合作为机制线索。在审稿场景中,这类结果通常更容易获得认可。
2.3 它适合和多组学结果联动
TF基序偏差评分并不是孤立使用的。它最好与以下分析联合。
- 差异表达分析。
- GO和KEGG富集分析。
- GSEA和GSVA。
- 免疫浸润分析。
- 生存分析。
- 实验验证,如qPCR、Western blot、IHC。
如果结果能形成闭环,文章说服力会明显提升。比如,某TF基序偏差评分升高,同时其下游靶基因上调,且与不良预后相关,那么逻辑就更完整。
3. WorkBuddy如何提高TF基序偏差评分分析效率
3.1 把复杂流程标准化
TF基序偏差评分分析,真正难的不是“有没有方法”,而是流程繁琐。数据格式要对,分组要清楚,参数要一致,结果还要能解释。
WorkBuddy的新技能价值,就在于把这类复杂分析尽量标准化。
对于研究者来说,最耗时的往往不是画图,而是反复试错、整理输入文件、核对结果一致性。标准化流程能显著减少这些重复劳动。
3.2 提升从结果到图表的转化速度
科研中的时间成本,经常卡在结果整理上。一个TF基序偏差评分分析完成后,通常还要输出:
- 各组评分差异图。
- 相关性热图。
- TF-靶基因网络图。
- 分组比较图。
- 结果注释表。
WorkBuddy的优势,是能帮助你更快把分析结果转成可读、可发表的图表和文字框架。
这对赶投稿、赶毕业、赶基金结题的人特别重要。
3.3 让非生信背景研究者也能参与分析
不少临床科研人员并不排斥生信,而是被流程细节拖住。比如不知道该选什么输入矩阵,不知道该如何设定分组,或者不清楚结果是否合理。
在这种情况下,WorkBuddy的意义不是替代科研判断,而是降低操作门槛。你仍然需要提出科学问题,但重复性高、标准化强的部分可以交给工具加速。
4. TF基序偏差评分怎么用,才能真正服务论文
4.1 先定义问题,再做分析
不要为了做分析而做分析。TF基序偏差评分最适合回答的是上游调控问题。你要先明确研究目标,比如:
- 耐药过程中,哪些TF可能被激活。
- 免疫抑制状态下,哪些TF可能参与转录重编程。
- 某表型转换是否由特定TF家族驱动。
- 某信号通路变化是否可追溯到关键转录因子。
先有问题,再选分析。这样结果才有解释力。
4.2 和实验验证一起设计
如果你希望文章达到二区及以上,单靠生信结果通常不够。TF基序偏差评分更适合作为“候选线索”,后续需要实验支撑。
可考虑的验证路径包括:
- qPCR验证下游靶基因。
- Western blot验证关键蛋白变化。
- IHC观察组织水平表达差异。
- ChIP-qPCR验证TF与靶位点结合。
- 功能实验验证敲降或过表达后的表型变化。
其中,qPCR、Western blot、IHC是最常见且可操作性较强的三件套。
如果条件更好,再进一步做ChIP相关实验,机制链条会更完整。
4.3 结果解释要保持克制
TF基序偏差评分给出的不是“绝对真理”,而是“有依据的推断”。因此写作时要避免过度下结论。
推荐表达方式是:
- “提示某TF相关调控活性可能增强。”
- “支持某转录因子参与该过程。”
- “为上游调控机制提供线索。”
这种写法更严谨,也更符合E-E-A-T原则。把推断说成推断,把证据说成证据。
5. 常见误区与优化建议
5.1 不要把评分结果等同于表达量
这是最常见的误区。TF基序偏差评分反映的是调控偏移,不等于TF本身mRNA一定升高。两者可能一致,也可能不一致。
所以写文章时,最好同时检查:
- TF自身表达。
- 靶基因表达。
- 通路富集方向。
- 相关临床表型。
这样可以避免单一证据导致结论偏移。
5.2 不要忽视样本分组质量
评分再漂亮,如果分组本身有问题,结论也站不住。尤其是临床样本,分组标准必须清楚。
建议优先保证:
- 分组依据明确。
- 样本量基本平衡。
- 批次效应处理合理。
- 外部验证集可复现。
高质量分组是所有下游分析的前提。
5.3 不要让图多于逻辑
TF基序偏差评分分析很容易做出很多图,但图多不代表文章强。真正关键的是逻辑闭环。
建议保留以下主线:
- 表型差异。
- 通路变化。
- TF调控变化。
- 靶基因和实验验证。
- 临床相关性。
少而精,通常比堆砌更容易发表。
6. 结论:用WorkBuddy把TF调控分析做得更快、更稳、更可发表
TF基序偏差评分的价值,在于它能把转录组结果进一步推进到调控层面。它适合回答“谁在驱动变化”,也适合为耐药、免疫、肿瘤进展等研究提供机制线索。对想冲击二区及以上的科研人员来说,这类分析非常实用。
如果你希望把TF基序偏差评分真正用到论文中,关键不是只会跑结果,而是要把分析、解释和验证连成一条线。WorkBuddy的新技能,正是为了让这类流程更标准、更高效、更适合科研落地。
如果你正在做转录调控、机制挖掘或论文投稿,不妨借助解螺旋,让复杂分析变得更省时,也更接近可发表的研究质量。
- 引言Introduction
- 1. TF基序偏差评分是什么,为什么适合科研分析
- 2. TF基序偏差评分在论文中的核心作用
- 3. WorkBuddy如何提高TF基序偏差评分分析效率
- 4. TF基序偏差评分怎么用,才能真正服务论文
- 5. 常见误区与优化建议
- 6. 结论:用WorkBuddy把TF调控分析做得更快、更稳、更可发表