

 15
 分享
引言Introduction
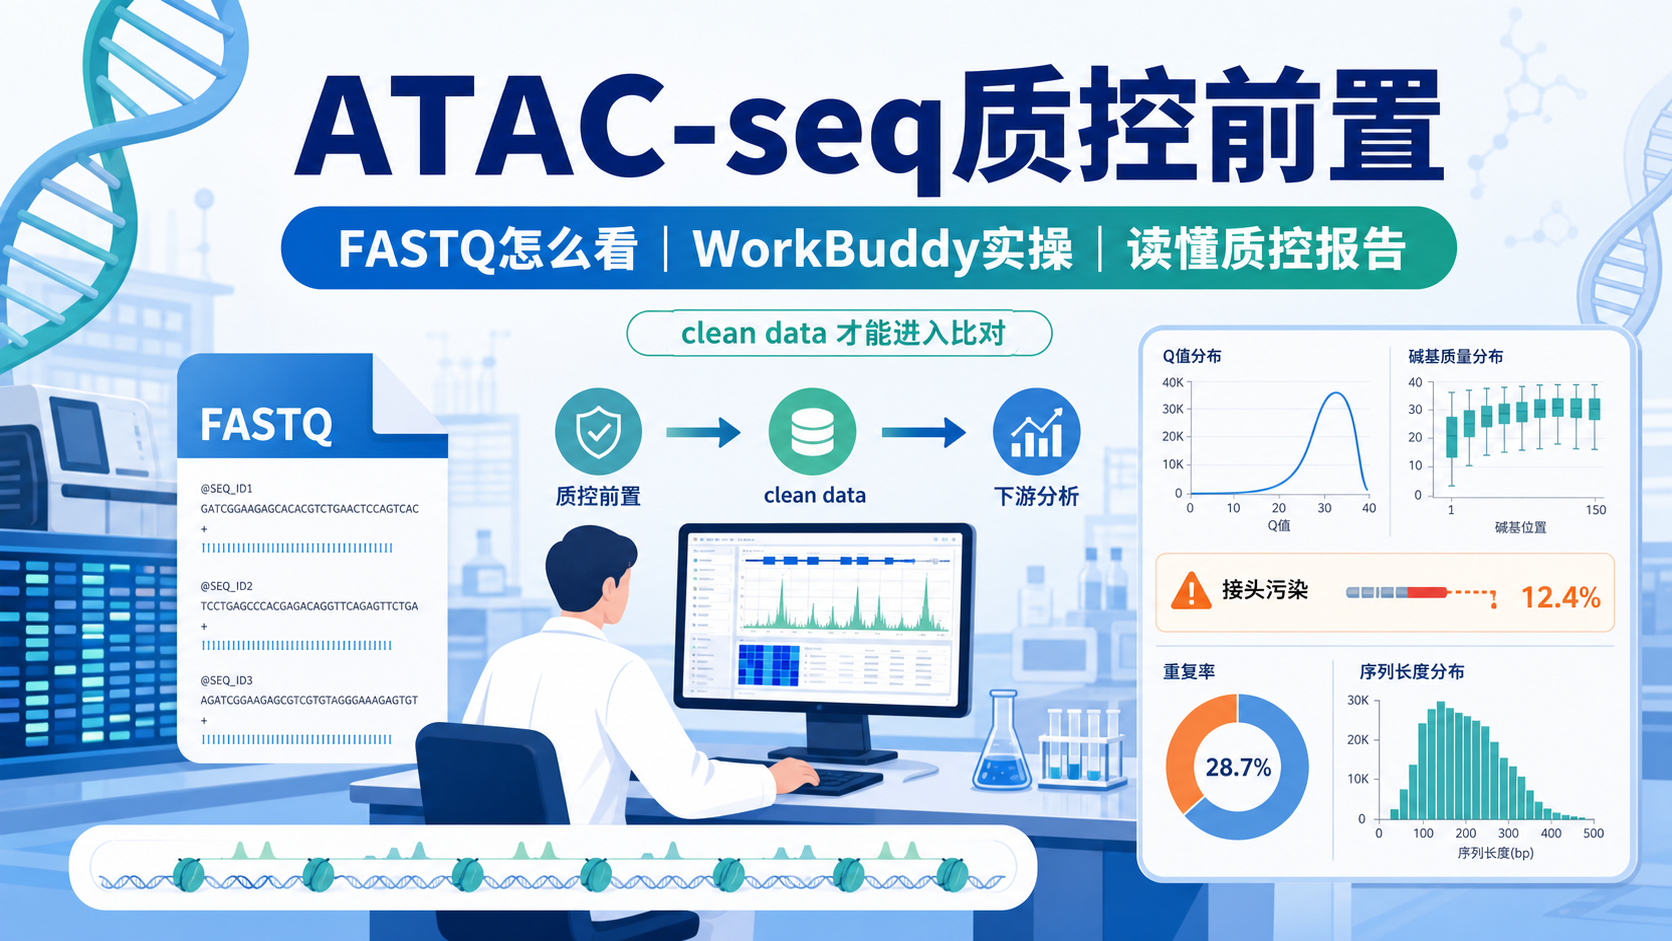
ATAC-seq数据看起来“能跑”,不代表结果就可信。很多人卡在质控这一步,样本是否可用、峰是否真实、文库是否合格,常常没有标准答案。如果前期质控没做好,后面的比对、peak calling和差异分析都会被带偏。 
1. 为什么ATAC-seq质控必须前置
1.1 质控不是“走流程”,而是筛掉无效数据
ATAC-seq本质上是开放染色质可及性测序。它对文库质量很敏感。样本一旦存在接头污染、低质量碱基、重复率过高或插入片段分布异常,后续分析的可信度就会明显下降。
质控的目标很明确。先判断数据能不能继续用,再决定是否进入比对和峰识别。 这一步做对了,能节省大量返工时间。
1.2 质控后的标准流程
从原始数据到可分析数据,通常要经历这几个阶段。
- raw data导入。
- FASTQ质量评估。
- 过滤低质量序列和接头。
- 得到clean data。
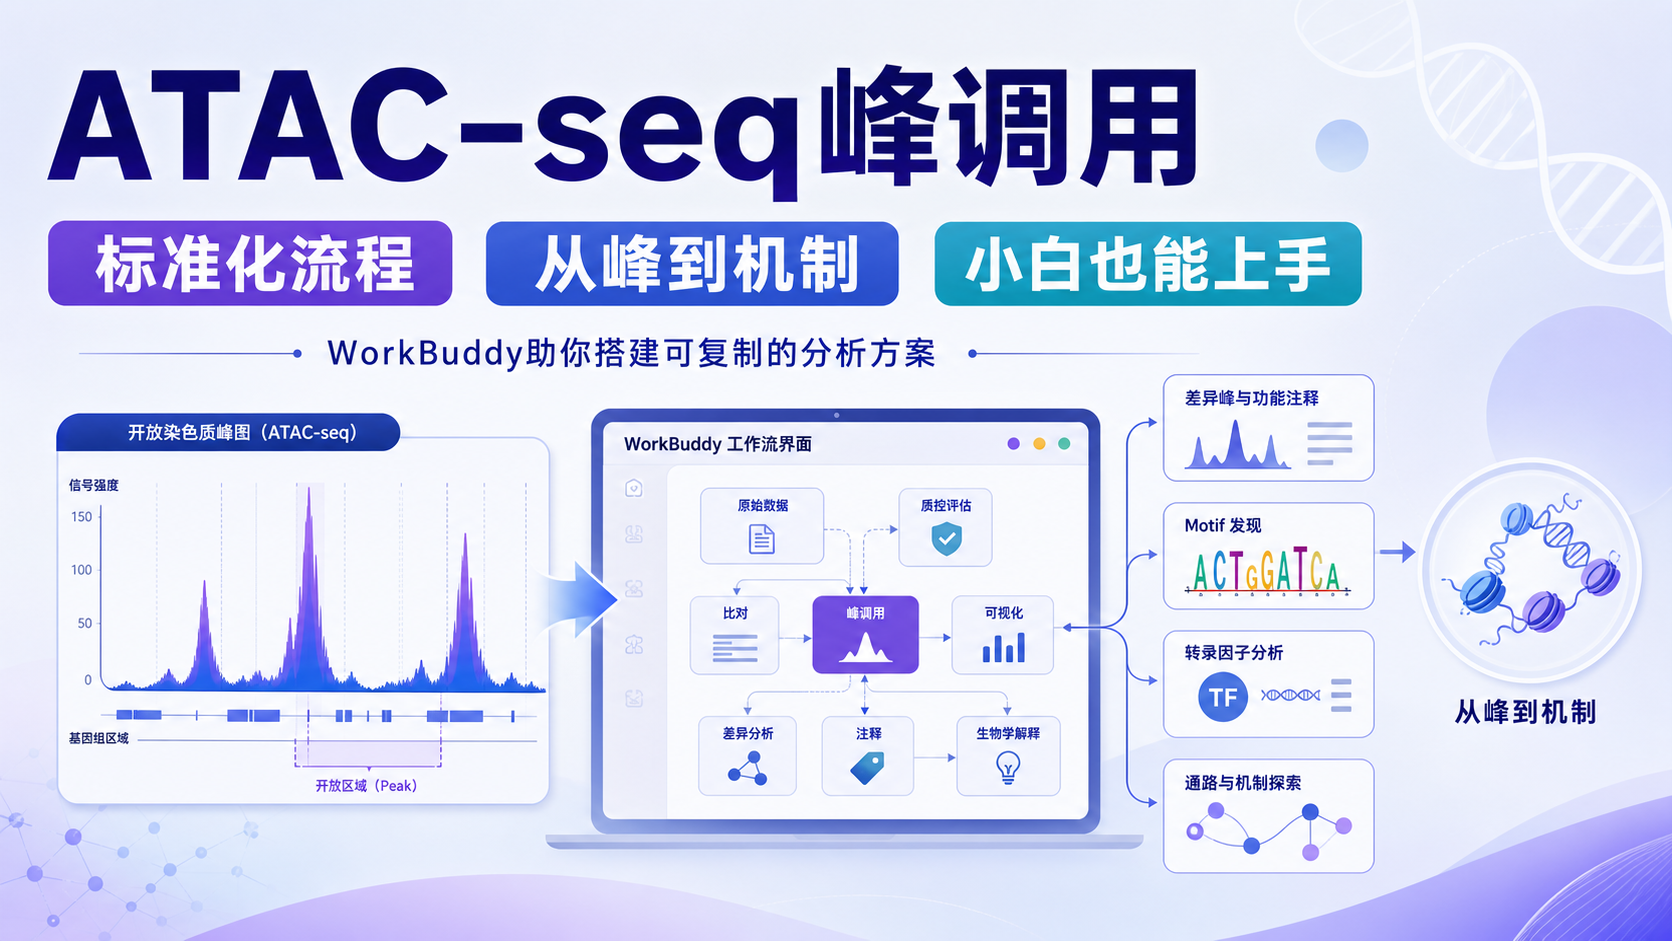
- 再做比对、去重复、peak calling和下游分析。
没有clean data,就不要急着进入统计分析。 这是ATAC-seq最基础的底线。
2. ATAC-seq FASTQ文件要看什么
2.1 FASTQ四行结构决定了你该检查什么
ATAC-seq数据通常以FASTQ形式存在。每条read由四行组成。
- 第一行,以“@”开头,记录序列ID。
- 第二行,是真实碱基序列。
- 第三行,通常是“+”。
- 第四行,是每个碱基对应的质量值。
真正决定数据是否可靠的,主要看第二行和第四行。 第二行看序列本身,第四行看碱基质量。
2.2 Q值是质控的核心指标
常见质量值标准包括Q20和Q30。
- Q20,表示碱基准确率在99%以上。
- Q30,表示碱基准确率在99.9%以上。
ATAC-seq质控中,Q30通常是更有参考价值的指标。 如果大部分碱基质量都能稳定落在Q30附近或以上,说明原始数据整体可用性较好。
2.3 还要关注哪些常见问题
除了碱基质量,还要留意以下几个点。
- 接头污染,说明测序片段过短或文库片段分布不理想。
- N碱基比例过高,表示有不可判定碱基。
- 序列重复水平异常,提示文库复杂度可能不足。
- GC含量明显偏离预期,需结合样本类型进一步判断。
对ATAC-seq来说,重复率并不一定都代表失败,但异常高重复通常提示文库质量不佳。
3. 用WorkBuddy跑ATAC-seq质控的实操思路
3.1 WorkBuddy适合做什么
在ATAC-seq分析里,WorkBuddy更适合作为流程管理和批量处理工具。它的优势是把质控、筛选、结果整理放在同一工作流里,减少手动切换命令行的成本。
对于样本量多、文件多的课题组,WorkBuddy能明显降低操作失误。
3.2 质控前的准备
在开始之前,先确认文件和目录结构。
- 检查FASTQ文件是否完整。
- 确认是单端还是双端数据。
- 统一命名,避免样本混淆。
- 明确输出目录,保证结果可追踪。
如果输入文件来自SRA或测序公司,建议先解压并核对文件数。文件缺失比质控失败更麻烦,因为它会直接影响整套分析链条。
3.3 在WorkBuddy里完成FASTQ质控
实际操作时,先把原始FASTQ文件导入WorkBuddy对应的项目目录,再启动质控模块。常见逻辑是先跑FastQC类检查,再汇总多个样本结果。
你重点要看这些内容。
- Basic Statistics,确认文件格式、读长和GC含量。
- Per base sequence quality,确认每个位点质量分布。
- Sequence Duplication Levels,观察重复水平。
- Adapter Content,检查接头残留。
- Per base N content,查看N碱基比例。
如果多个样本都出现相似异常,往往说明问题出在建库或测序环节,而不是单个样本。
4. 读懂质控报告,重点盯住这几项
4.1 碱基质量图是第一优先级
在质控报告中,最先看的是Per base sequence quality。曲线是否稳定、是否大面积低于Q30,是最关键的判断依据。
一般来说。
- 前端轻微下降可以接受。
- 全程明显低质量,需要警惕。
- 尾端质量下滑明显,常提示读长末端不稳定。
对ATAC-seq而言,稳定的碱基质量比“报告看起来很完整”更重要。
4.2 接头污染会直接影响后续比对
ATAC-seq文库片段通常偏短,因此更容易读穿接头。如果FastQC提示Adapter Content升高,说明需要做剪切。
这时不要直接进入比对。应先做清洗处理,再重新评估。
建议顺序是。
- 先看质控报告。
- 判断是否存在接头污染。
- 进行过滤和剪切。
- 再次运行质控。
没有复检的清洗,不算真正完成质控。
4.3 重复水平异常时要结合实验背景判断
Sequence Duplication Levels在转录组里常被反复讨论,在ATAC-seq里也不能机械解读。开放染色质区域天然富集,局部重复偏高并不罕见。但如果整体重复率过高,就要考虑文库复杂度不足、PCR偏倚或起始量不足。
判断重复率时,要结合测序深度、样本类型和文库制备方案一起看。
5. 质控后如何进入下游分析
5.1 clean data是进入比对的前提
当FASTQ质控通过后,下一步才是比对参考基因组。比对完成后,还要继续做去重复、过滤低质量比对、识别峰值区域。
ATAC-seq分析通常还会进一步看。
- 插入片段长度分布。
- TSS enrichment。
- FRiP值。
- mitochondrial reads比例。
这些指标和FASTQ质控一起,才能共同说明一个ATAC-seq样本是否值得继续分析。
5.2 批量样本最容易出错的地方
ATAC-seq经常不是一个样本,而是一批样本。样本越多,越容易出现命名混乱、路径错误、输出覆盖等问题。
建议保留以下规范。
- 原始数据、clean data、报告文件分目录保存。
- 样本名统一格式。
- 每一步都保留日志。
- 质控结果单独汇总成表。
这样做的好处是,后续论文写作和补充材料整理都更顺畅。
6. 为什么推荐用解螺旋辅助ATAC-seq分析
6.1 复杂流程更需要标准化工具
ATAC-seq分析链条长,任何一个环节出问题,都会影响最终结论。对医学生、医生和科研人员来说,最耗时的不是“有没有工具”,而是“工具能否把流程稳定跑通”。
解螺旋可以帮助你更高效地整理流程、规范质控步骤,并减少重复劳动。
6.2 把时间留给真正的科研判断
工具可以帮你做批量处理,但不能替代科研判断。比如,某个样本是否因为低质量而剔除,是否需要重新建库,是否能进入下游统计,这些都要结合实验设计和生物学背景判断。
解螺旋的价值,是让你把更多精力放在数据解释,而不是被琐碎操作拖住。
总结Conclusion
ATAC-seq质控不是附属步骤,而是整套分析的起点。你要先看FASTQ结构、碱基质量、接头污染、重复水平,再决定是否进入比对和peak calling。只要前期质控严谨,后续数据分析才更可靠。 如果你希望把ATAC-seq质控流程做得更高效、更规范,可以借助解螺旋来完成标准化整理与批量处理,减少重复操作,把时间留给真正的科研决策。
- 引言Introduction
- 1. 为什么ATAC-seq质控必须前置
- 2. ATAC-seq FASTQ文件要看什么
- 3. 用WorkBuddy跑ATAC-seq质控的实操思路
- 4. 读懂质控报告,重点盯住这几项
- 5. 质控后如何进入下游分析
- 6. 为什么推荐用解螺旋辅助ATAC-seq分析
- 总结Conclusion