

 19
 分享
引言Introduction
ATAC-seq峰调用看似是标准流程,实际常卡在参数选择、样本整合和结果解释。对医学生、医生和科研人员来说,难点不只是“跑出峰”,而是如何把峰调用结果快速转化为可验证的表观遗传假设 。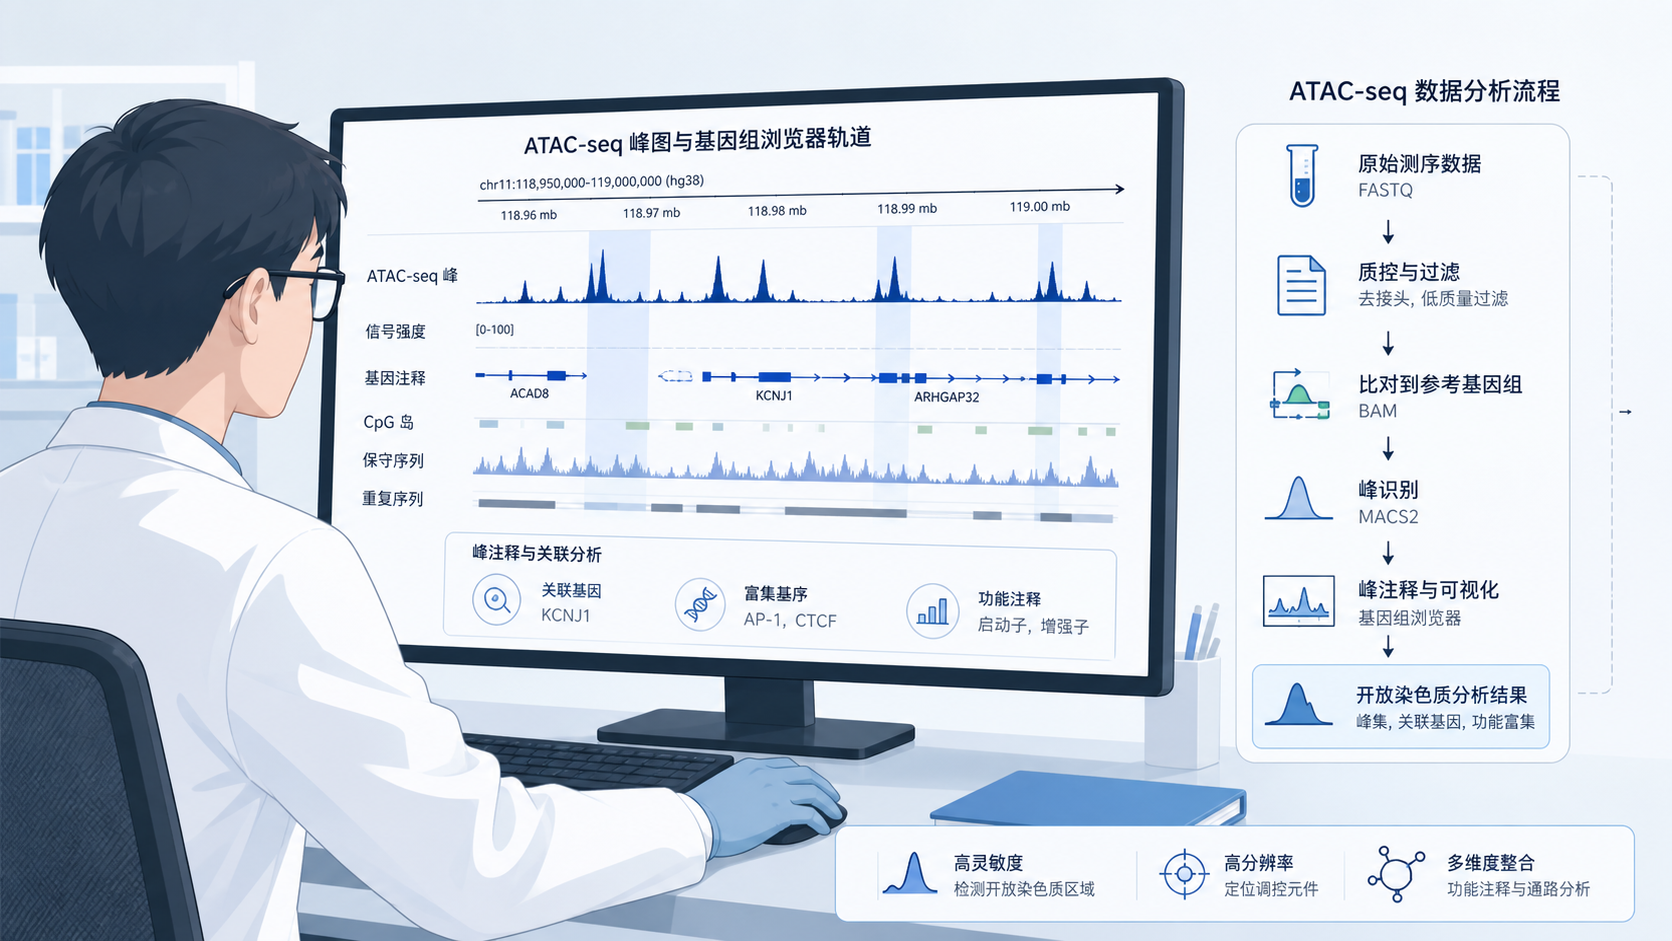
1. 为什么ATAC-seq峰调用仍是表观遗传分析的关键环节
1.1 峰调用决定后续分析的可信度
ATAC-seq反映染色质开放状态。峰调用是把测序信号转成可解释区域的第一步。
如果峰边界不准,后面的差异可及性分析、motif富集、转录因子推断都会偏移。
简单说,峰调用不是技术细节,而是结论的地基。
尤其在疾病机制研究中,开放染色质常对应增强子活化、转录调控变化和细胞状态重塑。峰调用质量直接影响你能否找到可信的调控位点。
1.2 传统流程的痛点在于“会跑但不易用”
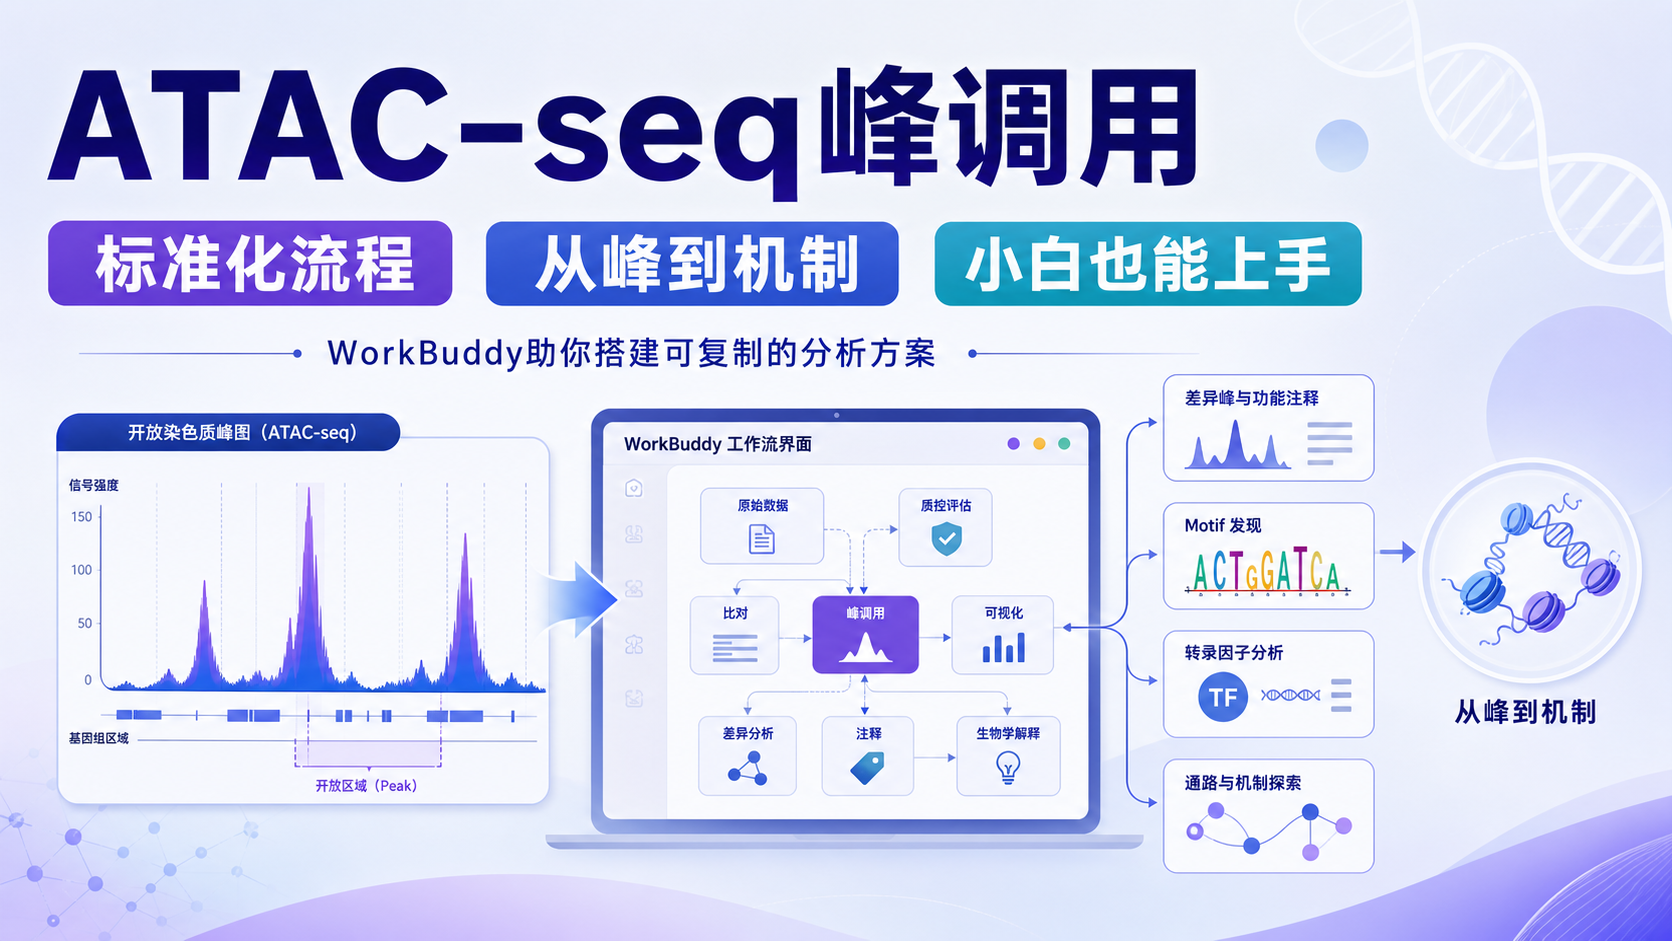
ATAC-seq分析通常涉及多个步骤:
- 原始数据质控。
- 比对与去重复。
- 峰调用。
- 结果注释与下游功能解释。
问题在于,很多团队能完成前两步,却在峰调用后卡住。常见原因包括:
- 不同样本参数不一致。
- 峰集整合困难。
- 结果文件多,难以快速筛选。
- 缺少可视化总结,无法高效进入生物学解释。
真正的瓶颈,往往不是算不出来,而是算完后看不懂、接不上。
1.3 WorkBuddy的价值在于把流程变成可执行方案
根据上游知识库中的思路,WorkBuddy配合定制技能的方式,更适合把复杂分析拆成清晰步骤。
它的优势不是替代专业判断,而是帮助用户把“分析套路”快速整理成可执行任务。
对ATAC-seq峰调用而言,这种方式尤其适合:
- 明确输入数据格式。
- 规划峰调用与注释顺序。
- 统一分析逻辑。
- 减少反复试错。
对需要兼顾教学、科研和临床转化的人群,这种零代码或低门槛组织方式非常实用。
2. WorkBuddy如何帮助搭建ATAC-seq峰调用的标准化流程
2.1 从数据准备开始,先统一输入规范
ATAC-seq峰调用前,最容易出错的是输入不规范。
无论是单组样本还是多组样本,建议先明确以下内容:
- 样本分组信息。
- 物种信息。
- 比对后文件是否可直接进入峰调用。
- 是否需要比较不同条件下的开放区域。
输入越标准,后续峰调用越稳定。
WorkBuddy的价值在于,它可以把这些前置条件整理成操作清单,减少漏项。
2.2 峰调用之后,重点不只是“有峰”,而是“峰能说明什么”
峰调用完成后,常见输出包括峰区域、注释结果和相关统计图。
但真正值得关注的是以下三类信息:
- 峰是否富集在启动子、增强子或其他调控区域。
- 峰对应的基因是否与疾病表型相关。
- motif富集是否提示关键转录因子参与调控。
峰调用的终点不是峰列表,而是调控机制假设。
如果你研究肿瘤、炎症或发育过程,这一步尤其重要,因为开放染色质变化往往先于表达变化出现。
2.3 多样本项目更需要统一管理
在真实项目里,ATAC-seq常常不是单样本分析,而是多条件、多批次、多队列整合。
这时最怕两件事:
- 不同样本参数不一致。
- 结果分散在多个表格里,难以横向比较。
WorkBuddy适合把分析任务做成结构化流程,便于记录每一步的输入和输出。
这样做的好处很直接:
- 方便复现。
- 方便团队协作。
- 方便后续写论文方法学部分。
标准化管理越早建立,后面的图表和结论越容易统一。
3. 从峰调用到生物学解释,如何把结果用起来
3.1 先看峰分布,再看调控区域
ATAC-seq结果出来后,不建议立刻只盯着显著峰数量。
更合理的顺序是先看峰在基因组中的位置分布。
例如:
- 启动子附近峰增多,常提示转录激活。
- 远端调控区峰变化,可能涉及增强子重编程。
- 特定细胞群体中峰改变,常提示细胞身份变化。
位置分布信息,能帮助你判断信号属于“启动子效应”还是“远端调控效应”。
3.2 再做motif富集和转录因子推断
峰调用之后,motif分析是最常见的下游步骤之一。
它回答的是一个核心问题:哪些转录因子可能驱动了这批开放染色质变化。
在实际研究中,建议把结果与已知生物学背景结合:
- 肿瘤样本中,重点看增殖、应激、分化相关TF。
- 免疫样本中,重点看炎症和激活相关调控因子。
- 发育研究中,重点看谱系决定因子。
上游知识库提到的在线工具中,也强调了motif与转录因子信息在调控网络构建中的重要性。
这说明峰调用只是入口,真正的价值在于把峰连接到调控网络。
3.3 把峰调用结果嵌入整体研究设计
对医学生和科研人员来说,ATAC-seq峰调用最好不要孤立看。
它应和RNA-seq、单细胞转录组、临床分组信息一起解释。
一个常见的整合思路是:
- 用ATAC-seq找到开放染色质变化。
- 用RNA-seq验证对应基因表达变化。
- 用通路分析解释功能意义。
- 用临床数据关联预后或分型。
当峰调用结果能和转录变化、表型差异相互印证,文章的说服力会明显增强。
4. WorkBuddy在ATAC-seq峰调用场景中的实际优势
4.1 让复杂任务更接近“可复制模板”
对很多实验室而言,最大痛点不是没有数据,而是每个人做法不同。
WorkBuddy的意义在于,它更适合把分析逻辑固定下来,形成可复用模板。
这对教学、协作和项目积累都很重要。
因为一旦模板稳定,后续只需替换样本和参数,就能快速重跑。
这比每次从零开始更高效,也更符合真实科研节奏。
4.2 降低非生信背景人员的进入门槛
ATAC-seq数据分析涉及命令行、参数、结果解释,多数临床科研人员很难独立完成。
如果有一个能把流程组织清楚的工具,研究者就可以把精力放在问题本身,而不是反复处理格式和脚本。
这也是WorkBuddy类方案的优势:
- 更容易描述任务。
- 更容易检查步骤。
- 更容易输出可读结果。
对时间紧张的医生科研团队,这种效率提升非常现实。
4.3 适合把“方法”升级为“研究方案”
上游内容中提到,AI工具的一个重要方向不是只给出结果,而是把分析套路继续延伸成研究方案。
这对ATAC-seq特别有价值。
例如,你可以从峰调用结果进一步提出:
- 某类细胞是否存在染色质重塑。
- 某个疾病状态是否出现增强子异常激活。
- 某个转录因子是否可能作为干预靶点。
当峰调用从“技术产物”变成“研究入口”,项目价值就被真正放大了。
总结Conclusion
ATAC-seq峰调用的核心,不只是识别开放染色质区域,而是把这些区域转化为可验证的调控假设。对医学生、医生和科研人员来说,真正的难点在于流程规范化、结果整合和生物学解释。WorkBuddy的价值,就在于把这些步骤组织成清晰、可复制、可协作的分析路径。
如果你正在推进ATAC-seq项目,或者希望把峰调用结果更快转化为课题思路,可以借助解螺旋 进一步梳理分析流程、整合结果输出,让复杂表观遗传数据更快服务于科研决策。
- 引言Introduction
- 1. 为什么ATAC-seq峰调用仍是表观遗传分析的关键环节
- 2. WorkBuddy如何帮助搭建ATAC-seq峰调用的标准化流程
- 3. 从峰调用到生物学解释,如何把结果用起来
- 4. WorkBuddy在ATAC-seq峰调用场景中的实际优势
- 总结Conclusion