

 19
 分享
引言Introduction
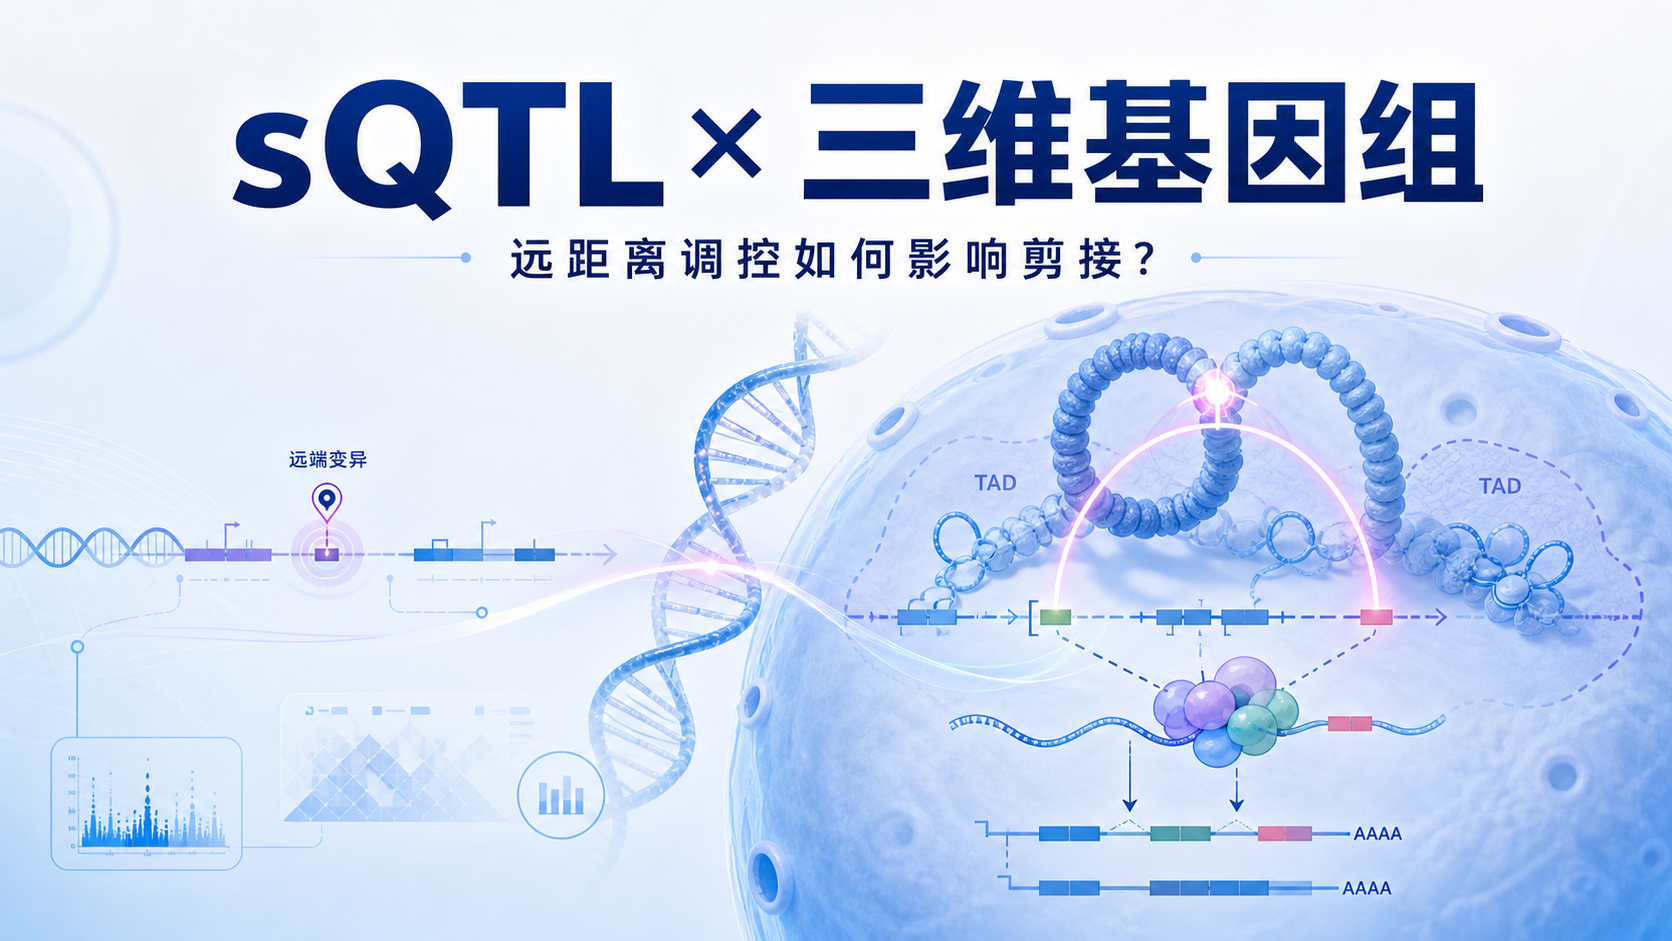
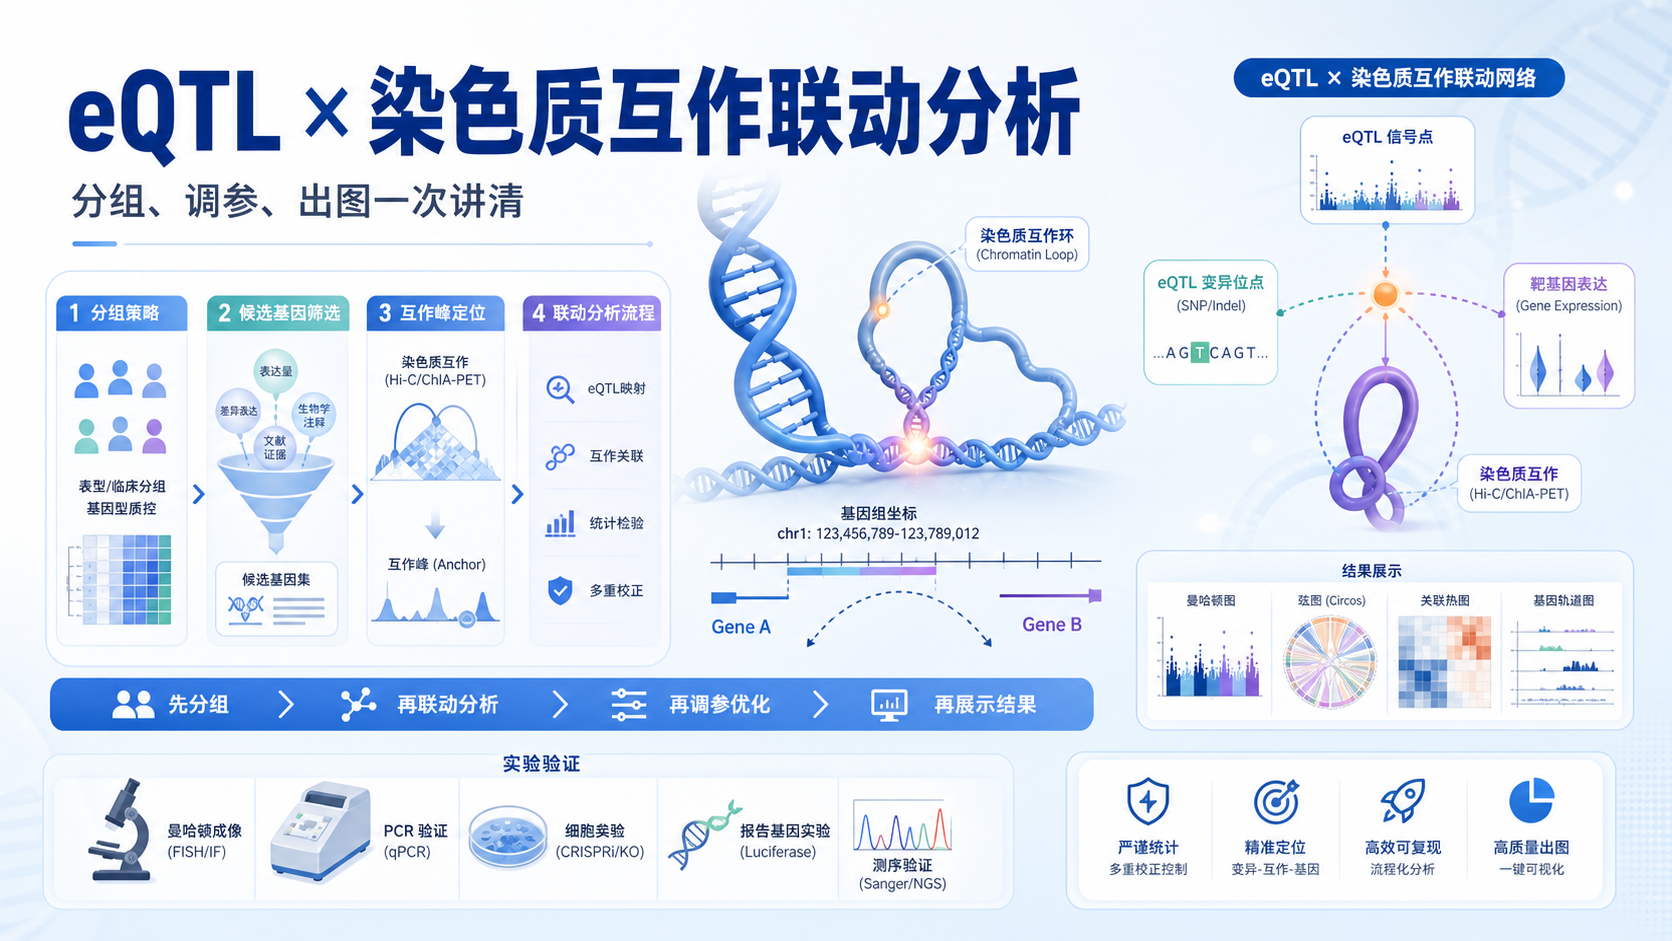
做染色质互作和eQTL分析时,最容易卡在两点。分组不合理,信号看不清。参数没调对,结果不稳定。很多项目不是没有生物学意义,而是分析策略把真实关联“淹没”了。 下面从分组、阈值、可视化和验证四个环节讲清楚。
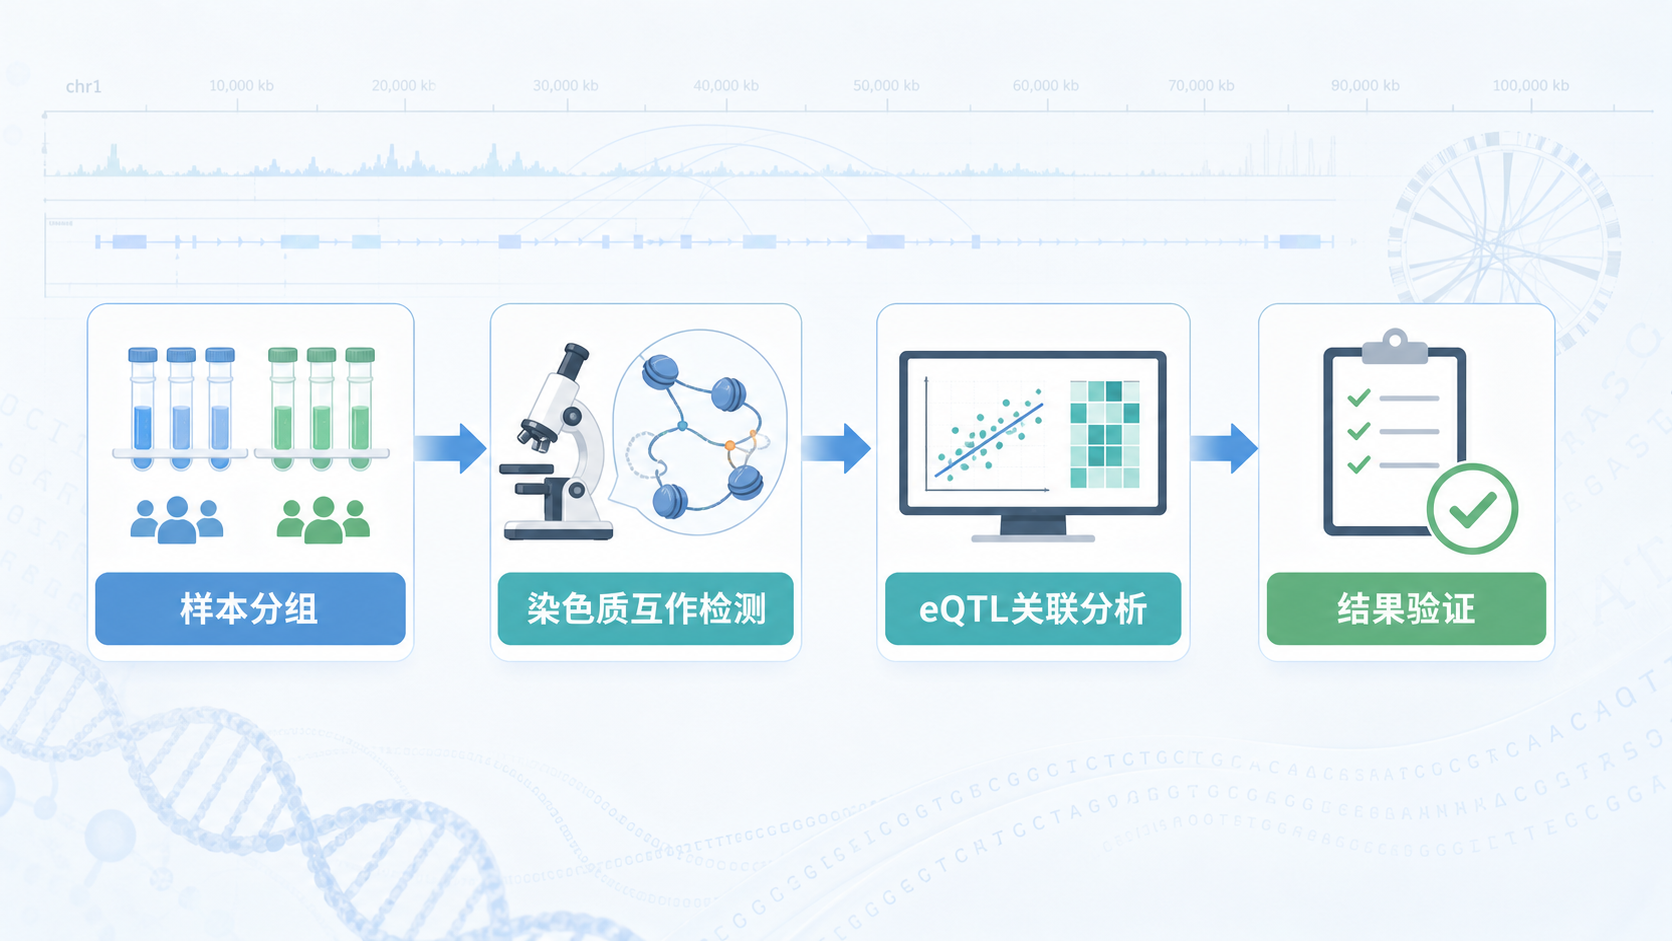
1. 先把分组想清楚,再开始做分析
1.1 分组的核心,不是“分得多”,而是“分得准”
染色质互作和eQTL,本质上都依赖样本异质性。样本一旦混杂,关联会被稀释。分组的第一原则,是让组内相似,组间有差异。
常见的分组维度包括:
- 疾病状态,如病例和对照。
- 组织来源,如外周血、肿瘤组织、正常组织。
- 细胞状态,如刺激前后、敲除前后。
- 遗传背景,如不同基因型人群。
如果研究目标是解释某个SNP如何影响基因表达,最好同时保留对应组织、对应表型和对应遗传背景。否则,eQTL信号可能只反映组织差异,而不是位点效应。
1.2 染色质互作和eQTL,分组逻辑要一致
很多项目的问题出在“前后不一致”。前面做染色质互作时按疾病分组,后面做eQTL时却把所有样本混在一起。这样得到的结论很难闭环。
建议在设计阶段就统一三个层次。
- 生物学分组,决定主问题。
- 技术分组,控制批次效应。
- 验证分组,专门用于独立复现。
如果样本量有限,宁可减少分组层级,也不要把组别切得过细。因为每切细一次,统计功效都会下降。对eQTL尤其明显。很多位点在10到20个样本里根本不稳定,通常需要更大的样本规模才能看到可信关联。
1.3 先做探索,再做正式建模
正式分析前,建议先做三件事:
- PCA或UMAP看样本是否按预期聚类。
- 染色质互作热图看远近互作是否集中。
- 基因表达矩阵看候选基因是否有基础差异。
这一步的意义,不是出图,而是排雷。如果样本在无监督分析里已经明显分离,后面的eQTL和互作结果才更值得继续。
2. eQTL与染色质互作如何联动分析
2.1 先定义“互作峰”和“候选基因”
染色质互作分析最怕两种情况。一个是峰太多,另一个是峰太散。
所以第一步要明确候选范围。通常会先筛出:
- 启动子区互作。
- 增强子区互作。
- 已知差异区域附近的互作峰。
在这个基础上,再去匹配eQTL。不要一上来就全基因组盲扫。 那样会增加多重检验压力,也容易把噪音当信号。
2.2 用互作信息缩小eQTL搜索空间
eQTL的优势,是能把SNP和表达变化联系起来。染色质互作的优势,是能把空间上分离的调控元件连起来。两者结合后,逻辑会更完整。
一个常见做法是:
- 先找互作锚点上的候选调控区。
- 再看这些区域是否含有显著SNP。
- 最后检查该SNP是否与目标基因表达相关。
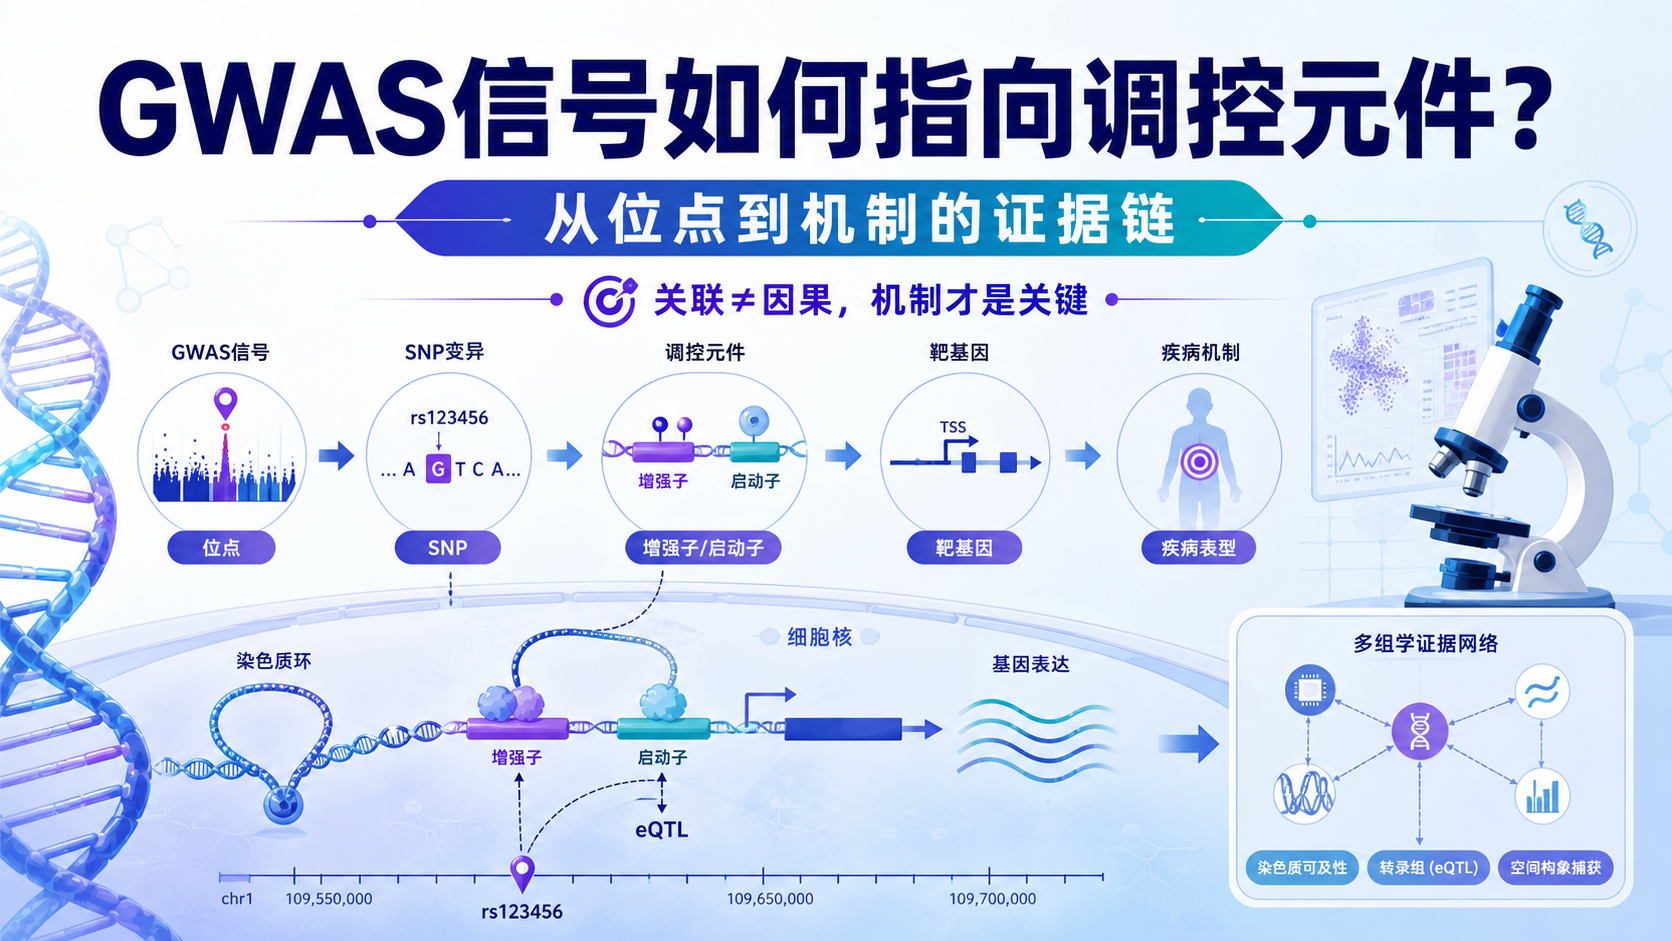
如果同一个SNP既落在互作增强子上,又能解释目标基因表达变化,这个证据链就更强。
2.3 注意方向一致性
eQTL不是只看P值。还要看方向。
比如某个等位基因增加后,目标基因表达上升,而该位点又位于增强子互作区域,这种结果更符合生物学逻辑。反过来,如果方向完全相反,就要检查:
- 参考基因组注释是否正确。
- 基因型编码是否反了。
- 互作峰是否来自错误样本或批次。
方向一致,比单纯显著更重要。 这是很多初学者容易忽略的地方。
3. 调参时,优先控制三个变量
3.1 阈值不能只追求“严”
做分析时,大家常常想把阈值设得非常严格,觉得这样更“高级”。但实际并非如此。阈值过严,会导致真信号丢失。阈值过松,又会引入大量假阳性。
所以调参时,优先考虑三个问题:
- 是否能保留足够的候选事件。
- 是否能控制FDR。
- 是否便于后续实验验证。
阈值不是越大越好,也不是越小越好,而是要和样本量匹配。
3.2 eQTL常用参数要稳定
在eQTL分析里,常见调参点包括:
- 基因型过滤阈值。
- 表达量过滤阈值。
- 协变量数量。
- 多重检验校正方法。
经验上,低表达基因如果不先过滤,假阳性会明显增加。协变量如果太少,批次效应会残留。协变量如果太多,又可能过度校正。最佳做法,是先做小规模试跑,再根据结果逐步调整。
3.3 染色质互作参数要兼顾分辨率和稳定性
互作分析里,分辨率越高,图越细,但噪音也越大。分辨率越低,图更稳,但细节会丢失。
常见优化方向有:
- 调整bin大小。
- 调整显著性阈值。
- 合理设定距离衰减范围。
- 选择合适的背景模型。
如果你关注的是增强子和启动子的远程联系,建议先用中等分辨率筛选,再对重点区域提高分辨率复查。这样更稳妥。不要一开始就追求最细颗粒度。
4. 结果展示要服务于机制,而不是堆图
4.1 先讲故事主线,再决定画什么图
染色质互作和eQTL的图很多,但不是每张都要放。
最有效的展示顺序通常是:
- 差异区域定位。
- 互作证据展示。
- eQTL关联展示。
- 机制假设图。
- 实验验证图。
图的作用是证明机制链条,不是单纯展示数据量。
如果一个图不能帮助读者理解“哪个位点调控了哪个基因”,就应该重新考虑是否保留。
4.2 常见图形组合要避免重复
很多文章会出现“图多但信息重复”的问题。比如,互作热图、弧线图、环状图都在讲同一个事件。此时要保留最能说明问题的一张。
建议优先保留这类图:
- 基因组浏览器图,展示SNP、开放染色质和互作峰的位置关系。
- 热图,展示区域内互作强度。
- 散点图或箱线图,展示eQTL关联方向。
- 示意图,展示调控路径。
一张图回答一个问题,效率最高。
4.3 验证要落回到生物学实验
如果条件允许,最终还是要回到实验验证。可以考虑:
- 双荧光素酶验证增强子活性。
- CRISPR干预候选调控区。
- qPCR或RNA-seq验证目标基因变化。
- ChIP-qPCR验证转录因子结合。
对于医学生、医生和科研人员来说,真正有说服力的不是“分析看起来很美”,而是“分析结果能被实验复现”。这才是eQTL和染色质互作联合分析的核心价值。
总结Conclusion
染色质互作和eQTL联合分析,关键不在于把所有方法都用上,而在于把分组、阈值和验证链条串起来。先分清样本,再缩小搜索空间,再用合适参数稳住结果。 这样得到的候选位点和目标基因,才更适合后续机制研究和论文发表。
如果你希望把这类分析做得更高效、更规范,可以关注并使用解螺旋 的专业内容和支持服务,把复杂的分析流程变成可落地的研究方案。
- 引言Introduction
- 1. 先把分组想清楚,再开始做分析
- 2. eQTL与染色质互作如何联动分析
- 3. 调参时,优先控制三个变量
- 4. 结果展示要服务于机制,而不是堆图
- 总结Conclusion