

 8
 分享
引言Introduction
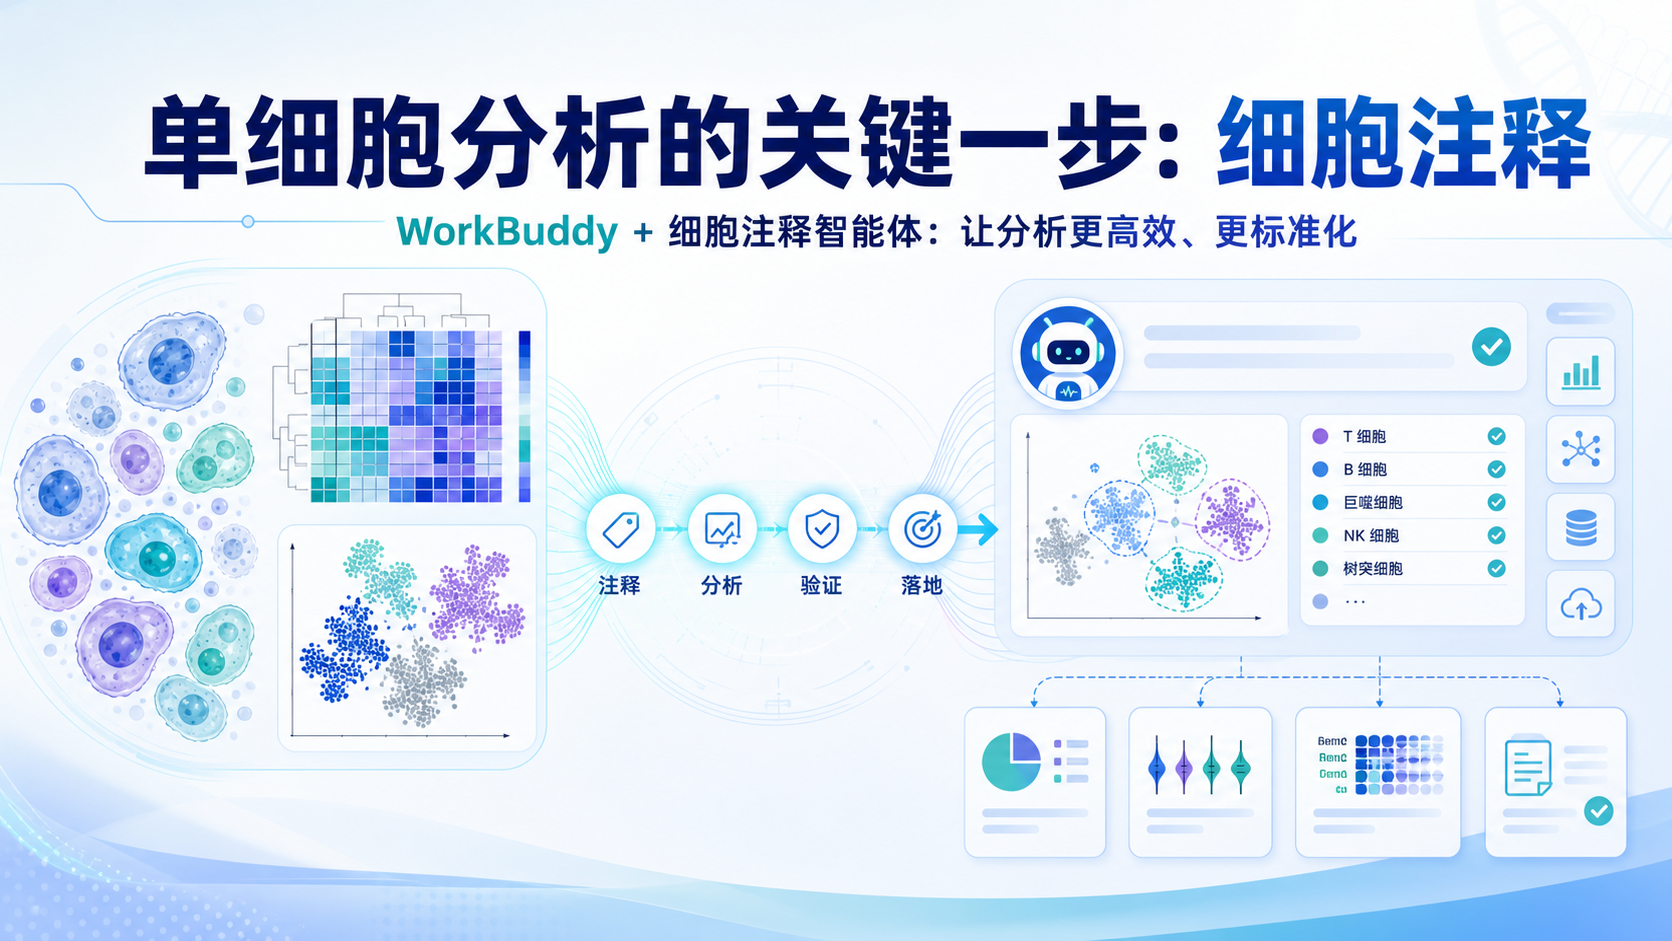
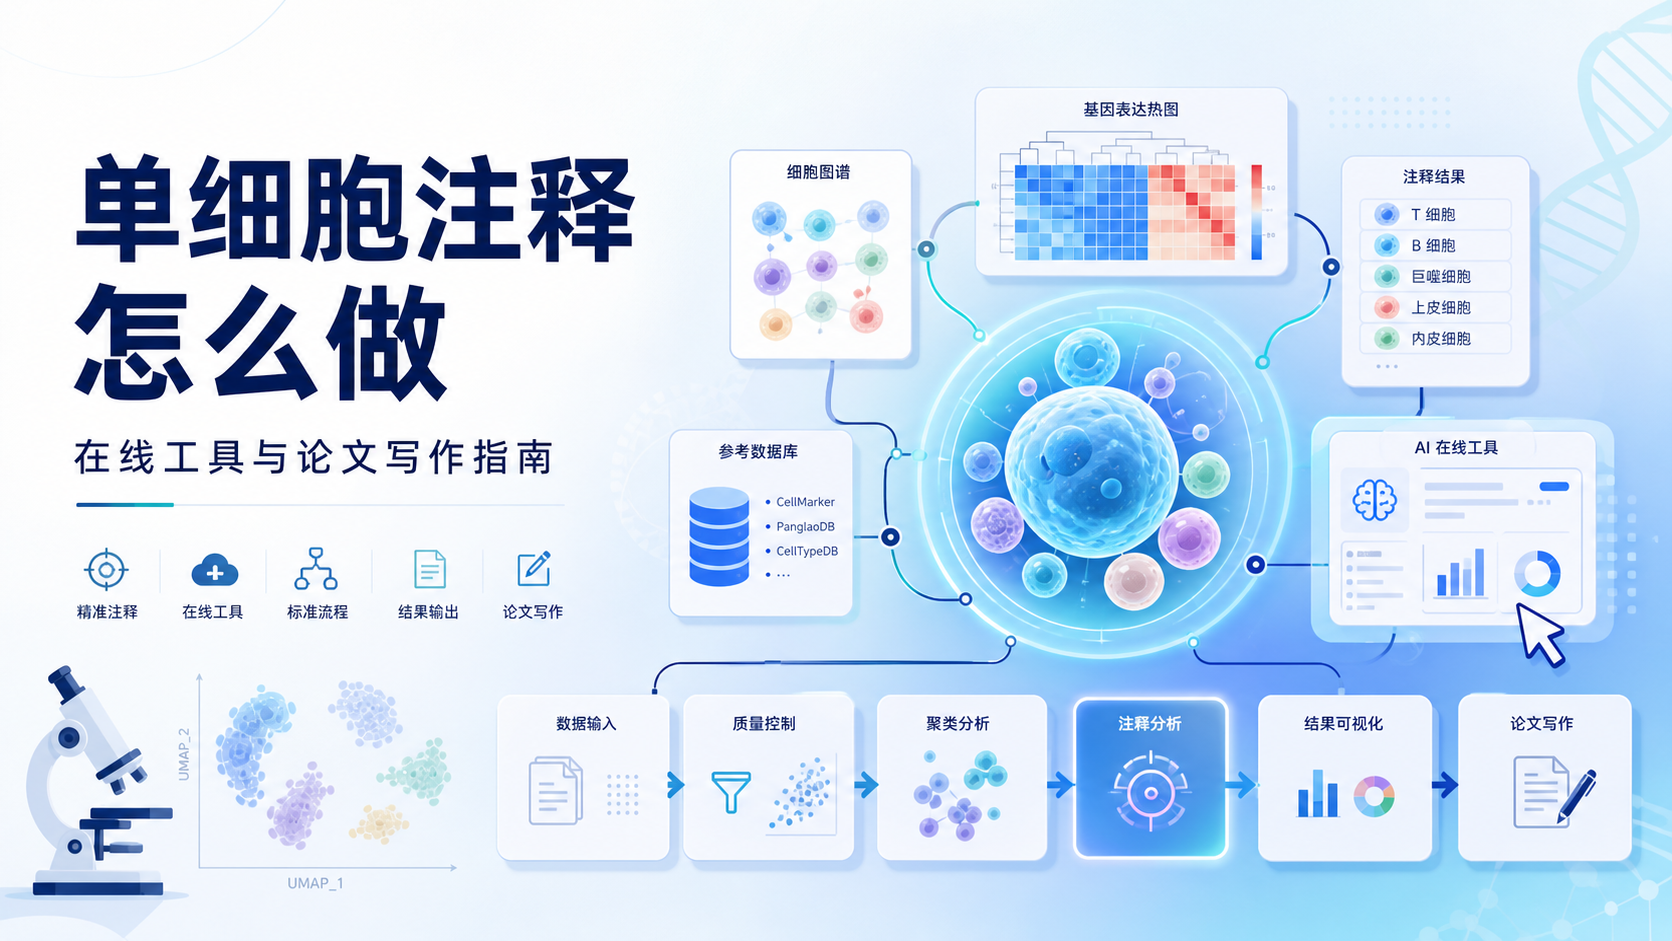
单细胞数据越来越多,但注释仍是很多课题的第一道门槛。细胞群太碎、标记基因不稳定、人工判读耗时长,都会直接拖慢分析和投稿进度。如果不能把细胞身份尽快定清,后续机制分析、通讯分析和发文逻辑都会受影响。 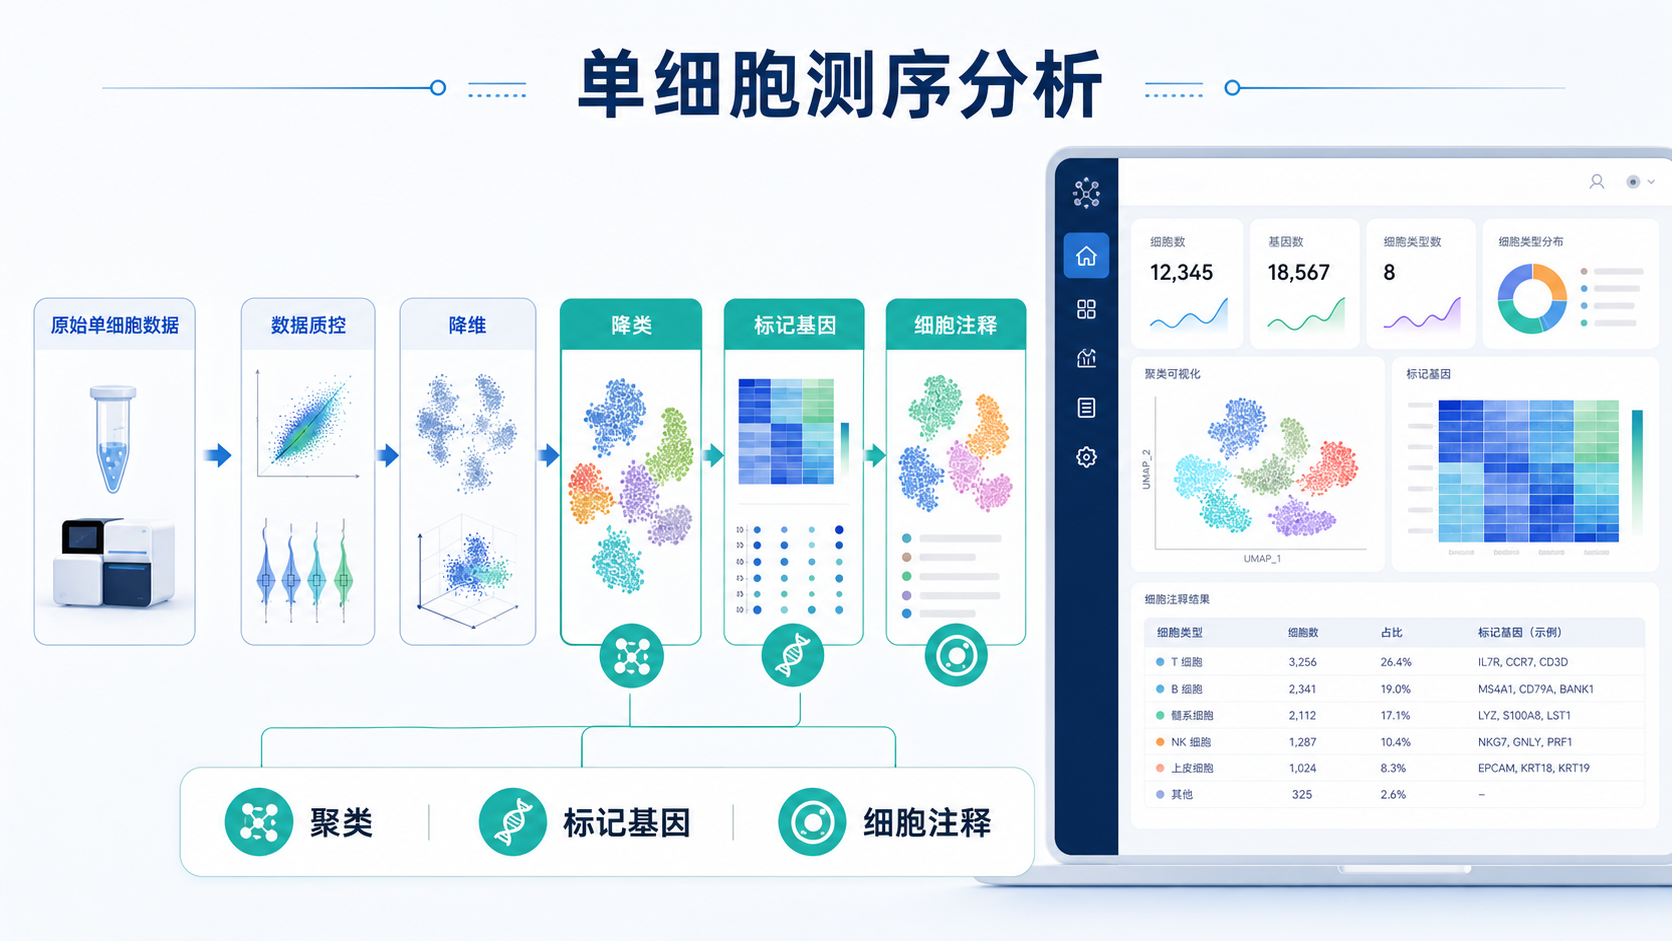
1. 为什么单细胞注释是关键步骤
单细胞转录组的价值,不在于“测到了很多细胞”,而在于能否把这些细胞准确分群并赋予生物学意义。对于医学生、医生和科研人员来说,注释结果决定了你能否回答“这是什么细胞”“它在疾病中发生了什么变化”“它是否参与了关键通路”。
1.1 细胞注释决定下游分析质量
单细胞分析通常从降维、聚类开始,但聚类只是数学分组,不等于生物学结论。没有可靠注释,后面的差异分析、轨迹分析、细胞通讯分析都可能建立在错误基础上。
例如,免疫细胞中T细胞、B细胞、髓系细胞若注释混乱,后续免疫浸润结论就会失真。肿瘤样本里,肿瘤细胞和上皮细胞边界不清,也会影响对恶性亚群和微环境互作的判断。
1.2 从人工判读到在线工具,工作流正在变化
过去注释主要依赖经验和文献。研究者需要逐个查看marker基因表达,再结合已知细胞谱系判断。这个过程准确,但耗时长,也容易受个人经验影响。
现在,在线注释工具可以把参考表达谱、标签基因和数据库信息整合起来,帮助研究者快速缩小候选范围。这类工具的价值不是替代判断,而是提高注释效率和一致性。
1.3 WorkBuddy适合做什么
WorkBuddy这类分析支持工具,核心优势在于“快速、标准化、可复用”。对于单细胞注释场景,它更适合做三类任务。
- 处理初步聚类后的细胞类型判定。
- 基于参考表达谱进行候选注释筛选。
- 辅助梳理注释结果,形成可写入文章的方法学表述。
对于需要反复试错的项目,WorkBuddy通用单细胞注释能显著减少人工重复劳动 ,尤其适合项目初期和多样本对照分析。
2. 单细胞注释的基本逻辑
单细胞注释并不是“随便找几个marker看看”。它本质上是一个基于参考数据和特征基因的分类过程。不同工具算法不完全一样,但核心逻辑大体一致。
2.1 两种主流思路
第一种是基于已有参考数据预测未知数据。这也是最常见的方法。工具会将待注释细胞与已知细胞类型表达谱进行比对,再根据相似度或特征基因给出候选标签。
第二种是从头预测,不依赖现成参考。它更依赖表达特征和聚类结构,适合参考不足的特殊组织或疾病模型,但不确定性更高。
对大多数常规课题来说,优先选择基于参考数据的注释方式更稳妥。 因为它更符合标准化分析,也更便于复现。
2.2 先验知识决定注释精度
注释不是只看单个基因。它依赖三类先验信息。
- 标签基因。比如免疫细胞常见marker。
- 表达谱参考。来自公开数据库或已发表数据。
- 功能数据库。比如GO、KEGG、MSigDB,用于理解细胞功能背景。
如果参考数据来源可信,注释结果通常更稳定。反之,即使算法再复杂,也可能得到偏差较大的标签。所以,注释的上限首先取决于参考知识的质量。
2.3 标准化流程更利于发表
在论文中,审稿人通常会关注两个问题。
第一,你的细胞类型是否注释准确。
第二,你的结果能否被别人复现。
因此,一个清晰的注释流程很重要。通常包括:
- 数据预处理和质控。
- 聚类后识别marker基因。
- 用参考库做自动注释。
- 手动核对关键细胞群。
- 输出图表和结果表。
自动注释负责效率,人工核对负责可信度。 两者结合,最适合严谨的科研写作。
3. 在线工具如何完成单细胞注释
在实际使用中,在线工具的价值主要体现在“少配置、快出结果、便于结果解释”。这对于不想花大量时间搭建本地环境的用户尤其友好。
3.1 参考表达谱和标签基因的使用
以常见的注释逻辑为例,工具通常会读取表达矩阵,再和参考细胞类型表达谱比对。参考中如果包含明确的标签基因,结果会更容易解释。
例如,免疫细胞、上皮细胞、成纤维细胞、内皮细胞等大类通常较容易区分;而同一大类内的亚群,如不同T细胞亚群、不同巨噬细胞状态,则更依赖精细marker和高质量参考。
参考库越完整,越有利于细胞亚群的精细划分。
3.2 自定义对照数据集的重要性
对于某些特定疾病或组织,公共参考库未必完全匹配。这时,自定义对照数据集就很重要。
比如你研究的是特定癌种、炎症模型或药物干预样本,最好使用与课题尽量接近的参考表达谱。这样可以减少误分配,提高注释可信度。
如果参考来源过于宽泛,容易出现“看似合理,实际偏差”的标签结果。
3.3 结果输出要看什么
一个合格的注释结果,不只是给出一个细胞名称,还应该能解释“为什么这样注释”。通常需要看三类输出。
- 表格结果。看每类细胞的候选标签和置信度。
- 柱状图或箱线图。看不同细胞群的表达分布。
- 热图。看marker基因在各群中的特异性。
真正有用的不是单一标签,而是标签、表达和可视化证据三者一致。 这是科研中最基本的可信度要求。
4. WorkBuddy在单细胞注释中的应用价值
如果说传统注释流程强调“手工判断”,那么 WorkBuddy 的意义在于把这套判断流程前置、标准化和提速。对于需要快速推进项目的人,这一点非常重要。
4.1 降低入门门槛
很多学生和初级研究者并不是不会做单细胞,而是卡在工具选择、参数理解和结果解释上。WorkBuddy通用单细胞注释的优势,就是把复杂流程压缩成更易执行的步骤。
你不需要反复调试环境,也不必从零搭建所有参考库。对于课题起步阶段,这能明显降低试错成本。
4.2 提高分析一致性
单细胞注释最容易出现的问题,是不同批次、不同操作者得到不同标签。
使用统一的工作流,可以让数据处理、参考匹配和结果输出更规范。这样不仅方便内部复核,也方便后续写进论文方法部分。
对团队协作来说,标准化比“个人经验”更重要。
4.3 适合和后续分析联动
单细胞注释不是终点。它是后续分析的入口。
一旦细胞类型稳定下来,就可以继续做:
- 差异表达分析。
- 细胞通讯分析。
- 轨迹和拟时序分析。
- 富集分析和通路分析。
- 疾病相关亚群挖掘。
注释越准确,后面的机制链条越清晰。 这也是为什么很多高质量单细胞文章,都把注释作为核心方法步骤之一。
5. 如何把注释结果写进论文
很多人完成了注释,却不会写。其实论文里只需要把逻辑交代清楚,重点是可复现。
5.1 方法部分怎么写更规范
方法部分建议交代四点。
- 数据来源和预处理方式。
- 聚类和降维方法。
- 参考数据库或注释工具。
- 人工校正的标准。
这样写的好处是,审稿人能看出你的分析不是“黑箱”。
如果能同时说明使用了参考表达谱、标签基因和可视化验证,可信度会更高。
5.2 结果部分怎么组织
结果部分最好分层写。
先写大类注释,再写亚群注释。
先说明主要细胞类型,再说明关键疾病相关群体。
最后再把注释结果和功能变化联系起来。
例如,先确认免疫、上皮、间质等主要谱系,再进一步分析某一类细胞在疾病组中的比例变化和基因表达变化。这样结构清楚,也更符合文章阅读逻辑。
5.3 让结果更有说服力的做法
如果只给出一个注释标签,证据不够。建议至少配合以下内容。
- marker基因气泡图。
- 热图。
- UMAP标注图。
- 细胞比例统计图。
图、表、文字三者要相互支持。 这是单细胞文章能否站得住的关键。
6. 结语:让注释更快,也更稳
单细胞注释本质上是在“速度”和“准确性”之间找平衡。纯手工判断可靠,但慢。纯自动化高效,但需要核对。更理想的方式,是用标准化工具先快速筛选,再结合专业判断完成最终确认。
WorkBuddy单细胞注释的价值,就在于把复杂流程变成更可控的分析路径。 对于追求效率、规范和可复现性的医学生、医生与科研人员来说,它能帮助你更快完成细胞类型识别,减少重复劳动,并把更多精力留给机制分析和文章写作。
如果你正在做单细胞项目,想要更快得到可用于论文的注释结果,不妨了解一下解螺旋的 WorkBuddy 通用单细胞注释能力。它更适合把注释这一步做得稳、做得快,也更利于你把课题继续往下推进。
- 引言Introduction
- 1. 为什么单细胞注释是关键步骤
- 2. 单细胞注释的基本逻辑
- 3. 在线工具如何完成单细胞注释
- 4. WorkBuddy在单细胞注释中的应用价值
- 5. 如何把注释结果写进论文
- 6. 结语:让注释更快,也更稳