

 4
 分享
引言Introduction
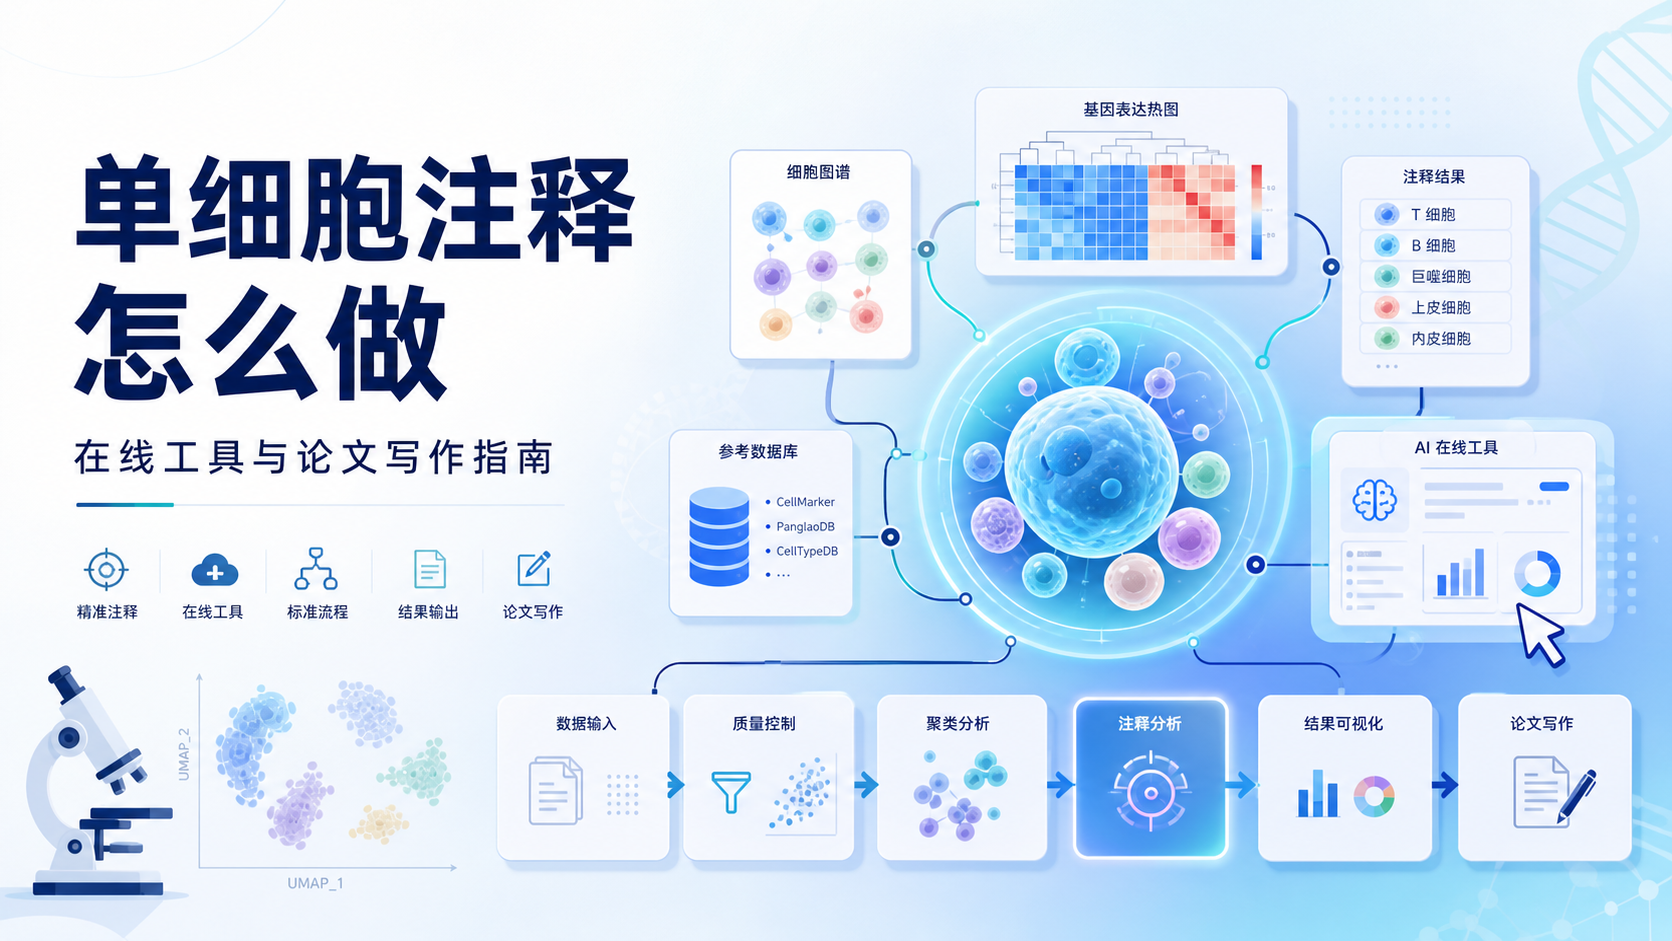
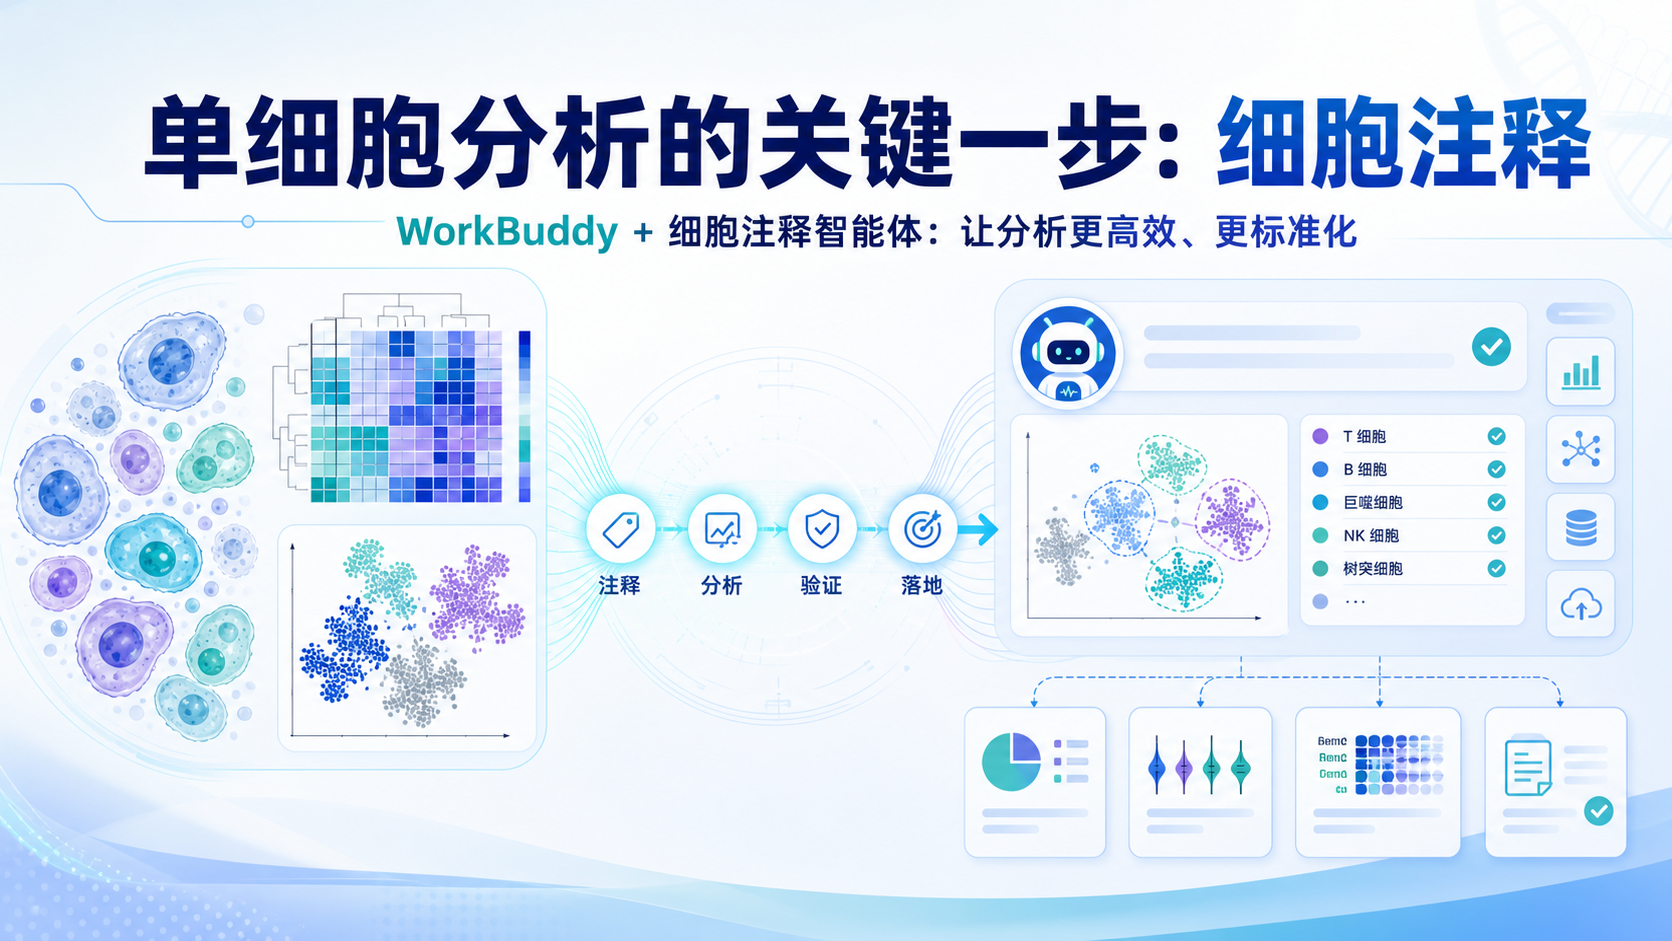
单细胞数据越做越大,细胞注释却常卡在“结果能跑出,标签难定准” 。手工查标记基因慢,在线工具多,但流程分散,重复劳动多。对医学生、医生和科研人员来说,真正需要的是一个能把数据、参考谱和分析步骤串起来的智能体。
1. 细胞注释为什么是单细胞分析的关键环节
1.1 细胞注释决定后续结论是否可信
单细胞测序的核心价值,不只是看见“有多少细胞”,而是回答“这些细胞是什么”。注释不准,后面的差异分析、轨迹分析、细胞通讯分析都会偏。
在真实研究中,T细胞、B细胞、髓系细胞、成纤维细胞、上皮细胞等大类通常能较快识别,但亚群层面的判断更依赖经验。比如同样是髓系细胞,单靠少数marker很容易把单核细胞、巨噬细胞和树突状细胞混淆。
1.2 细胞注释本质上依赖两类信息
细胞注释通常有两条思路。
- 基于已有参考数据进行预测。
这是当前最常用的方法。把待测表达矩阵与参考表达谱、标签基因集或数据库比对。 - 从头识别新细胞群。
适用于参考不足、组织特殊或疾病状态明显改变的场景,但对经验要求更高。
从数据来源看,常用参考包括 GO、KEGG、MsigDB 等功能数据库,以及 GEO、ArrayExpress 这类表达谱资源。参考库越规范,注释越稳定。
1.3 WorkBuddy适合解决什么问题
对于多数科研团队,难点不在“有没有工具”,而在“工具很多,流程很碎”。一个项目里可能同时需要质控、分群、marker筛选、在线注释、结果整理。
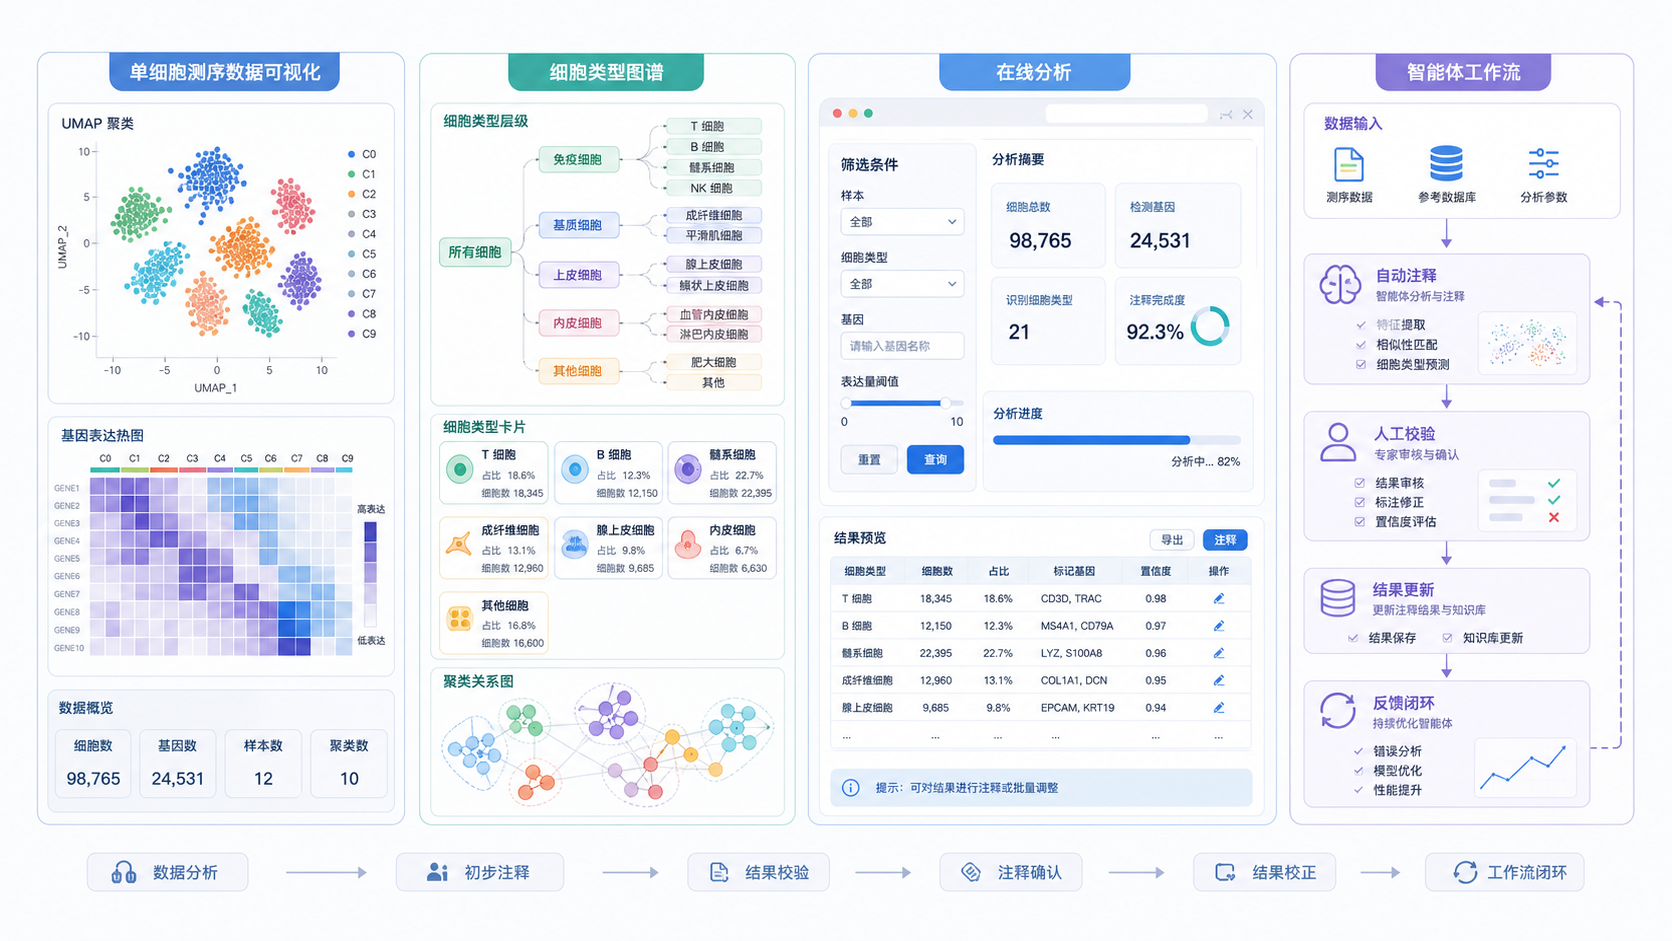
WorkBuddy+细胞注释智能体的价值,在于把这些步骤串成可执行流程。 它更像一个科研助理,而不是单点工具。对需要快速形成初稿、筛选候选细胞群、整理汇报结果的场景尤其有用。
2. 细胞注释的主流工具与方法逻辑
2.1 在线工具为何仍然重要
即使在R或Python里可以完成复杂分析,在线工具仍有价值。原因很简单,它们适合做快速验证、结果交叉检查和教学演示。
课程中提到的 EPIC 和 TIMER,就属于常用的在线分析思路。前者强调基于参考细胞类型表达谱进行推断,后者更偏向免疫浸润分析和肿瘤相关场景。
2.2 EPIC和TIMER分别解决什么
EPIC数据库可以上传表达矩阵,选择参考细胞类型和自定义参考集后运行分析。它输出表格和图形结果,如柱状图、箱线图和热图。
TIMER则常用于免疫细胞浸润相关分析。用户上传表达矩阵后,可获取不同样本的免疫推断结果,并导出表格和图形。
这两类工具共同说明一个事实:细胞注释不是单一算法问题,而是“参考谱选择+表达矩阵质量+结果解释”三者共同决定。
2.3 常见方法的优劣对比
从实际应用看,细胞注释方法各有边界。
- 标签基因法 ,直观,但依赖经验。
- 参考映射法 ,稳定,适合批量样本。
- 数据库驱动法 ,标准化程度高,适合教学和快速分析。
- 从头推断法 ,更灵活,但更考验专业判断。
最稳妥的策略不是只依赖一种方法,而是先自动注释,再人工复核。 这也是智能体最容易发挥价值的地方。
3. WorkBuddy+细胞注释智能体的实战思路
3.1 智能体不是替代专业判断,而是提高效率
科研中最浪费时间的,往往不是分析本身,而是反复切换软件、查资料、对照marker、整理输出。
WorkBuddy+细胞注释智能体的核心作用,是把“查、比、判、写”整合起来。
它适合处理以下任务:
- 生成分析步骤清单。
- 推荐注释参考方向。
- 整理候选细胞标签。
- 输出结果摘要,方便写进方法和结果部分。
3.2 实战流程可以拆成四步
一个更符合科研习惯的流程通常是:
- 准备输入文件。
例如表达矩阵、样本信息、参考细胞类型或marker列表。 - 执行初步注释。
用参考表达谱或标记基因集进行分类。 - 人工复核关键群。
对边界不清的细胞群,检查典型marker表达。 - 输出可写作结果。
包括细胞比例、注释图、富集信息和可复现实验步骤。
真正高效的工作流,不是一步给答案,而是让每一步都能被审计和复现。
3.3 为什么适合教学、科研和临床转化
对医学生,智能体能帮助建立单细胞分析的基本框架。
对医生,它能更快把临床样本与免疫微环境、炎症状态、肿瘤异质性联系起来。
对科研人员,它则更适合做标准化模板,提升项目周转速度。
尤其在疾病样本量有限、时间窗口紧张的情况下,先用智能体完成初筛,再进入深入机制验证,效率会高很多。
4. 从课程案例看,细胞注释如何真正落地
4.1 在线工具实操说明了什么
课程中的实战部分给出了完整文件结构。比如,EPIC 有输入文件、参考文件和结果文件,TIMER 也有输入和输出文件。
这说明细胞注释分析并不是“点一下按钮就结束”,而是一个标准化的数据流程。
输入文件是否规范,直接决定后续结果能否复现。
4.2 结果解读比结果生成更重要
很多人能跑出表格,却不会解释。
实际上,细胞注释结果至少要看三层内容:
- 细胞类型比例是否合理。
- marker是否符合生物学常识。
- 不同样本之间是否存在一致性或偏移。
如果结果与已知组织来源不符,就要回头检查批次效应、参考集选择和低质量细胞过滤。这一步往往比重新跑模型更重要。
4.3 智能体最适合补上的短板
WorkBuddy+细胞注释智能体的优势,不在于制造“神奇答案”,而在于减少低价值重复劳动。
例如,它可以帮助你快速整理:
- 某个细胞群的候选marker。
- 某个数据集适合用哪类参考谱。
- 某个分析结果如何写成规范语言。
- 哪些群需要进一步实验验证。
对于需要高频产出结果的团队,这种标准化辅助非常实用。
5. 细胞注释走向智能体化,意味着什么
5.1 对研究者来说,门槛在下降
过去,细胞注释高度依赖个人经验。现在,数据库、在线工具和智能体正在把这件事流程化。
这不意味着专业能力不重要,恰恰相反。越是工具成熟,越要求研究者具备判断能力。
能不能识别异常群体,能不能结合疾病背景解释结果,决定了研究质量。
5.2 对项目管理来说,效率在提升
一个成熟的智能体流程,至少能减少三类成本:
- 查文献的时间成本。
- 反复试错的计算成本。
- 结果整理和汇报的沟通成本。
对于团队合作项目,这种效率提升非常明显。尤其当你要同时推进多个样本、多个亚群、多个分析模块时,智能体能显著减少碎片化工作。
5.3 对未来方向来说,标准化会越来越重要
单细胞研究未来不会只拼“谁跑得快”,而会拼“谁更规范”。
可复现、可解释、可迁移,才是长期竞争力。
WorkBuddy+细胞注释智能体如果能把分析步骤、参考来源、结果解释和写作模板统一起来,就不仅是工具,而是科研流程的一部分。
总结Conclusion
细胞注释是单细胞研究的起点,也是最容易出错的一步。真正高质量的注释,必须同时满足参考充分、流程规范和人工复核。 从EPIC、TIMER这类在线工具,到更进一步的智能体化工作流,核心目标都是提升效率并降低误判。
如果你希望把细胞注释从“手工查表”升级为“标准化、可复现、可写作”的流程,WorkBuddy+细胞注释智能体 是很值得尝试的方向。想进一步把分析流程做成研究模板,可以关注解螺旋,获取更系统的生信实战支持。
- 引言Introduction
- 1. 细胞注释为什么是单细胞分析的关键环节
- 2. 细胞注释的主流工具与方法逻辑
- 3. WorkBuddy+细胞注释智能体的实战思路
- 4. 从课程案例看,细胞注释如何真正落地
- 5. 细胞注释走向智能体化,意味着什么
- 总结Conclusion