

 3
 分享
引言Introduction
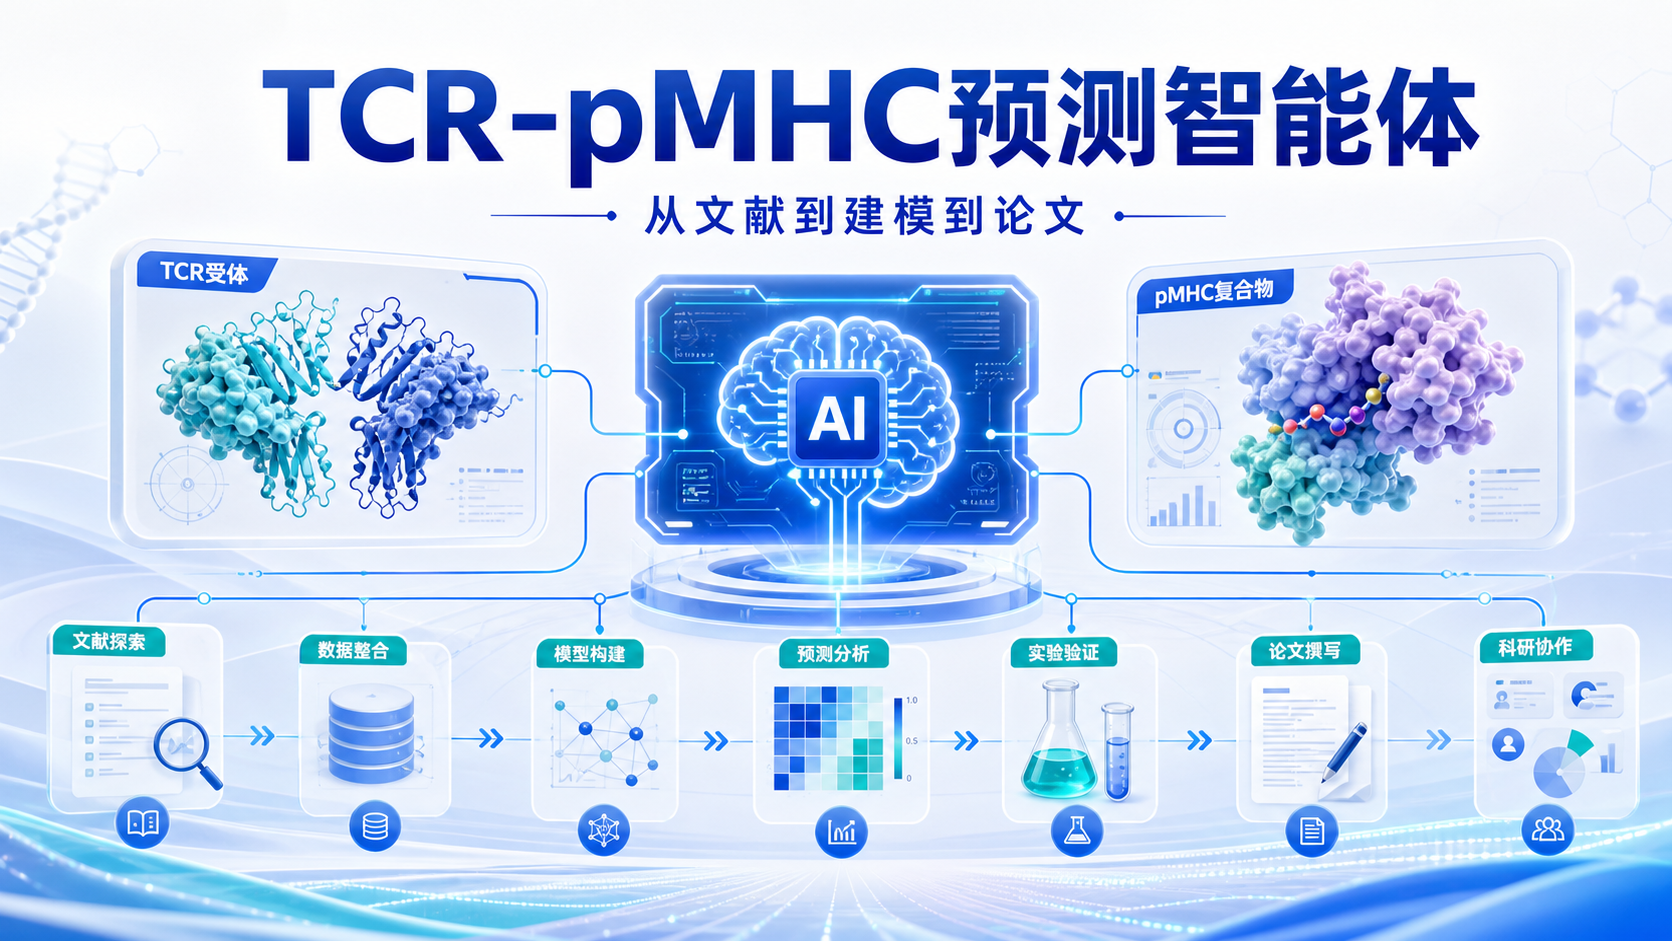
TCR-pMHC预测是免疫研究中的高频难题。数据分散、流程复杂、模型选择多,很多团队卡在“能做分析,却难以复现和落地”。WorkBuddy智能体把文献分析、流程提炼和任务执行串成一条线,适合科研人员快速建立可执行的TCR-pMHC预测方案。 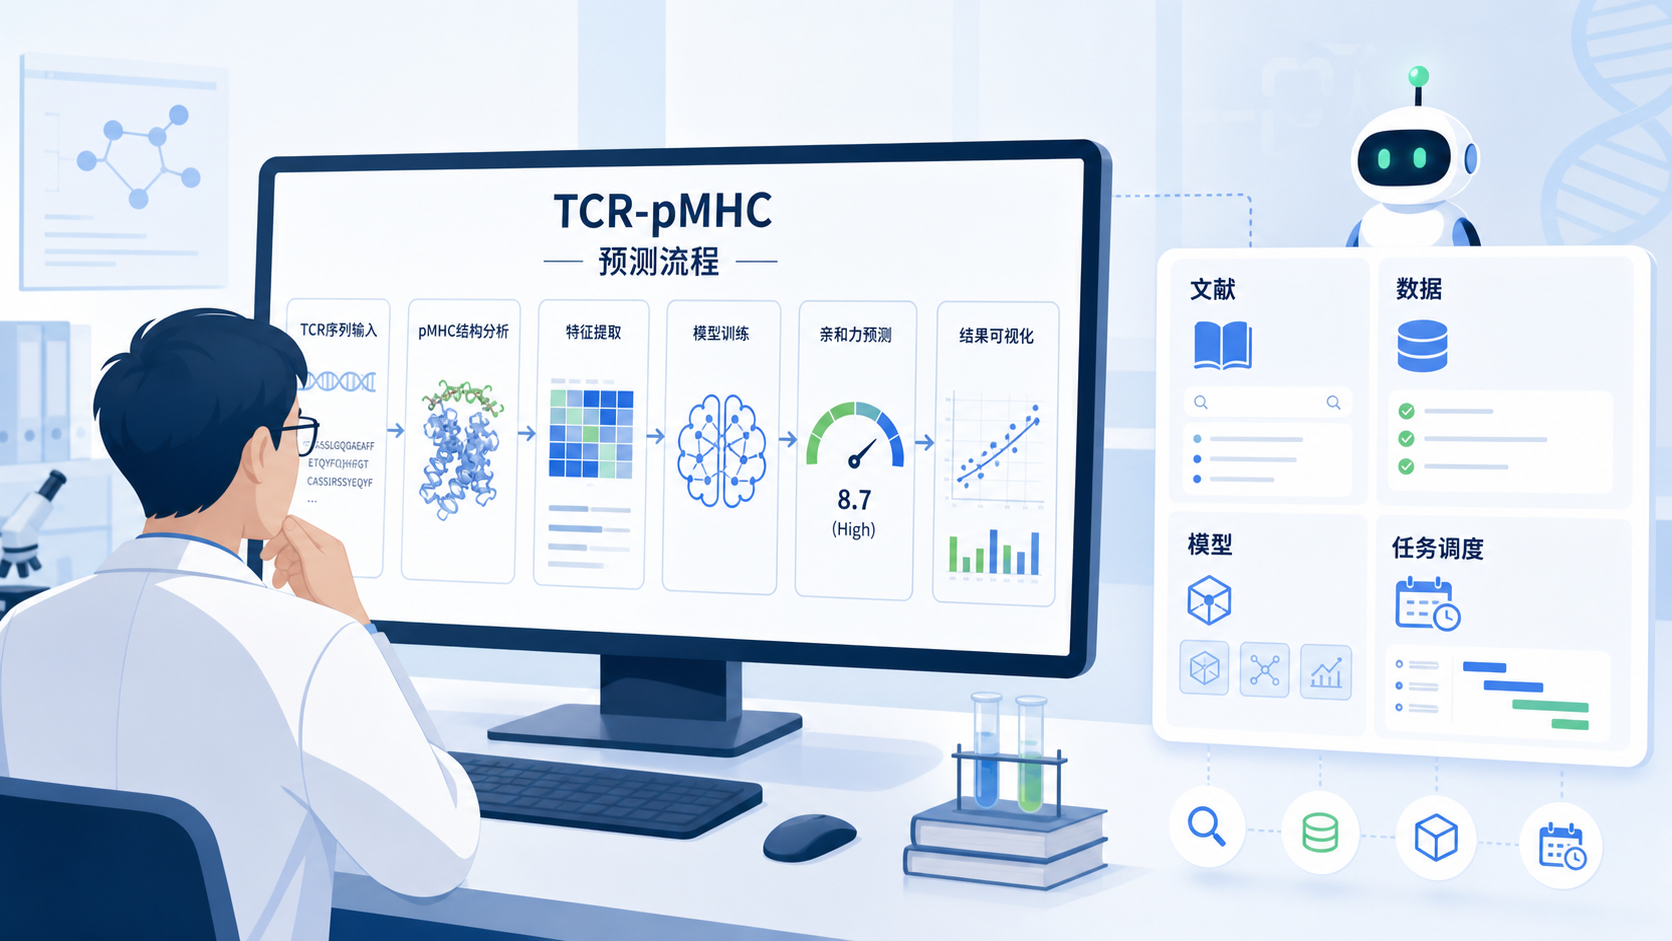
1. 为什么TCR-pMHC预测需要智能体
1.1 传统流程的三个痛点
TCR-pMHC预测涉及免疫识别机制、序列特征建模和多源数据整合。常规做法往往依赖人工筛文献、手工整理数据,再逐步搭建模型。这个过程耗时长,且容易在数据标准不一致时出错。
真正的难点不只是建模,而是把研究问题拆成可执行步骤。 例如,输入数据类型、负样本构建方式、特征编码方法、训练验证策略,这些环节任何一个不统一,结果都可能失真。
1.2 为什么“会跑模型”还不够
对于医学生、医生和科研人员来说,单纯跑出一个AUC并不能解决问题。TCR-pMHC研究更看重的是可解释性、可复现性和后续扩展性。
如果缺少流程化支持,常见结果是:
- 文献很多,但没有形成清晰假设。
- 工具很多,但不知道先用哪个。
- 结果出来了,但无法转成下一步研究方案。
WorkBuddy智能体的价值,就在于把“分析套路”提前结构化。 它不是只输出结论,而是帮助用户看到整个研究路线。
2. WorkBuddy智能体如何重构TCR-pMHC预测流程
2.1 从文献到研究路线的自动提炼
WorkBuddy加上定制skill后,可以把一篇文章的分析框架提炼出来,再转化为可执行的研究步骤。对TCR-pMHC预测来说,这一步非常关键,因为很多研究不是缺模型,而是缺“从哪里开始”的判断。
例如,智能体可以帮助用户梳理:
- 研究对象是TCR序列、pMHC复合物,还是两者联合特征。
- 任务类型是分类、亲和力预测,还是结合位点识别。
- 数据来源是公开数据库、内部实验数据,还是二者联合。
- 评价指标采用AUC、F1、准确率,还是更适合不平衡数据的PR-AUC。
这类结构化输出,比零散的摘要更接近科研实战。
2.2 用skill把重复劳动变成标准动作
在科研场景里,很多步骤具有高度重复性。比如文献梳理、表格整理、模型参数记录、结果摘要。智能体配合skill之后,可以把这些工作标准化,减少人为遗漏。
对于TCR-pMHC预测,这意味着用户不必每次重新设计一套流程,而是直接调用成熟模块。
常见可预装能力包括:
- 文献检索与筛选。
- 研究问题拆解。
- 分析流程生成。
- 结果结构化输出。
- 进一步延伸为研究方案或学习计划。
这比单次问答更适合科研工作流。 因为科研不是一次性回答,而是连续推进。
2.3 适合新手,也能提升高手效率
很多AI工具的问题在于,高手觉得不够灵活,新手又不知道怎么用。WorkBuddy的优势在于,它不是只给一个答案,而是给一个可以继续扩展的分析框架。
对新手来说,它能降低起点门槛。
对有经验的研究者来说,它能节省前期整理时间。
尤其在TCR-pMHC预测这类跨免疫学、计算生物学和机器学习的题目中,流程清晰本身就是竞争力。
3. TCR-pMHC预测智能体的科研应用场景
3.1 文献综述与选题设计
TCR-pMHC方向的文献更新快,数据库和模型方法也在持续变化。智能体可以先帮助用户把某一类主题的主线梳理出来,再进一步识别可切入的空白点。
例如,用户可以围绕以下方向展开:
- 不同TCR编码方式的比较。
- pMHC结构信息是否应纳入建模。
- 负样本构建对预测性能的影响。
- 不同模型在小样本场景下的泛化能力。
这类输出的核心价值,是把“看文献”变成“找问题”。
3.2 预测建模与实验设计
TCR-pMHC预测不是纯算法问题,也不是纯生物学问题。它需要把序列数据、实验验证和统计评估串起来。智能体在这里的作用,是帮助用户提前规划研究步骤。
一个更合理的流程通常包括:
- 明确预测任务和终点。
- 整理可用样本及标签规则。
- 设计训练集、验证集和测试集划分。
- 选择编码与模型。
- 设定评价指标和外部验证策略。
- 形成结果解释与后续实验建议。
如果前面一步没想清楚,后面再强的模型也很难补救。
3.3 从结果到论文的转换
很多科研项目的问题不在于没结果,而在于结果无法组织成论文逻辑。WorkBuddy智能体的价值之一,是能把分析路线、核心结果和可视化思路组织起来,帮助研究者快速形成初稿框架。
对于TCR-pMHC预测,论文通常需要回答三个层次的问题:
- 预测是否有效。
- 方法是否优于基线。
- 机制解释是否成立。
智能体适合做的,不只是“写”,而是把写作前的逻辑准备好。
4. 数据、模型与平台选择的现实边界
4.1 数据库整合的限制
TCR-pMHC研究依赖公开数据库,但现实中数据库接入并不总是顺畅。不同数据库的格式、权限和接口都不同。对于中文数据库,还可能存在API缺失和版权问题。
因此,在实际使用中,更可行的方案通常是:
- 优先使用有明确接口和结构化数据的资源。
- 对无法直接调用的数据,采用人工授权或半自动下载。
- 在分析前统一格式,减少后续清洗成本。
智能体不是替代数据治理,而是提升数据治理效率。
4.2 大模型、agent和workflow的区别
很多人会把智能体、工作台和workflow混为一谈。实际上,它们并不完全相同。
workflow更像流程编排。
agent更强调任务理解、自主调用和连续执行。
对于TCR-pMHC预测,agent模式更适合复杂任务,因为它能围绕目标自动拆分步骤,而不是只执行固定模板。这也是WorkBuddy这类智能体更适合科研场景的原因。
4.3 为什么后端化更重要
如果每一步都要手工点选,效率会明显下降。更理想的方式,是把分析模块后端化,让智能体在后台完成检索、整理、归纳和生成。这样不仅更快,也更稳定。
对科研用户来说,速度提升不是锦上添花,而是直接影响迭代效率。
从“十分钟一个模块”到“几十秒一个模块”,意味着你可以更快完成假设验证。
5. WorkBuddy+TCR-pMHC预测智能体的实际价值
5.1 把高门槛任务变成标准流程
TCR-pMHC预测之所以难,不只是技术难,也因为它涉及跨学科知识。WorkBuddy+skill的组合,实际上是在把高门槛知识流程化,让用户少走弯路。
它能帮助科研人员:
- 快速形成选题框架。
- 建立可复现的分析路线。
- 将文献分析转成研究方案。
- 将结果整理成论文写作提纲。
这对新手尤其重要,因为新手最缺的不是信息,而是路径。
5.2 更适合持续迭代的研究模式
科研不是一次性完成。TCR-pMHC研究尤其如此,因为新数据、新模型和新验证方法会不断出现。智能体的优势在于可持续更新skill,让流程跟着研究进展迭代。
这意味着未来用户不需要每次重建系统,只需要不断补充新的任务模块。
长期看,智能体会成为科研方法的一部分,而不是附属工具。
5.3 解螺旋的定位
如果你希望把TCR-pMHC预测从“想做”推进到“能做”,就需要一个能把文献、流程和任务执行连接起来的工具。解螺旋提供的WorkBuddy智能体,正是面向这类科研场景的解决方案。 它更适合帮助用户快速提炼分析套路,减少试错成本,并把结果进一步延展成研究方案、学习计划或论文框架。
总结Conclusion
TCR-pMHC预测是一个典型的高复杂度科研任务。它不仅考验模型能力,也考验问题拆解、数据组织和结果转化能力。WorkBuddy智能体的意义,不是替代研究者,而是让研究者更快进入有效工作状态。
如果你正在做TCR-pMHC相关研究,或者需要把文献分析转成可执行方案,建议尽早使用智能体化工具提升效率。现在就了解解螺旋,借助WorkBuddy+TCR-pMHC预测智能体,把你的科研流程从“手工整理”升级为“标准化执行”。
- 引言Introduction
- 1. 为什么TCR-pMHC预测需要智能体
- 2. WorkBuddy智能体如何重构TCR-pMHC预测流程
- 3. TCR-pMHC预测智能体的科研应用场景
- 4. 数据、模型与平台选择的现实边界
- 5. WorkBuddy+TCR-pMHC预测智能体的实际价值
- 总结Conclusion