14
 分享
全文概要
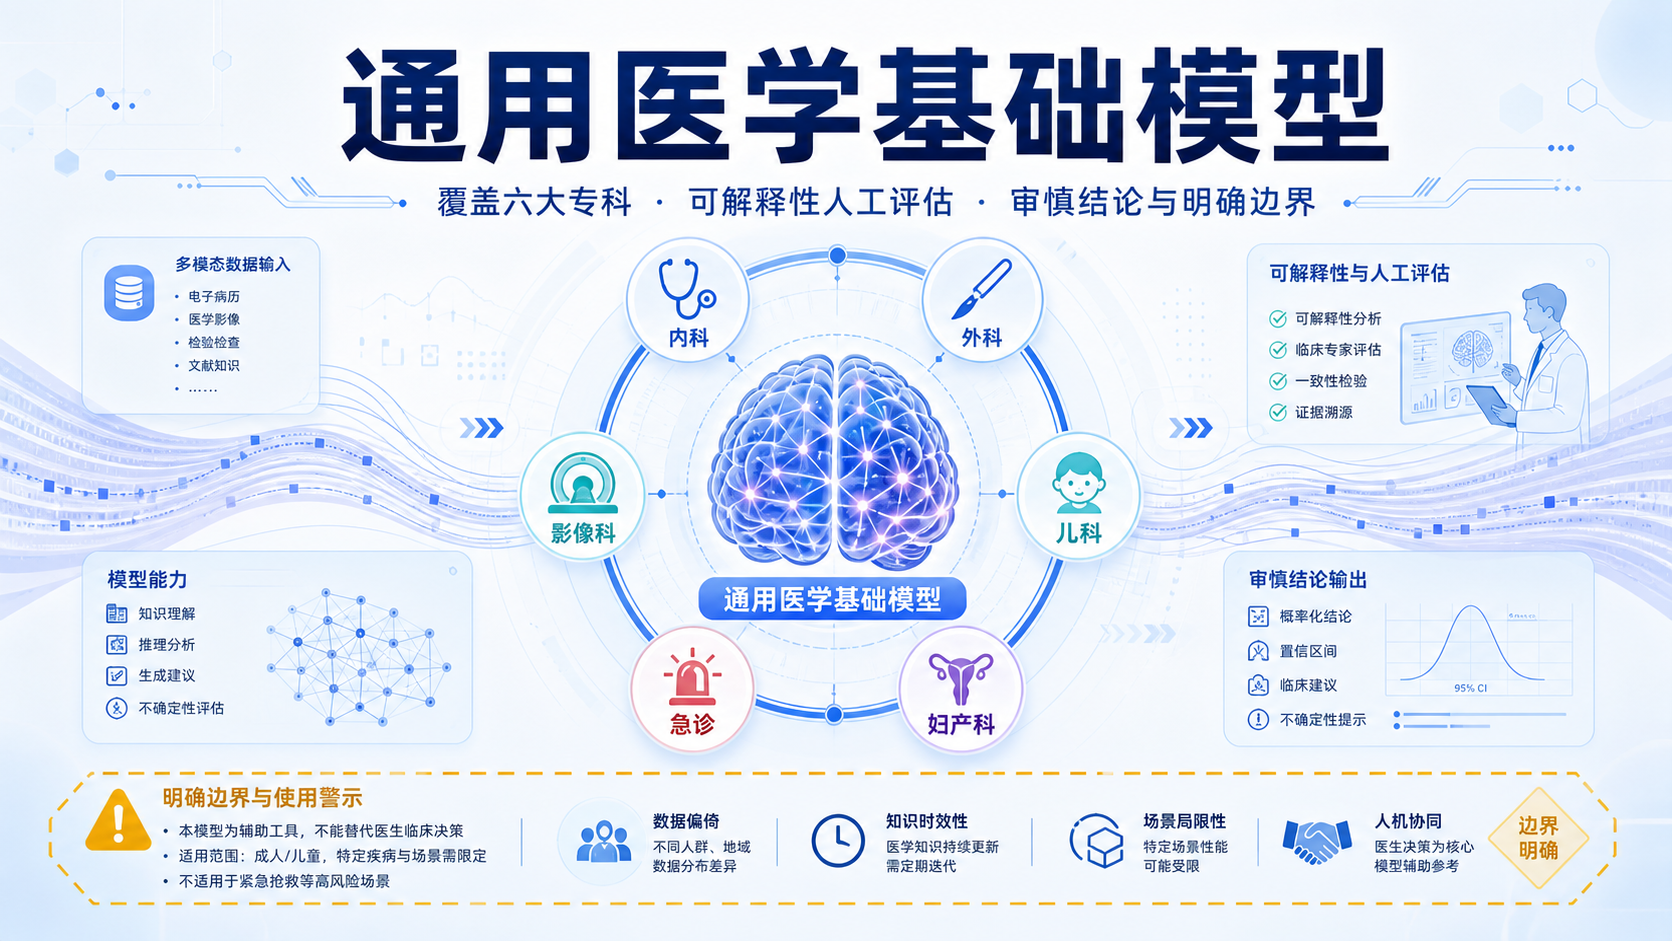
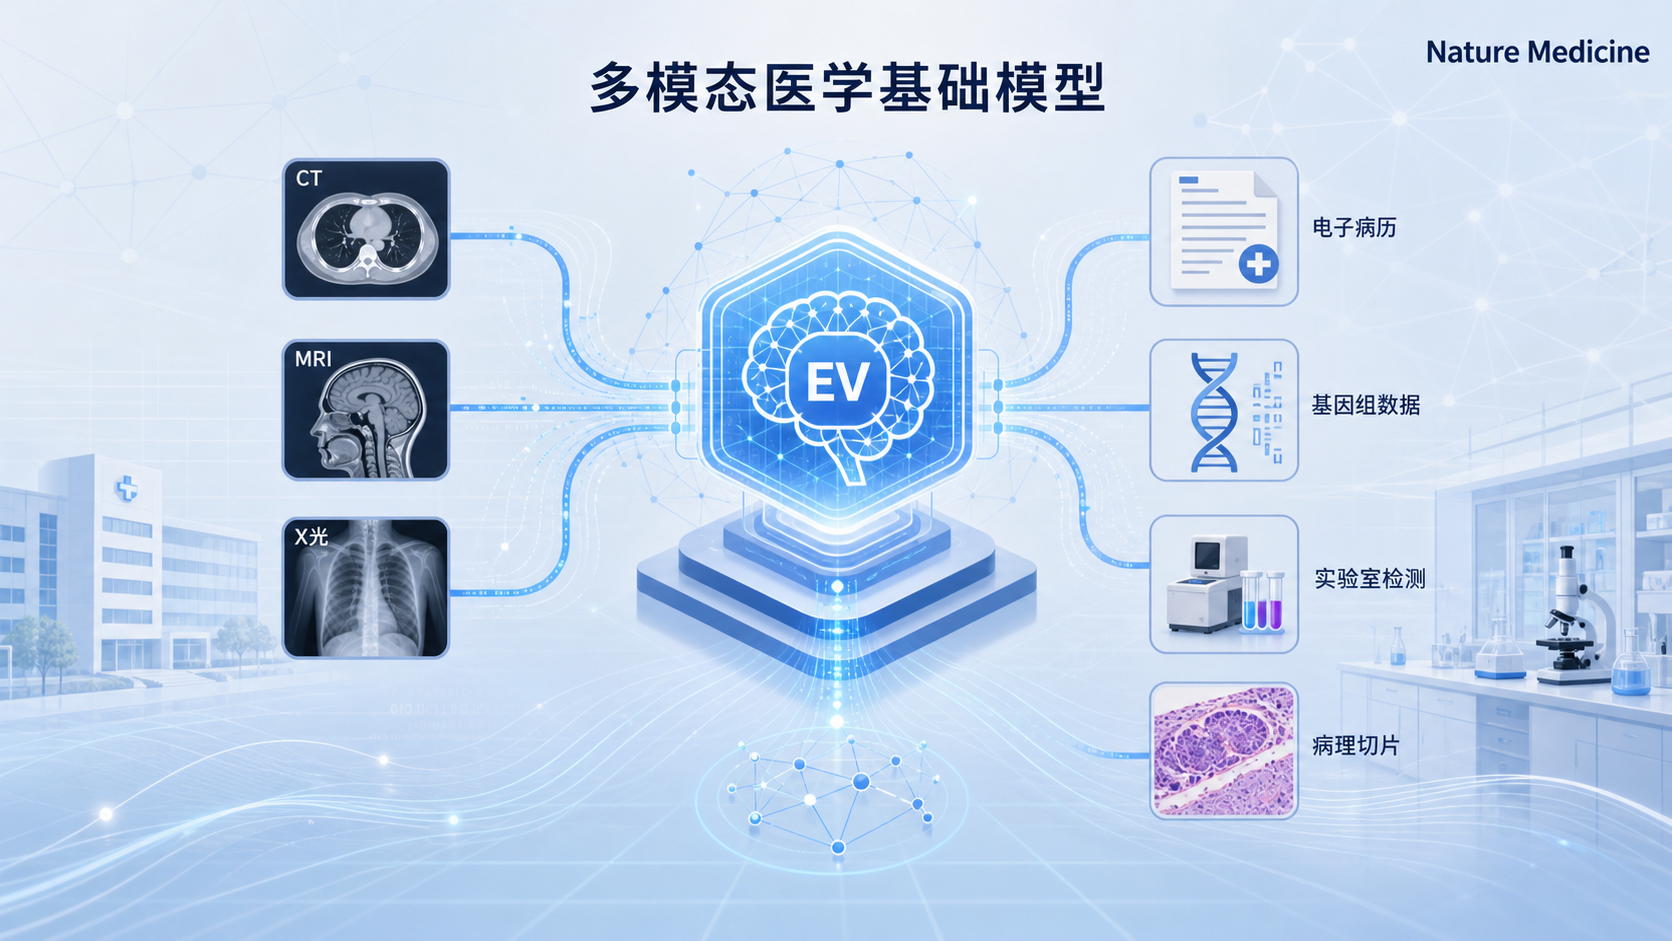
发表于《自然·医学》(Nature Medicine)的一项研究,报告了多模态医学基础模型 EVLF-FM 的开发与验证结果:该模型基于 18 个全球数据集、超过 130 万样本、覆盖 10 种影像模态与 6 大临床专科,在内部验证中平均诊断准确率达 0.895,并在 17 个外部数据集的 1.3 万余独立样本中进行了外部验证。
1. 覆盖六大临床专科的通用医学基础模型
EVLF-FM 是一项多模态医学基础模型研究,其开发与测试涵盖了超过 130 万个样本,来自 18 个全球数据集,横跨 10 种影像模态,涉及皮肤科、肝病科、眼科、病理科、呼吸科和放射科六大临床专科。这一"通用型"(generalist)设计,试图打破传统 AI 影像模型"一病一模、单模态"的局限,向跨专科、跨模态的通用医学视觉基础模型迈进。
在疾病诊断的内部验证中,EVLF-FM 取得了 0.895 的最高平均准确率,优于主流的通用模型与专科模型。在像素级视觉定位(visual grounding)任务上,其在九种模态中的平均交并比(IoU)达 0.842,说明模型不仅能"判断有无疾病",还能"指出病灶在哪"。
2. 可解释性经过人工评估检验
医学 AI 的"黑箱"问题是制约其落地的重要障碍。EVLF-FM 研究专门检验了模型的可解释性:采用 S.C.O.R.E. 框架,由人工评分员对模型的推理输出进行评估,总体平均得分达 4.25(满分 5 分),评分者间一致性从"substantial"到"几乎完美"(Gwet’s AC2 介于 0.5 至 0.93)。
这一设计回应了临床医生对 AI 可信度的核心关切——一个能说明"为什么"的模型,比单纯给出结论的模型更容易被医生接受、也更便于在临床中把关。
3. 审慎的结论与明确的边界
尽管内部与外部验证结果积极,研究作者仍以审慎态度明确了局限:当前仍需要在多样化的医疗环境中开展额外验证,且须通过前瞻性临床研究评估 EVLF-FM 的安全性、有效性与临床效用,方能考虑常规临床部署。
这提示,基础模型在医学影像领域的潜力虽大,但从"论文中的高准确率"到"临床中的真实可用",中间仍需跨越前瞻性验证、监管审批与真实世界落地等多重门槛。对临床与科研工作者而言,这类通用医学基础模型代表了一个值得持续关注的重要技术方向。
来源:《自然·医学》(Nature Medicine)EVLF-FM 研究论文及 The AI Edge 等科技简报

声明:本文资讯来源于公开报道及学术期刊,仅作行业信息传播,不构成临床用药建议。转载需注明来源。
- 1. 覆盖六大临床专科的通用医学基础模型
- 2. 可解释性经过人工评估检验
- 3. 审慎的结论与明确的边界