3
 分享
引言Introduction
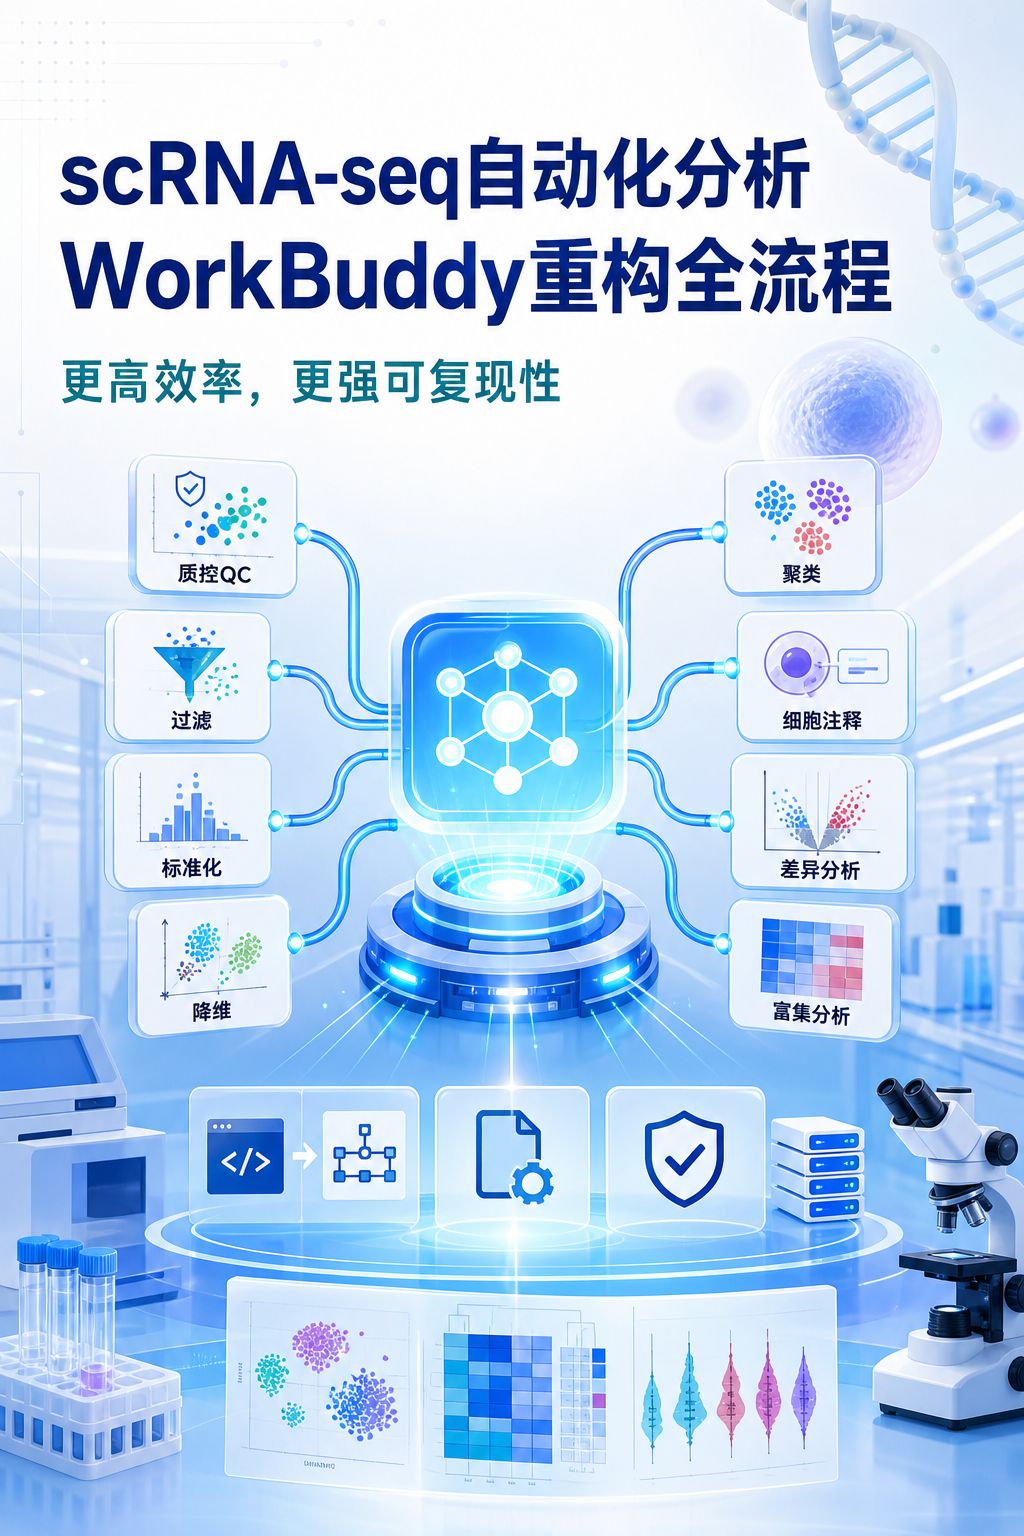
scRNA-seq分析流程长,步骤多,参数多。对很多医学生和科研人员来说,最难的不是拿到数据,而是把质控、过滤、归一化、降维、聚类、注释串起来,并保证结果可重复、可追溯。如果流程依赖手写代码,任何一个参数改动都可能带来结果偏差。
1. 为什么scRNA-seq分析特别需要自动化
1.1 scRNA-seq流程天然复杂
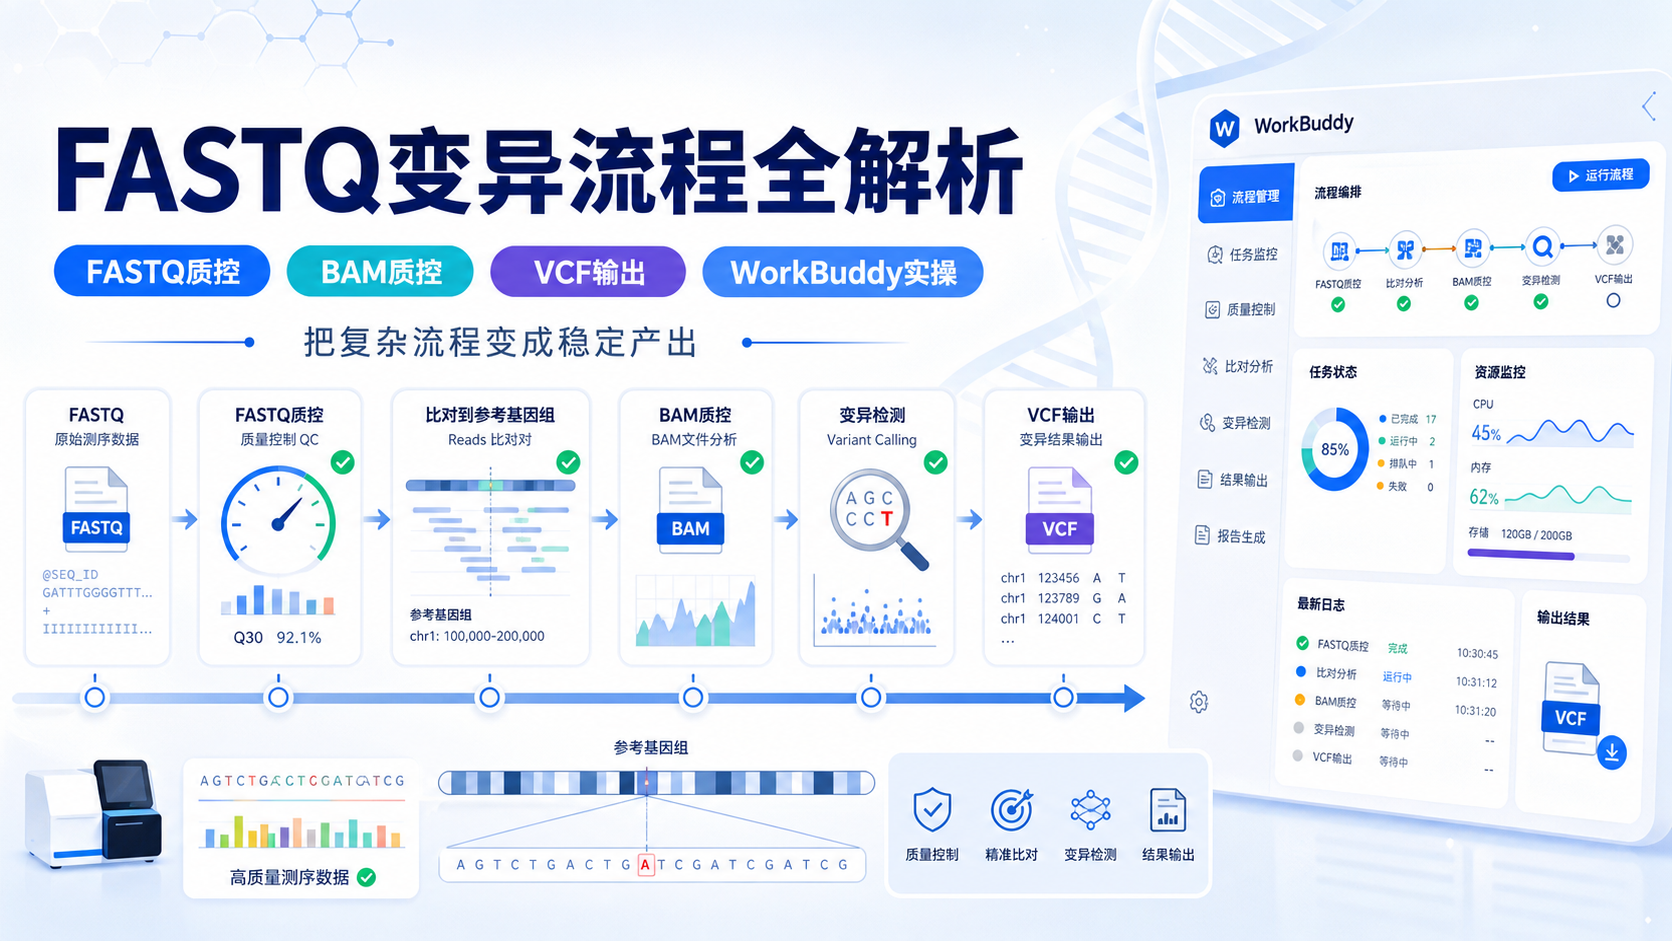
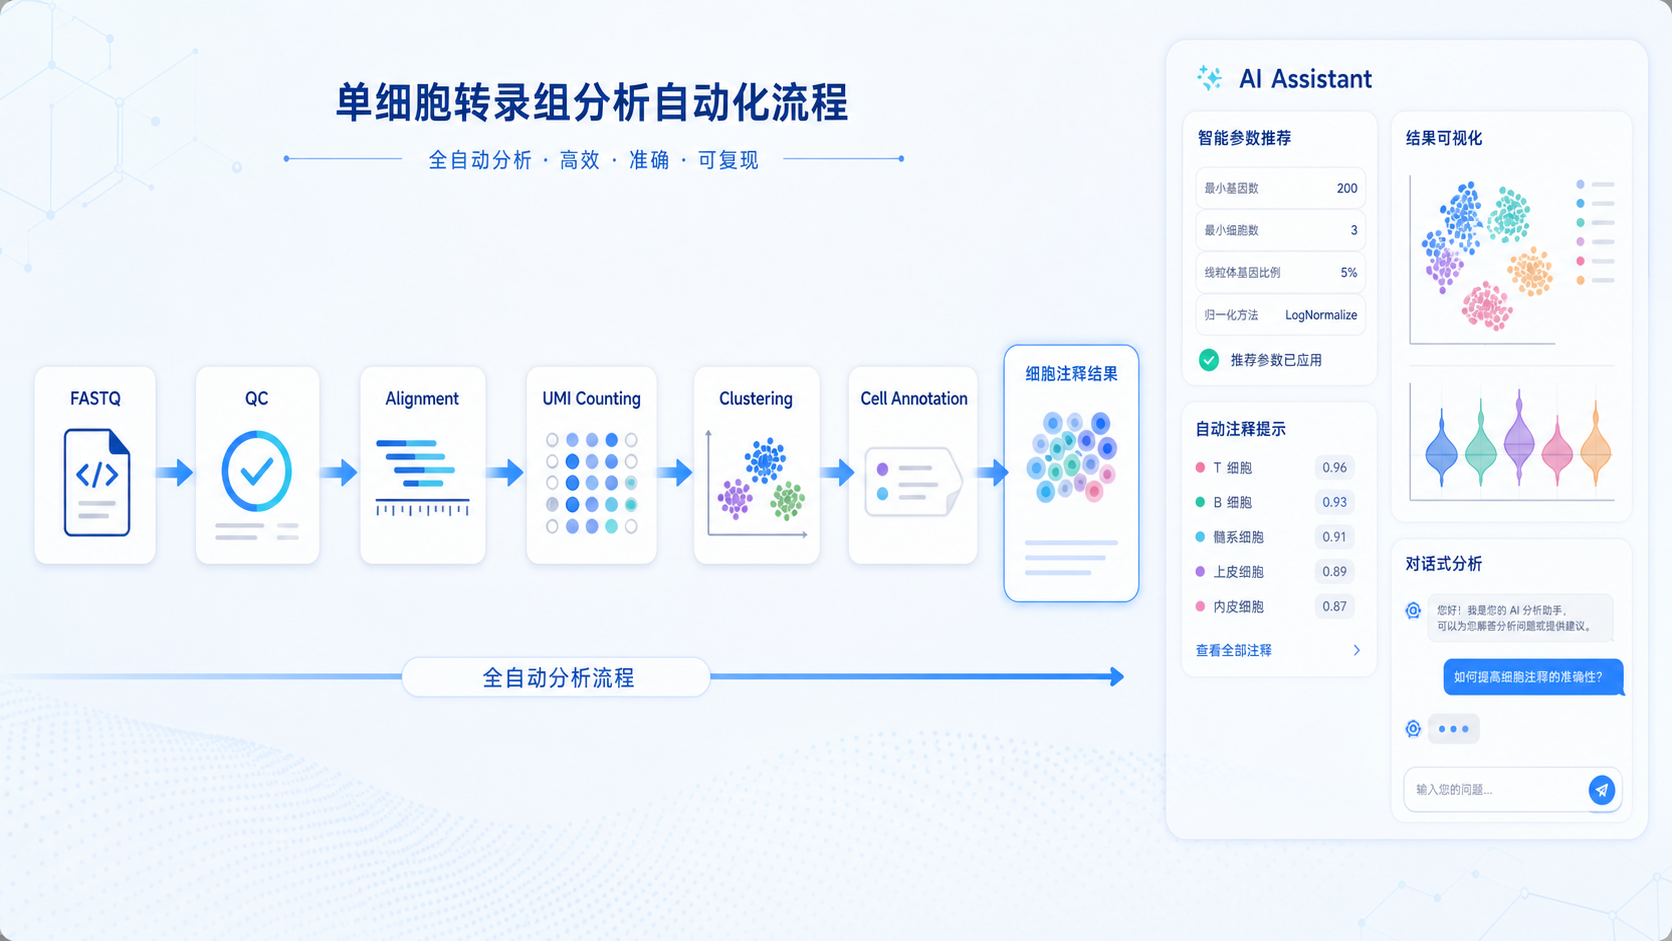
scRNA-seq不是单一步骤分析,而是一条连续链条。通常包括原始数据质控、比对或准比对、表达矩阵生成、细胞质控、归一化、批次校正、降维、聚类、差异表达、细胞类型注释和下游功能分析。每一步都可能影响最终结论。
以10x Genomics数据为例,常见分析对象是barcode、UMI和gene count矩阵。若前处理不一致,后续细胞数、基因数和聚类结果都会变化。对于临床样本或多中心数据,这种差异会进一步放大。
1.2 手写代码的核心痛点是不可复现
很多scRNA-seq分析依赖R或Python脚本。问题不在于代码本身,而在于代码执行链条太长,且参数敏感。比如Seurat、Scanpy、Harmony、SingleR等工具都很常用,但参数设置不同,结果可能明显不同。对不熟悉代码的人来说,最难的是判断结果是否合理。
知识库中已经点出一个关键事实。大模型可以生成代码,但同样的任务执行两次,输出未必一致。代码如果不能被熟练审核和测试,就会影响分析可信度。对科研而言,这不是效率问题,而是方法学问题。
1.3 自动化的价值在于把流程固定下来
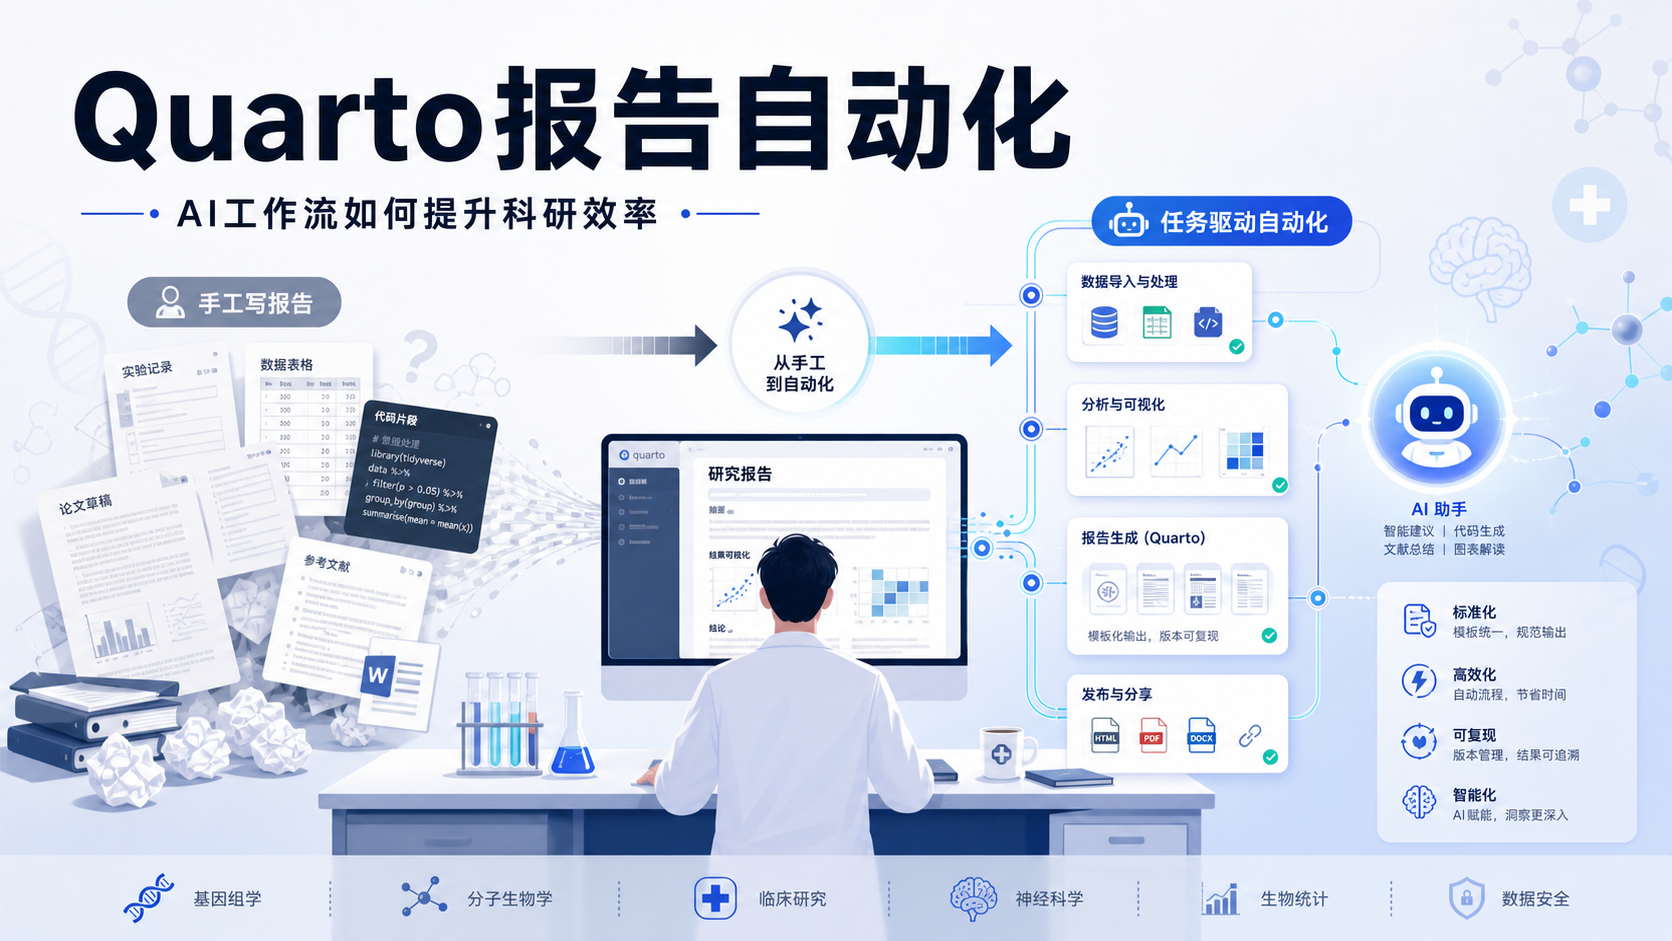
自动化不是替代科研判断,而是把可标准化的部分固定。比如:
- 统一输入格式。
- 统一参数模板。
- 统一输出目录和结果命名。
- 统一质控阈值和分析顺序。
这样做的好处很直接。同一批样本、同一套流程、同一组参数,可以得到更稳定的分析结果。 这对发表论文、做课题复现、做临床队列分析都很重要。
2. WorkBuddy如何重构scRNA-seq全流程
2.1 从“写代码”转向“调用流程”
WorkBuddy的核心思路,不是让用户从零写分析脚本,而是让系统调用固定工具和既定流程。这个方向更适合数据分析。因为scRNA-seq中很多步骤本来就是标准流程,适合用工具化方式实现,而不是每次都现写一遍。
知识库里提到,未来更理想的方式不是让AI随意生成代码,而是让它会使用R包和工具链。对生信分析来说,工具调用比自由生成代码更严谨,也更可复现。
2.2 WorkBuddy适合哪些分析场景
对于scRNA-seq,WorkBuddy更适合做以下几类任务:
- 原始数据处理和质控流程整理。
- 标准分析步骤的自动串联。
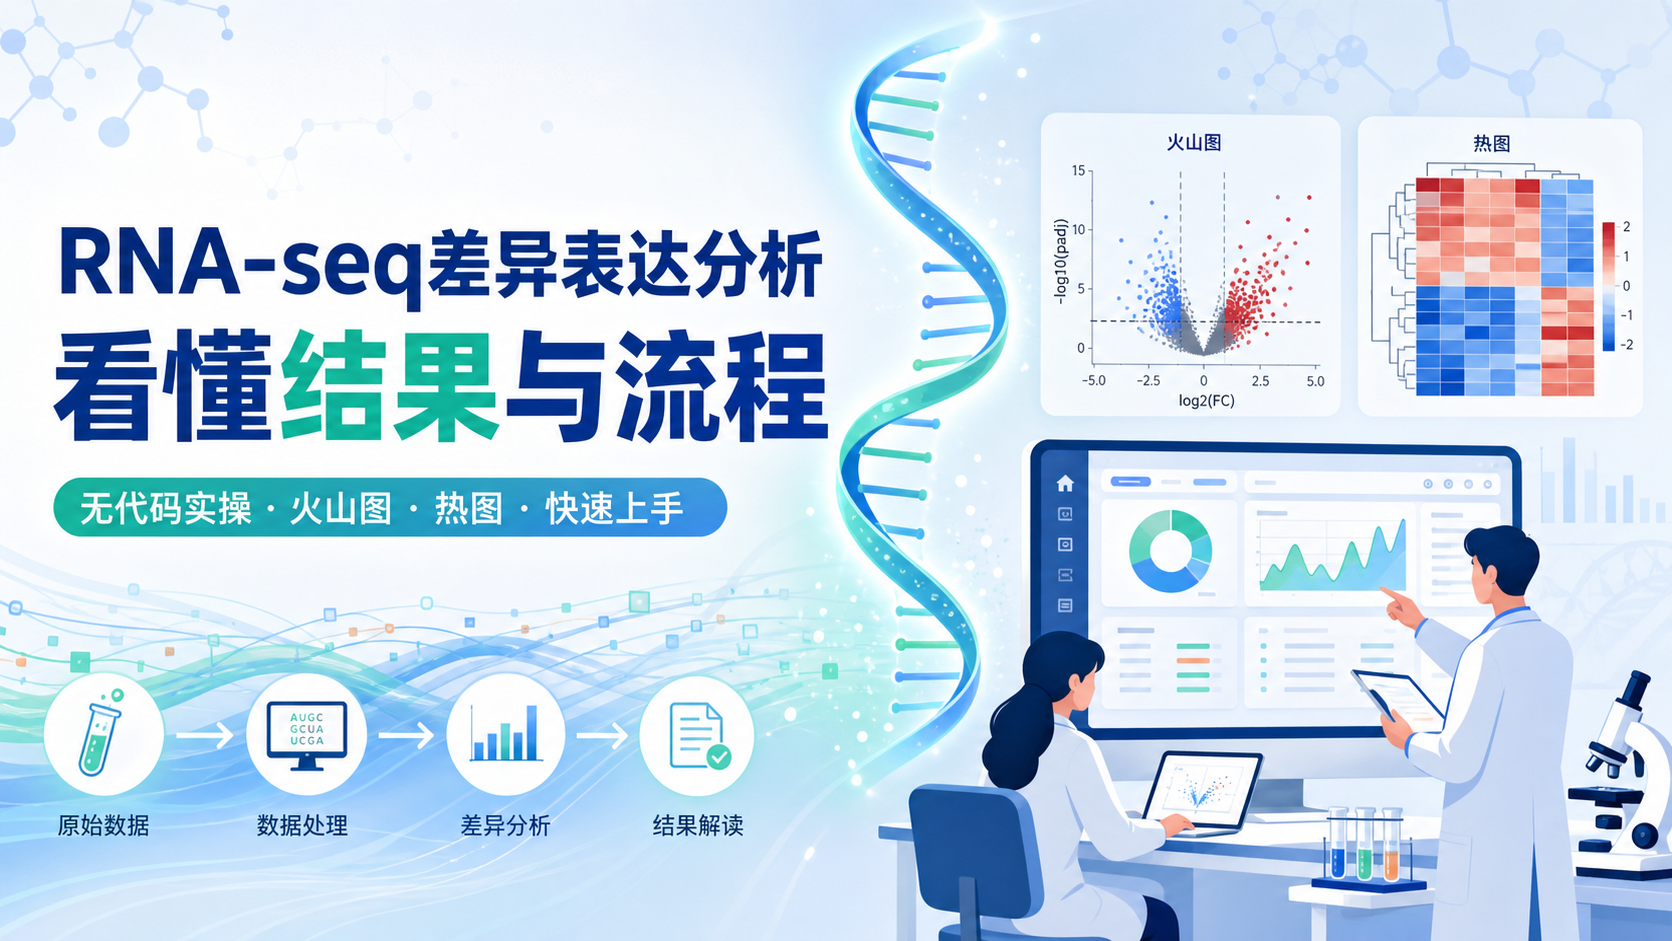
- 常规图表输出,如UMAP、热图、火山图、DotPlot。
- 差异基因筛选和功能富集的流程化执行。
- 研究方案或分析套路的自动提炼。
这些任务有一个共同点:流程固定,输入明确,输出可验证。这正是自动化最擅长的部分。
2.3 适合新人,也适合需要提效的老手
对新手来说,WorkBuddy最大的价值是降低入门门槛。你不需要先掌握大量脚本细节,也能先跑通主流程。对老手来说,它的价值在于减少重复劳动,让更多时间留给生物学解释。
但要注意,自动化不是“完全无脑点击”。科研人员仍需理解关键节点,例如:
- 细胞过滤阈值是否合理。
- doublet去除是否充分。
- 批次效应是否被过度校正。
- 聚类分辨率是否与样本复杂度匹配。
真正高质量的自动化,是让人把精力放在判断,而不是重复敲代码。
3. scRNA-seq全流程中,哪些步骤最值得自动化
3.1 质控、过滤和标准化最适合固定模板
scRNA-seq的前半段最适合自动化。因为这些步骤的目标明确,判断标准也相对统一。例如,通常会关注每个细胞的基因数、UMI数、线粒体比例和核糖体比例。不同数据集的阈值会变,但逻辑相似。
标准化步骤也很适合流程化。无论是Seurat中的LogNormalize,还是后续更复杂的整合分析,核心都是减少技术噪音对表达量的影响。只要模板固定,结果就更容易比较。
3.2 降维、聚类和注释需要标准流程加人工复核
降维与聚类是scRNA-seq结果展示的核心。常见步骤包括PCA、邻近图构建、UMAP或t-SNE可视化,再进行聚类。这里最容易出问题的是参数选择和解释偏差。
细胞注释同样如此。自动注释工具可以提高速度,但不应完全替代人工判断。比如SingleR、CellTypist或基于marker gene的注释,常常需要结合组织来源和研究背景进行修正。AI可以给出建议,最终结论仍应由研究者确认。
3.3 差异分析和富集分析最适合批量执行
当细胞群体已经分好后,后续差异分析和富集分析可以高度标准化。常见流程包括:
- 识别marker基因。
- 进行群间差异表达分析。
- 完成功能富集,如GO和KEGG。
- 输出图表和结果表。
这类任务高度重复,最适合用WorkBuddy这种方式批量执行。尤其在多组比较、多个细胞亚群比较时,人工操作非常耗时。流程自动化后,结果命名、图表保存和路径管理都更稳定。
4. 自动化分析如何提升可复现性和研究效率
4.1 固定配置文件,比临时改脚本更可靠
知识库中提到一个很重要的点。不同客户端如果换环境,只需要复制配置文件即可继续使用。这说明自动化系统的优势不只是“快”,而是“可迁移”。
对于科研项目来说,这一点非常关键。因为实验室常常会出现:
- 新成员接手项目。
- 不同电脑或服务器切换。
- 同一项目跨月份重复分析。
- 论文返修时需要重新出图。
如果流程都写在临时脚本里,维护成本会很高。如果流程被配置化,项目可交接性会大幅提升。
4.2 更适合临床研究和大队列项目
临床转录组研究往往强调样本多、批次多、时间跨度长。scRNA-seq如果叠加多患者、多病理分组、多中心数据,人工分析更容易出错。自动化流程可以帮助团队统一分析标准。
尤其在临床科研中,研究者更关心的是:
- 是否能稳定复现结果。
- 不同批次是否能保持一致处理。
- 结果是否便于审稿人追溯。
WorkBuddy这类工具的意义,就是把“分析动作”变成“可审计的流程”。
4.3 未来趋势是“工具驱动”,不是“自由生成”
从知识库内容可以看出,行业趋势正在从“AI现写代码”转向“AI调用工具”。原因很简单。现写代码不稳定,而固定工具链更符合生信分析的科学要求。尤其是在scRNA-seq这种对参数和流程敏感的场景,工具驱动更容易形成稳定标准。
这也是为什么自动化分析会成为未来主流。它不是降低专业性,而是把专业性放到更高层级。专业人员不再被重复劳动消耗,而是集中精力做实验设计、结果解释和论文表达。
5. 什么时候适合用WorkBuddy,什么时候仍需人工参与
5.1 适合直接自动化的场景
以下情况非常适合WorkBuddy:
- 标准10x scRNA-seq项目。
- 常规分群和细胞注释。
- marker筛选和可视化出图。
- 富集分析和结果整理。
- 多批次重复项目的统一处理。
这些任务流程固定,结果明确,最适合自动化。只要输入规范,输出通常也更规范。
5.2 仍然需要人工判断的场景
对于以下情况,人工判断仍不可替代:
- 样本质量差异很大。
- 组织来源复杂,细胞注释争议大。
- 需要特殊批次校正策略。
- 研究问题偏探索性,流程不完全标准化。
也就是说,WorkBuddy更像高效助手,而不是全自动替代者。它负责把流程跑顺,把重复工作做好。研究者负责提出问题、修正假设和解释生物学意义。这才是AI辅助分析最合理的分工。
5.3 对初学者最现实的价值,是先跑通再优化
很多初学者不是不会分析,而是不知道从哪一步开始。WorkBuddy的优势就在于,它能帮助用户先建立完整流程认知。先看到分析链条,再逐步理解每一步的意义。相比直接面对一堆脚本,这种方式更符合学习规律。
当用户熟悉流程后,就可以进一步调整参数、替换工具、细化分组,逐步进入高阶分析。这是从“会跑”到“会改”的路径。
总结Conclusion
scRNA-seq分析之所以难,不是因为某一个步骤复杂,而是因为整条流程长、参数多、重复性高。WorkBuddy的价值,在于把这些标准步骤工具化、流程化、配置化。 它让新手更容易入门,让老手更高效,也让临床和科研项目更可复现。
如果你正在做单细胞项目,或者经常需要重复执行相似分析流程,WorkBuddy+scRNA-seq流程会显著降低时间成本和出错概率。想把更多精力放在生物学解释和论文产出上,可以进一步了解解螺旋的相关产品与课程。
- 引言Introduction
- 1. 为什么scRNA-seq分析特别需要自动化
- 2. WorkBuddy如何重构scRNA-seq全流程
- 3. scRNA-seq全流程中,哪些步骤最值得自动化
- 4. 自动化分析如何提升可复现性和研究效率
- 5. 什么时候适合用WorkBuddy,什么时候仍需人工参与
- 总结Conclusion