3
 分享
引言Introduction
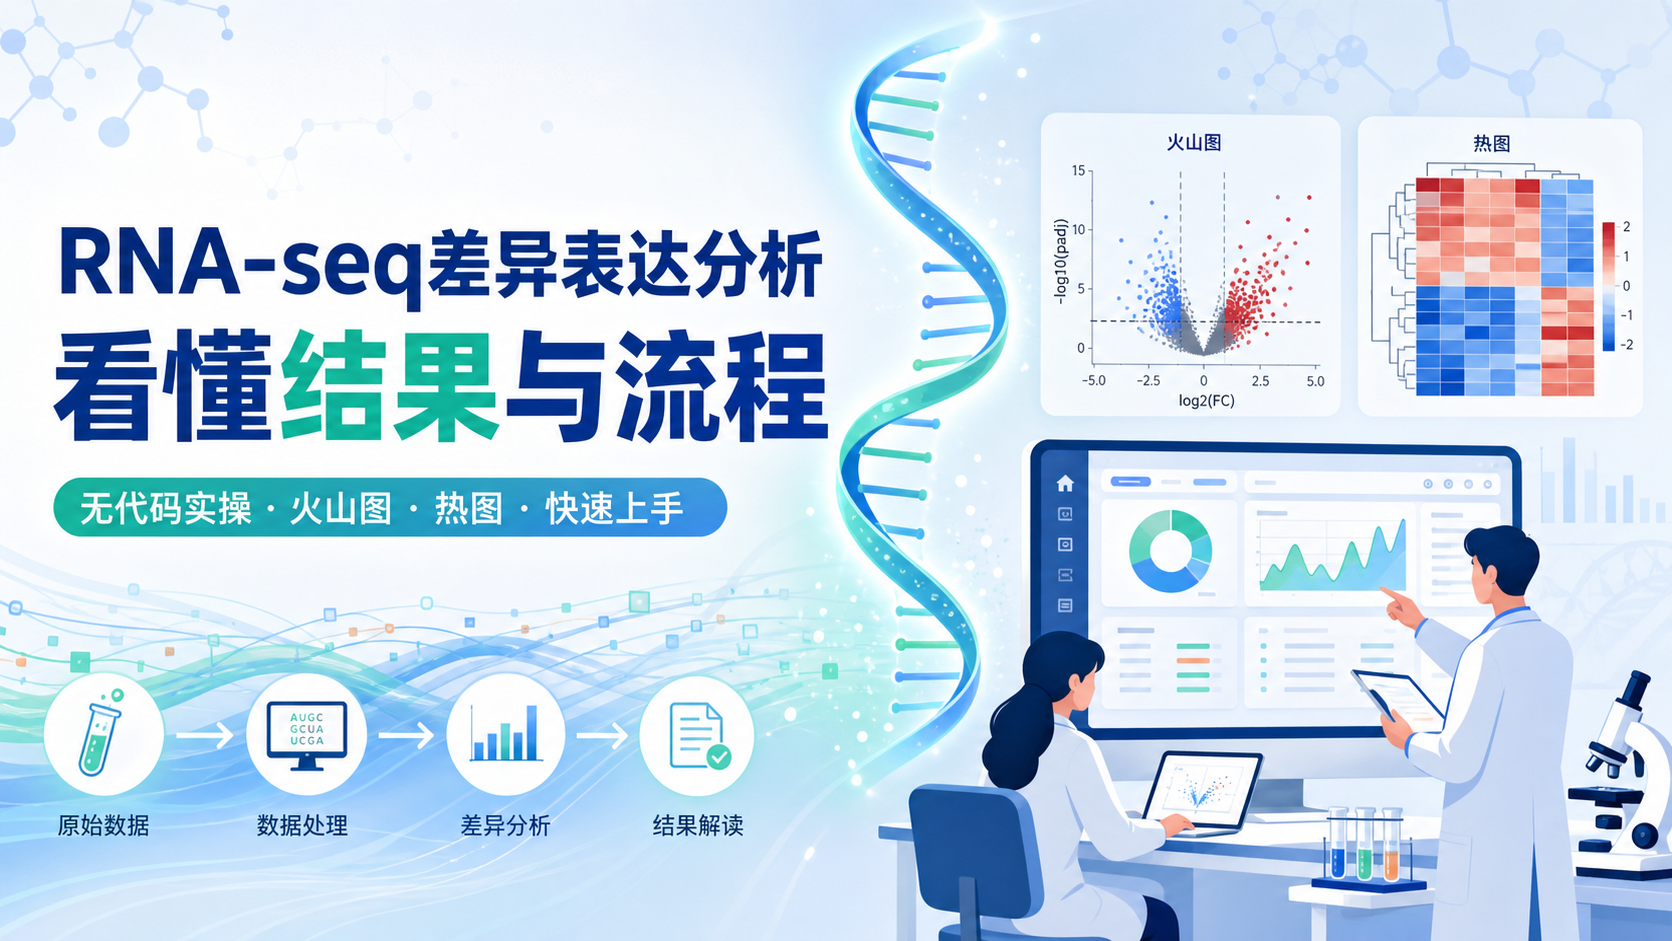
RNA-seq差异表达分析是转录组研究的起点,但对很多医学生和科研人员来说,真正的难点不是“知道要做”,而是“怎么快速、规范地做出来”。从样本分组、低表达过滤,到统计检验和可视化,任一步出错都会影响结论。
1.RNA-seq差异表达分析到底在看什么
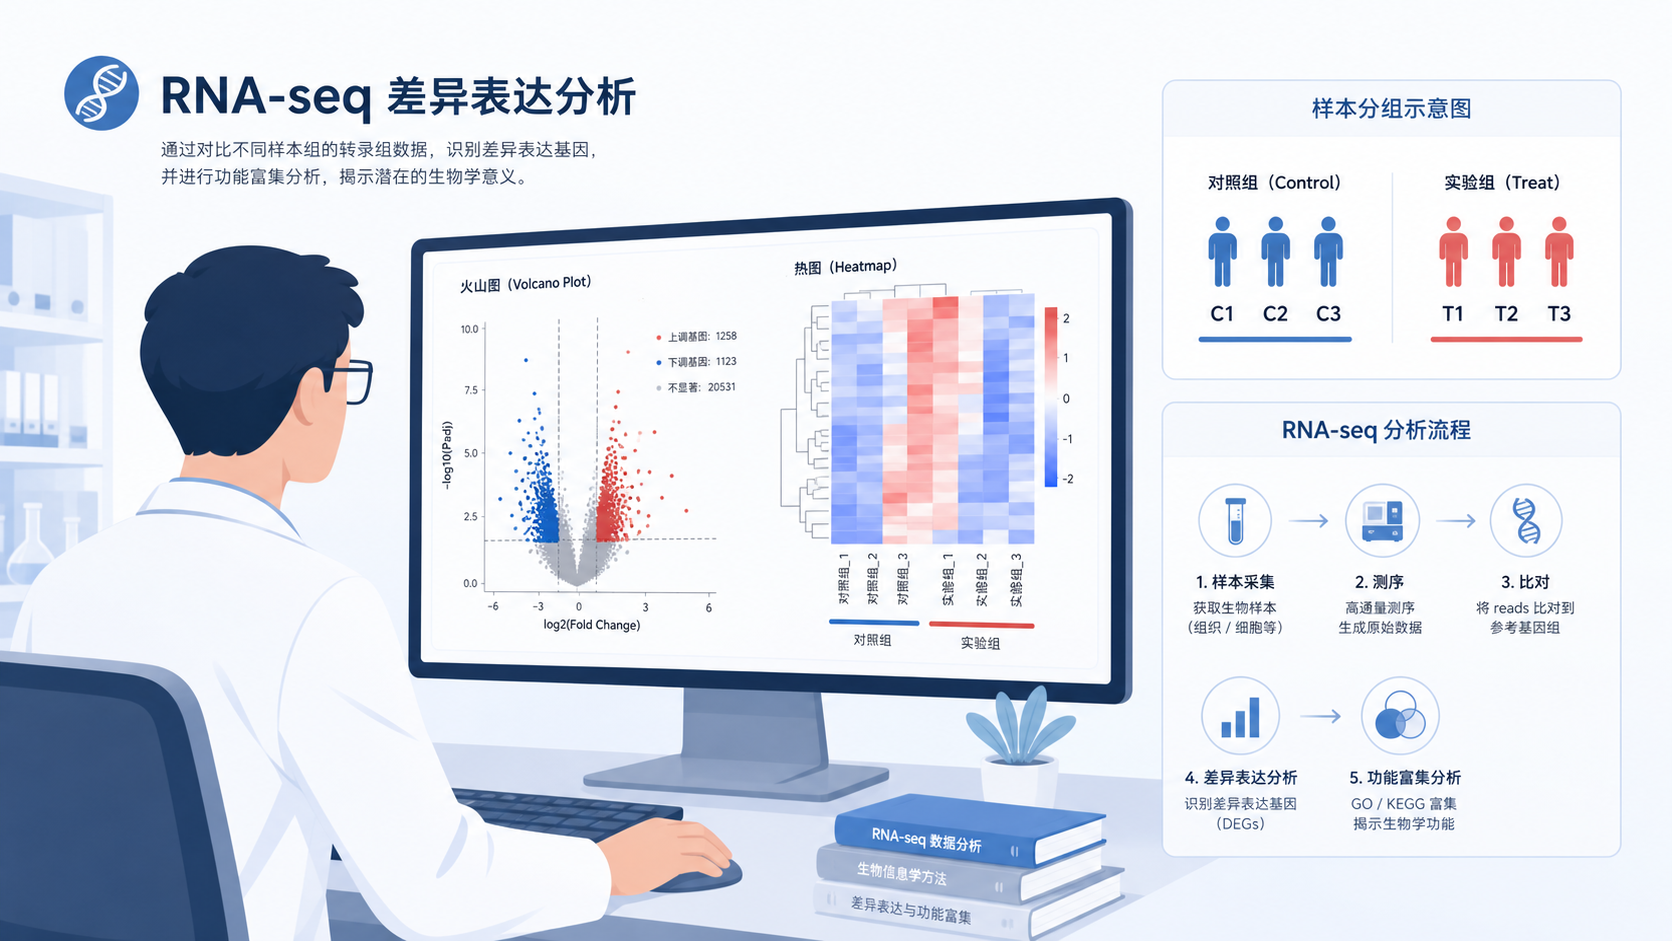
RNA-seq差异表达分析的核心,是比较不同条件下基因表达量是否存在显著变化。常见场景包括肿瘤与正常组织,治疗前后,或不同分型之间。它的目标不是找“表达高低”,而是找“统计学上可信的变化基因”。
在实际研究里,差异表达结果通常要回答三个问题。
- 哪些基因发生了变化。
- 变化方向是上调还是下调。
- 这些变化是否足够显著,能支撑后续功能分析。
对于RNA-seq数据,差异分析常用的指标包括logFC、P value和FDR。logFC反映变化幅度,FDR反映多重检验后的假阳性控制。 在论文和报告中,通常会同时关注二者,而不是只看某一个指标。
1.1 分组是分析成败的第一步
RNA-seq差异分析里,分组错误是最常见的问题之一。样本分组一旦错了,后面的上调和下调方向都会反过来。
在标准流程中,先根据样本名或临床信息确定分组,再构建设计矩阵。若样本量不平衡,也要提前确认统计策略是否合适。分组清楚,结果才有解释价值。
1.2 低表达基因需要先过滤
低表达基因会增加噪音,也会影响统计稳定性。常见做法是先过滤均值过低的基因,再进入差异分析。这个步骤看似简单,但非常关键。
一般来说,过滤后的数据更稳定,结果更容易解释。对医学生和科研人员来说,这一步的意义是减少“假阳性”干扰,让后续火山图和热图更可信。
2.WorkBuddy如何把差异分析流程简化
传统RNA-seq分析需要写代码、装包、调参数。对没有编程基础的人来说,这个门槛很高。WorkBuddy无代码实操的价值就在于,把差异表达分析拆成可视化步骤,减少操作负担。
它更适合以下人群。
- 第一次接触RNA-seq分析的学生。
- 需要快速出图的临床科研人员。
- 想先跑通流程,再学习代码逻辑的人。
无代码不等于无规范。 好的平台仍然需要你完成正确的上传、分组和阈值设置。否则,结果同样可能不可靠。
2.1 数据准备要符合格式要求
无代码平台通常要求表达矩阵和样本信息分开准备。表达矩阵一般是第一列基因ID,后面每列对应一个样本。样本信息则至少包含样本名和分组信息。
这里最容易出错的地方有三个。
- 样本名不一致。
- 分组字段缺失。
- 表达矩阵格式不规范。
格式正确,才能保证平台识别样本与分组。 如果前期文件整理混乱,后面再好的分析工具也跑不出可信结果。
2.2 平台会自动完成核心统计步骤
在规范上传后,平台通常会自动完成标准化、离散度估计和差异检验。这类流程的逻辑和常规转录组分析一致,核心目标都是找出显著差异基因。
对用户来说,最重要的不是记住所有函数名,而是理解每一步的作用。
- 标准化,用于消除测序深度差异。
- 离散度估计,用于刻画基因间变异。
- 差异检验,用于判断组间表达差异是否显著。
你看到的是一键运行,背后是完整的统计流程。
3.差异表达结果怎么看才专业
差异表达分析做完,不是看见一张火山图就结束了。真正有价值的是学会解读结果。专业的结果解读,通常要从阈值、方向和生物学意义三层来判断。
3.1 先看阈值,再看方向
常用筛选条件包括P value、FDR和logFC。不同研究会根据设计调整阈值,但思路一致。先用统计阈值筛选,再判断上调和下调方向。
常见解释方式如下。
- logFC > 0,说明该基因在实验组上调。
- logFC < 0,说明该基因在实验组下调。
- FDR越小,结果越稳定。
如果分组方向设反了,那么上下调方向也会反。这就是为什么差异分析前必须确认比较方向。
3.2 火山图和热图是最常用的两个图
火山图适合快速展示整体差异分布。横轴通常是logFC,纵轴通常是显著性指标。它能一眼看出哪些基因变化大,哪些基因变化显著。
热图则更适合展示显著差异基因在各样本中的表达模式。它的优势是直观,适合做文章图和汇报图。
两类图的分工很明确。
- 火山图回答“哪些基因变了”。
- 热图回答“这些基因在样本中怎么分布”。
如果只做一张图,信息不够。火山图加热图,才更符合转录组文章的基本表达习惯。
3.3 结果整理要便于后续分析
差异表达分析不是终点。后面通常还会接GO、KEGG、GSEA,或者ceRNA网络分析。因此,结果表需要整理得足够规范。
建议至少保留以下字段。
- 基因名称。
- logFC。
- P value。
- FDR。
- Regulation,标注上调或下调。
整理清楚的数据表,能显著提高后续功能分析效率。
4.无代码实操适合什么研究场景
WorkBuddy这类无代码流程,特别适合教学、预实验和快速验证假设。对于刚进入转录组领域的医学生,它能帮助你先建立完整分析框架,而不是一开始就被代码卡住。
对科研人员来说,它也有明确价值。尤其是在项目早期,需要快速判断一个方向是否值得继续投入时,快速差异分析能节省大量时间。
4.1 适合快速形成初步结论
如果你的目标是先做探索性分析,看看组间是否存在明显转录变化,无代码实操很合适。它能帮助你在短时间内拿到初步结果。
例如,先看差异基因数量,再看火山图和热图,再决定是否进入下游机制分析。这种流程非常高效。
4.2 适合团队协作和教学演示
无代码平台还有一个优势,就是便于团队沟通。临床医生、实验人员和数据分析人员都能更快理解分析流程,减少沟通成本。
对于教学场景,它尤其适合做演示。先让学习者看到完整流程,再逐步回头理解统计逻辑,学习效率更高。
4.3 适合从“会用”过渡到“会解释”
很多人卡在不是不会点按钮,而是不知道结果怎么解释。无代码实操的价值,不只是省事,更是帮助用户建立分析思维。
当你能看懂分组、阈值、标准化和可视化之间的关系时,后续学习R语言、DESeq2或edgeR就会更顺畅。这一步是从工具使用者,走向分析理解者的关键。
最后,如果你希望在不写代码的前提下快速完成RNA-seq到差异表达的完整流程,WorkBuddy可以把上传、分组、分析和可视化串成一条清晰路径。对于想尽快得到可解释结果、又不想被技术细节拖慢进度的研究者来说,解螺旋的相关工具和服务能帮助你更高效地把数据转化为结论。
总结Conclusion
RNA-seq差异表达分析的关键,不只是跑出结果,而是确保分组正确、阈值合理、图表清晰、结论可信。对医学生、医生和科研人员来说,掌握这套逻辑,才能真正把转录组数据用于科研设计和论文写作。
如果你希望更快上手,WorkBuddy无代码实操是很好的起点。它能降低分析门槛,也能帮助你建立规范的数据分析思路。 想把RNA-seq从原始数据快速推进到差异表达结果,可以进一步了解解螺旋的相关方案。
- 引言Introduction
- 1.RNA-seq差异表达分析到底在看什么
- 2.WorkBuddy如何把差异分析流程简化
- 3.差异表达结果怎么看才专业
- 4.无代码实操适合什么研究场景
- 总结Conclusion