44
 分享
引言Introduction
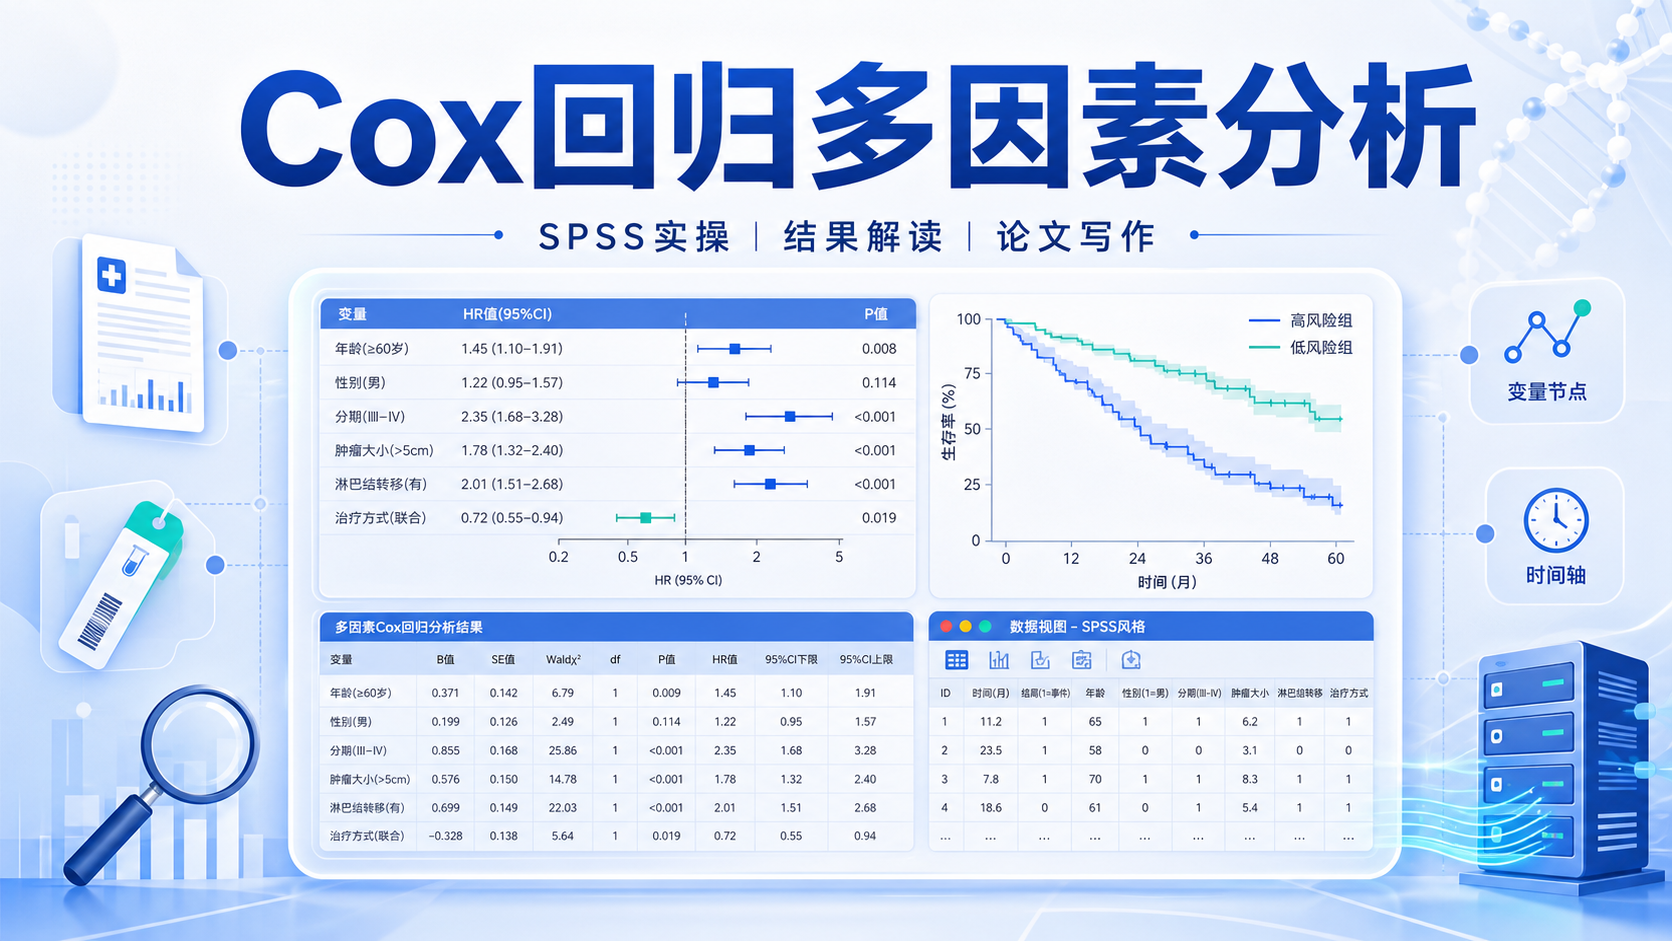
临床研究里,单看Kaplan-Meier曲线和Log-rank检验,常常只能说明“有差异”,却说不清差异是否独立存在。Cox回归多因素分析 正是把混杂因素纳入模型后,回答“治疗是否真正影响生存”的关键工具。
1. 为什么要做Cox回归多因素分析
1.1 仅看生存曲线,结论往往不够
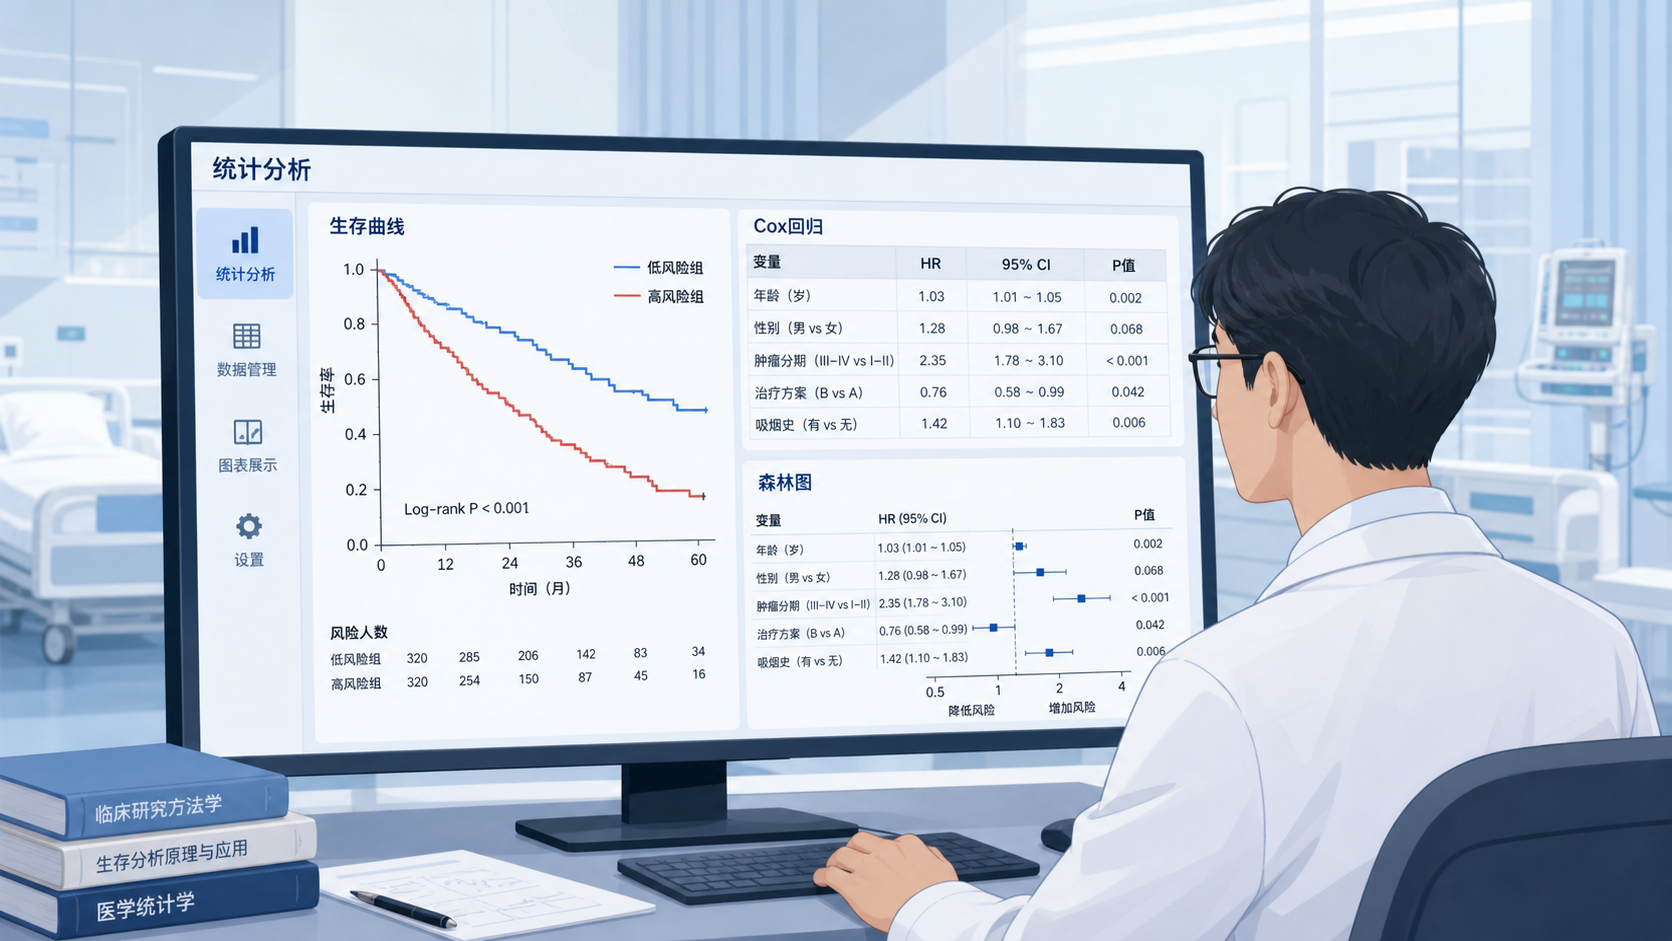
在肿瘤预后研究中,很多文章先画Kaplan-Meier曲线,再做Log-rank检验。这一步只能比较两组生存分布是否不同。它不能判断差异是否由年龄、分期、放疗等因素造成。
例如,接受化疗组和未化疗组常常在基线特征上并不平衡。若化疗组年轻、分期更早,单纯比较生存率,容易高估治疗效果。此时就需要把年龄、性别、AJCC分期、放疗等协变量一起放入模型。
1.2 Cox模型的核心价值
Cox比例风险模型适用于生存时间结局,能够在不限定基线风险函数形式的前提下,估计协变量对死亡风险的影响。多因素Cox回归的重点,不是“谁组间差异更大”,而是“在控制其他变量后,某因素是否仍然显著”。
在结果表达上,通常报告:
- HR值,表示风险比。
- 95%CI,表示估计精度。
- P值,表示统计学证据。
HR小于1,提示风险下降。HR大于1,提示风险上升。
如果95%CI跨过1,通常提示该变量未达到统计学显著。
2. Cox回归多因素分析的建模思路
2.1 先明确变量角色
一个规范的Cox模型,至少要先定义三类变量:
- 因变量,通常是总生存期或无进展生存期。
- 事件状态,如死亡记为1,删失记为0。
- 自变量和协变量,如化疗、年龄、性别、AJCC分期、放疗等。
以SEER数据库或临床回顾性队列为例,研究问题往往是:是否接受化疗,是否独立影响总生存期。
这时化疗是主要自变量,其他变量多为混杂因素。
2.2 协变量选择要有依据
多因素模型不是变量越多越好。常见纳入原则包括:
- 临床上已知与结局相关。
- 单因素分析有统计学意义。
- 避免高度共线性。
例如在肿瘤研究中,年龄、性别、分期、治疗方式通常优先纳入。若变量过多而事件数不足,模型会不稳定。经验上,Cox多因素分析应关注“事件数/变量数”是否足够 。实际研究中,常见建议是每个自变量对应至少10个事件,更稳妥时可提高到20个事件。
3. SPSS中如何完成Cox回归多因素分析
3.1 数据准备与变量编码
在SPSS中进行Cox回归前,数据需要整理成适合分析的格式。至少要包含:
- 生存时间变量。
- 生存状态变量。
- 分组变量和协变量。
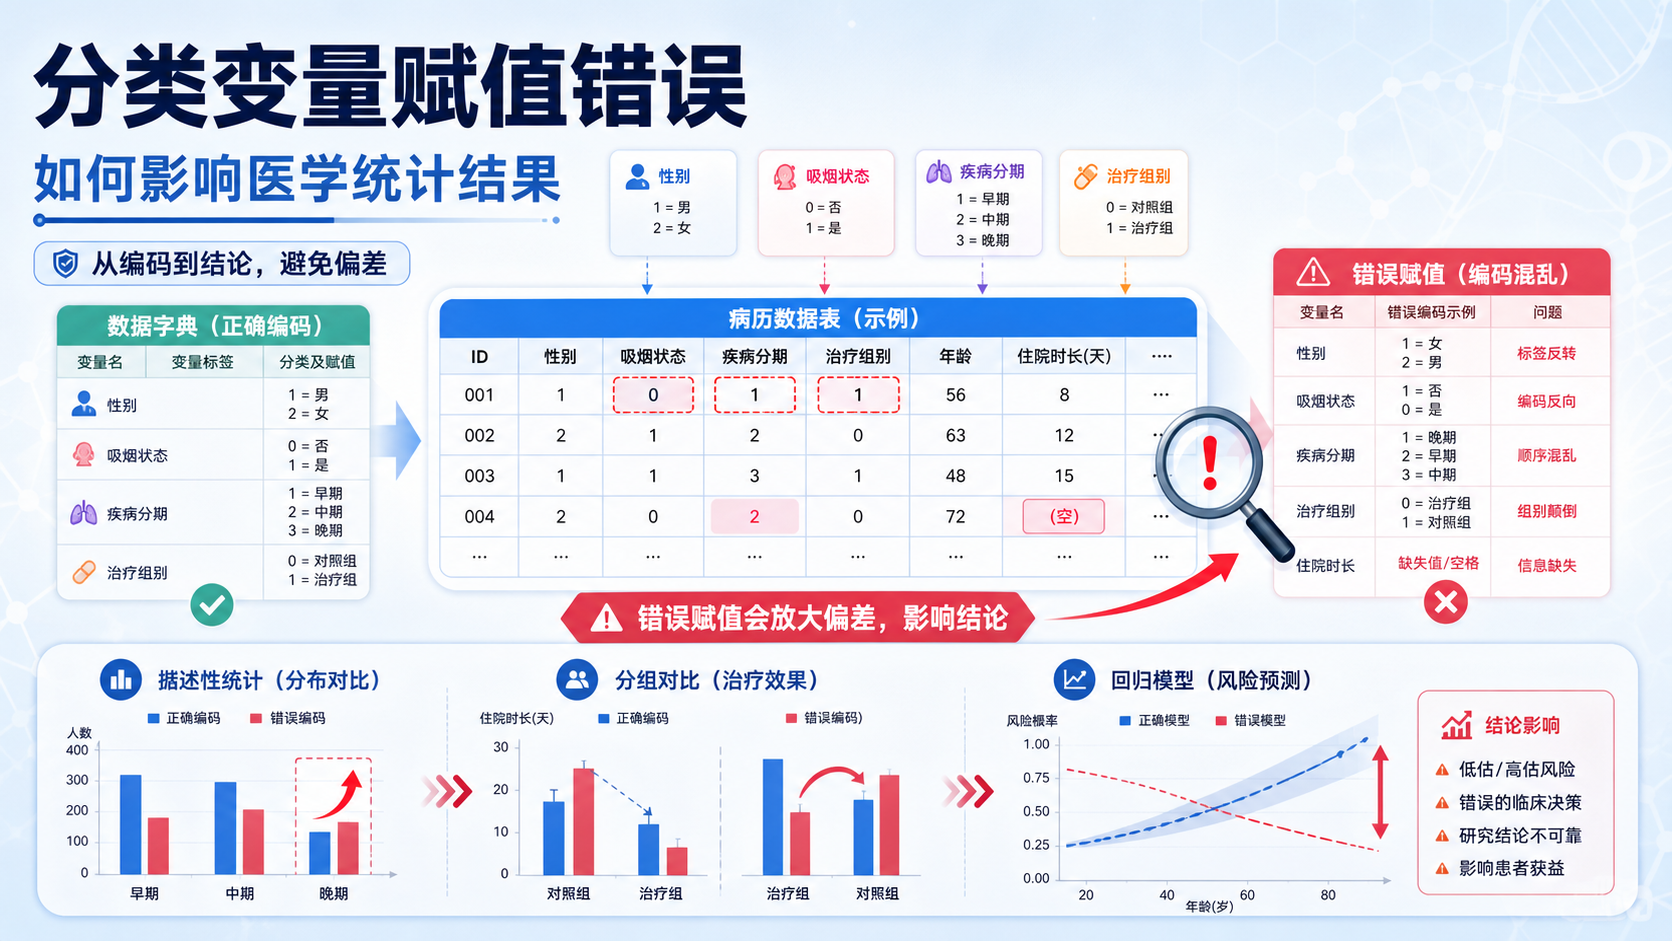
分类变量必须正确设定。比如“是否化疗”应作为分类变量处理,并设定参考组,通常选择“未化疗组”作为对照。参考组设定错误,会直接影响HR解释方向。
若变量是多分类变量,如AJCC分期,建议按临床意义设置哑变量或指定参考水平。连续变量如年龄,可以直接纳入,也可以按研究设计分组,但分组会损失信息,需谨慎。
3.2 单因素Cox回归:先筛变量
操作路径通常为:
- Analyze。
- Survival。
- Cox Regression。
先做单因素分析,把单个变量放入协变量框,观察其HR和P值。单因素分析的作用是初筛,不是最终结论。它帮助你识别与结局可能相关的变量,也能为后续多因素建模提供方向。
结果输出中,重点看:
- Variables in the Equation。
- Exp(B),即HR。
- 95%CI。
- Sig.,即P值。
如果“是否化疗”的HR为0.72,95%CI为0.58到0.89,P<0.05,说明化疗与死亡风险下降相关。但这仍然是粗略结果,必须进入多因素模型进一步验证。
3.3 多因素Cox回归:分层建模更清晰
多因素分析常见做法是分模型逐步加入协变量,便于观察主要暴露因素HR的变化。
模型1
纳入年龄和性别。
目的:先控制最基础的人口学混杂因素。
模型2
在模型1基础上,再纳入AJCC分期和放疗信息。
目的:进一步控制疾病严重程度和治疗策略的影响。
模型3
采用向前逐步回归,把所有候选变量一起纳入。
目的:在统计意义和临床意义之间取得平衡,识别最终独立因素。
如果某变量在单因素中显著,但进入多因素后不显著,通常说明它的作用可能被其他变量解释了。
这并不意味着变量“没用”,而是说明其不是独立预测因子。
4. 结果该怎么看,才不容易解读错误
4.1 HR不是“生存率”
很多初学者会把HR直接理解成生存率差异,这是错误的。HR反映的是某时点附近的瞬时风险比,不是固定时间点的绝对生存概率。HR=0.70,不代表生存率一定提高30%。
正确表述应是:
- HR<1,说明相较参考组,事件风险降低。
- HR>1,说明相较参考组,事件风险增加。
- 若95%CI不跨1且P<0.05,结果更可信。
4.2 看显著性,也要看临床意义
统计学显著,不等于临床意义大。
例如某变量HR为0.95,P<0.05,可能因为样本量很大。此时仍要思考,它在临床上是否值得改变决策。
反过来,某变量HR为0.68,但样本量不足,95%CI较宽,可能提示有潜在效应,只是证据不够强。医学统计不是只看P值,而是结合效应量、置信区间和临床背景综合判断。
4.3 森林图比文字更直观
多因素Cox回归结果常配森林图展示。森林图有三个优点:
- 一眼看出各变量方向。
- 可比较不同变量效应强弱。
- 便于论文排版和读者快速理解。
如果模型中有多分类变量,建议在森林图中清晰标注参考组。否则读者很容易误解。
5. 样本量、事件数和模型稳定性
5.1 事件数比总样本数更关键
做Cox回归时,真正决定模型稳定性的,往往不是总样本数,而是事件数。因为生存分析的有效信息主要来自事件发生。如果事件太少,多因素模型会“看起来能跑”,但结果不稳。
经验性估计中,常参考每个自变量至少对应5到10个事件,保守时可取20个事件。
例如你计划纳入6个协变量,若按1:10,至少需要60个事件。若事件数远低于这个水平,模型应谨慎解释。
5.2 不要把变量塞得太满
很多研究为了“显得全面”,把所有变量都放入模型,结果出现:
- 标准误增大。
- CI变宽。
- P值不稳定。
- 变量间共线性增强。
更合理的做法是:
- 先做临床筛选。
- 再做单因素分析。
- 最后建立多因素模型。
- 必要时进行敏感性分析。
模型的目标是解释问题,不是堆砌变量。
6. 写论文时如何规范呈现Cox回归结果
6.1 结果部分怎么写
建议按照“单因素—多因素—模型解释”的顺序写。
可以这样组织:
- 单因素分析中,化疗、AJCC分期、年龄与总生存期相关。
- 多因素分析中,调整年龄、性别、分期和放疗后,化疗仍然显著。
- 最终模型提示化疗是独立保护因素。
写作时尽量给出具体数值:
- HR。
- 95%CI。
- P值。
- 调整变量范围。
不要只写“有统计学意义”,要把证据写全。
6.2 讨论部分怎么避免空泛
讨论时要说明三点:
- 主要发现是什么。
- 为什么会这样。
- 与既往研究是否一致。
如果化疗在多因素分析后仍显著,说明其可能确有独立获益。但也要提醒读者,回顾性研究仍可能存在选择偏倚、信息偏倚和残余混杂。Cox回归能控制已测量的混杂因素,但不能消除所有偏倚。
7. 从实操到写作,如何提高效率
7.1 一个实用流程
建议按以下顺序推进:
- 整理数据,确认时间和结局变量。
- 先做单因素Cox回归。
- 根据临床意义筛选协变量。
- 建立多因素模型。
- 输出HR、95%CI、P值。
- 用森林图和表格整理结果。
- 回到临床问题解释结论。
这个流程适合医学生、医生和科研人员快速完成论文初稿。
7.2 借助专业工具减少返工
如果你希望把统计流程做得更规范,或者希望快速复现高质量论文中的Cox回归分析,可以结合标准化的数据处理与结果模板。解螺旋 可帮助你把变量整理、模型构建和结果呈现串联起来,减少反复修改和格式返工,让Cox回归多因素分析更高效、更接近发表要求。
总结Conclusion
Cox回归多因素分析是生存资料研究的核心方法。它能在控制混杂因素后,判断某个变量是否真正独立影响预后。对于临床研究者而言,关键不是会不会点软件,而是能否正确设定变量、理解HR、判断模型稳定性,并把结果写得准确、克制、可发表。
如果你正在做肿瘤预后、治疗效果或队列研究,建议把单因素、多因素、样本量与结果解读一并设计好。想更高效完成规范分析和论文输出,可以进一步了解解螺旋的专业支持。
- 引言Introduction
- 1. 为什么要做Cox回归多因素分析
- 2. Cox回归多因素分析的建模思路
- 3. SPSS中如何完成Cox回归多因素分析
- 4. 结果该怎么看,才不容易解读错误
- 5. 样本量、事件数和模型稳定性
- 6. 写论文时如何规范呈现Cox回归结果
- 7. 从实操到写作,如何提高效率
- 总结Conclusion