27
 分享
引言Introduction
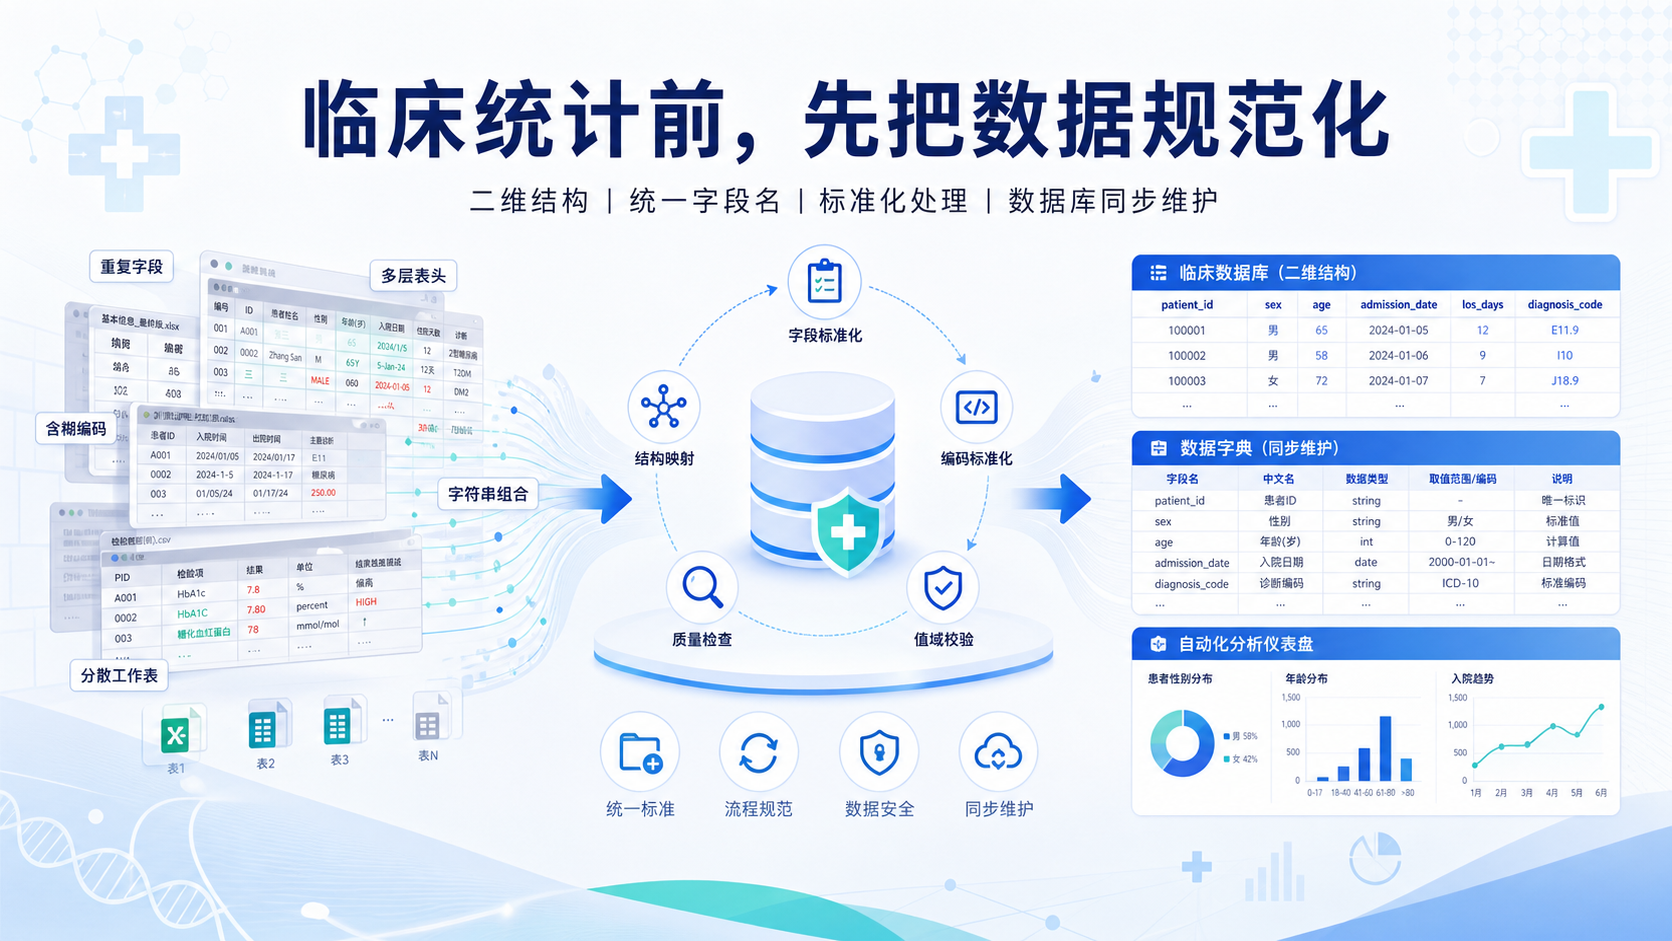
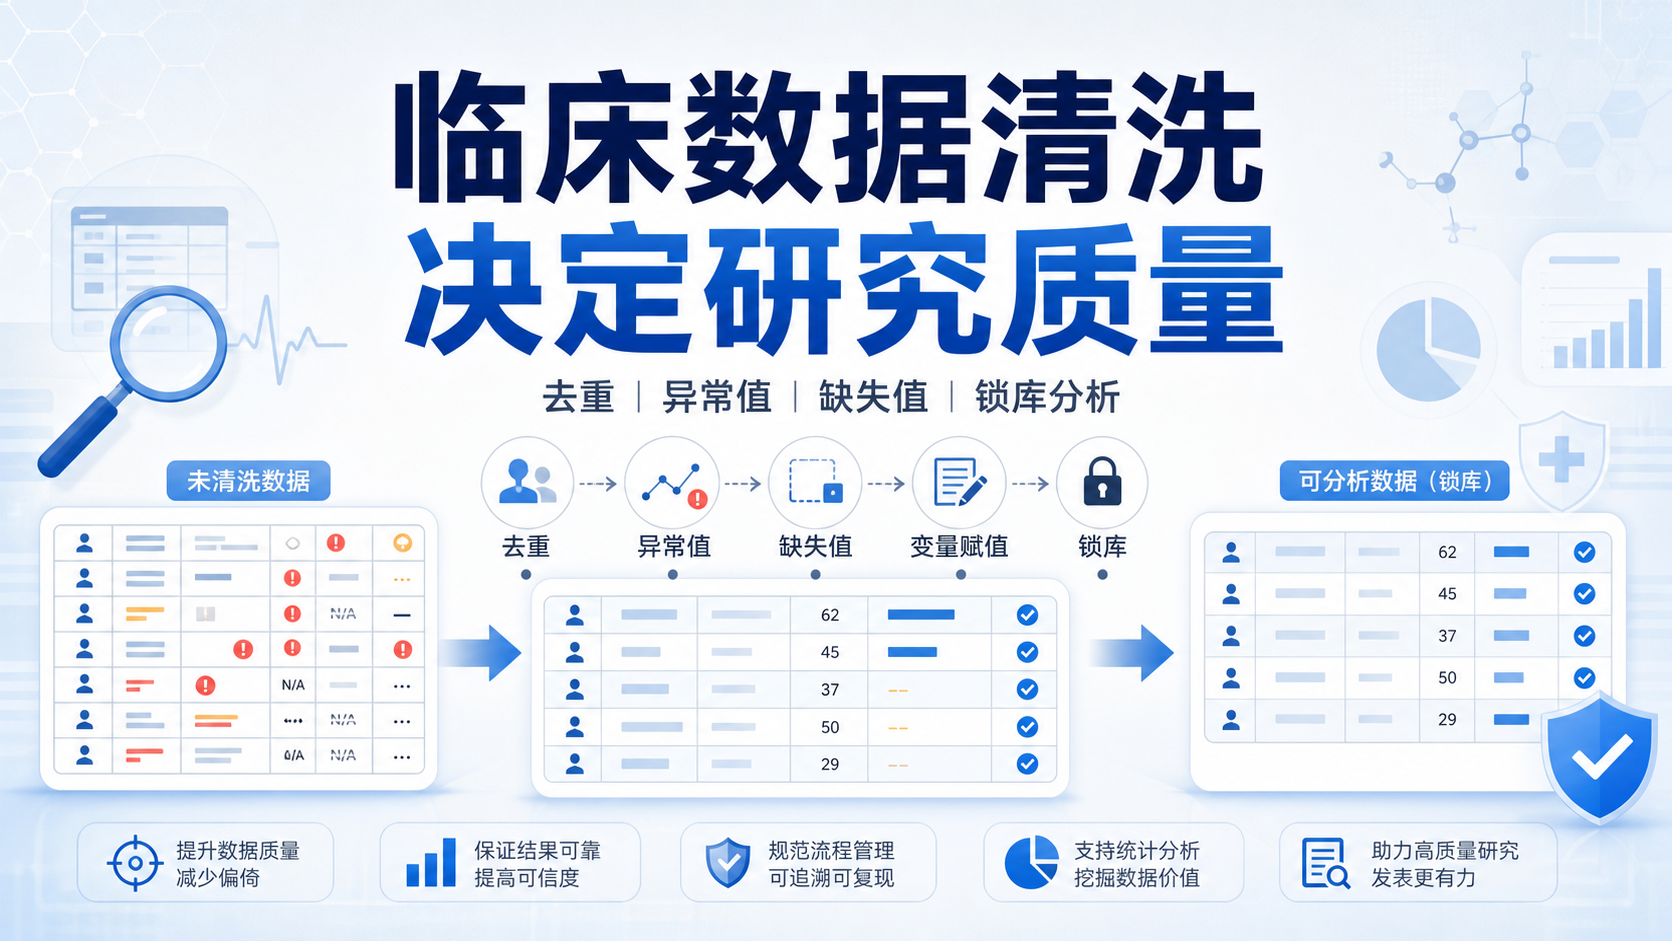
临床研究中,数据脏、重复、缺失、异常值未处理,都会直接拉低统计结果可信度。临床数据清洗流程不是附加步骤,而是发文前的核心门槛。 如果预处理不到位,后续建模、分层、假设检验都可能失真。
1. 为什么临床数据清洗决定研究质量
1.1 先清洗,再分析,是基本原则
临床数据进入统计软件后,很多人会急着做描述分析。但从研究设计角度看,数据清洗完成度,决定了结果能否被信任。
常见问题包括:
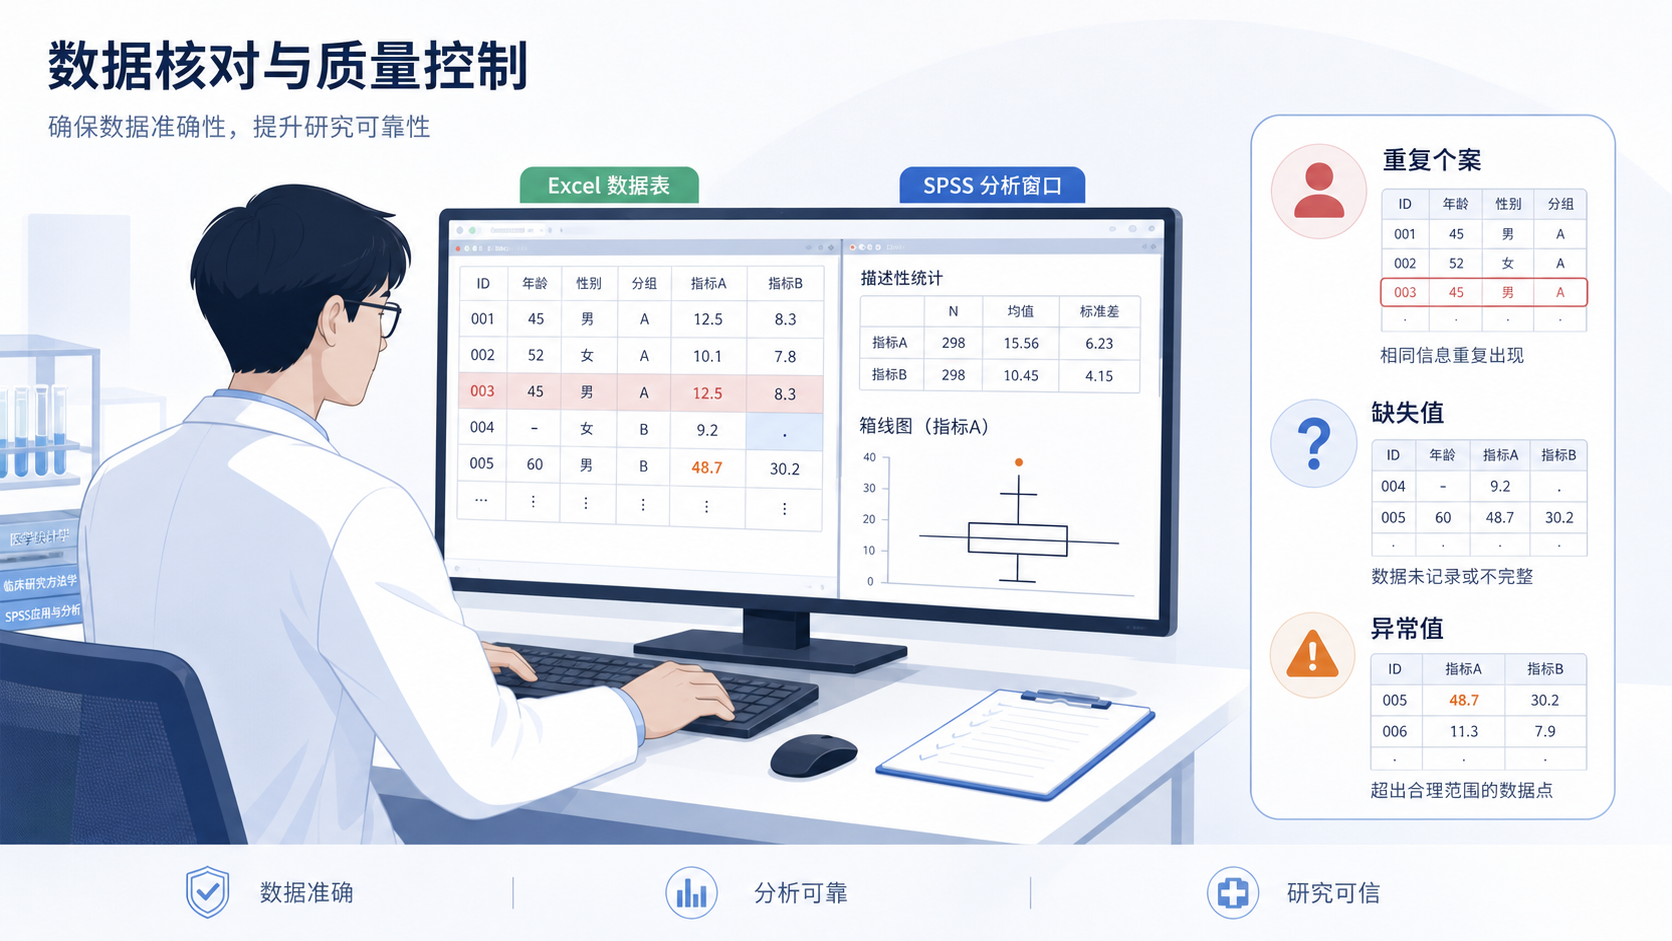
- 同一患者重复录入。
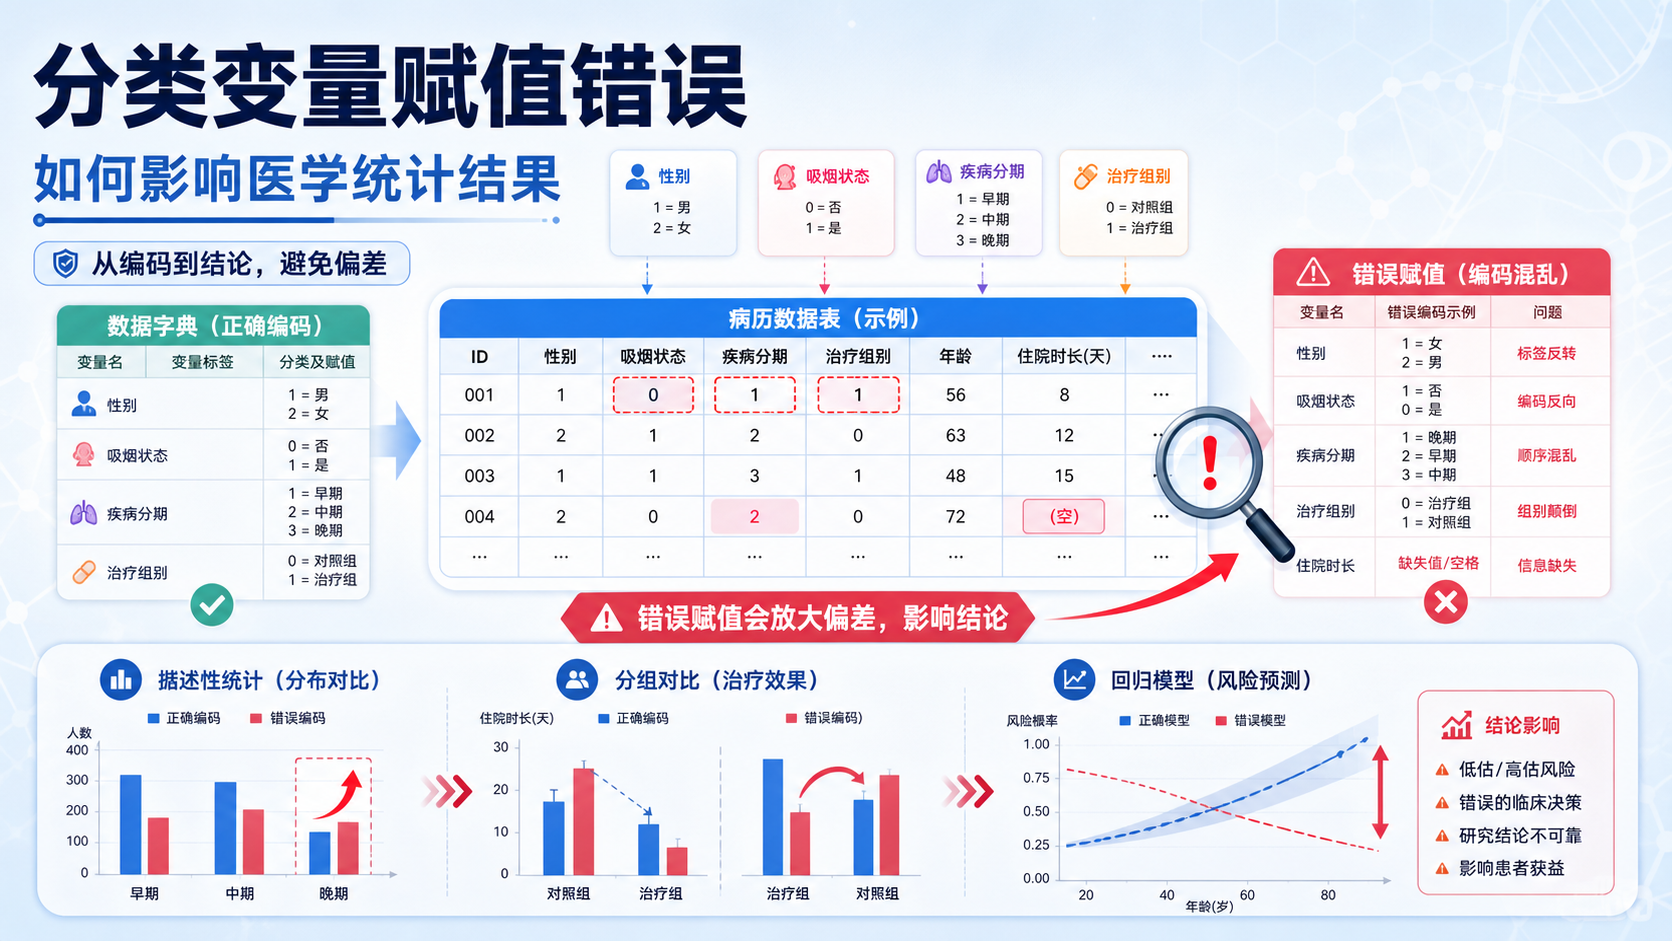
- 编码错误,如性别出现3。
- 连续变量超出生理范围。
- 缺失值未识别,直接纳入分析。
这些问题一旦进入模型,会影响均值、回归系数、P值,甚至改变结论方向。
1.2 数据清洗的目标,不只是“删数据”
清洗的本质,是把原始数据变成可分析、可追溯、可复核的数据集。
它不是简单删除异常值,而是要完成识别、核查、修正、验证和锁库。
对医学生、医生和科研人员来说,这一步是论文质量的基础,也是后续多中心协作的前提。
2. 第一步:理解变量名与研究目的
2.1 先确认每个变量是否服务研究问题
拿到数据库后,第一件事不是运行统计,而是看变量。
要先回答三个问题:
- 这个变量是否与研究目的相关。
- 变量含义是否明确。
- 变量编码是否可追溯。
不相关的变量可以先剔除,相关变量要保留并理解清楚。
这样能减少后续清洗负担,也避免误用无关字段。
2.2 变量名建议使用英文
课程知识库中明确提到,SPSS虽可用中文变量名,但英文变量名更利于导出、共享和后续使用R等软件分析。
同时,建议制作变量说明表,列出:
- 变量名。
- 中文含义。
- 取值范围。
- 编码规则。
- 是否为结局变量或协变量。
这张表后面会成为锁库、核查和复现的重要依据。
3. 第二步:识别并删除重复个案
3.1 重复个案是最优先处理的问题
重复录入会让样本量虚高,导致统计偏倚。
重复个案应尽量在最早阶段识别。
尤其在多人员录入、合并多个文件时,更容易出现同一患者被重复导入。
常见重复标准包括:
- ID一致。
- ID与姓名一致。
- 多个关键字段完全一致。
3.2 处理重复个案要有规则
建议处理顺序如下:
- 先备份原始数据。
- 定义重复识别规则。
- 标记重复记录。
- 核对原始病历或录入来源。
- 删除无效重复项。
- 保留处理日志。
删除重复个案前,必须先确认是否为同一患者的多次就诊。
如果研究对象本身允许重复入组,就不能简单按重复删除,而应按研究设计定义单位。
4. 第三步:识别异常值并分类处理
4.1 异常值分两类
异常值不等于错误值。
临床数据里,异常值通常分为两类:
- 录入错误。
- 真实但极端的临床值。
例如,年龄出现负数,通常是错误。
但90岁住院患者,可能是真实存在。
4.2 连续变量和分类变量的处理不同
连续变量可结合现实逻辑和统计分布判断。
常见方法包括:
- 生理范围判断。
- 箱形图法。
- 四分位距法。
分类变量则主要看编码逻辑。
如性别变量只应有0/1,却出现3,这通常无法解释。
处理原则建议如下:
- 能回查原始记录的,优先订正。
- 无法核实且明显错误的,可改为缺失值。
- 若异常值可能是真实极端值,可保留,并在敏感性分析中评估影响。
异常值处理不能一刀切,必须结合研究目的。
5. 第四步:系统处理缺失值
5.1 先判断能不能填补
缺失值处理前,先问三个问题:
- 缺失比例多高。
- 变量是否关键。
- 缺失机制是否适合填补。
一般来说,缺失比例越高,随意填补的风险越大。
如果变量是核心结局或关键暴露,不能轻易用均数替代。
5.2 常用方法要匹配场景
常见处理方式包括:
- 个案删除。
- 均数或中位数填补。
- 虚拟变量法。
- 多重填补。
知识库中提到,多重填补较常用,但并不适用于所有缺失场景,尤其是非随机缺失。
因此,选择方法时要结合缺失机制,而不是只看操作方便。
5.3 缺失值处理后要复核
处理完缺失值后,要再次检查:
- 是否仍有空值。
- 是否误填到错误变量。
- 是否影响变量分布。
缺失值处理不是填完就结束,必须验证。
6. 第五步:完成清洗验证
6.1 验证的核心是“前后对比”
清洗验证的目的,是确认修改有依据、结果可追溯。
建议至少做两件事:
- 对比原始数据集与清洗后数据集。
- 重新扫描异常值和缺失值。
这样可以确认:
- 删除了哪些记录。
- 修正了哪些数值。
- 是否引入了新错误。
6.2 验证是锁库前最后一道防线
很多研究者忽略这一步,结果在统计阶段才发现某个变量被误改。
清洗验证的价值,在于把错误拦在分析前。
如果项目涉及多人协作,验证记录尤其重要。它能保证后续分析基于同一个“最终数据库”。
7. 第六步:根据研究目的进行变量赋值转换
7.1 分层变量放在清洗后做
研究中常常需要把连续变量转成分层变量。
例如:
- BMI按中国标准或WHO标准分层。
- 年龄分组。
- 血压状态分类。
这一步建议放在异常值和缺失值处理完成之后。
原因很简单。原始数据先清干净,再做分层,新的变量更稳定,也更不容易带入错误。
7.2 转换后仍要再查一遍
变量赋值转换完成后,建议再做一次检查:
- 分类是否正确。
- 是否出现新异常值。
- 分组是否与研究方案一致。
这一步经常被忽略,但它能显著降低后续分析错误率。
8. 第七步:锁定数据库并进入统计分析
8.1 锁库意味着分析口径固定
当清洗验证、变量转换都完成后,就应锁定数据库。
锁库的意义是,后续所有统计都基于同一版本数据。
这对论文撰写、投稿答复和审稿复核都很重要。
锁库前建议确认:
- 数据备份完整。
- 变量说明表已更新。
- 清洗日志已留存。
- 最终数据集文件名清晰。
8.2 锁库后才进入正式统计
完成以上步骤后,才适合进入描述分析、组间比较、回归建模和假设检验。
换句话说,临床数据清洗流程完成,才真正进入科研分析阶段。
9. 临床数据清洗流程的实操清单
9.1 一页式执行顺序
你可以按这个顺序执行:
- 理解研究目的和变量含义。
- 删除无关变量,建立变量说明表。
- 识别重复个案并处理。
- 查找异常值并订正或标记。
- 处理缺失值并记录方法。
- 做清洗验证和前后比对。
- 完成变量赋值转换。
- 锁定数据库,进入统计分析。
9.2 最容易出错的三个环节
最容易出错的环节通常是重复个案、异常值和缺失值。
这三步如果做得不严谨,后面再漂亮的模型也不可靠。
因此,建议在项目开始阶段就建立统一规则,而不是分析时临时处理。
总结Conclusion
临床数据清洗流程七步法的核心,不是机械删改,而是围绕研究目的完成识别、修正、验证和锁库。只有清洗后的数据库,才适合进入统计分析和论文撰写。
如果你正在做临床研究,建议尽早建立变量说明表、重复个案规则和缺失值处理方案。这样能显著提高数据质量,也能减少返工。
如果你希望把临床数据清洗流程做得更规范、更高效,可以进一步借助解螺旋的课程与工具,帮助你从原始数据快速走向可发文的数据结果。

- 引言Introduction
- 1. 为什么临床数据清洗决定研究质量
- 2. 第一步:理解变量名与研究目的
- 3. 第二步:识别并删除重复个案
- 4. 第三步:识别异常值并分类处理
- 5. 第四步:系统处理缺失值
- 6. 第五步:完成清洗验证
- 7. 第六步:根据研究目的进行变量赋值转换
- 8. 第七步:锁定数据库并进入统计分析
- 9. 临床数据清洗流程的实操清单
- 总结Conclusion