2
 分享

引言Introduction
临床研究里,很多“显著结果”其实很便宜。真正值钱的,不是验证一个假设,而是判断这个假设是否值得验证。如果你只做单一假设检验,三五分钟就能跑完;如果要做临床研究高通量,成本、资源和解释力完全不是一个量级。 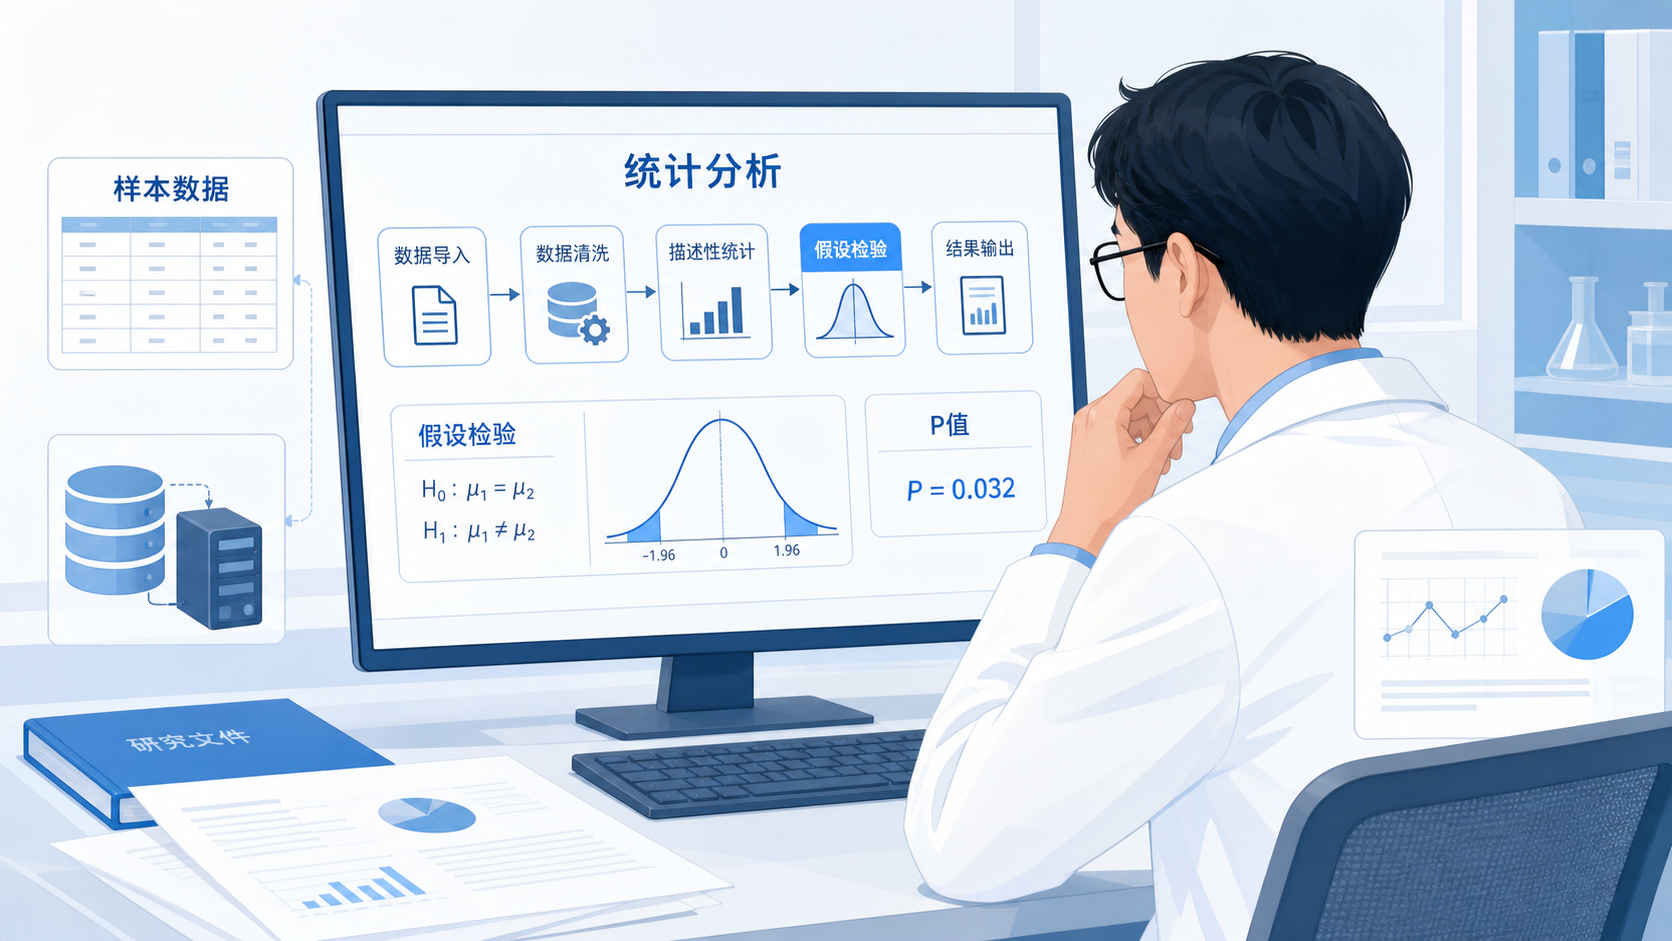
1. 什么是“九块九验证一个假设”
1.1 单一假设验证,为什么会变得很便宜
在临床论文统计学中,单一假设验证通常指的是,只围绕一个明确问题做分析。比如,比较干预组和对照组的某个结局是否不同,或者验证某个变量和结局是否相关。这类分析的核心不是“做多少次”,而是“问题是否清楚”。
如果研究问题已经固定,数据也已经收集好,那么后续的统计分析往往是套路化的。常见方法包括t检验、卡方检验、秩和检验、相关分析和回归分析。只要变量类型明确,方法选择通常并不复杂。换句话说,真正消耗时间的不是统计本身,而是前期设计是否合理。
1.2 为什么“验证结果”不等于“研究价值”
一个假设值不值得验证,取决于三个层面。
- 这个问题是否足够重要。
- 数据是否支持可靠回答。
- 结果是否能带来新的临床解释。
如果只是拿一份现成数据,反复尝试几个变量组合,最后挑出一个P值小于0.05的结果,这种工作量很低,但论文价值也很低。因为它解决的不是临床问题,而是数据表面上的偶然关系。
临床论文统计学的难点,不在于“算出P值”,而在于判断这个P值背后的证据强度。对医学生、医生和科研人员来说,这一步尤其重要。因为一旦研究目的不清,后面的所有统计都只是形式。
2. 临床研究高通量到底是什么
2.1 从“一个假设”变成“多个变量排列组合”
所谓临床研究高通量,简单说,就是把大量变量、结局和分析策略进行组合筛选。比如你有一批临床数据,想看哪些基线特征、治疗方式、实验室指标和结局之间存在关联。理论上,可以对很多变量进行模型尝试、分层分析和敏感性分析。
这类工作不只是“多做几次统计”那么简单。因为变量一多,模型就会面临更多问题:
- 多重比较导致假阳性上升。
- 亚组分析容易出现偶然显著。
- 缺失值处理方式会改变结论。
- 不同模型设定可能得到不同结果。
当分析路径很多时,最危险的不是没结果,而是结果太多。 研究者很容易被某个“显著P值”吸引,忽略它是否经得起重复验证。
2.2 为什么高通量分析需要更强的资源支持
高通量不是普通电脑就能轻松完成的。它往往依赖更稳定的计算资源、批量处理流程和更规范的数据管理。尤其在大样本、多终点、重复建模的情况下,分析过程会明显增加。
这也是为什么一些机构会把临床分析体系化。不是因为“统计更神秘”,而是因为当分析维度增加,任何一个环节出错,都会放大到最终结论里。
对于临床研究者来说,真正需要警惕的是:你是在做严谨推断,还是在做结果搜索。两者看起来很像,但科研价值完全不同。
3. P值为什么常常被误解
3.1 P值不是“结论正确率”
很多人把P值理解成“结果是真的概率”,这是错误的。P值的本质是:在原假设成立的前提下,当前样本结果或更极端结果出现的概率。
比如,假设A药无效,患者痊愈概率等于对照水平。此时如果样本里出现6/10痊愈,这并不一定罕见。相反,如果出现8/10痊愈,就可能进入“小概率事件”区域。此时我们才有理由怀疑原假设不成立。
但要注意,P小于0.05不等于“药物有效”,只能说明当前数据与原假设不相容。 这是一种统计学证据,不是最终临床结论。
3.2 统计学意义和临床意义不是一回事
这是临床论文统计学里最常见的误区之一。很多结果写着P<0.05,看起来“显著”,但实际差异非常小。比如某个模型C指数差了0.7%,统计学上可能显著,但临床上未必有实际价值。
为什么会这样。一个常见原因是样本量太大。样本量一大,统计功效上升,哪怕差异很小,也可能被检验出来。所以,P值只能回答“有没有统计学差异”,不能直接回答“值不值得临床应用”。
临床研究最终要看的是:
- 效应量有多大。
- 差异是否稳定。
- 是否具有实际决策意义。
- 是否能改变诊疗路径。
4. 临床论文里最容易踩的统计学坑
4.1 只写“P<0.05”,不写具体值
在较规范的论文中,P值应该尽量报告具体数值。只有特别小,比如P<0.001,才常写成区间形式。如果只写“大于0.05”或“小于0.05”,读者无法判断结果的边界和证据强度。
例如,0.049和0.051看似只差一点点,但统计结论已经不同。这个差别本身并不神秘,它只是人为设定的阈值效应。科研写作中,不能把这个阈值当成绝对真理。
4.2 统计方法与变量类型不匹配
很多临床论文的问题,不在结果,而在方法描述。比如:
- 计量资料未说明是否正态分布,就直接用均值和标准差。
- 分类资料只写“采用卡方检验”,不说明研究目的。
- 三分类结局被拆成多个二分类比较,重复做卡方检验。
这些写法看起来像“都做了”,其实逻辑并不成立。方法不是越多越好,而是越匹配越好。
4.3 只看“显著性”,忽略数据合理性
统计结果不可信,往往会暴露出数据问题。常见信号包括:
- 总人数和各亚组人数对不上。
- 均值和标准差与极值范围明显不符。
- 多个结果之间逻辑冲突。
- 同一类型变量却出现互相矛盾的P值。
例如,某些文章会报告年龄均值、标准差和最小最大值,但如果数据分布与这些数字严重不符,就要怀疑数据质量。统计学不只是算答案,更是检查数据是否自洽。
5. 怎样判断一个假设值不值得做
5.1 先看研究问题,再看统计方法
真正有价值的临床论文,往往先有清晰问题,再选统计方法,而不是反过来。一个好的研究设计通常会先明确:
- 主要终点是什么。
- 分组方式是什么。
- 数据类型是什么。
- 预期效应方向是什么。
- 是否存在混杂因素。
如果这些问题没有想清楚,后面的统计分析只会越来越乱。临床论文统计学的核心,是把问题定义清楚,而不是把模型堆复杂。
5.2 不要把“探索”伪装成“验证”
探索性分析是可以做的,但必须诚实说明。验证性分析要求更严格,通常需要预先设定假设、主要终点和统计方案。否则,今天试这个变量,明天试那个亚组,最后总能找到一个“显著结果”。
这种做法的风险在于,它会放大偶然性,缩小真实性。探索可以帮助生成假设,但不能直接替代结论。
5.3 论文价值取决于“可重复性”
一个值得验证的假设,必须具备可重复性。也就是说,别人拿到类似数据、类似设计,应该有机会得到相近结论。若某个结果只在单次分析中成立,换个样本就消失,那它的临床价值就有限。
因此,临床研究不能只看一次统计输出。还要看:
- 结果是否稳定。
- 是否有外部验证。
- 是否符合生物学和临床逻辑。
- 是否具备推广到真实世界的可能性。
6. 为什么很多人会觉得“统计学很难”
6.1 难的不是公式,而是逻辑
很多临床研究者觉得统计难,其实难点不在公式本身,而在逻辑链条。你必须同时回答:
- 这个假设能不能检验。
- 这组数据能不能支撑。
- 这个方法是否适合。
- 这个结果能不能解释。
只要其中任意一环断了,整篇文章就会变得不可靠。所以,统计学本质上是科研逻辑训练,不只是计算技巧。
6.2 复杂模型不等于高质量论文
有些人喜欢把模型做得很复杂,仿佛变量越多、方法越新,文章就越高级。但事实上,模型越复杂,越需要清楚说明变量选择、共线性、缺失值和过拟合控制。
对于临床论文来说,最重要的不是“模型看起来厉害”,而是“结论是否可信”。简单的问题,用简单方法就够了。复杂问题,才需要复杂模型。
7. 用解螺旋把“假设验证”做得更高效
7.1 让研究从“试错”变成“流程化”
如果你经常卡在统计设计、变量筛选、结果解释和论文写作之间,那么问题往往不是你不会做,而是缺少一套稳定的分析路径。解螺旋的价值,就是把临床研究中的分析流程标准化、结构化。
从数据清洗到统计选择,从结果表达到账目逻辑梳理,流程越清楚,研究越不容易走偏。对于临床论文统计学来说,这种支持很关键。它能减少无效试错,也能提高结论表达的准确性。
7.2 让“九块九式验证”回到真正有价值的问题
真正值得验证的,不是每一个显而易见的假设,而是那些有临床意义、能改变判断的问题。借助解螺旋,你可以更快识别:
- 哪些问题适合做验证。
- 哪些结果只是偶然显著。
- 哪些数据结构适合进一步建模。
- 哪些分析能支撑论文主线。
当研究流程更清晰,统计就不再只是“跑P值”,而是帮助你找到真正值得发表的证据。
总结Conclusion
临床论文统计学的核心,不是把每个假设都验证一遍,而是判断这个假设是否值得验证。单一检验很便宜,高通量分析才是真正考验资源和判断力的地方。P值只能说明样本与原假设的冲突程度,不能代替临床意义。
如果你正在做临床研究,最该提升的不是“多跑几个模型”,而是研究设计、变量逻辑和结果解释能力。想把假设验证做得更快、更稳、更像一篇能发表的论文,可以借助解螺旋 来规范流程、减少试错,让你的临床研究更高效,也更可信。
- 引言Introduction
- 1. 什么是“九块九验证一个假设”
- 2. 临床研究高通量到底是什么
- 3. P值为什么常常被误解
- 4. 临床论文里最容易踩的统计学坑
- 5. 怎样判断一个假设值不值得做
- 6. 为什么很多人会觉得“统计学很难”
- 7. 用解螺旋把“假设验证”做得更高效
- 总结Conclusion