16
 分享
引言Introduction
医学研究最怕什么。不是没数据,而是数据不完整、不一致、不可追溯。很多课题做到后期才发现,基线不平衡,随访丢失,结局缺项,最后整篇研究的可信度被拉低。数据质量不达标,往往不是统计问题,而是前期质控没做好。
1. 为什么医学研究数据质控决定成败
1.1 数据不达标,先影响的是结论可信度
在临床研究中,数据质量直接决定结果能否解释。即使研究设计正确,如果录入错误、缺失过多、分组不一致,结论也会被质疑。尤其是随机对照试验,理论上依赖组间可比性。一旦基线失衡,就很难证明差异来自干预本身。
研究结论的强弱,不只取决于样本量,更取决于数据是否真实、完整、稳定。
常见问题包括:
- 变量定义不统一。
- 测量方法不标准。
- 随访信息不全。
- 数据输入后未核查。
- 结局指标记录前后不一致。
这些问题单独看似乎不大,但叠加后会明显降低研究有效性。
1.2 临床研究最容易忽视的是过程控制
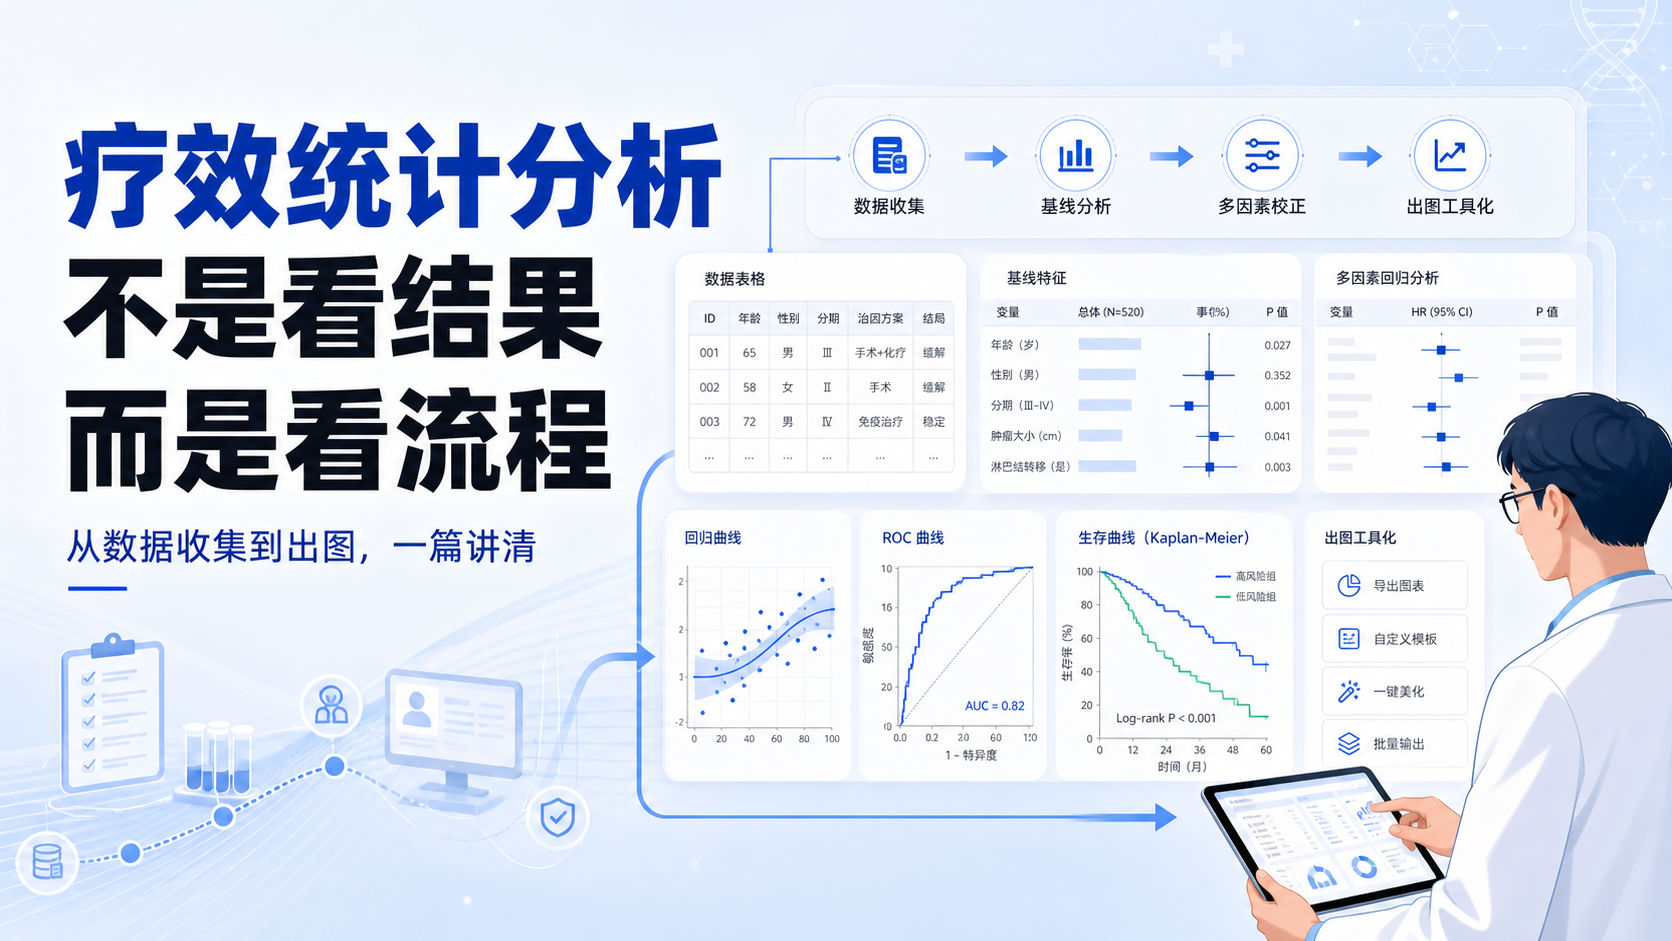
很多团队把重点放在统计分析,却忽略了过程管理。实际上,医学科研数据质控整理应贯穿研究全流程。从问卷设计到资料收集,从原始记录到数据库清洗,每一步都可能引入偏差。
尤其是多中心研究和长期随访研究,研究对象流失、执行标准不一致、不同研究人员记录习惯不同,都会影响最终结果。质量控制不是附加环节,而是研究本身的一部分。
2. 医学科研数据质控整理的核心环节
2.1 资料收集前,先把规则定清楚
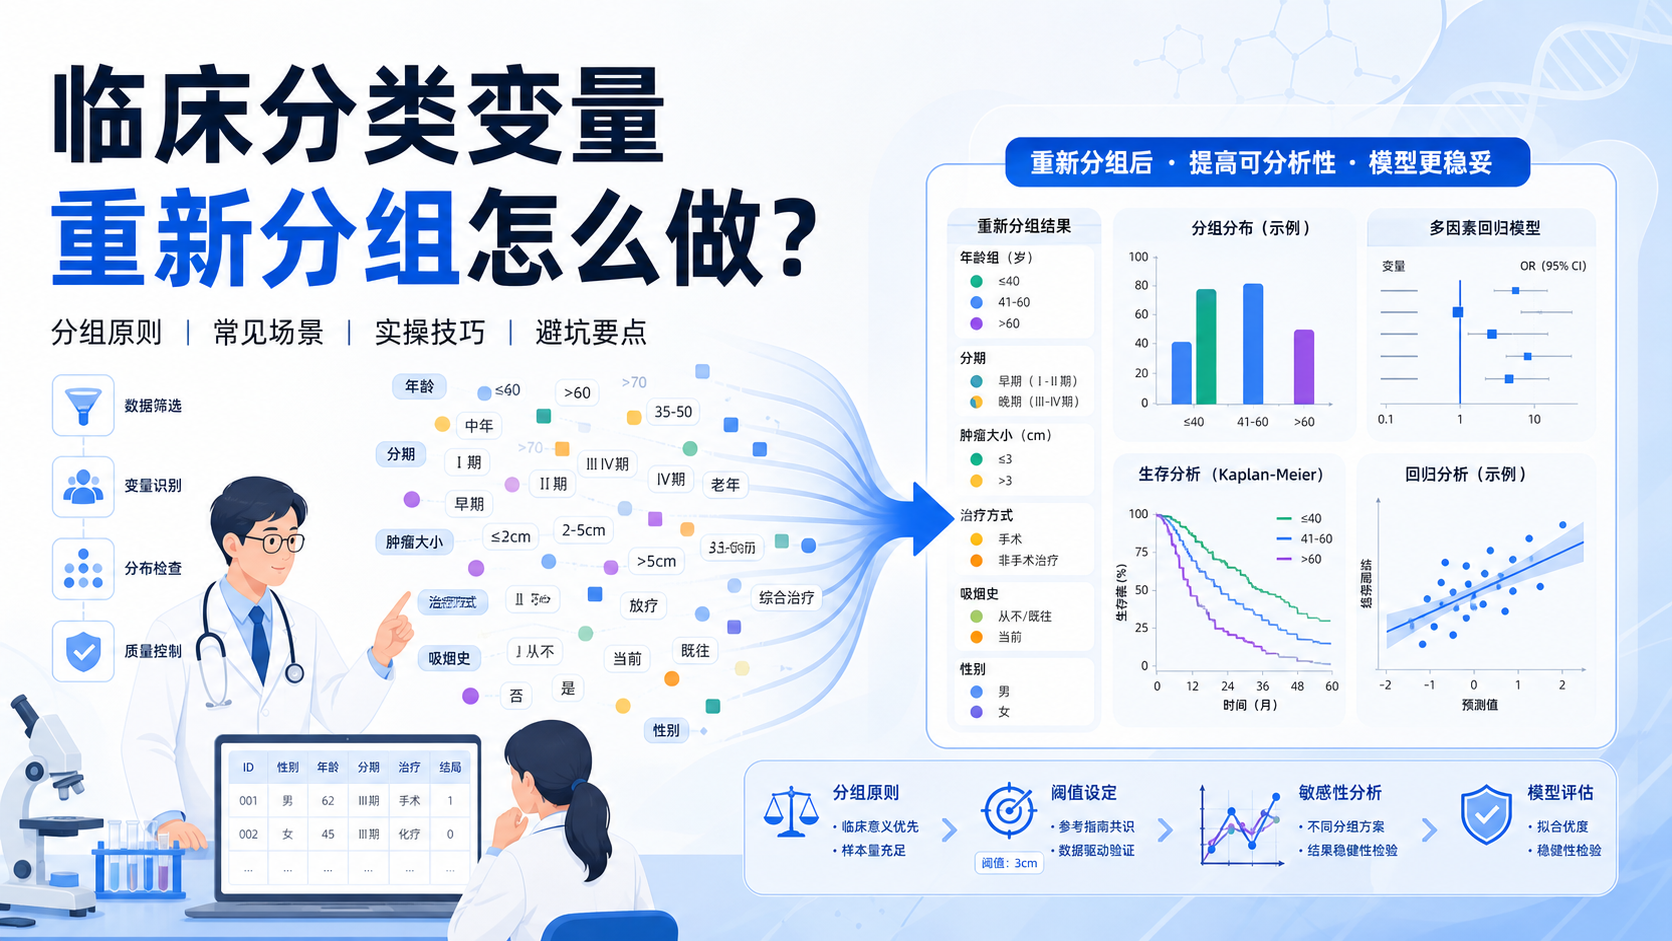
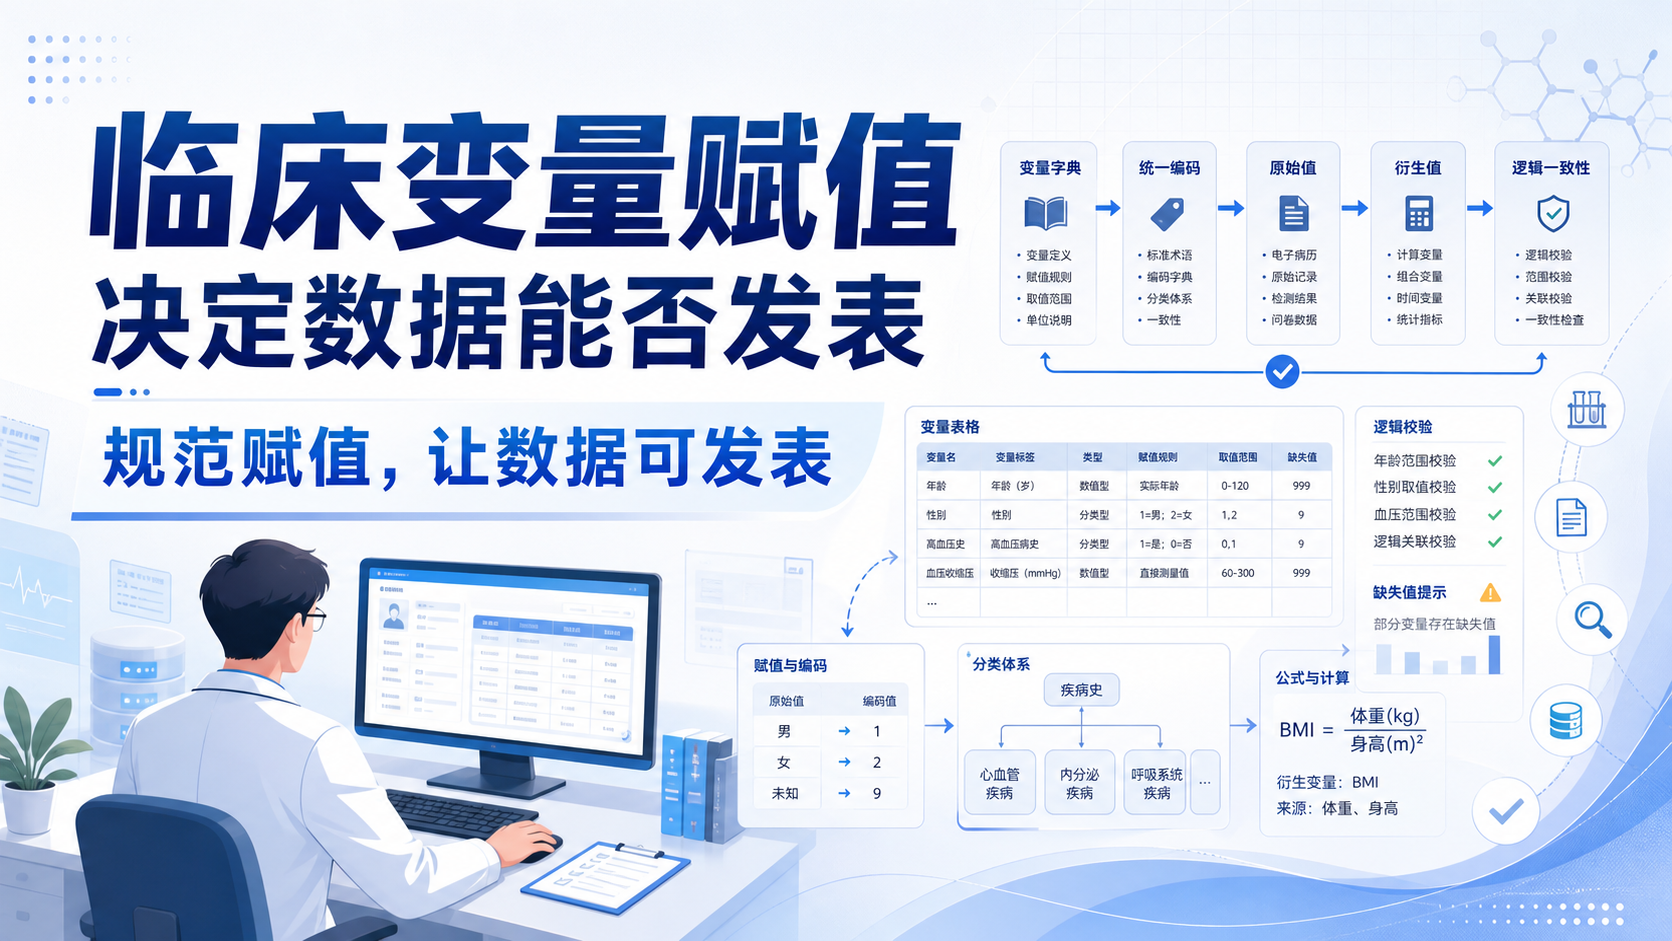
高质量数据来自高质量设计。研究启动前,应先明确变量定义、纳入排除标准、测量时间点和记录格式。问卷调查要避免歧义,病例表要减少开放式填写,关键指标要有统一判定标准。
建议提前完成以下工作:
- 制定标准化操作流程。
- 对研究人员进行统一培训。
- 先做小样本预实验。
- 明确缺失值和异常值处理规则。
- 设定数据字典和编码方案。
如果前期标准不统一,后期再补救,成本会成倍增加。
2.2 资料收集过程中,要控制一致性
资料收集阶段最重要的是一致性。不同人员、不同时间、不同地点采集的数据,必须尽量保持同一标准。比如同一生物标志物,采样条件、检测设备、判读阈值都应一致。否则,即便数值准确,也无法直接比较。
对于临床结局资料,还要重点减少以下情况:
- 已入组但不符合条件的病例。
- 中途自动退出的病例。
- 未接受规定治疗的病例。
- 私下交换分组的病例。
- 无法获得结局信息的病例。
这些对象越多,研究偏倚就越大。
2.3 数据录入后,核查比录入更重要
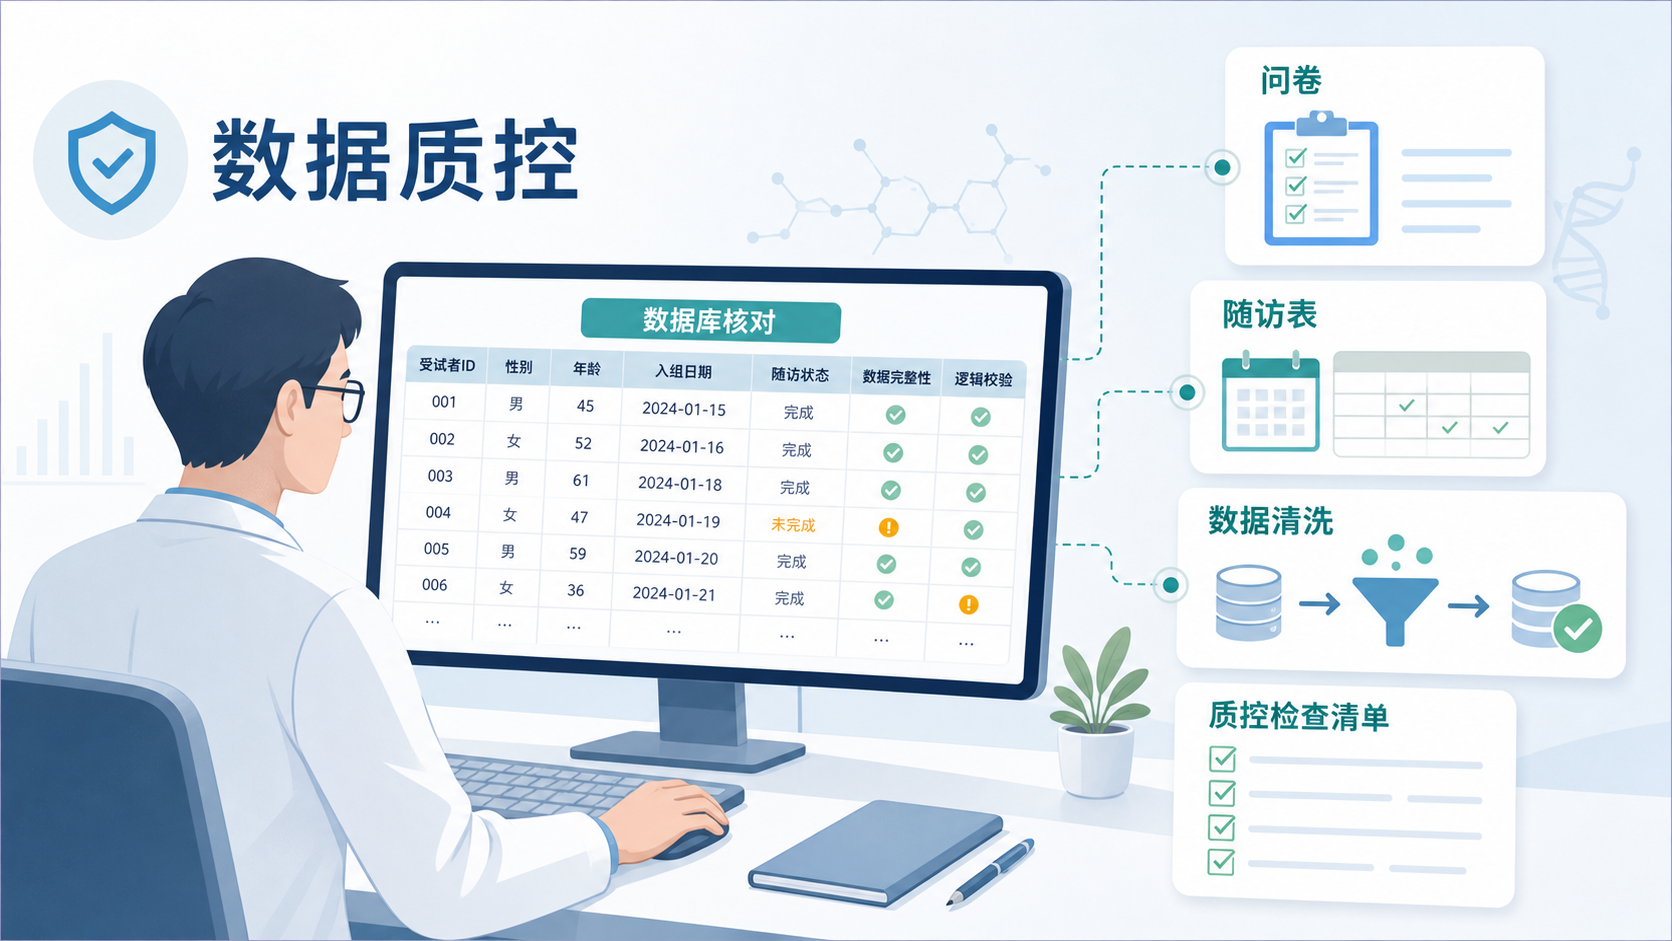
很多人以为数据输入完成就结束了,其实真正的质控才刚开始。录入后必须进行逻辑核查、范围核查和一致性核查。比如年龄不可能为负,随访日期不能早于入组日期,前后两次测量值若相差异常,需要回查原始记录。
建议保留三层校验:
- 原始病历与CRF互查。
- CRF与数据库比对。
- 异常值回溯原始来源。
没有核查的数据,只是“看起来完整”的数据。
3. 长期随访研究为什么更依赖质量控制
3.1 随访偏差是最常见的问题
长期随访研究中,失访会直接影响结果。常规医疗环境下,患者是否回访往往不可控。真正可获得结局信息的病例,常常只是原始人群中的一部分。这样一来,样本就可能发生选择性偏倚。
失访控制的关键,不是事后解释,而是事前预防。常见做法包括:
- 设置合理的随访间隔。
- 保留多个联系方式。
- 专人负责随访管理。
- 简化随访流程。
- 必要时提供交通补贴或便利服务。
有研究经验表明,失访率低于5%通常影响较小,但超过20%时,研究真实性和有效性会明显下降。
3.2 提高依从性,才能保住结局数据
依从性差,往往意味着疗效数据不稳定、结局判断不完整。要提高依从性,最好在研究启动前就做好预试验,判断方案是否可执行。对于复杂干预,还要考虑患者教育、沟通方式和服务可及性。
常见提升措施包括:
- 优化随访节奏。
- 提高研究团队沟通效率。
- 减少患者操作负担。
- 明确退出与转归规则。
- 必要时结合盲法减少信息偏差。
随访做得好,研究才有机会拿到完整终点。
4. 随机对照试验中,质量控制要特别关注什么
4.1 保持组间可比性是底线
RCT 的核心是随机分组,但随机并不等于天然完美。实际执行中,仍可能出现入组不均衡、治疗外流、资料缺漏等问题。因此,质量控制的目标是尽量维护组间可比性。
重点应关注:
- 分组后是否严格按方案执行。
- 是否存在跨组治疗。
- 是否有中途退出或失访。
- 是否采用统一结局判定标准。
一旦组间可比性被破坏,统计显著也未必代表真实因果。
4.2 意向性治疗分析能减少偏倚
在随机试验中,除了控制过程,还应坚持分析原则。意向性治疗分析,也就是 ITT 分析,要求按最初随机分组进行统计,而不是只看最终完成治疗的人群。这样可以尽量保留随机化带来的优势,减少人为筛选造成的偏差。
这也是为什么很多高质量研究会把质控和统计策略绑定在一起看。前者保障数据真实,后者保障结论稳健。两者缺一不可。
5. 医学科研数据质控整理,如何真正落地
5.1 从研究开始,就建立可执行的质控清单
最实用的方法,是把质控拆成可检查、可追踪、可回溯的清单。不要只停留在“加强管理”这种空话。每个环节都应有责任人和时间点。
可落地的质控清单包括:
- 变量定义表。
- 数据采集表。
- 缺失值追踪表。
- 异常值核查表。
- 随访记录表。
- 数据锁库前复核表。
只要清单足够清晰,质控就能从经验变成流程。
5.2 数据管理应服务于发表和复现
医学研究不只是做出来,还要经得起复核。一个规范数据库,不仅方便统计分析,也能支持后续投稿、补充分析和同行质询。对于医学生、医生和科研人员来说,真正有价值的不是“有数据”,而是“数据可用、可解释、可复现”。
这也是为什么越来越多团队开始重视专业的数据整理与质控支持。像解螺旋这类科研服务平台,能够帮助研究者把数据收集、整理、清洗和分析流程前置化、规范化,减少重复返工,把更多精力留给选题、验证和论文写作。对于想提升科研效率的人来说,可靠的数据质控就是最值得投入的一步。
总结Conclusion
医学研究数据不达标,往往不是样本不够,而是质量控制不到位。无论是横断面研究、队列研究,还是随机对照试验,数据的完整性、一致性和可追溯性,都是决定研究能否发表的基础。
如果你正在做临床研究,建议尽早把质控流程标准化,把随访、录入、核查、清洗四个环节做实。这样才能真正提升结论可信度,降低返工成本。若你希望更高效地完成医学科研数据质控整理,不妨借助解螺旋的专业支持,让数据从一开始就更接近发表标准。

- 引言Introduction
- 1. 为什么医学研究数据质控决定成败
- 2. 医学科研数据质控整理的核心环节
- 3. 长期随访研究为什么更依赖质量控制
- 4. 随机对照试验中,质量控制要特别关注什么
- 5. 医学科研数据质控整理,如何真正落地
- 总结Conclusion