14
 分享
引言Introduction
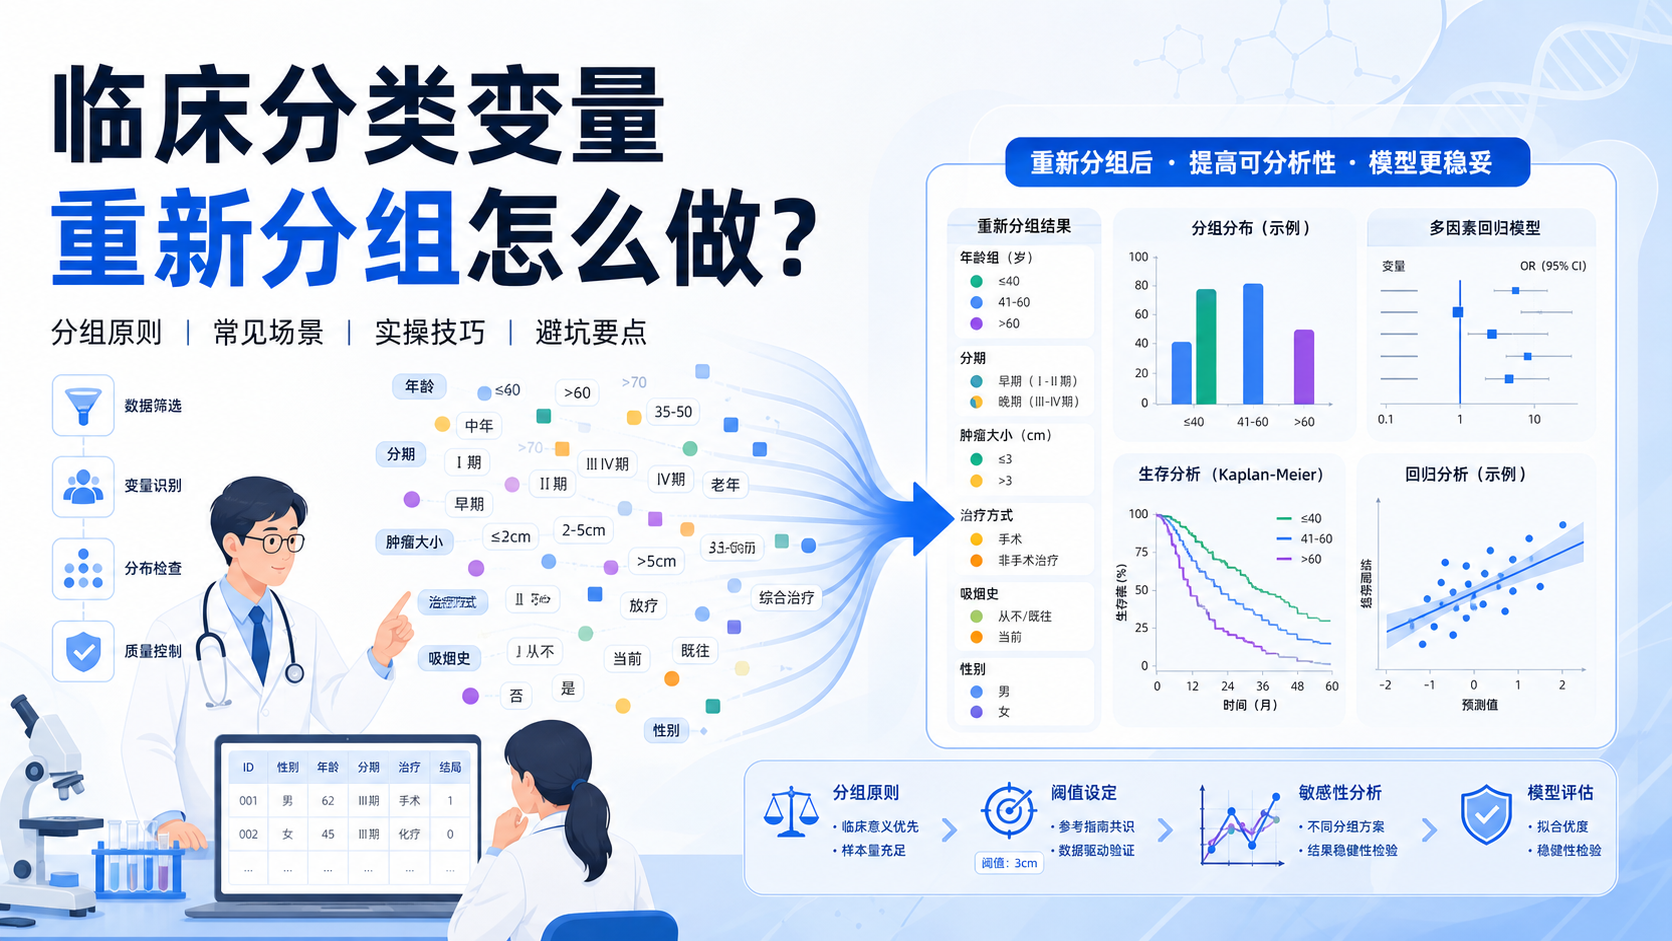
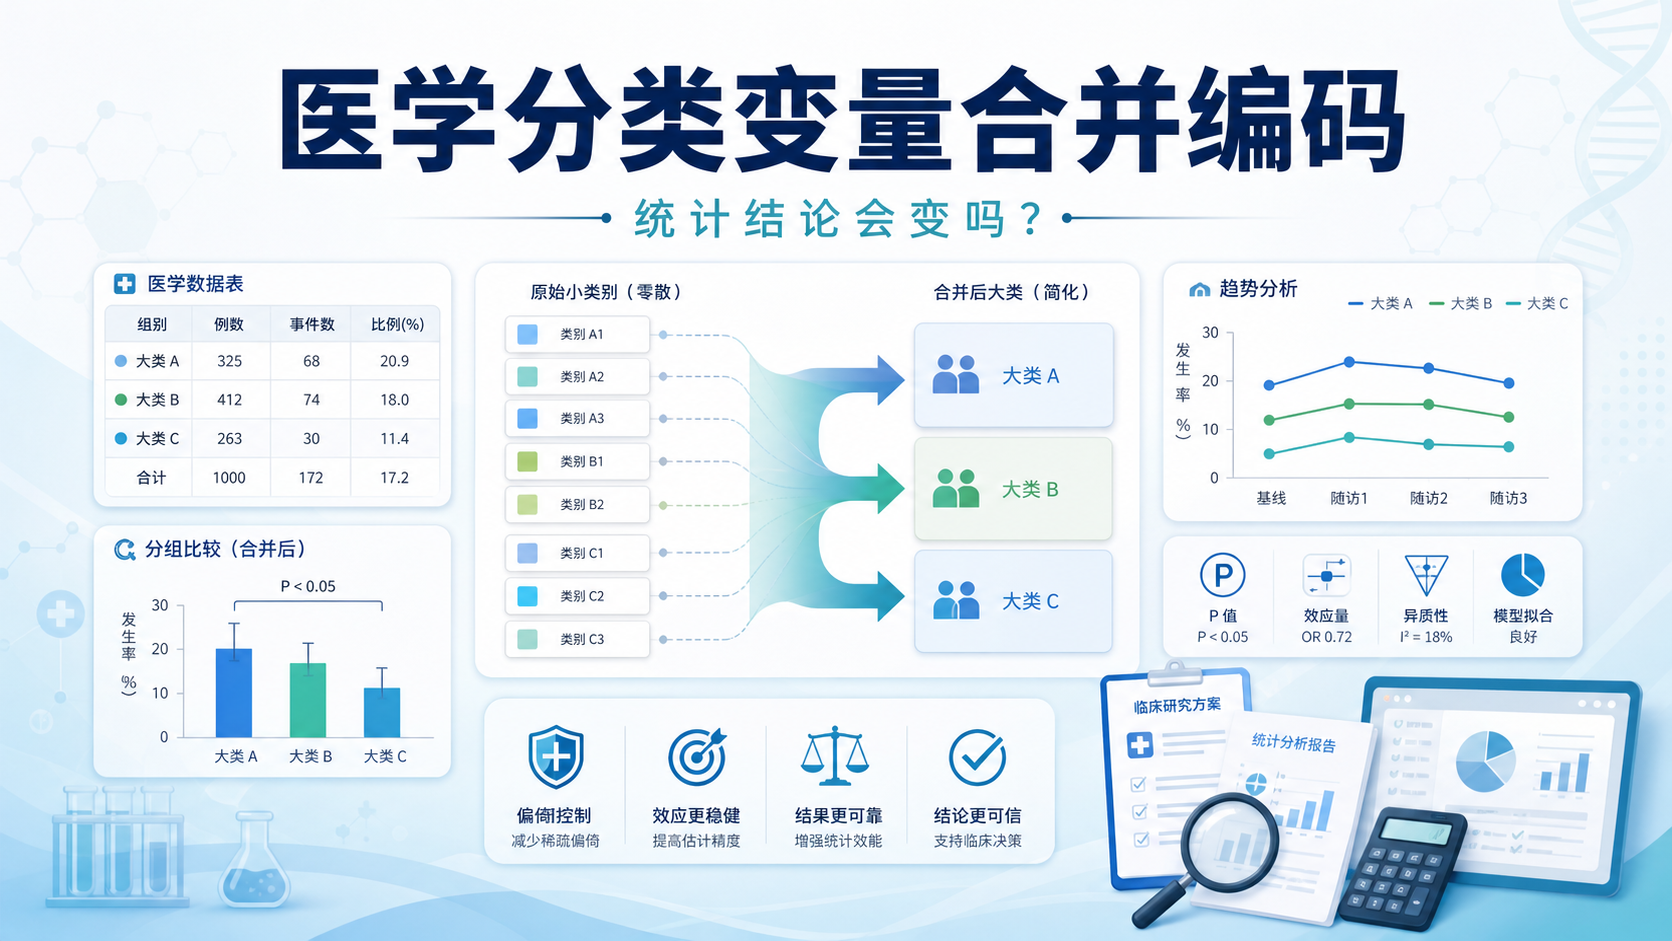
医学研究里,分类变量一旦分组过细,样本会被切得很散,结果不稳,结论也可能失真。相反,合并编码能提高统计效率,但也可能掩盖真实差异。关键不在于“能不能合并”,而在于“合并后会不会改变研究结论”。 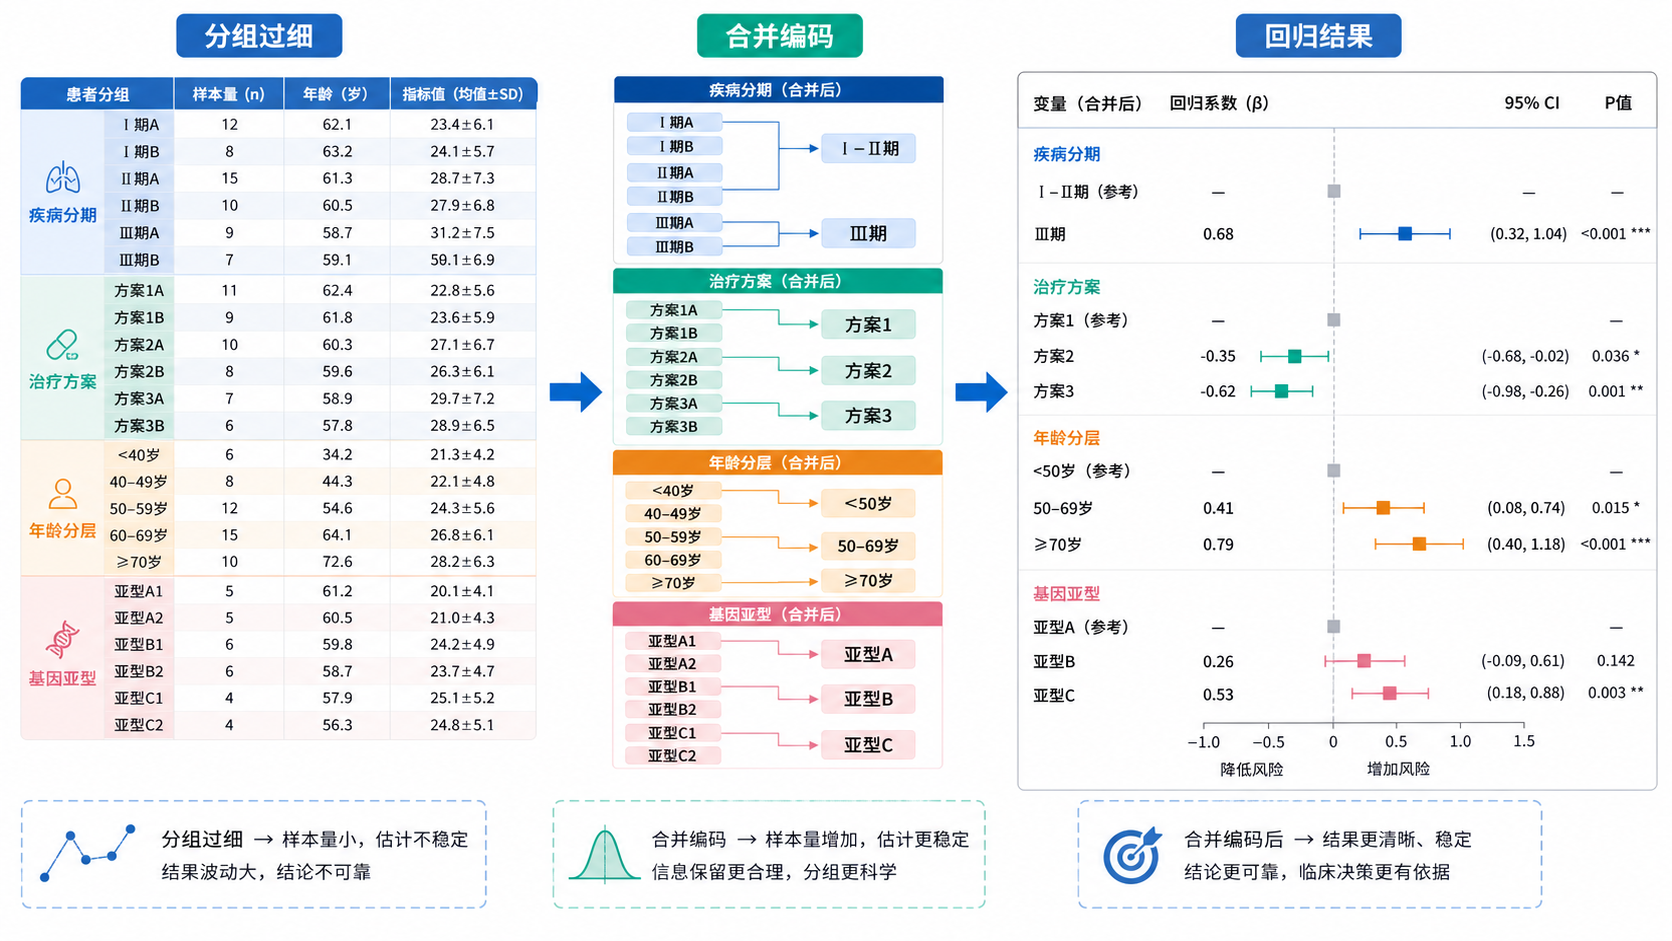
1. 为什么医学分类变量需要合并编码
1.1 变量太细,会让分析失去稳定性
临床数据里,很多分类变量天然有多个水平。比如年龄分组、疾病分级、手术方式、治疗反应等。若每一类样本很少,回归模型容易出现估计不稳,标准误变大,置信区间变宽。
当某个类别样本数过少时,OR值或HR值可能被极端值“拉偏”。 这在Logistic回归和Cox回归中都很常见。尤其是结局事件少、协变量多的情况下,模型更容易过拟合。
1.2 合并编码的核心目的,是提高可解释性
医学研究不是只追求“算得出来”,还要追求“讲得清楚”。过多类别会让结果表变复杂,读者也难以理解。
例如,把血压分成6组,可能得到6个效应量,但临床上更常见的表达是“正常、偏高、高血压”。合并后的结果更贴近临床决策,也更方便论文表述。
1.3 但合并并不等于优化
合并编码不是简单压缩类别。如果把本来有明显梯度差异的组别合并,信息会被吃掉。
比如把轻、中、重度三组并成两组,可能会让原本存在的剂量反应关系消失。这样虽然模型更简洁,但结论可能变得不准确。
2. 合并编码如何改变统计结论
2.1 结论可能从“显著”变为“不显著”
这是最常见的情况。原来某个变量分层后有统计学差异,合并后由于组内异质性增加,效应值被稀释,p值升高,结果可能不再显著。
这种变化并不罕见。原因在于合并后,相当于把原先不同风险水平的人放进同一组。组内差异越大,效应越容易被平均掉。
2.2 结论也可能从“不显著”变为“显著”
合并编码后,如果原本每组样本过少,模型不稳定,那么合并能提高统计功效。
当事件数增加、估计更稳定时,原来不显著的关联,可能变得有统计学意义。
但要注意,显著不等于更真实。 它可能只是因为样本量更集中,估计更平稳。研究者必须回到临床意义上判断,而不能只看p值。
2.3 合并方式不同,方向都可能变
这是最需要警惕的地方。不同的合并规则,可能带来不同甚至相反的结论。
例如,把某连续指标分为三组后,若选择“低+中”合并,和选择“中+高”合并,参考组结构会改变,OR值也会变。
也就是说,分类变量合并编码不是纯技术操作,它会直接影响效应量的方向、大小和显著性。 这也是为什么论文方法部分必须交代清楚分组依据。
3. 哪些情况适合做合并编码
3.1 原始分组样本过少
如果某些类别人数太少,比如每组只有个位数,模型容易出现不收敛、置信区间极宽、估计不稳定等问题。这时可以考虑合并。
常见经验是:
- 每个类别事件数过少。
- 某些类别与结局分布非常接近。
- 多分类变量进入模型后参数过多。
不过,合并前要先看临床逻辑,而不是只看频数。
3.2 类别之间具有明确临床相似性
如果两个类别在病理机制、临床处理或预后风险上确实接近,合并更合理。
比如某些相邻分级差异不大,或某些治疗方式本质上属于同一策略。
这类合并的好处是保留主要信息,同时减少噪音。临床同质性越强,合并越有说服力。
3.3 研究目的本来就是比较大类差异
如果研究问题关注的是“是否有高危状态”,而不是细到每一级差别,那么合并编码反而更符合研究目标。
例如把多个轻度异常合并为“非高危”,把中重度合并为“高危”。这种做法常用于筛查研究和风险分层。
4. 哪些情况不建议随意合并
4.1 存在明显剂量反应关系时
如果变量本身有明确梯度,比如轻、中、重度,或者低、中、高风险,随意合并可能掩盖剂量反应趋势。
一旦趋势被抹平,模型就会失去很多解释价值。
4.2 临床阈值有明确界限时
有些分类不是为了统计方便,而是基于公认阈值。比如某些实验室指标、疾病分层、诊断标准。
这类变量应优先尊重临床定义,而不是为了追求显著性任意合并。
4.3 合并依据来自“结果导向”
如果先看结局,再决定怎么合并分类变量,这很容易引入选择偏倚。
正确顺序应是先定义分组规则,再做分析。 否则结果可能被“优化”出来,但并不可靠。
5. 合并编码时,如何尽量减少偏倚
5.1 先看临床,再看统计
合并规则建议按以下顺序考虑:
- 是否有明确临床依据。
- 各组样本和事件数是否过少。
- 合并后是否保留主要信息。
- 合并后结局解释是否更合理。
临床逻辑永远优先于纯粹的统计便利。
5.2 做敏感性分析
这是判断合并是否影响结论的关键步骤。
可以比较不同分组方式下的结果,例如:
- 原始多分类模型。
- 两两合并后的模型。
- 按临床阈值重新分组后的模型。
如果不同方案结论一致,说明结果更稳健。
如果差异很大,就说明变量分组对结论高度敏感,论文中必须如实说明。
5.3 关注效应量,不只看p值
很多人只盯着显著性,忽略OR值、HR值和置信区间。
实际上,分类变量合并编码对效应量的影响,往往比对p值的影响更值得关注。
如果效应量大幅变化,说明分组方式已经改变了研究含义。
5.4 保留原始变量记录
即使最终采用合并编码,也建议保留原始分组。这样便于后续复核、补充分析和投稿修改。
对于科研团队来说,这一步很重要。它能提高数据可追溯性,也更符合规范化研究流程。
6. 论文写作中如何表达合并编码
6.1 方法部分要交代清楚
要说明:
- 合并前有几个类别。
- 合并依据是什么。
- 合并后形成哪些组。
- 是否基于临床阈值或样本量不足。
不要只写“将变量重新编码”,这样信息不够。
6.2 结果部分要说明变化
如果合并后结论发生变化,要诚实呈现。
比如原始分析中某变量显著,而合并后不显著,应说明这是由于样本量变化、组内异质性增加或效应稀释所致。
这样处理更符合E-E-A-T要求,也更容易获得审稿人认可。
6.3 讨论部分强调限制
可以指出:分类变量合并编码可能带来信息损失,并影响结果稳定性。
这不是缺点,而是研究设计中必须被正视的限制。
对于读者来说,透明报告比“只报一个最好看的结果”更可信。
7. 实操中如何判断合并是否合理
7.1 看样本分布
如果某一类样本极少,先问自己:
- 这一类是否可以与相邻组合并?
- 合并后是否仍保留临床意义?
- 是否会改变参考组结构?
7.2 看结局分布
如果某类中事件数接近0,回归模型常会不稳定。
此时合并往往比硬分析更合理。
但如果事件数足够,且各类风险差异明显,尽量保留原始分层。
7.3 看结果是否稳健
建议至少做一次敏感性分析。
如果不同编码方式下主要结论一致,说明研究更可靠。
如果结论对分组极其敏感,说明这个变量需要谨慎解释,必要时应在正文中重点提示。
7.4 借助专业工具提高规范性
在真实研究中,分类变量合并编码、哑变量设置、回归建模和敏感性分析,常常需要反复调整。
如果你希望更高效地完成数据整理、变量重编码和结果输出,可以借助解螺旋 的临床研究工具和课程体系,把编码规则、回归分析与论文表达串起来,减少反复试错。
总结Conclusion
医学分类变量合并编码会直接影响效应量、显著性和临床解释。 合并得当,可以提高稳定性和可读性。合并不当,则可能掩盖真实差异,甚至改变结论方向。研究者在处理这类变量时,应坚持临床优先、统计辅助、结果可复核的原则。若你正在进行论文分析或数据清洗,建议结合规范方法和工具支持,提升效率与可信度。需要系统化处理变量编码、回归分析和结果呈现时,可以关注** 解螺旋**。

- 引言Introduction
- 1. 为什么医学分类变量需要合并编码
- 2. 合并编码如何改变统计结论
- 3. 哪些情况适合做合并编码
- 4. 哪些情况不建议随意合并
- 5. 合并编码时,如何尽量减少偏倚
- 6. 论文写作中如何表达合并编码
- 7. 实操中如何判断合并是否合理
- 总结Conclusion