59
 分享
引言Introduction
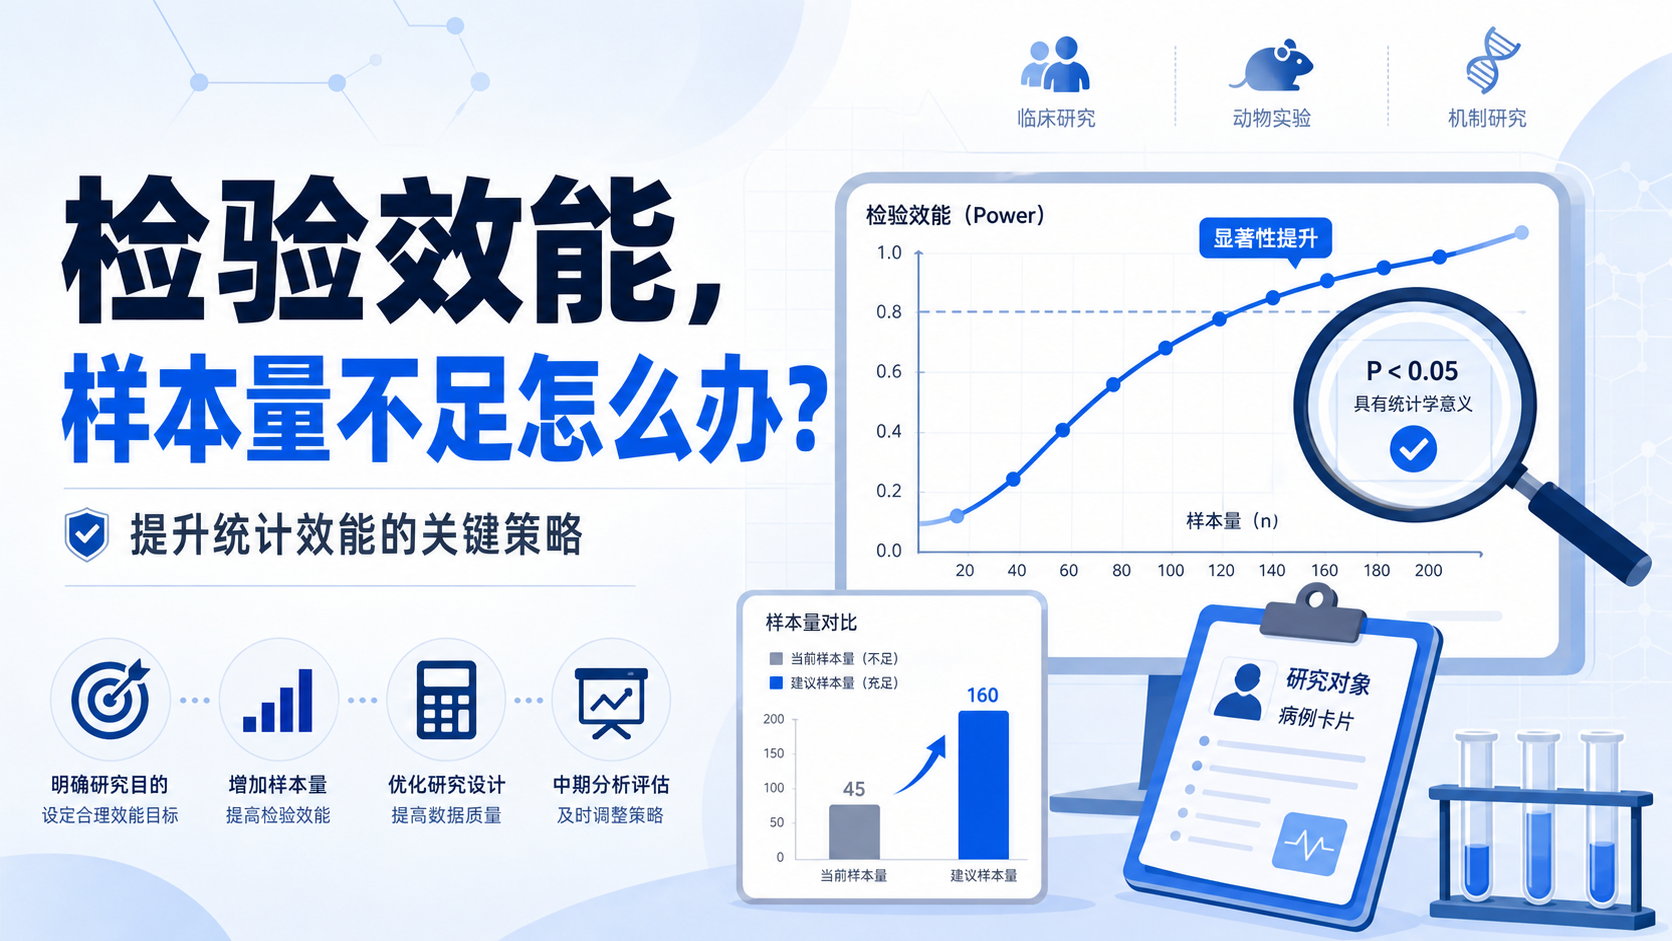
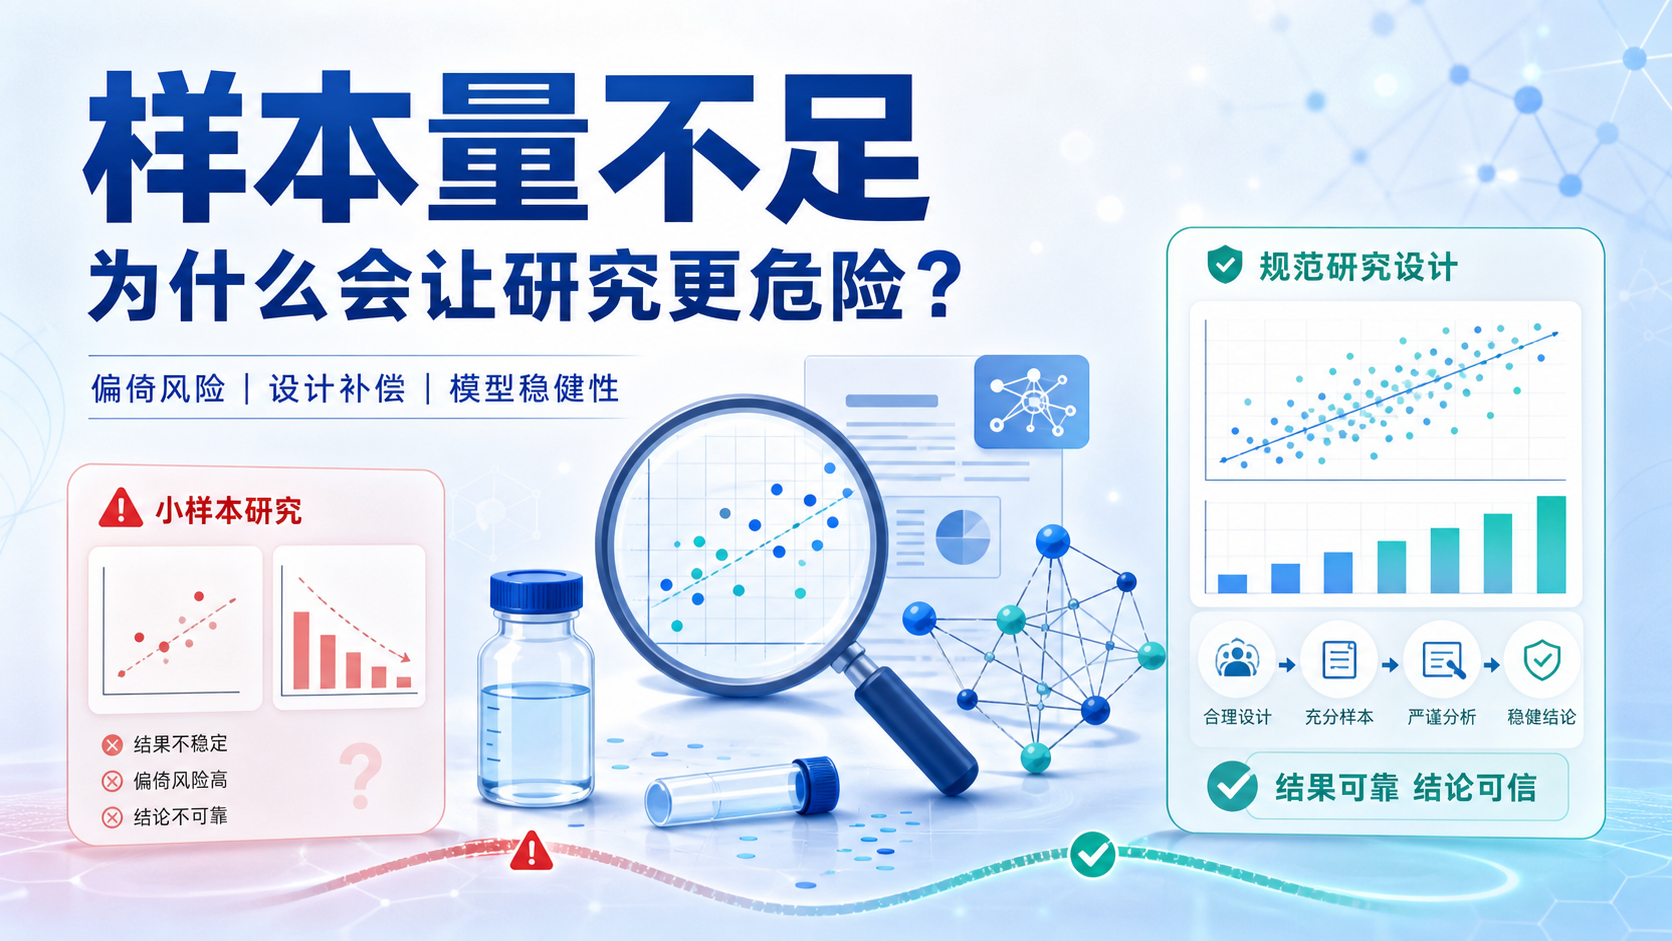
样本量不足,不只是“数据少一点”。它会直接放大偏倚风险,降低统计效能,还可能让模型、结论和临床应用一起失真。对医学生、医生和科研人员来说,真正难的是,如何在资源有限时,把研究做得尽量严谨。
1. 样本量不足,为什么会成为研究的核心问题
1.1 不只是“显著性变差”,更是偏倚风险上升
样本量不足最直接的后果,是检验效能下降。也就是,真实存在的差异更容易被漏检。
但这还不是全部。更严重的是,样本量过小常常和选择偏倚、信息偏倚、过度拟合同时出现。
例如在预测模型研究中,结局事件太少,会让回归系数不稳定,模型区分度看似不错,实际校准可能很差。PROBAST工具也明确把“结局事件数不足”视为高风险信号之一。
1.2 样本量不足时,最容易出现哪些偏差
常见问题主要有四类:
- 选择偏倚 。纳入的样本不代表目标人群。
- 信息偏倚 。测量方法不一致,结局或暴露错分。
- 混杂偏倚 。关键混杂因素未控制。
- 过度拟合 。模型参数过多,事件太少。
一句话总结:样本量少,不等于只是“误差变大”,而是整个研究结构都更脆弱。
2. 样本量不足偏倚,通常从哪里发生
2.1 研究对象不代表源人群
在PROBAST的领域一“研究对象”中,核心是判断样本是否能反映源人群中的真实关系。
如果纳入标准过严,或者因便利抽样只收集某一类患者,结果就可能无法外推。
比如:
- 诊断预测模型,不应排除合并其他疾病者。
- 预后预测模型,不应把基线已患结局但未确诊者随意排除。
- 传统病例对照研究,不适合作为低风险证据来源。
样本量不足时,研究者往往为了“凑数”扩大纳入范围,但这又可能引入新的选择偏倚。
2.2 测量不统一,导致信息偏倚被放大
样本少时,每个个体的数据权重都更大。只要结局定义或预测因子测量不一致,偏倚就会被放大。
PROBAST领域二和领域三都强调:
- 预测因子应采用同一定义和同一测量方法。
- 临床结局最好参考指南公认标准。
- 结局测量应尽量采用盲法。
- 结局定义不能在数据分析时临时决定。
样本量越小,任何一次错分都更容易改变结果方向。
2.3 数据分析阶段“硬凑模型”,最危险
样本量不足时,研究者常见的补救方式是:
- 增加自变量数量。
- 把连续变量临时二分。
- 单纯依赖单变量筛选。
- 删除缺失样本。
这些做法会进一步提高偏倚风险。
尤其是连续变量在分析阶段临时转为二分类变量,若没有内部验证和回归系数收缩,通常应视为高风险。
换句话说,样本少时最怕的不是少,而是“少还乱用”。
3. 严谨设计,如何尽量把样本量不足的伤害降到最低
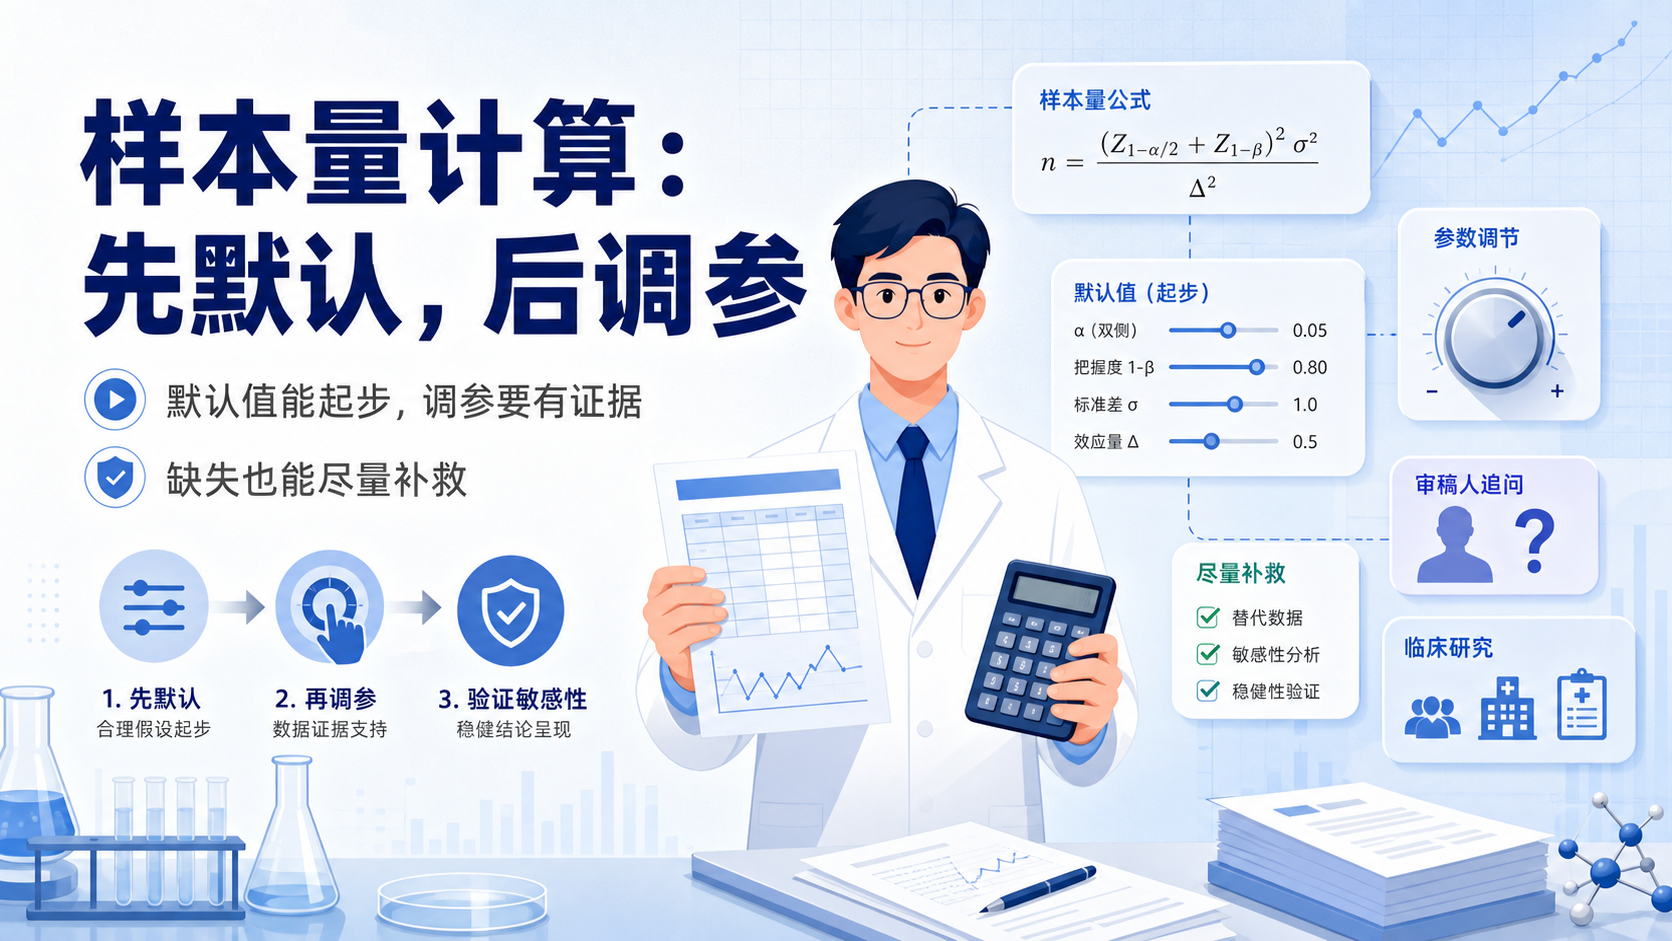
3.1 先做样本量估计,再谈研究启动
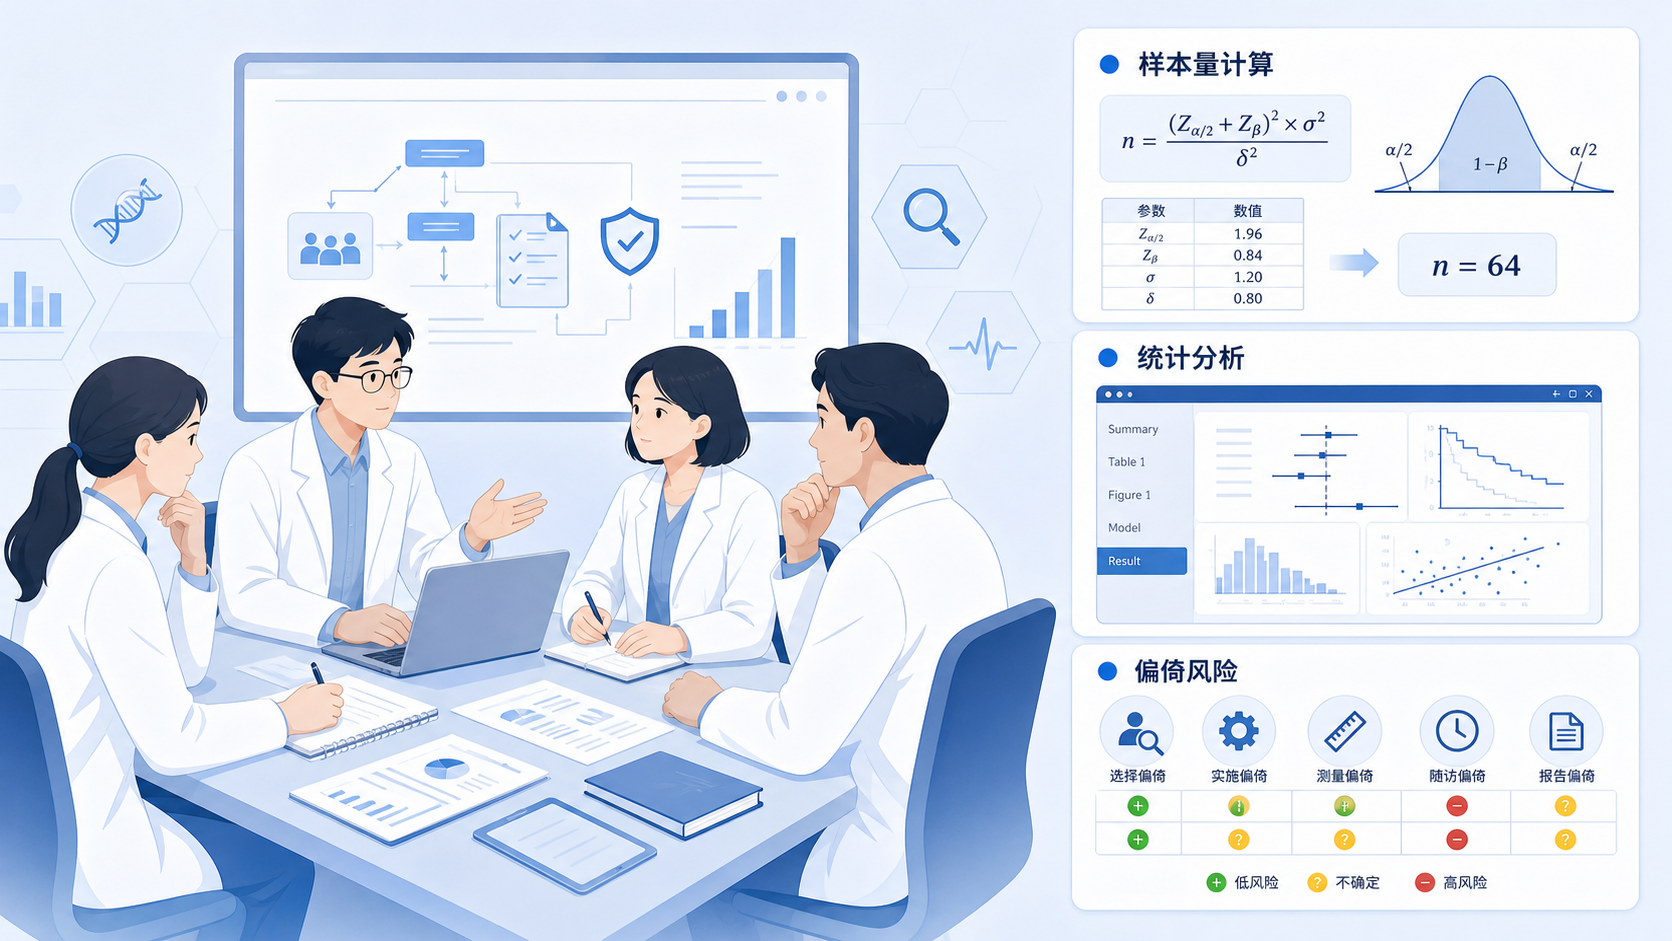
研究设计阶段就要完成样本量计算,而不是数据收集后再补救。
不同研究类型,计算思路不同:
- 横断面研究 ,常根据患病率或均数估计样本量。
- 病例对照研究 ,重点看暴露率、效应量和组间比例。
- 队列研究 ,重点看暴露组与对照组事件率差异。
- 预测模型研究 ,重点看事件数,而不是仅看总样本数。
预测模型研究尤其要关注事件数。EPV过低时,模型极易过拟合。
3.2 优先提高“有效样本”,而不是盲目扩大总样本
如果经费或时间有限,与其粗放增加入组人数,不如提高每个样本的质量。可优先考虑:
- 减少无效纳入和失访。
- 提高测量一致性。
- 统一结局判定标准。
- 提前设计随访节点。
- 减少缺失值。
在实践中,10%的失访和10%的问卷不合格,会把原本勉强够用的样本量迅速拉低到不合格水平。
3.3 用设计补偿样本量不足
当样本客观不足时,可以通过设计优化来弥补一部分风险:
- 选择更合适的研究设计。
- 增加随访质量,而不是只增加数量。
- 采用匹配设计,减少混杂。
- 预先定义结局,减少选择性报告。
- 必要时采用内部验证、bootstrap或交叉验证。
这些方法不能“凭空创造样本”,但能减少不稳定估计带来的损失。
4. 预测模型研究中,样本量不足最容易踩的坑
4.1 结局事件太少,模型必然不稳
在预测模型里,真正决定稳定性的不是总人数,而是发生结局的事件数。
事件太少时,模型参数会剧烈波动,最终导致:
- 回归系数偏大或偏小。
- 过拟合严重。
- 校准曲线失真。
- 外部验证性能明显下降。
如果EPV小于10,通常需要非常谨慎,甚至必须进行内部验证和系数收缩。
4.2 缺失值处理错误,会进一步放大偏倚
常见错误是把缺失值单独作为一类处理。
这在统计上看似“保留了样本”,实际上常常制造新的分类偏倚。更稳妥的做法是根据数据机制考虑多重插补等方法。
样本越少,越不能简单粗暴地删掉缺失值。
因为每删掉一个样本,剩余样本的代表性就更差。
4.3 变量筛选不能只看单因素P值
单变量筛选看起来简单,但风险很高。
更合理的原则是结合:
- 临床知识。
- 测量可靠性。
- 可及性。
- 一致性。
- 成本与可重复性。
研究不是在筛“最显著的变量”,而是在筛“最可信的变量”。
5. 样本量不足时,研究还能怎么做得更稳
5.1 先把研究问题收窄
如果样本确实有限,最实用的方法不是硬撑一个大而全的课题,而是把问题收窄。
例如:
- 只研究一个主要结局。
- 只保留最关键的预测因子。
- 明确主要分析,不同时铺开多个亚组。
- 提前定义主要终点和次要终点。
问题越聚焦,样本量越容易支撑结论。
5.2 把统计方案写在前面
建议在研究开始前写清楚:
- 样本量估计依据。
- 主要终点。
- 纳排标准。
- 缺失值处理方法。
- 统计模型和敏感性分析。
- 内部验证方案。
这样做的价值是,哪怕样本不足,也能最大限度减少事后调整带来的偏倚。
5.3 必要时寻求专业工具支持
很多研究并不是设计思路错了,而是缺少可执行的统计支持。
从样本量计算,到预测模型建模,再到偏倚风险评估,规范工具和方法都很关键。
如果你正在做临床研究、模型研究或系统评价,可以借助解螺旋的专业内容和工具支持,把样本量设计、偏倚控制和统计分析前置化。 这类支持的核心价值,不是“替你写结果”,而是帮你把研究一开始就做对。
总结Conclusion
样本量不足,不是简单的“人少一点”。它会同时推高选择偏倚、信息偏倚和过度拟合风险。真正严谨的做法,是在研究设计阶段就完成样本量估计,明确结局和变量,减少缺失与错分,并用合适的统计方法做内部验证。
如果你正在为样本量不足偏倚、模型不稳或结论不可信而困扰,下一步不是硬上,而是重做设计。 想把研究尽量做稳、做准、做得更容易发表,可以结合解螺旋的专业支持,从源头降低偏倚风险。

- 引言Introduction
- 1. 样本量不足,为什么会成为研究的核心问题
- 2. 样本量不足偏倚,通常从哪里发生
- 3. 严谨设计,如何尽量把样本量不足的伤害降到最低
- 4. 预测模型研究中,样本量不足最容易踩的坑
- 5. 样本量不足时,研究还能怎么做得更稳
- 总结Conclusion