46
 分享
引言Introduction
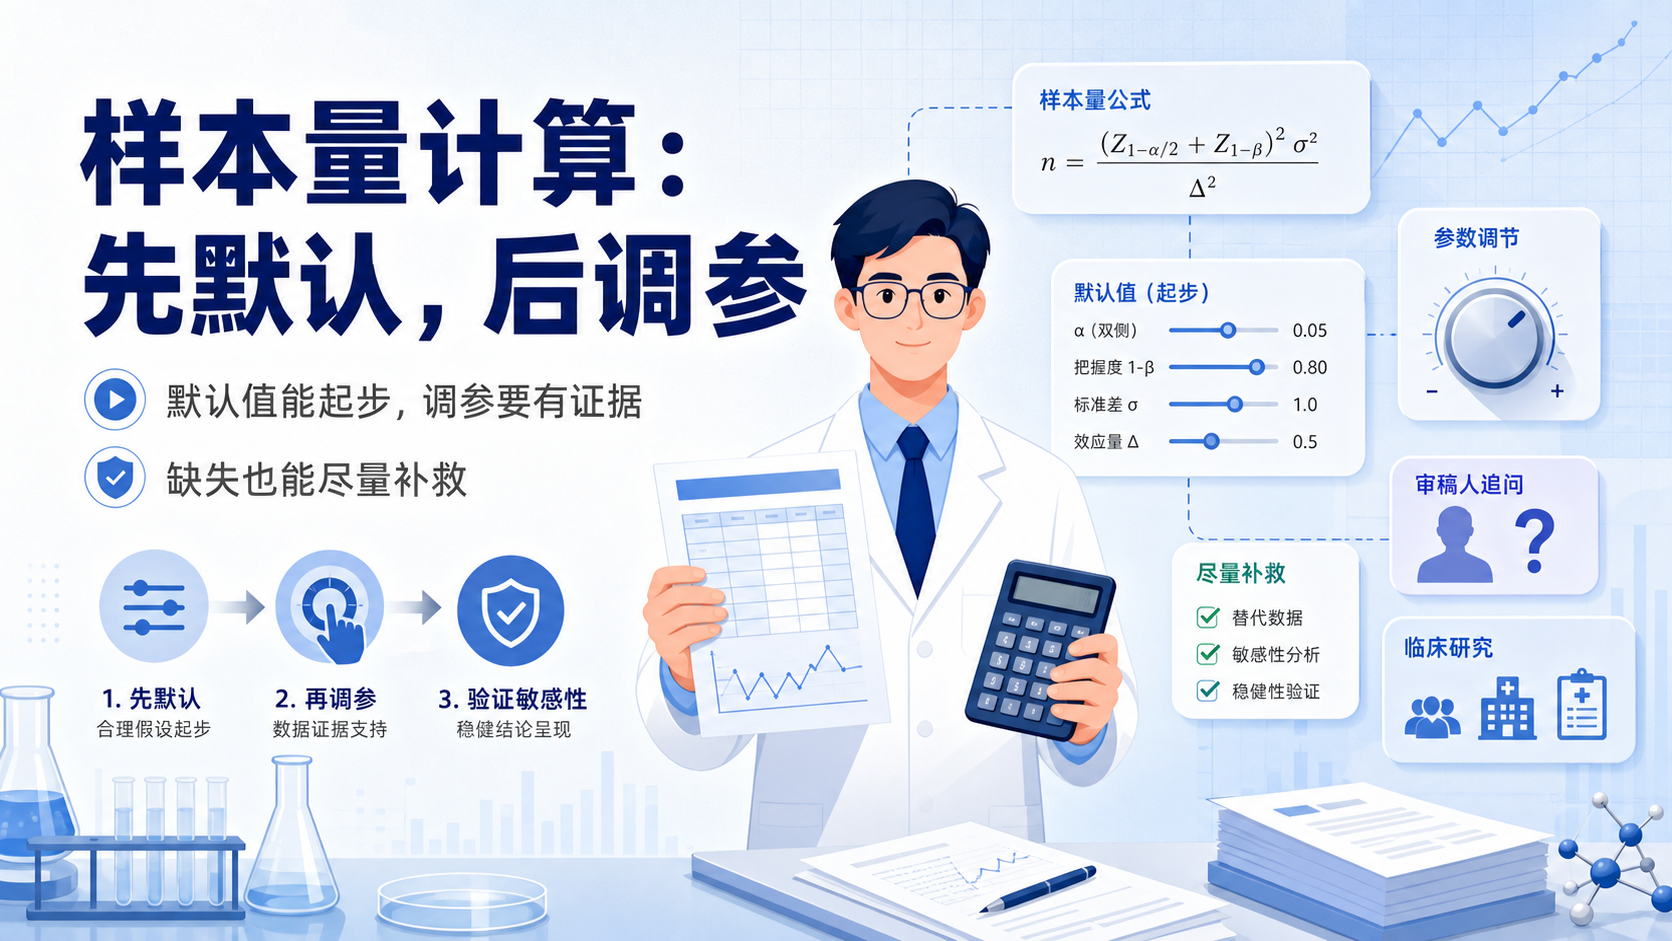
样本量算错,轻则结果不稳,重则论文被质疑“设计先天不足”。很多医学生和临床研究者卡在一个问题上,软件默认值要不要改,什么时候能改,改了会不会更科学。答案不是一刀切,而是先看研究设计,再看参数依据。
1. 先明确:样本量计算不是“填个数字”
1.1 研究设计决定公式
样本量计算的前提,不是先选软件,而是先定研究问题。横断面、病例对照、队列研究、临床试验,所用公式完全不同。同样是“算样本量”,不同设计对应的参数和逻辑并不一样。
例如,横断面研究常关注患病率或均值。病例对照研究更关心暴露率差异或OR。队列研究则常比较结局发生率。临床试验还要结合效应量、检验水准、把握度和失访率。设计没定清,样本量就没有计算基础。
1.2 参数不是越多越好
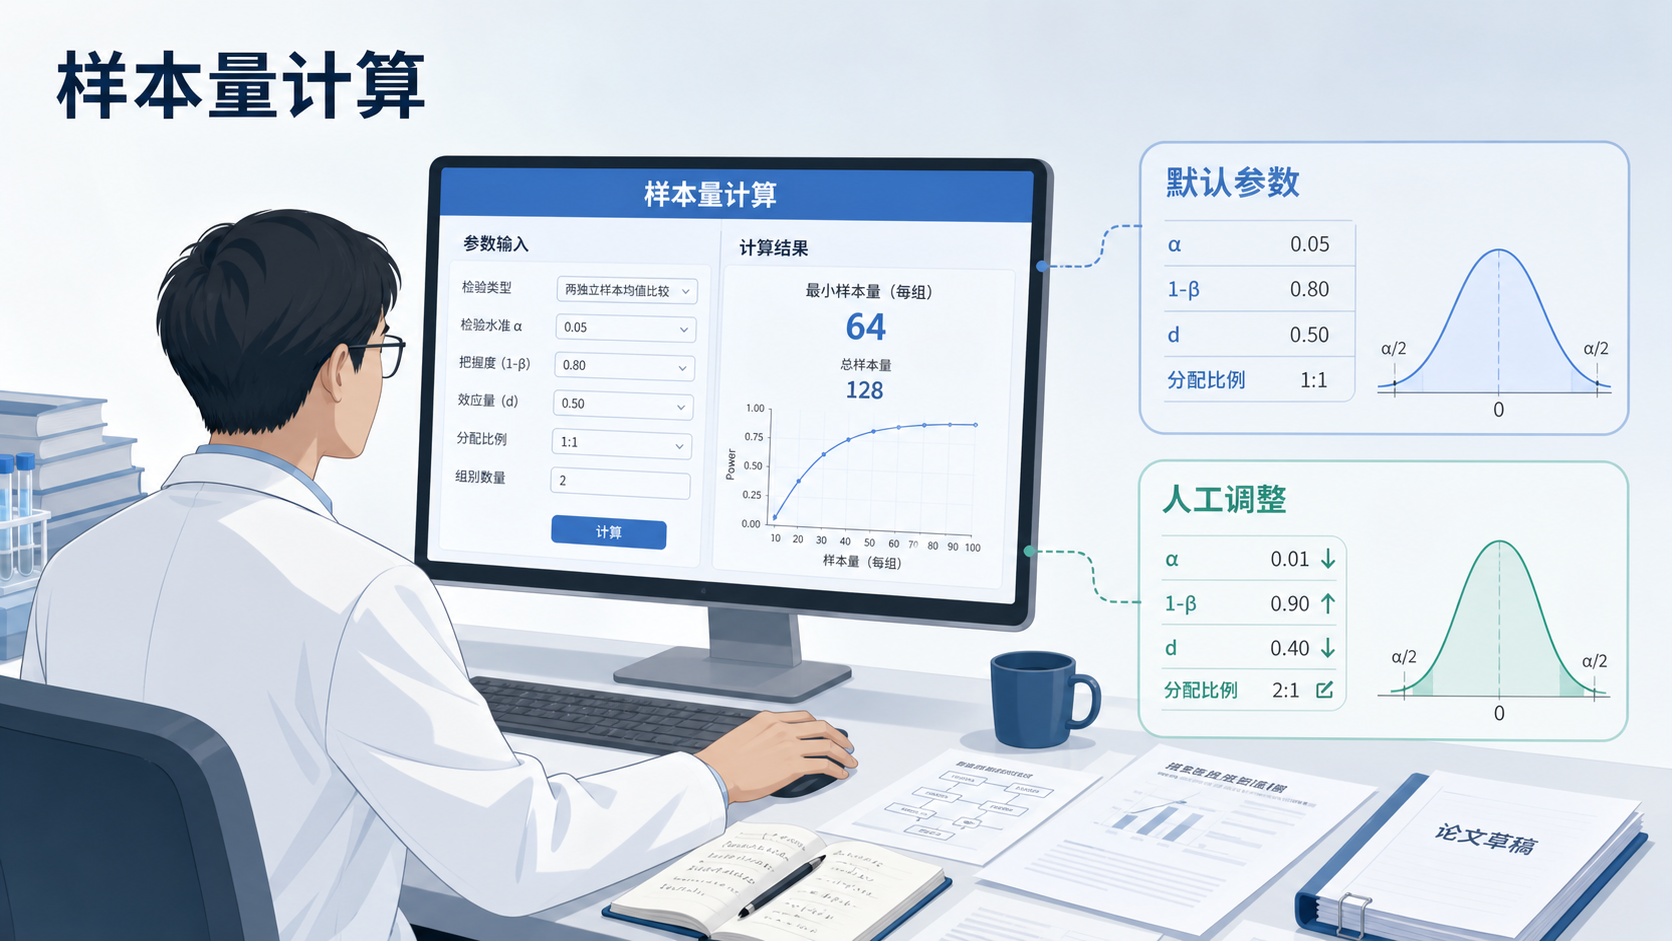
样本量计算常见参数包括α、β、效应量、标准差、容许误差、暴露率或事件率。这些参数不是随便填,而是要有文献、预实验或临床经验支持。
如果没有依据,填进去的数字只是“看起来合理”,并不等于科学。
实际写论文时,建议把参数来源写清楚:
- α通常取0.05。
- 把握度常取80%或90%。
- 效应量来自文献或预调查。
- 标准差来自既往研究。
- 失访率按真实随访场景估计。
2. 默认值的意义:适合大多数基础研究
2.1 默认值的优势
很多统计软件给出的默认参数,本质上是为常规科研场景准备的。对于初学者,默认值的最大好处是降低出错率。如果你对统计不熟,优先用默认值通常比“凭感觉调参”更安全。
默认值还有一个优点,就是便于复现。审稿人看到明确的默认设置、清楚的公式、规范的软件版本,更容易理解你的研究路径。尤其在开题、伦理和基金申请阶段,这种写法更稳妥。
2.2 什么情况下可以不改默认值
以下情况,默认值通常可直接使用:
- 常规横断面调查。
- 常规两组比较。
- 常见α和把握度设置。
- 文献支持充分,参数来源明确。
如果研究问题标准、数据来源明确、没有特殊抽样设计,默认值往往已经足够。
对多数基础临床研究来说,真正重要的不是“改不改参数”,而是“参数有没有依据”。
3. 调参不是禁区,但必须有理由
3.1 什么时候可以人工干预
当研究存在特殊设计或特殊现实约束时,参数可以调整。比如:
- 预期效应量特别小。
- 暴露率或事件率明显偏低。
- 需要提高把握度。
- 有严格的经费或招募限制。
- 采用1:n匹配或复杂抽样。
调参的前提是你知道自己在改什么,以及为什么改。
如果只是因为想让样本量更小,或者为了“好做研究”而随意改参数,这样的做法在统计上站不住脚。
3.2 哪些参数最常被误改
最容易被乱改的,通常是以下几个:
- α值。
- 把握度。
- 预计效应量。
- 标准差。
- 容许误差。
其中,α值并不是不能变,但变更后要有清楚理由。比如某些探索性研究会使用更宽松的阈值,但这属于研究策略的一部分,不能默认照搬。对于非统计学高手,最稳妥的做法是保持默认,并查阅文献或请统计人员复核。
4. “样本量估算缺失”会带来什么问题
4.1 审稿人最常追问的点
如果论文里没有样本量估算,常见问题有三个:
- 研究是否有足够把握发现差异。
- 阴性结果是否因为样本不足。
- 研究设计是否经过前期论证。
样本量估算缺失,会直接削弱论文的可信度。
尤其是临床研究和回顾性分析,审稿人会追问你为什么纳入这么多或这么少病例。没有样本量依据,就很难证明设计是合理的。
4.2 缺失不等于不能补救
如果已经完成研究,但事前未做样本量估算,也不是完全没办法。可以在论文中说明:
- 这是回顾性研究,样本来自数据库或病历系统。
- 纳入全部符合条件的病例。
- 研究样本受现实可得性限制。
- 结果解释需结合统计效能谨慎解读。
但要注意,事后解释不能替代规范的样本量设计。
如果能补做,最好补上。至少在方法学和局限性中交代清楚。
5. 医学论文里,哪些情况更适合“默认”,哪些情况必须“调参”
5.1 更适合默认的场景
默认设置更适合以下场景:
- 研究问题简单。
- 参数可从经典文献直接获得。
- 设计符合常规统计框架。
- 研究团队缺少专职统计支持。
这类研究里,“默认”往往意味着稳健、可解释、低风险。
尤其对学生论文、开题报告和小样本探索性研究,默认值通常是更合理的起点。
5.2 必须调参的场景
以下情况建议主动调整并说明理由:
- 采用1:2、1:3病例对照匹配。
- 暴露率极低。
- 事件率偏低且预期差异很小。
- 多中心研究,入组结构复杂。
- 需要按亚组分析预留样本。
- 研究有明确的非标准设定。
当研究本身不是“标准题型”时,就不能只靠默认。
例如队列研究中事件很少,若仍照搬默认值,常会低估样本量。反过来,过度保守也会导致资源浪费。
6. 更实用的做法:先默认,再验证,再微调
6.1 三步法更适合临床研究
对大多数医学生和医生来说,推荐按这个顺序做:
-
先用默认值跑一次。
看看样本量大概落在哪个范围。 -
再核对参数来源。
检查效应量、标准差、事件率有没有文献支撑。 -
最后根据研究现实微调。
例如考虑失访率、分组比例、招募能力和数据完整性。
这个过程比“直接上手改参数”更可靠。默认值是起点,不是终点。
6.2 写作时要把逻辑写出来
在论文方法学里,建议写清楚三件事:
- 采用了什么研究设计。
- 样本量计算依据来自哪里。
- 是否考虑失访、分组比例或安全边际。
例如,可以写成:
- 基于既往文献估计效应量。
- 设定α为0.05,把握度为80%。
- 在此基础上增加10%失访率。
- 最终得到目标样本量。
这种写法比只写“根据公式计算得出样本量”更专业。
7. 结尾:默认值能起步,调参要有证据,缺失要尽量补救
样本量计算不是机械操作。它的核心,是让研究设计和统计推断匹配。默认值适合常规研究,调参适合特殊场景,但前提都是“有依据”。
如果你的论文存在样本量估算缺失,建议尽快补上计算逻辑,至少在方法和局限性中交代清楚。
对需要规范论文设计、补齐统计逻辑、提升发表质量的研究者来说,可以借助解螺旋 获取更系统的写作与统计支持。把样本量算对,研究才更稳,论文也更容易过审。

- 引言Introduction
- 1. 先明确:样本量计算不是“填个数字”
- 2. 默认值的意义:适合大多数基础研究
- 3. 调参不是禁区,但必须有理由
- 4. “样本量估算缺失”会带来什么问题
- 5. 医学论文里,哪些情况更适合“默认”,哪些情况必须“调参”
- 6. 更实用的做法:先默认,再验证,再微调
- 7. 结尾:默认值能起步,调参要有证据,缺失要尽量补救