19
 分享
引言Introduction
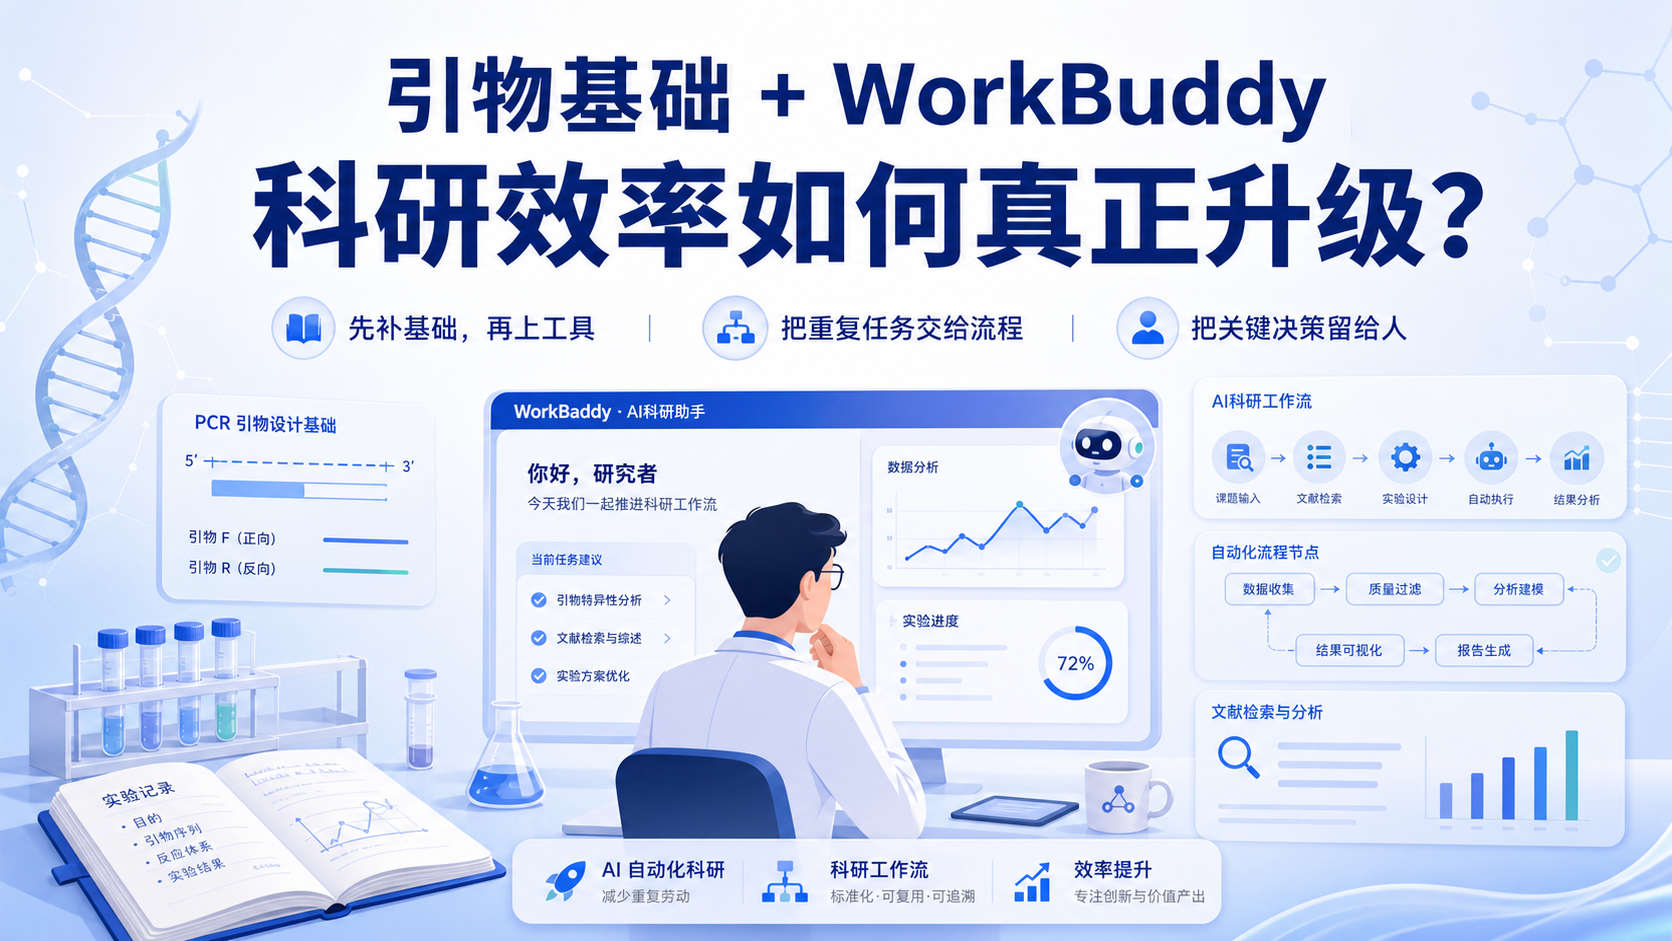
医学科研里,最耗时的往往不是实验本身,而是前期信息筛选。面对海量文献,如何快速锁定基序相关线索,决定了选题效率和后续分析质量。WorkBuddy 的基序搜索功能,正是为解决这一类高频痛点而设计。 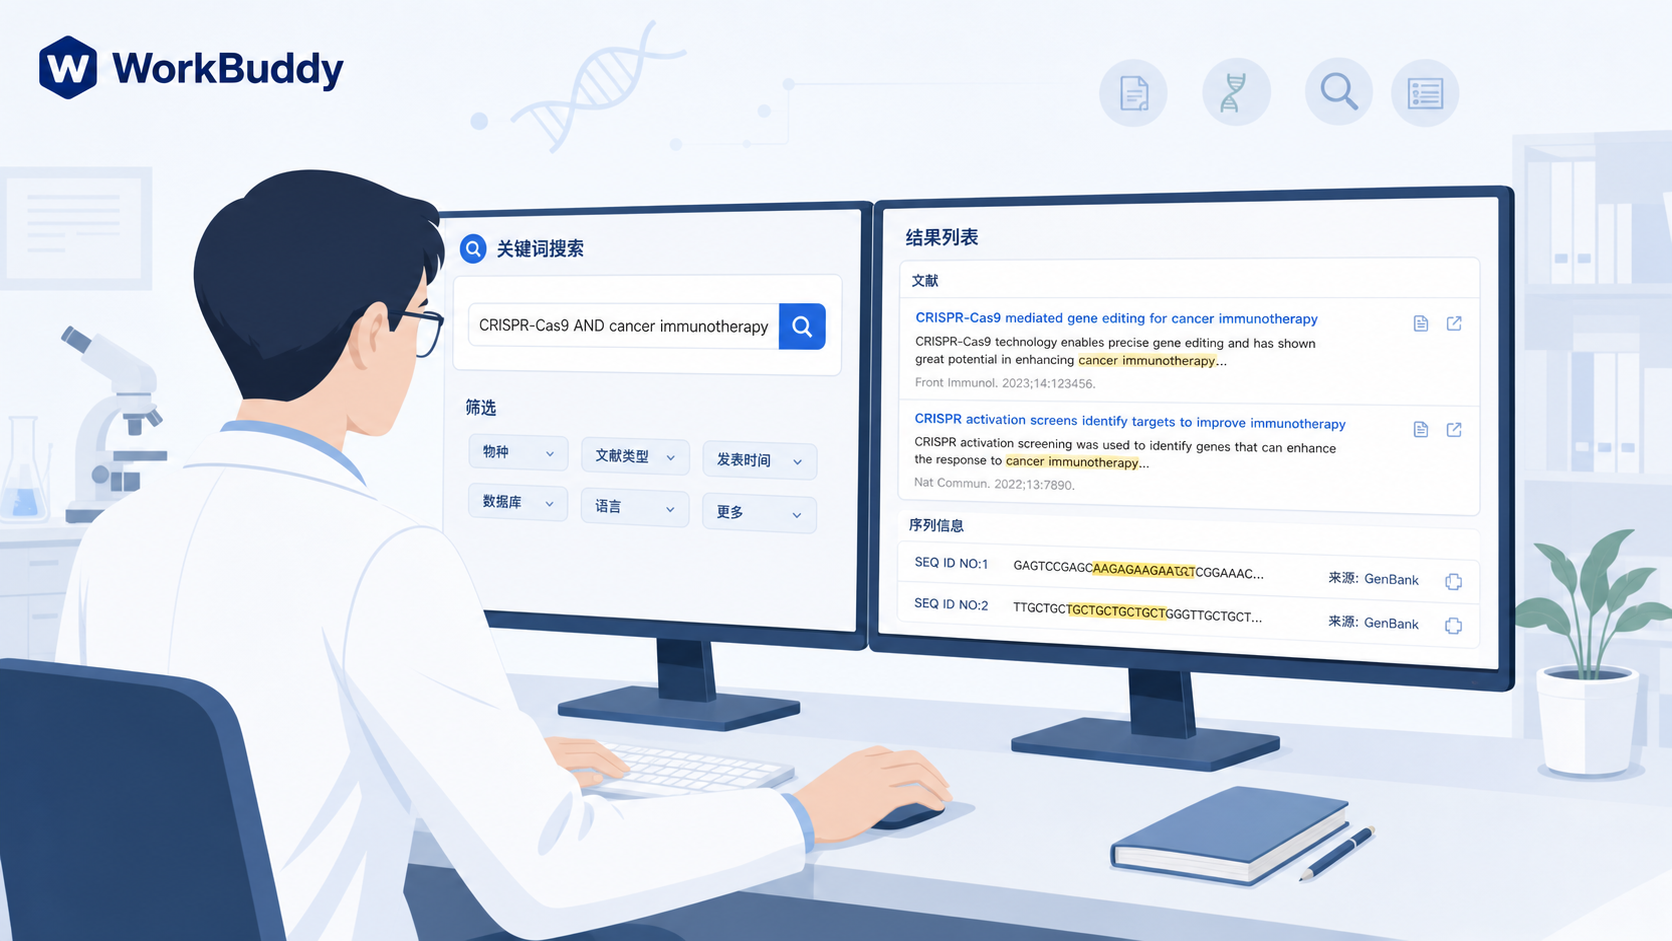
1. WorkBuddy 的基序搜索,解决什么问题
1.1 基序搜索不是“多一个检索框”这么简单
在转录调控、蛋白结合位点、启动子分析、miRNA 靶点预测等场景中,研究者常常需要从大量文本和序列信息中找出固定模式。传统检索方式依赖人工组合关键词,效率低,而且容易漏掉同义表达和隐性关联。
基序搜索的核心价值,是把“模式识别”前置到检索阶段。 也就是说,你不必先读完大量文献再归纳规律,而是可以先用工具缩小范围,再进入验证。
1.2 适合哪些医学科研场景
基序搜索在以下方向尤其有用:
- 转录因子结合位点筛查。
- 启动子区域功能研究。
- RNA 结合蛋白识别。
- miRNA seed 区相关分析。
- 蛋白结构域或保守片段的线索整理。
对于医学生、医生和科研人员来说,这类场景的共同特点是:信息碎片多,模式重要,人工筛选慢。 WorkBuddy 的价值就在于把这些碎片化信息快速结构化。
1.3 从“找文献”到“找规律”
上游知识库显示,WorkBuddy 安装后,左侧栏会出现专家、技能等模块。用户新建任务后,可以直接进入深度研究流程,系统会默认执行联网检索和工具调用。这意味着它不是单纯的搜索引擎,而是带任务执行能力的科研辅助工具。
与传统检索相比,这类工具更适合做“主题聚焦”和“模式发现”。这对需要快速形成课题框架的人非常重要。
2. 基序搜索如何嵌入WorkBuddy的工作流
2.1 先建任务,再让系统自动推进
根据知识库内容,WorkBuddy 的典型操作路径是:先点击新建任务,再选择深度研究。系统会调用互联网搜索,并在技能框架下执行分析。对于基序搜索而言,这种流程的优势在于,它能把检索、筛选、总结放进同一条链路里。
你需要做的不是反复切换平台,而是把问题定义清楚。 例如:
- 研究对象。
- 目标模式。
- 时间范围。
- 文献类型。
- 是否偏向综述或原始研究。
这样得到的结果更稳定,也更适合后续写作。
2.2 Skills 让检索更接近“任务式研究”
课程内容提到,WorkBuddy 的技能系统可以帮助它总结综述、论著等不同类型信息。虽然当前知识库里并没有把“基序搜索”展开成完整的独立模块,但从其任务式检索逻辑看,它本质上已经支持面向科研问题的分步处理。
这对科研用户很关键。因为基序相关研究常常不是单一关键词命中,而是多个信息维度同时满足,包括:
- 目标分子名称。
- 基序或 motif 相关描述。
- 组织或疾病背景。
- 研究类型。
- 发表时间。
任务式工作流可以显著降低漏检率。
2.3 联网检索与模型能力的组合
知识库还提到,WorkBuddy 可以接入腾讯提供的模型,也可以配置用户自己的 API key。其默认模型中包含 DeepSeek V4 Pro 和 V4 Fresh,实际测评中 V4 Fresh 已足够完成一般任务,复杂任务可切换 Pro。
这说明基序搜索并不是孤立功能,而是建立在“检索能力 + 模型理解能力”之上的。 这类组合的意义在于,它不仅能找到信息,还能初步判断信息是否与研究问题真正相关。
3. 用基序搜索做科研,关键看什么
3.1 关键词要够精确
课程中明确提到,文献检索要尽可能增加关键词,中文英文都可以识别,关键词之间可用空格隔开。这个原则同样适用于基序搜索。
如果你研究的是某个转录因子相关 motif,建议至少包含:
- 转录因子名称。
- 基序名称或核心序列描述。
- 疾病或组织名称。
- 研究对象,例如 DNA、RNA 或蛋白。
- 场景限定,例如 promoter、binding site、motif prediction。
关键词越接近你的真实研究问题,结果越可用。
3.2 学会设置范围,避免结果发散
知识库里提到,检索可以通过影响因子、文献类型、发布时间等条件缩小范围。对于基序搜索,这一点尤为重要。因为同一基序可能存在不同命名方式,也可能在不同物种和疾病背景下被重复讨论。
建议优先设置:
- 时间范围。
- 文献类型。
- 物种范围。
- 疾病范围。
- 期刊质量阈值。
这样更容易得到可直接用于综述或课题设计的结果。
3.3 结果要二次判断,不要直接照搬
任何自动化检索都不能替代人工判断。 基序搜索尤其如此。原因很简单:很多文章标题或摘要会提到 motif,但真正的数据支持程度并不一致。研究者仍需要检查:
- 是否有实验验证。
- 是否只是预测结果。
- 是否存在样本量过小。
- 是否与已有机制冲突。
- 是否可迁移到你的研究对象。
这一步决定了工具是“辅助”还是“误导”。
4. 为什么WorkBuddy适合医学科研人群
4.1 对医学生,降低入门门槛
医学生做科研,最大问题通常不是“不会做”,而是“不知道从哪开始”。WorkBuddy 的价值在于,它把复杂的信息整理成任务式流程,减少反复试错。
对于基序搜索这种偏生信和机制方向的任务,它能帮助学生更快理解研究框架。 先看问题怎么被组织,再看结果如何呈现,比单纯刷文献更高效。
4.2 对临床医生,加快选题速度
临床医生时间有限,最需要的是“快速找到可研究的问题”。基序相关课题常与肿瘤、炎症、免疫调控、耐药机制等方向相连。借助 WorkBuddy,医生可以更快筛出与临床问题相关的候选机制,再交给团队做实验验证。
4.3 对科研人员,提高重复劳动的自动化程度
科研人员最怕重复劳动。比如反复整理文献、分类、初步总结。知识库显示,WorkBuddy 的深度研究会调用技能执行分析。这类自动化最直接的收益,就是节省前期 30% 到 50% 的整理时间。
具体节省幅度取决于问题复杂度,但“减少人工筛查时间”是确定的。
5. 实际使用时,建议这样做
5.1 先明确研究问题
不要直接输入一个泛关键词。最好先把问题写完整,例如:
- 某基因是否存在特定 motif 相关调控。
- 某疾病中是否报道过保守基序。
- 某通路是否涉及特定结合位点变化。
问题越具体,返回结果越有价值。
5.2 用分层检索替代一次性搜索
可以先做广检索,再逐步收窄:
- 先找总览性文献。
- 再找近三年高质量研究。
- 最后筛实验验证文章。
- 把高频基序或核心序列单独整理。
这种方法适合综述、开题和课题设计。
5.3 把检索结果转成可写作材料
课程里提到,仙桃工具还提供写作工具和例句检索。对医学科研来说,这意味着检索完成后,可以直接进入写作阶段。从文献检索到表达输出的链路越短,论文推进速度越快。
如果你需要把基序搜索结果整理成摘要、引言或讨论,这类工具能显著减少中间转换成本。
总结Conclusion
WorkBuddy 的基序搜索,本质上不是单点功能,而是科研任务流中的一个高效入口。它的价值在于帮助研究者更快定位模式、缩小范围、组织信息,并把检索结果转化为可写作、可验证的科研线索。对于医学生、医生和科研人员来说,这类工具最重要的意义,是把“找资料”变成“找规律”。
如果你希望更高效地完成医学科研中的检索、筛选和初步分析,可以进一步了解 解螺旋 的相关工具和方案,让基序搜索真正服务于课题设计、论文写作和机制探索。

- 引言Introduction
- 1. WorkBuddy 的基序搜索,解决什么问题
- 2. 基序搜索如何嵌入WorkBuddy的工作流
- 3. 用基序搜索做科研,关键看什么
- 4. 为什么WorkBuddy适合医学科研人群
- 5. 实际使用时,建议这样做
- 总结Conclusion