19
 分享
引言Introduction
生物医学序列相似性分析,常卡在三件事。数据多、流程长、结果难复现。对医学生、医生和科研人员来说,单靠手工整理很容易错过关键命中,甚至影响后续注释和机制判断。WorkBuddy把比对、筛选、总结与流程化分析放进一个工作站,正在改变这一套旧方法。 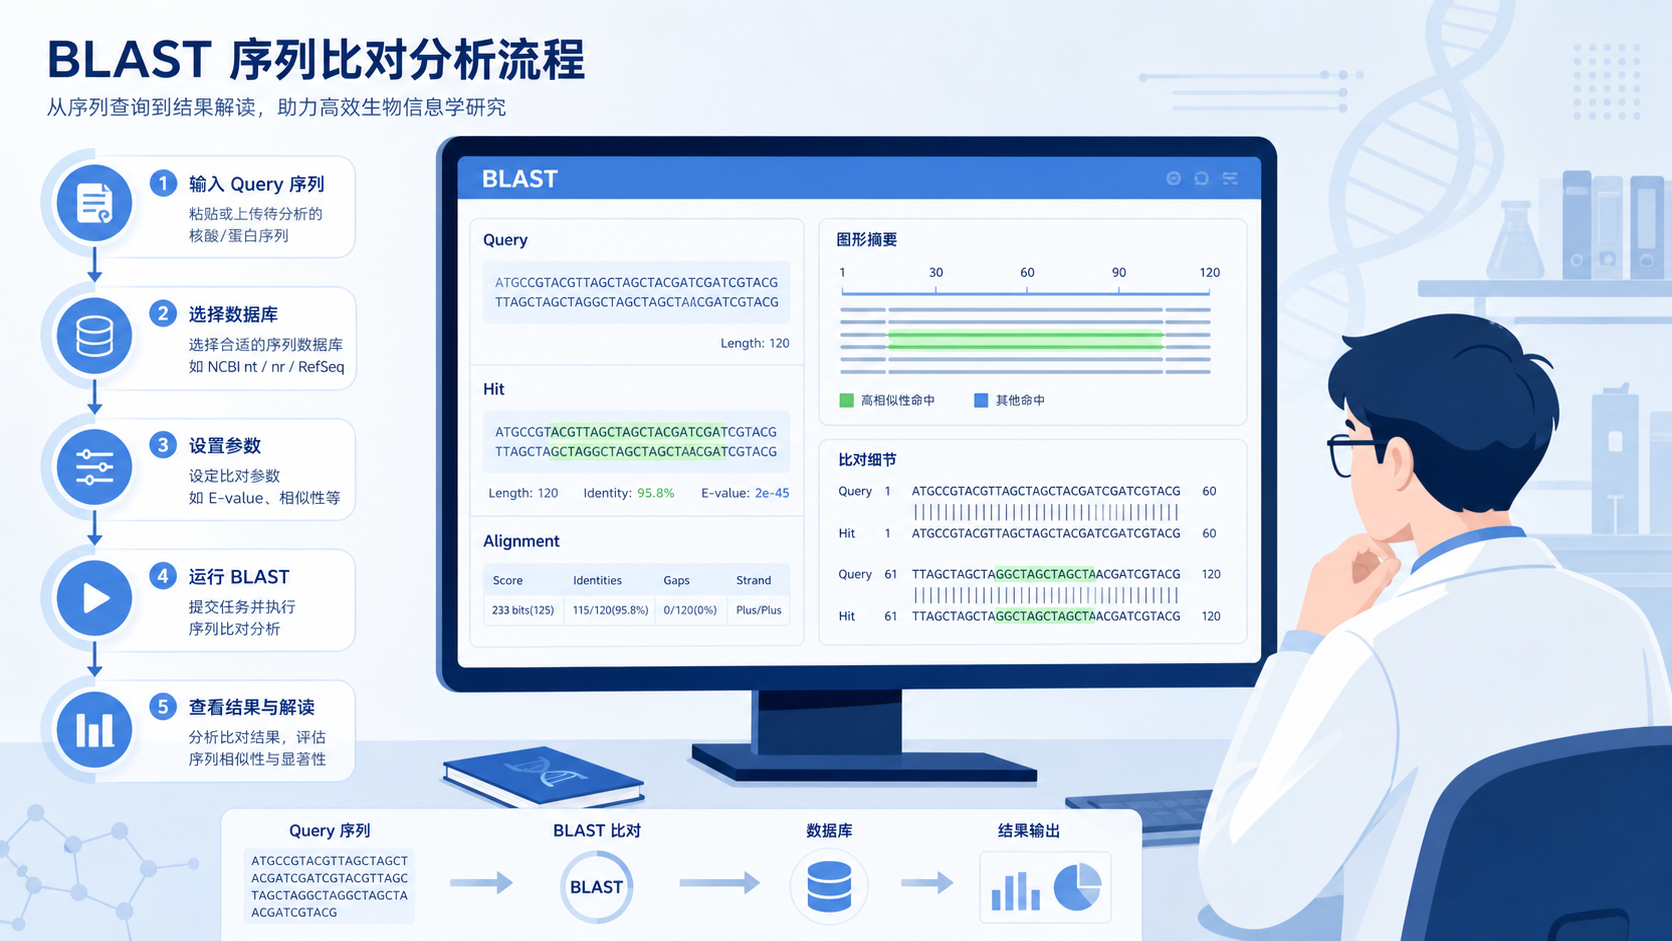
1.WorkBuddy为什么适合做序列相似性分析
1.1 从“单次比对”走向“流程化分析”
传统序列相似性分析,往往只完成一次比对。真正麻烦的是后面。你还要筛选物种,判断覆盖范围,比较E值和得分,再把结果整理成可用结论。这个过程对新手尤其耗时。
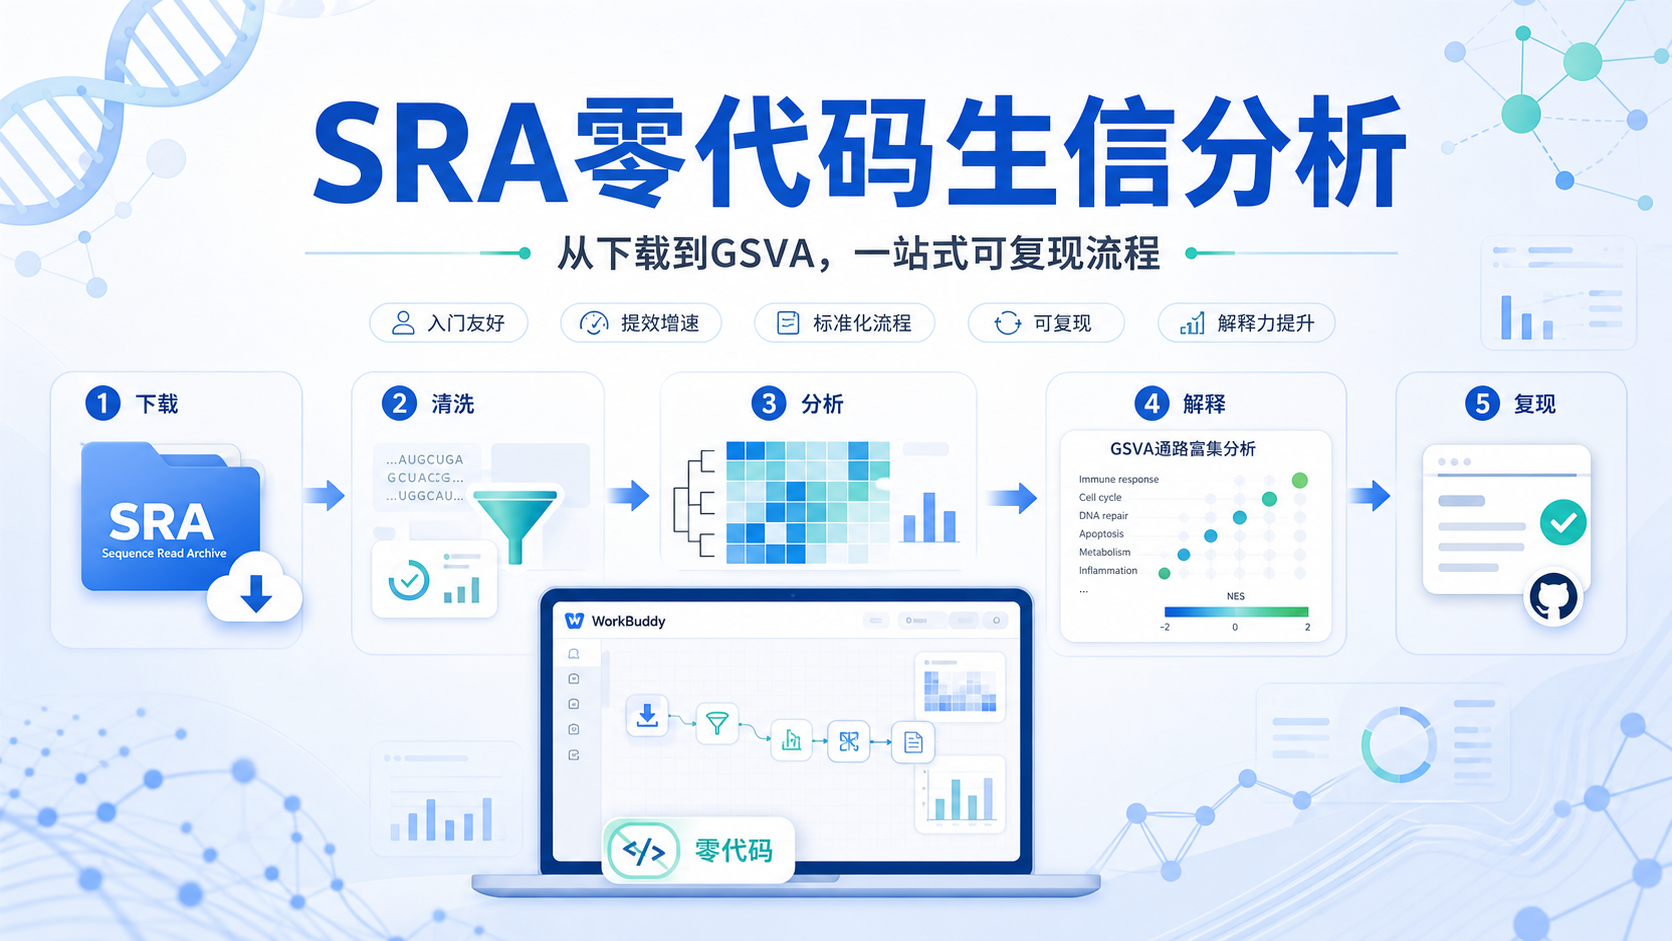
WorkBuddy的价值,不只是跑出结果,而是把分析链条串起来。 根据现有功能,WorkBuddy工作站里已经有文献计量学等自动化模块,面向生命科学和生物医学场景,也在持续扩展AI自动化能力。对于需要处理复杂分析流程的人,这意味着可以先用现成工作站,再等待更细分的skill上线。
1.2 为什么序列相似性分析需要自动化
序列相似性分析不是看一个分数就结束。尤其是BLAST这类区段比对工具,输出的是hit片段。也就是说,不能只看“像不像”,还要看“像哪一段”“覆盖了多少”“可信度是否足够高”。
这也是很多研究生和初入组课题人员常见的痛点。
他们能看到结果,却不一定能快速判断:
- 命中的片段是否覆盖关键功能区。
- E值是否足够低。
- 同一性与相似性是否被正确理解。
- 结果是否能直接进入下一步注释或研究设计。
WorkBuddy的优势,在于它更适合把这些步骤整合到一个连续流程里。
2.序列相似性分析的核心,不只是“匹配到了”
2.1 先理解BLAST输出的本质
BLAST是区段比对工具。它输出的是局部相似片段,也就是hit。这意味着两个序列即使整体不完全一致,只要关键区域相似,也可能具有重要生物学意义。
因此,分析时至少要看三层信息:
- 命中片段的得分和E值。
- 命中是否覆盖查询序列的重要区域。
- 命中物种和注释是否支持你的研究假设。
如果只看列表中最前面的条目,而不看覆盖范围,就可能误判。
2.2 如何区分Identities、Positives和覆盖率
在蛋白序列比对中,Identities表示完全匹配,Positives表示相似性。这两个指标在蛋白分析里不能混用。 因为蛋白比对使用替换矩阵,完全相同和理化性质相近并不是一回事。
还要特别关注查询覆盖率。
例如,一条序列只在20%的区域高度相似,和一条覆盖80%以上区域的相似,研究意义完全不同。前者可能只是保守结构域相同,后者才更接近整体同源关系。
2.3 看懂结果,才能进入下一步研究
对于医学生和科研人员,序列相似性分析通常不是终点,而是起点。后续可能接着做:
- 保守结构域判断。
- 家族归类。
- 功能注释。
- 进化关系推断。
- 候选靶点筛选。
如果第一步结果不稳,后面的实验设计就容易偏。 这也是为什么流程自动化越来越重要。
3.WorkBuddy在序列相似性分析中的实际价值
3.1 把“查结果”变成“做研究”
从上游知识库的信息看,WorkBuddy的思路不是简单替代工具,而是把论文、分析套路和研究方案连接起来。对于序列相似性分析,这一点很关键。
因为很多人真正缺的,不是一个比对按钮,而是:
- 如何组织输入。
- 如何筛选可信结果。
- 如何把结果转成研究假设。
- 如何把分析继续推进到方案层面。
WorkBuddy更像是一个面向科研流程的工作站,而不是孤立的查询工具。
3.2 对不同层级用户都更友好
新手常常卡在“结果很多,不知道怎么选”。高手则更在意效率和批量处理。WorkBuddy的价值就在于两头都能覆盖。
对新手,重点是降低学习成本。
对熟练用户,重点是减少重复劳动。
对课题组来说,重点是让分析逻辑更统一,减少不同成员之间的解释偏差。
这类能力在生物医学场景里很实用。尤其当你面对的是大量序列、多个样本,或者需要跨数据库验证时,流程化工具能明显降低沟通成本。
3.3 现阶段可用的工作站,已经足够解决一部分问题
根据现有信息,WorkBuddy的长分析流程自动化能力还在持续完善中,部分更细分的skill也在开发中。但对大多数科研场景来说,现阶段先用工作站,已经能覆盖很多实际需求。
这意味着,你不必等到所有功能都完整上线,才开始优化自己的分析流程。
如果你现在就有文献计量学、序列分析、研究方案梳理这类需求,可以先用现有模块搭建工作流。
4.从序列比对到研究设计,真正的难点在哪里
4.1 难点不是“能不能跑”,而是“能不能解释”
很多人把序列相似性分析当成技术活。其实更难的是解释。
比如,某条蛋白序列和一个超家族相似。下一步要判断的是:
- 它是不是同一家族成员。
- 是否保留关键结构域。
- 是否具备相同或部分相同功能。
- 能否支持某个疾病相关假说。
没有解释框架,结果只能停留在“像”这个层面。
4.2 复杂流程需要标准化
对于课题组来说,最怕的是每个人各做各的。
一个人用默认参数,一个人手动改过滤条件,一个人只看最高命中。最后汇总时,结论口径不一致。
这时候,标准化流程特别重要。比如:
- 统一比对程序选择。
- 统一阈值和过滤逻辑。
- 统一命中覆盖判断标准。
- 统一结果记录格式。
WorkBuddy这种工作站式思路,正适合把这些动作标准化,减少人为波动。
4.3 对医学科研而言,效率直接影响产出
医学科研节奏快。
从靶点筛选到机制验证,再到文章写作,时间窗口很紧。序列相似性分析如果耗时过长,就会拖慢整个项目。
能把“分析”前移,把“整理”自动化,就等于给后续实验留出更多时间。 这也是AI科研工具真正被需要的地方。
5.如何用解螺旋把序列相似性分析做得更高效
5.1 更适合科研场景的一体化支持
如果你正在做生物医学序列相似性分析,最需要的不是零散工具,而是稳定、可复用、可继续扩展的工作流。解螺旋的价值,就在于把AI自动化能力放进科研真实场景。
对于当前还没有完全开放的细分skill,可以先用工作站完成核心流程。等后续功能上线,再把已有流程继续升级。这样不会让项目停在等待中。
5.2 让结果更容易进入后续环节
真正好的工具,不只是输出比对结果。它还要帮助你把结果转成下一步动作。比如:
- 从命中结果提炼分析路线。
- 从比对信息生成研究思路。
- 从序列相似性延伸到功能假设。
- 从初筛结果进入实验设计。
这正是解螺旋想解决的痛点。 让复杂分析不再只是“看懂”,而是“能继续做下去”。
总结Conclusion
生物医学序列相似性分析,难点不在于是否能比对,而在于如何高效解读、筛选和延伸。WorkBuddy的意义,是把比对从单点工具变成可执行的科研流程。对于医学生、医生和科研人员来说,这种范式更接近真实需求,也更有利于后续研究推进。
如果你也在做序列比对、家族注释或功能推断,可以先用解螺旋的工作站搭建你的分析流程。 当工具从“能跑”进化到“能串起来”,科研效率会明显提升。

- 引言Introduction
- 1.WorkBuddy为什么适合做序列相似性分析
- 2.序列相似性分析的核心,不只是“匹配到了”
- 3.WorkBuddy在序列相似性分析中的实际价值
- 4.从序列比对到研究设计,真正的难点在哪里
- 5.如何用解螺旋把序列相似性分析做得更高效
- 总结Conclusion