52
 分享
引言Introduction
Meta分析不是“把文献堆起来”。真正决定质量的,往往是数据提取是否规范,统计是否匹配,写作是否符合PRISMA。很多研究者卡在中间环节,前期筛得很辛苦,后面却因为提取错误或报告不完整被退稿。如果你想把一篇Meta分析做得可复现、可发表,必须先把六步流程走稳。 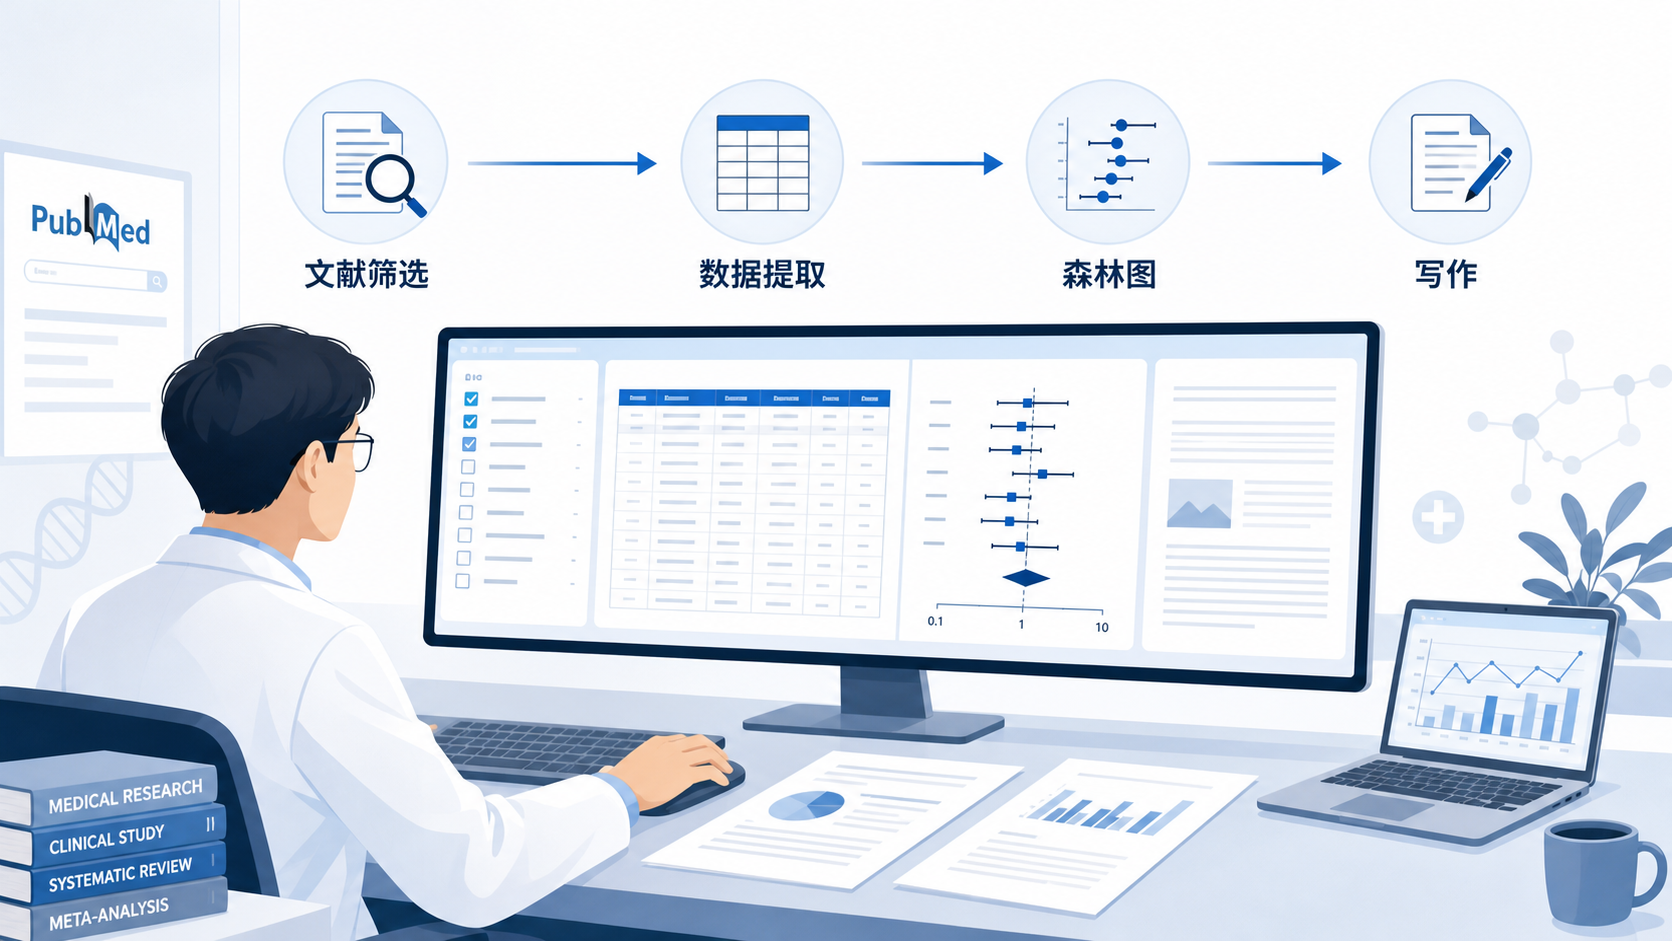
1. 先把六步流程建立成工作框架
1.1 六步不是形式,是质量控制链
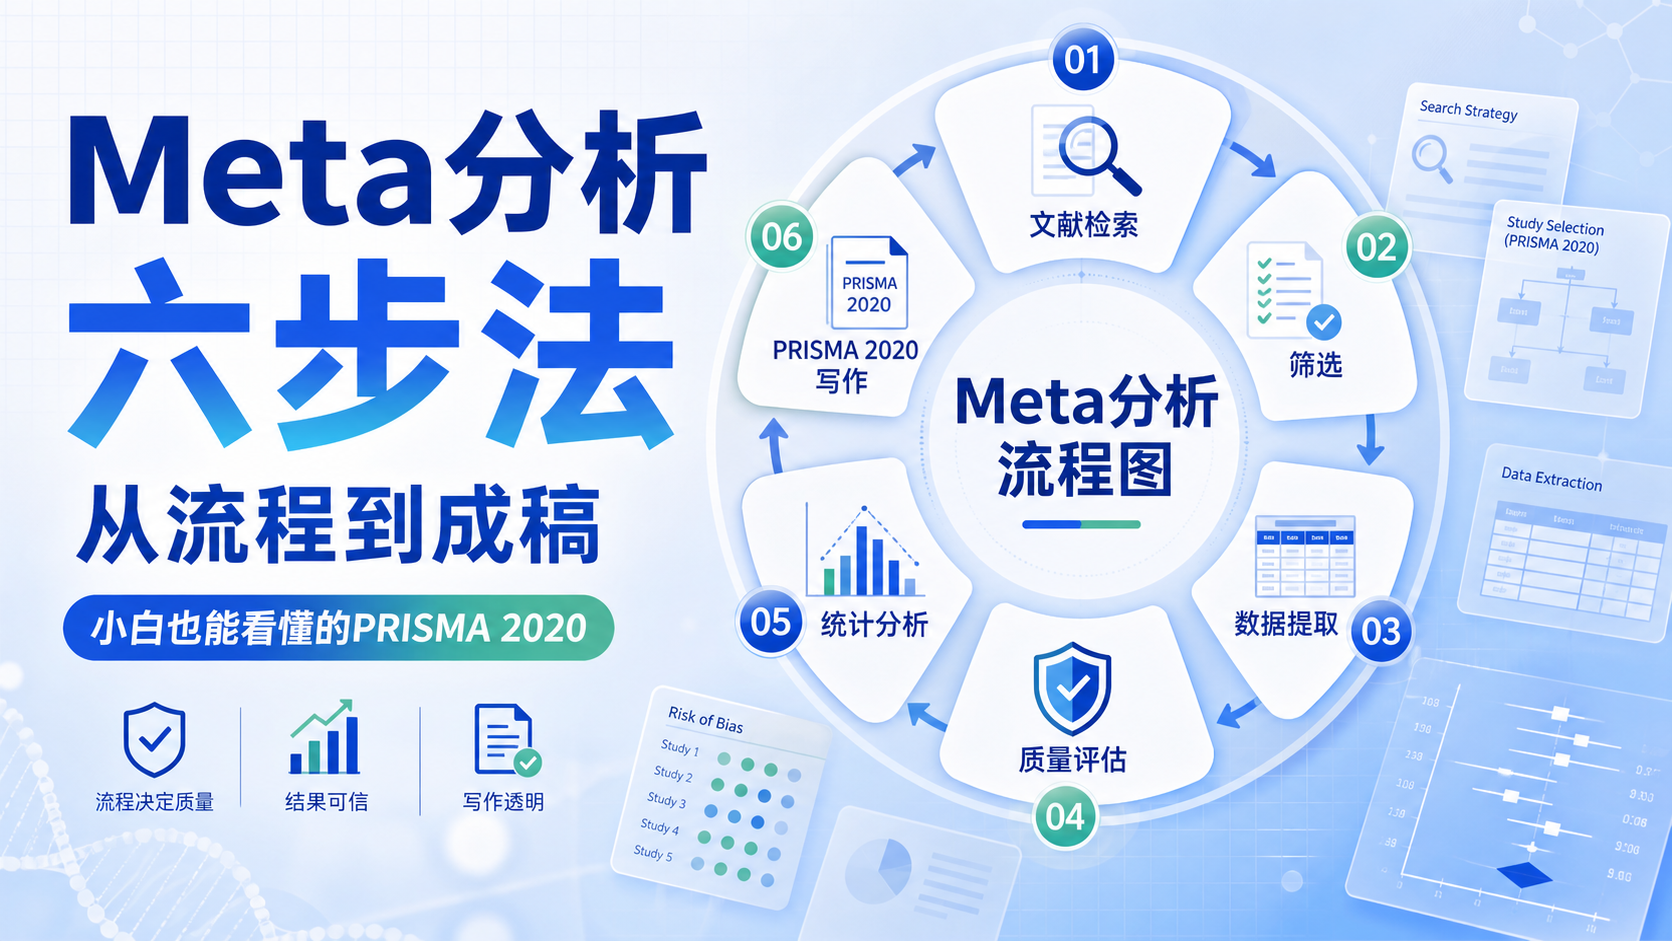
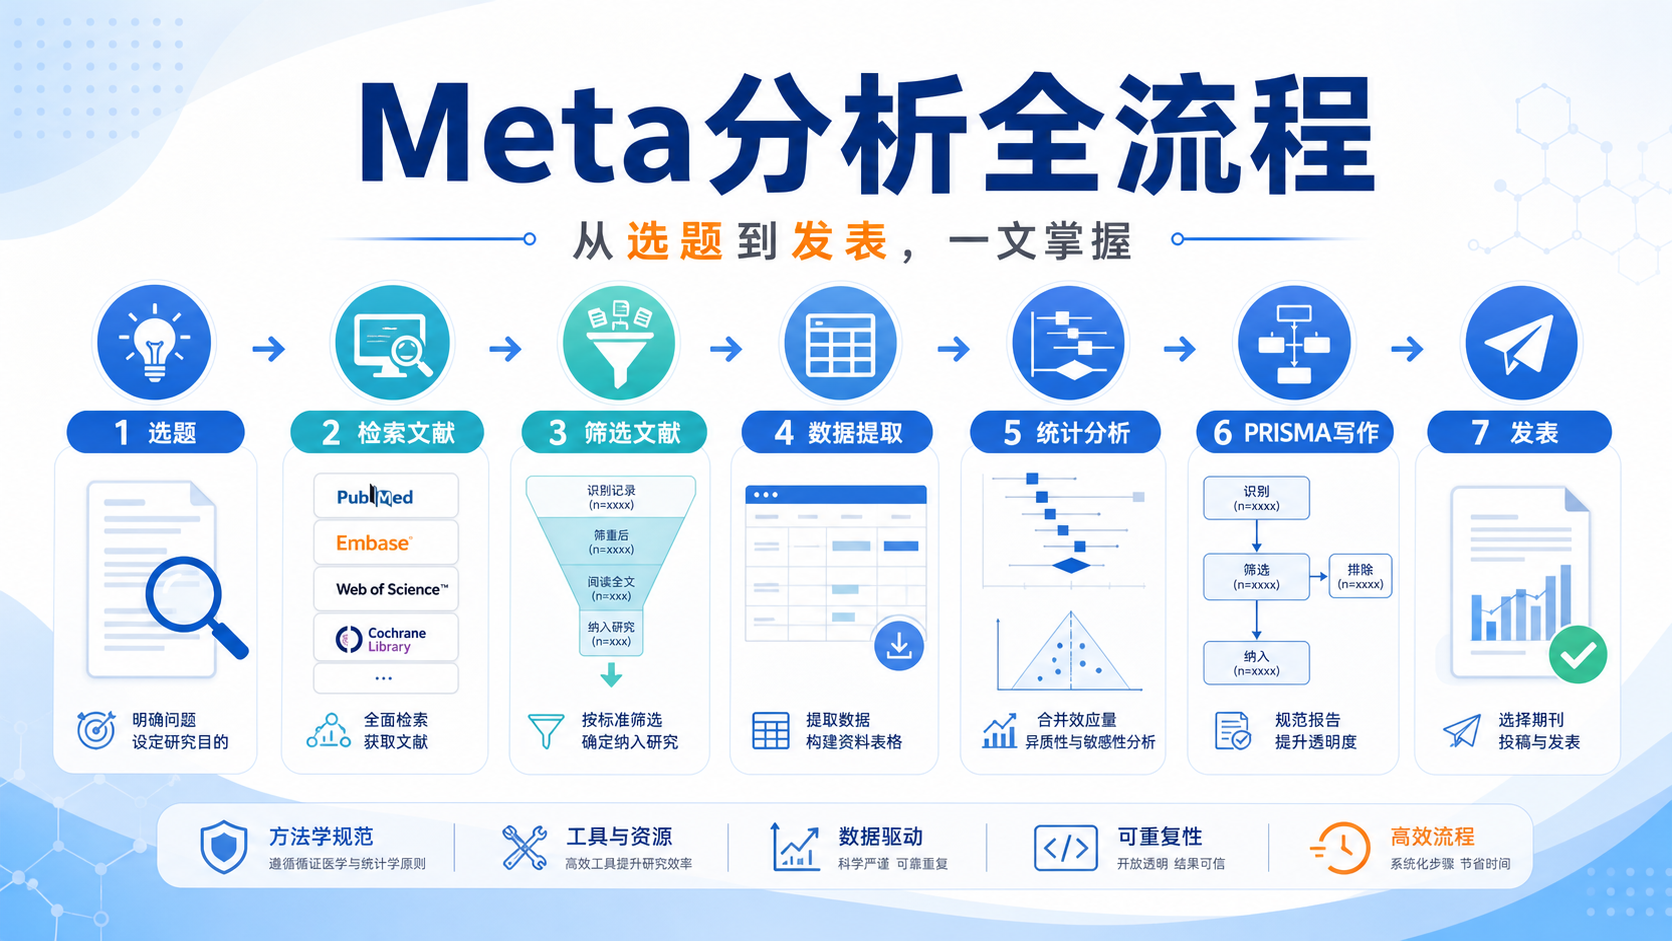
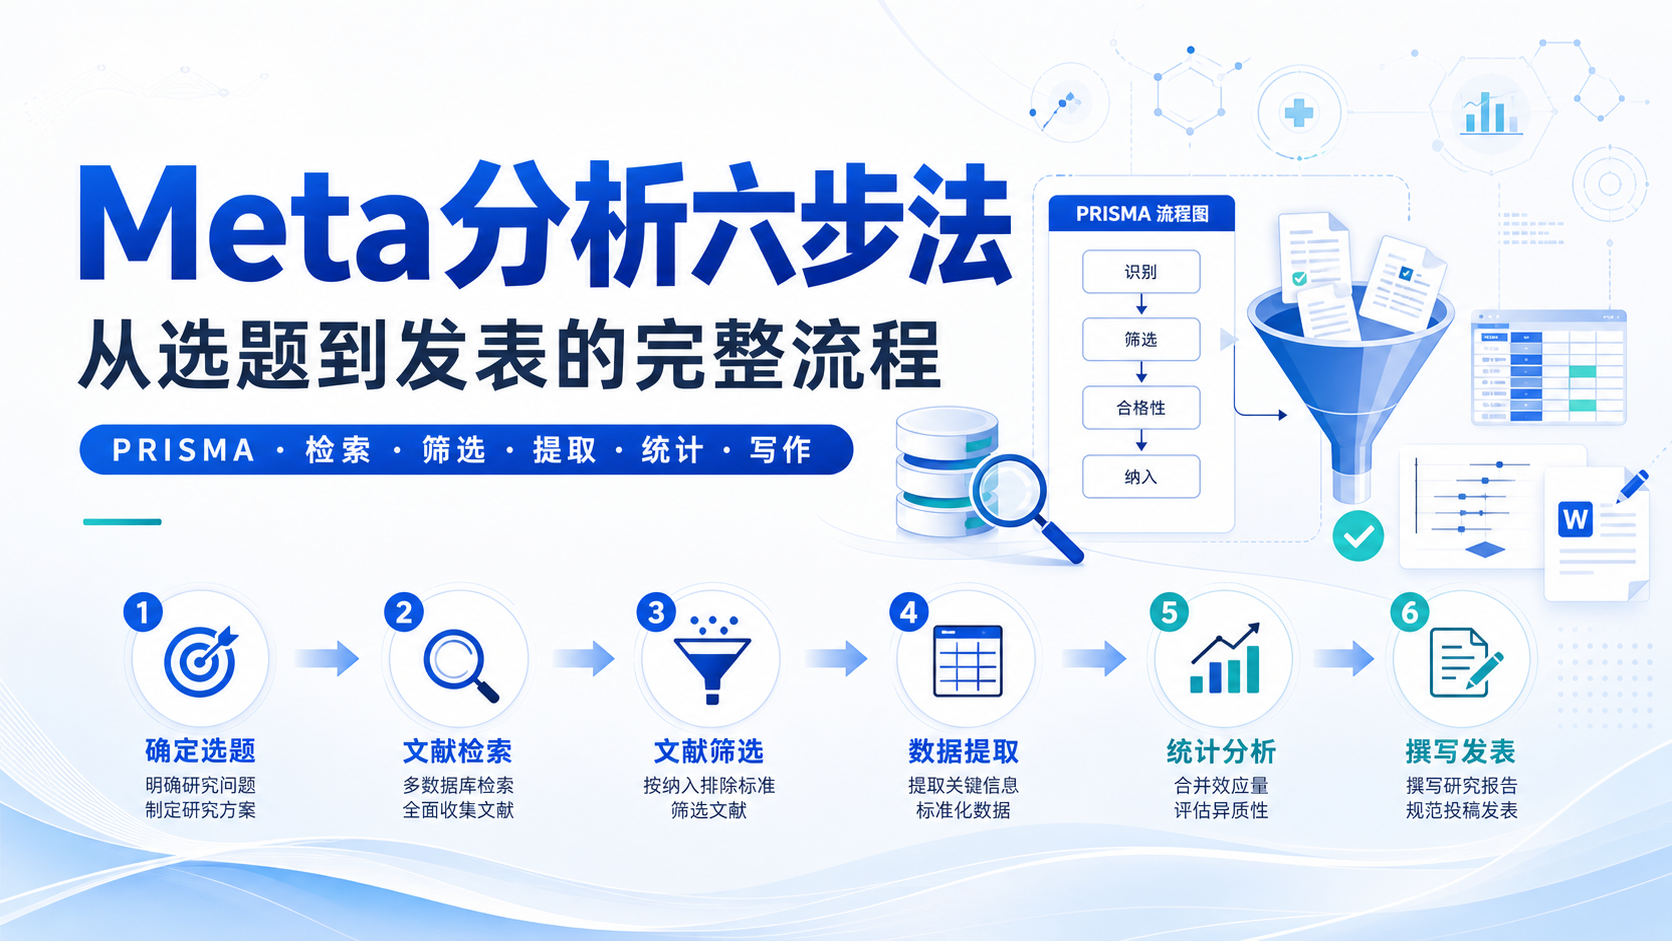
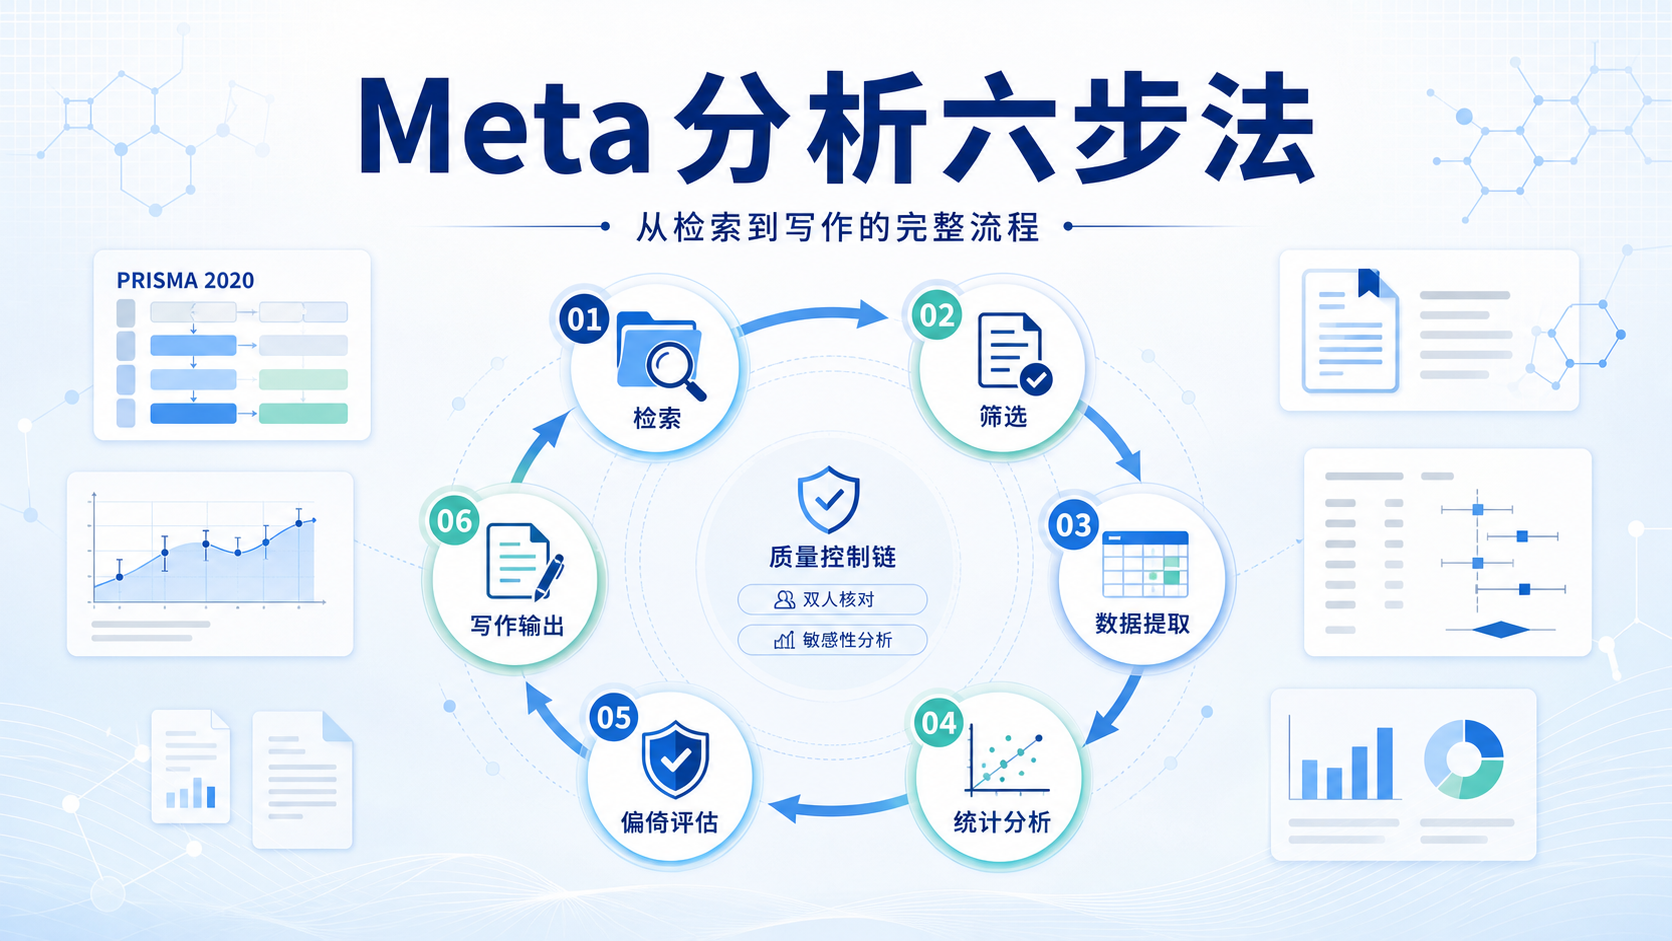
Meta分析的核心流程可以概括为六步。
第一步确定选题。第二步文献检索。第三步论文筛选。第四步数据提取。第五步统计分析。第六步写文章。
这六步不是孤立动作,而是一条连续的质量控制链。 前一步做得不规范,后一步再努力也难以补救。
选题通常来自两类来源。
一类是临床问题。另一类是文献触发。
例如某个干预在不同研究中结果不一致,就值得进一步做Meta分析。反过来,如果一个问题已经有明确结论,继续重复做,意义不大。
1.2 先聚焦,再放开,检索效率更高
文献检索不是越多越好。
检索策略和检索式会直接影响结果范围。
一开始建议先聚焦,围绕核心概念设置关键词和主题词。确认方向后,再逐步放开范围,避免噪音过多。
常见数据库应尽量覆盖到位。
英文文献至少要考虑PubMed、WOS、Cochrane。
如果课题涉及中文研究,也应补充中文数据库。
数据库覆盖不全,会直接影响纳入研究的完整性。
1.3 筛选和提取要保留痕迹
筛选阶段建议两人独立完成。
初筛和精筛都要记录理由。
出现争议时,再由第三方判定。
这样做的目的,不只是提高一致性,更是为了保证流程可追溯。
数据提取也一样。
不要只看摘要。
必须阅读全文后再提取outcomes、基线特征和关键信息。
双人提取、交叉核对,是减少录入错误最有效的方法。
2. 文献检索与筛选,决定后续能否提取到有效数据
2.1 检索式要围绕研究问题构建
检索式不是拼关键词。
它需要对应研究设计、干预措施、结局指标和人群特征。
如果检索式过宽,容易得到大量无关文献。
如果过窄,又可能漏掉关键研究。
实操上可以先搭建基础框架,再逐层扩展。
例如先用核心主题词锁定主问题,再补充同义词、缩写和MeSH词。
检索的目标不是“多”,而是“准”。
2.2 筛选时要坚持统一标准
纳入和排除标准必须在前期写清楚。
常见维度包括研究对象、干预措施、对照组、随访时间和结局指标。
如果标准不统一,后续提取的数据就无法比较。
筛选一般分两轮。
第一轮看标题和摘要,排除明显不符的文献。
第二轮看全文,确认是否真正满足纳入条件。
只有进入全文阶段,才能判断研究是否具备可提取的数据。
2.3 保留排除原因,方便写作和回应审稿
很多人写PRISMA流程图时才发现,前面没有记录排除原因。
这会让整篇文章显得不够规范。
因此,筛选时建议同步建立排除日志。
常见排除原因包括:
- 研究类型不符。
- 没有目标结局。
- 数据无法提取。
- 重复发表。
- 样本不符合纳入标准。
这些记录不仅用于流程图,也用于后续回应审稿意见。
3. 数据提取是Meta分析的核心,错误最容易发生在这里
3.1 提取前先建立标准表
数据提取前,最好先设计统一表格。
表格至少应包括作者、年份、国家、样本量、研究类型、干预措施、对照措施、结局指标、随访时间和统计量。
如果是连续性资料,还要提取均数和标准差。
如果是二分类资料,则要提取事件数和总例数。
表格越规范,后面的统计越顺。
没有固定模板时,最常见的问题就是漏项和重复录入。
3.2 只提全文里真正可用的数据
摘要里的信息往往不完整。
同一篇研究,摘要、正文、表格和补充材料里给出的数据可能不完全一致。
因此,提取时应以全文为准,并优先核对原始表格。
如果结局指标不统一,要先判断是否能转换。
如果单位不同,是否可以标准化处理。
如果同一研究有多个时间点,要提前规定提取规则。
这些问题不提前统一,后面就会引入选择偏倚。
3.3 双人提取和核对,能显著降低错误率
数据提取最忌讳单人完成后直接进入统计。
双人独立提取,可以明显减少漏提、错提和理解偏差。
如果发现差异,先回到原文核对,再决定最终版本。
建议对以下信息重点复核:
- 样本量。
- 结局指标方向。
- 干预组和对照组定义。
- 时间点。
- 统计量类型。
这一步做得细,后面森林图和异质性分析才有意义。
4. 统计分析要和数据类型匹配,不能混用
4.1 效应量选择取决于数据属性
Meta分析常见效应量并不固定。
连续性数据常用WMD或SMD。
二分类数据常用OR、RR。
生存资料常用HR。
选择原则很简单。
同一指标、同一单位,优先考虑WMD。
不同研究量纲不同,才考虑SMD。
如果研究是病例对照设计,OR更常见。
队列研究多用RR。
涉及时间结局时,HR更合适。
4.2 异质性判断不能只看P值
统计分析不只是合并结果。
异质性、偏倚和稳健性都要一起看。
常用指标包括I²、森林图、漏斗图和偏倚评估图。
I²可以帮助判断研究间差异大小。
一般来说,I²越高,研究间一致性越差。
这时要考虑随机效应模型,或进一步做亚组分析。
如果不先判断异质性,直接合并,结果可信度会下降。
4.3 偏倚评估和证据分级不能省
偏倚评估是Meta分析的重要组成部分。
随机对照试验可看风险偏倚图,也就是常说的红绿灯图。
发表偏倚可结合漏斗图观察。
证据质量还可用GRADE进行分级。
这些步骤的意义在于告诉读者。
结果不是“算出来就完了”。
还要判断它是否稳定,是否能支持临床决策。
高质量的Meta分析,不只报告合并值,还报告证据强度。
5. 写作要按PRISMA 2020组织,不要只写结果
5.1 文章结构要服务于可复现
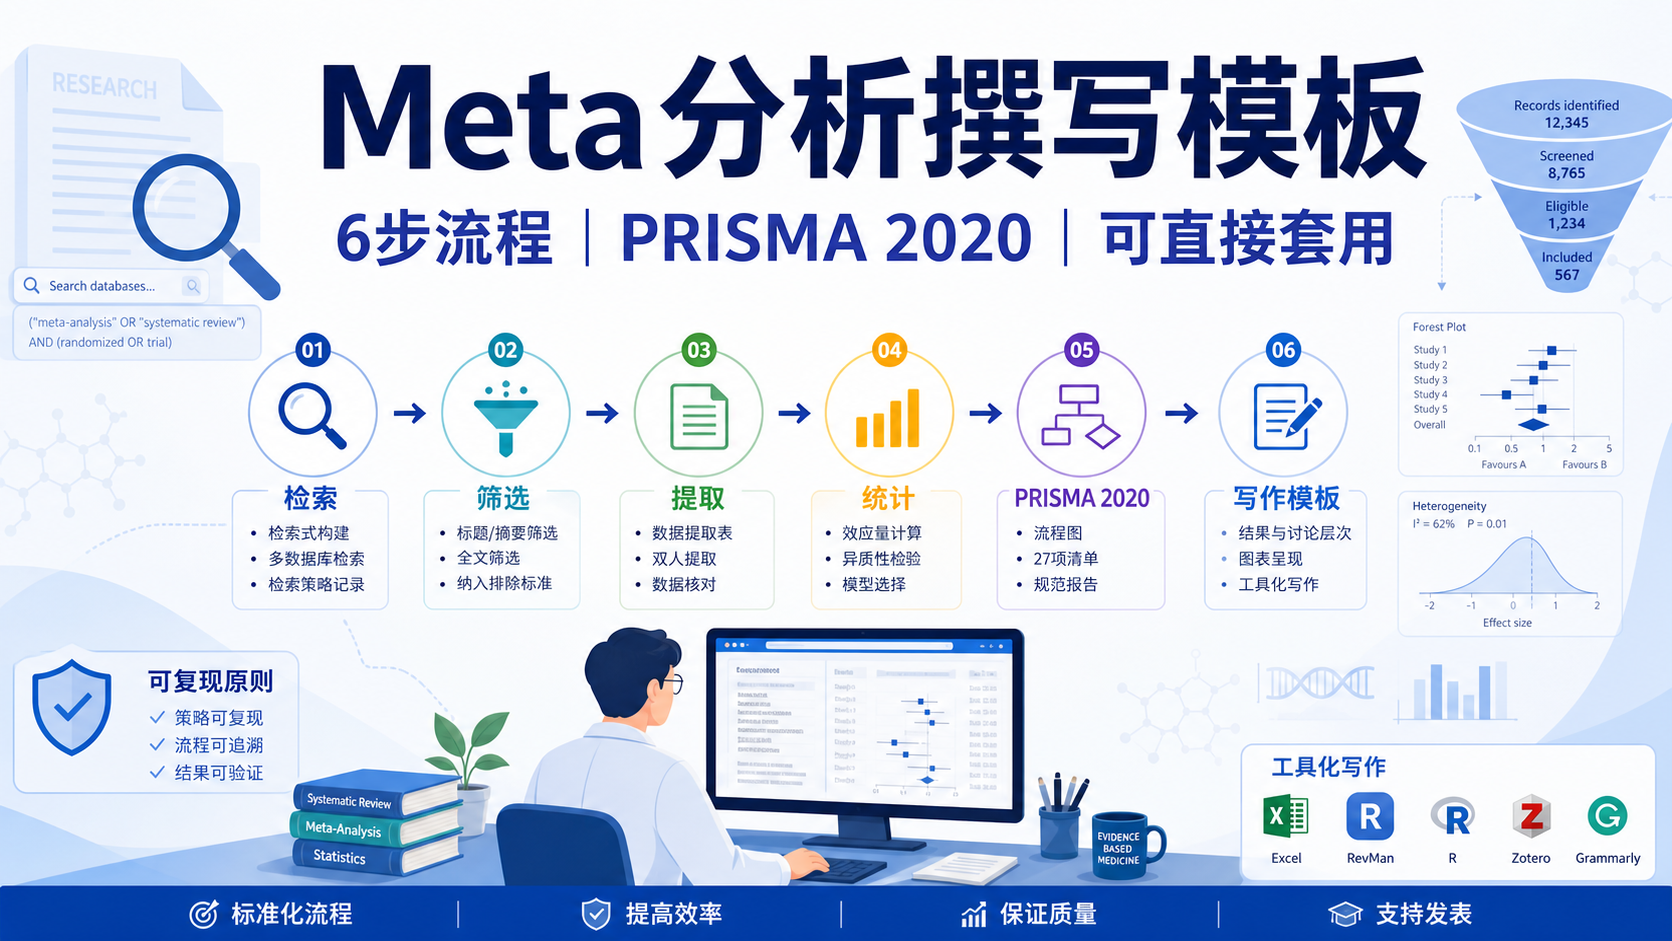
写作阶段要围绕PRISMA 2020的27条规范展开。
这不是形式要求,而是报告完整性的底线。
标题、摘要、方法、结果、讨论都要对应研究流程。
方法部分尤其重要。
要写清楚检索数据库、检索日期、筛选标准、数据提取方法、偏倚评估方法和统计策略。
方法写得越清楚,文章越容易被信任。
5.2 结果部分要让读者看懂你做了什么
结果部分不要只堆数字。
要按流程写。
先写检索结果和纳入研究数量。
再写研究特征。
然后写主要结局、异质性、敏感性分析和发表偏倚。
如果有亚组分析或敏感性分析,也要写明依据。
例如是否按干预类型、随访时间或人群特征分层。
结果的重点不是“有几个显著”,而是“证据是否一致”。
5.3 讨论部分要回答三个问题
讨论部分建议围绕三个问题展开。
第一,主要发现是什么。
第二,为什么会出现异质性。
第三,结果对临床或科研有什么意义。
同时要主动说明局限性。
比如纳入研究数量不足、样本量偏小、结局定义不一致、随访时间短等。
实事求是,远比过度拔高更符合E-E-A-T原则。
6. 把流程做成可执行方案,才能真正提升效率
6.1 从表格、软件到写作模板,一次性搭好
很多研究者不是不会做,而是每次都从零开始。
更高效的办法,是把流程标准化。
包括检索式模板、筛选记录表、提取表、统计输出表和写作提纲。
常用工具可以帮助提升效率。
RevMan、Stata、R包和专用Meta软件都能完成合并分析。
其中R包免费,适合有一定编程基础的人。
工具能提高效率,但前提是前面数据提取正确。
6.2 敏感性分析要预留时间
敏感性分析往往比漏斗图更耗时。
它可能需要反复排除单个研究,多轮比较结果变化。
如果一开始数据提取不稳定,后面会反复返工。
因此,建议在项目排期里预留足够时间给核对和复算。
尤其是多中心、长随访、多个结局指标的课题。
越复杂的Meta分析,越需要前置标准化。
6.3 用解螺旋提高从数据到写作的效率
如果你已经完成了文献筛选,却在数据提取、统计分析和写作衔接上反复卡住,可以借助更成熟的工具和方法体系。
解螺旋可以帮助你把Meta分析流程标准化,减少重复劳动,提升数据整理和写作效率。
无论是提取表设计、结果梳理,还是写作结构搭建,都更适合高频科研场景。
对于需要尽快产出、又要保证规范性的医学生、医生和科研人员来说,这是更稳妥的路径。
总结Conclusion
Meta分析从数据提取到写作,关键不在“做过多少”,而在“每一步是否规范”。
六步流程中,检索决定范围,筛选决定质量,数据提取决定准确性,统计决定可信度,写作决定可发表性。
只要把数据提取标准化,把PRISMA写作规范化,Meta分析就会从繁琐任务变成可复制流程。
如果你希望进一步提升Meta分析效率,减少返工,建议关注解螺旋,借助更专业的工具和支持,把研究真正做扎实。

- 引言Introduction
- 1. 先把六步流程建立成工作框架
- 2. 文献检索与筛选,决定后续能否提取到有效数据
- 3. 数据提取是Meta分析的核心,错误最容易发生在这里
- 4. 统计分析要和数据类型匹配,不能混用
- 5. 写作要按PRISMA 2020组织,不要只写结果
- 6. 把流程做成可执行方案,才能真正提升效率
- 总结Conclusion