47
 分享
引言Introduction
Meta分析最容易卡在三处,选题不准,文献筛不干净,写作不符合规范。结果就是反复返工,时间被大量消耗。如果你想把Meta分析做成一条清晰、可复现的流程,必须先把六步核心建立起来。
1. 先把选题定准
1.1 选题来自临床问题,也来自文献空白
Meta分析不是先找题目,再硬凑证据。更合理的路径是先看临床问题,再判断是否存在可合并的研究。
高质量选题通常有两个来源。
- 临床实践中的真实问题,比如某治疗是否优于标准方案。
- 文献触发,比如同一主题已有多个研究,但结论不一致。
如果题目过大,检索会产生大量噪音。
如果题目过窄,可能根本没有足够研究可纳入。
所以选题阶段的核心,是平衡“可发表性”和“可合并性”。
1.2 选题要先定义PICO
Meta分析题目最好先落到PICO框架。
- P,研究对象。
- I,干预措施。
- C,对照措施。
- O,结局指标。
把PICO写清楚,后面的检索式、筛选标准、数据提取都会更稳定。
如果PICO模糊,后续每一步都会漂移。
2. 检索决定了结果上限
2.1 检索策略比“搜得多”更重要
Meta分析检索不是越多越好,而是越准越好。检索式设计不合理,会直接影响结果范围和文献质量。
建议先聚焦,再逐步放开。
先围绕核心概念设置关键词和主题词,再根据检索结果调整同义词、近义词和截词方式。这样能减少早期噪音,避免一开始就被无关文献淹没。
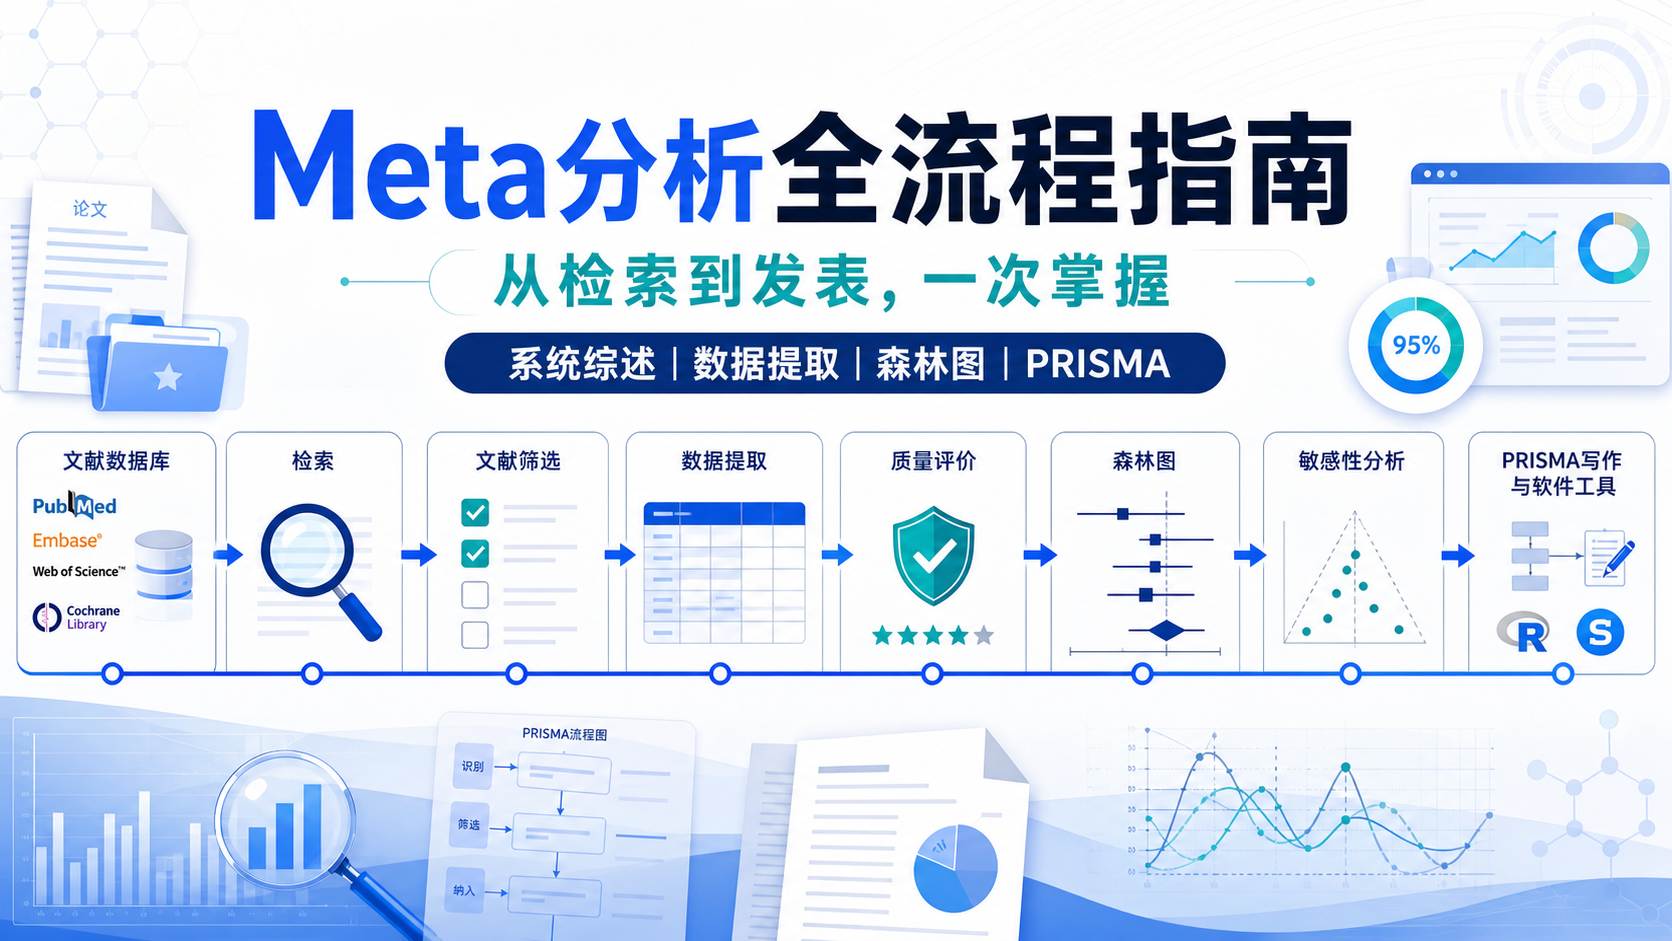
检索时通常应覆盖多个数据库,例如:
- PubMed
- WOS
- Cochrane
- Embase
- 视研究领域补充中文数据库
单一数据库检索,往往不足以支撑严格的系统评价或Meta分析。
2.2 检索过程要可复现
专业的Meta分析检索,不能只写“我们检索了相关数据库”。
更重要的是写清楚:
- 检索日期
- 数据库名称
- 完整检索式
- 限定条件
- 是否追溯参考文献
这不是形式主义。
这是保证研究可复现、可审稿、可追踪的基础。
对于医学生和科研人员来说,检索环节最常见的错误是:
- 关键词过少
- 仅用自然语言,不用主题词
- 不记录检索过程
- 只检索英文库,忽略补充库
3. 筛选要严格,过程要透明
3.1 初筛和精筛要分开做
文献筛选通常分为两步。
- 初筛,先看题目和摘要,排除明显不相关研究。
- 精筛,再阅读全文,判断是否真正符合纳入标准。
初筛解决“看起来不相关”的问题,精筛解决“真正能不能纳入”的问题。
这一步是Meta分析文献筛选写作中最容易出争议的部分。
常见排除原因包括:
- 研究对象不符
- 干预措施不符
- 结局指标不符
- 研究设计不符合要求
- 数据不足以提取
3.2 双人独立筛选是基本要求
筛选阶段建议由两名研究者独立完成,并记录每一步决策。
如果意见不一致,再由第三方裁定。
这样做的意义很明确:
- 降低主观偏倚
- 提高纳入一致性
- 便于后续写PRISMA流程图
没有筛选记录的Meta分析,通常很难通过高质量审稿。
3.3 PRISMA流程图要真实反映过程
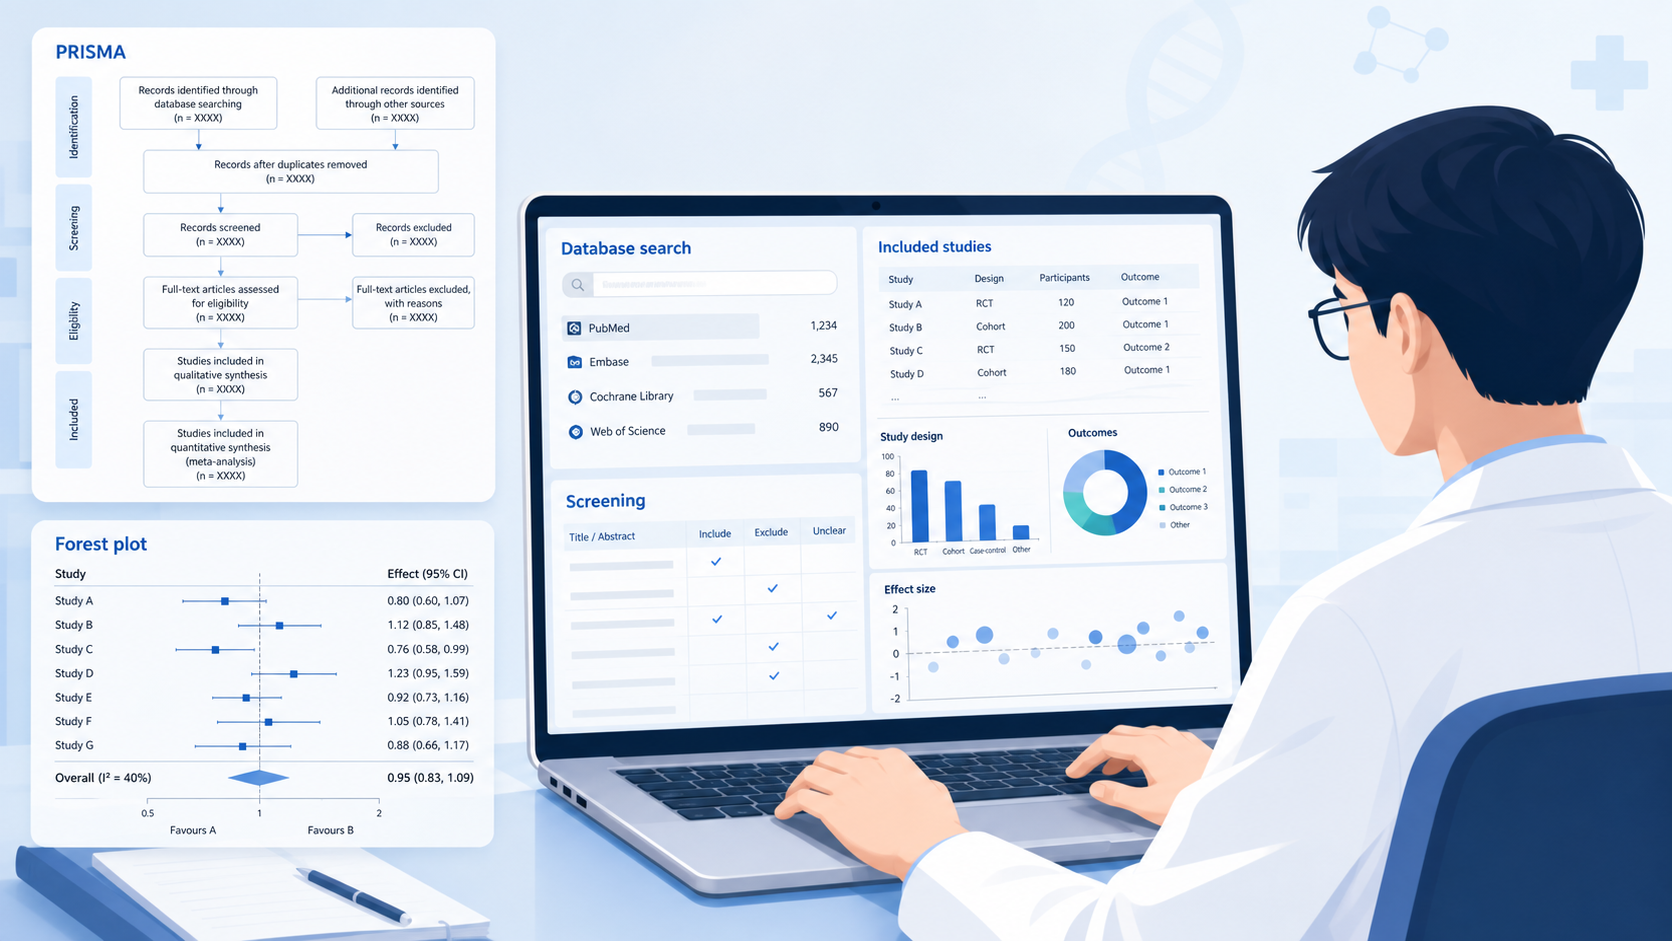
筛选结果最终会体现在PRISMA流程图里。
这个图不是装饰,而是全文证据链的一部分。
需要清楚展示:
- 检索到多少篇
- 去重后剩多少篇
- 初筛排除多少篇
- 全文评估后排除多少篇
- 最终纳入多少篇
流程图的每一个数字,都应与检索和筛选记录一致。
4. 数据提取决定分析质量
4.1 先提取全文,再提取结局
数据提取不能只看摘要。很多关键数据只在全文、表格或补充材料中。
通常要提取的信息包括:
- 基本研究特征
- 样本量
- 干预与对照方案
- 主要和次要结局
- 随访时间
- 统计指标
真正影响Meta结果的,是结局指标和数据口径是否统一。
例如同一临床问题,不同研究可能报告OR、RR、HR或均数差。提取前必须明确统计类型。
4.2 双人提取和核对能显著减少错误
数据提取建议双人独立完成,再交叉核对。
因为一个数字提错,最后森林图和结论都可能偏移。
常见问题有:
- 小数点错误
- 组别顺序颠倒
- 单位不一致
- 结局时间点混乱
数据提取不是机械抄表,而是一次标准化整理。
5. 统计分析要回答“结果是否可靠”
5.1 先看效应量,再看异质性
Meta分析的核心不只是合并结果,而是判断结果是否稳定。
常见统计内容包括:
- 森林图,展示各研究效应值及合并结果
- I²,判断异质性大小
- 偏倚评估,常见有红绿灯图、漏斗图
- GRADE,评估证据等级
I²是判断研究间差异是否明显的重要指标。
如果异质性高,不能只看总体合并值,还要进一步分析来源,例如人群差异、干预差异、结局定义差异。
5.2 敏感性分析比漏斗图更费时间
很多人只记得发表偏倚,却忽略敏感性分析。
实际上,敏感性分析往往更能检验结论稳不稳。
常见做法包括:
- 逐一剔除单项研究
- 更换统计模型
- 分亚组分析
- 对不同质量研究分别分析
敏感性分析的价值,在于看结论会不会被单个研究“带偏”。
5.3 统计工具可以提高效率
这些分析大多可以借助工具完成,例如:
- RevMan
- Stata
- R包
- Meta专用软件
其中R包免费,适合需要重复分析和自动化流程的研究者。
工具能提高效率,但前提是你先把数据结构和分析逻辑定义清楚。
6. 写作要遵循规范,也要讲清逻辑
6.1 PRISMA 2020是写作底线
Meta分析写作不能只写“结果显著”。
需要按照PRISMA 2020的27条规范,把方法、结果、偏倚、局限和结论完整交代清楚。
写作部分通常应包含:
- 引言,说明问题背景和研究意义
- 方法,交代检索、筛选、提取、统计流程
- 结果,展示纳入研究、森林图、异质性和偏倚
- 讨论,解释结果、比较既往研究、说明局限
方法写得越清楚,结果越容易被信任。
6.2 讨论部分要避免过度解读
Meta分析最容易出现的问题,是把“统计显著”直接写成“临床确定有效”。
这不严谨。
讨论时应明确:
- 证据等级是否足够高
- 异质性是否影响结论
- 纳入研究质量是否有限
- 结局指标是否存在局限
结论应该与证据强度匹配,而不是与作者期待匹配。
6.3 写作流程本身也要标准化
高效的写作通常按这个顺序推进:
- 先整理纳入研究特征。
- 再完成森林图和偏倚图。
- 接着写方法和结果。
- 最后写讨论和结论。
这样能减少来回修改。
先把图表和数据定稿,再写正文,是更稳妥的路径。
7. 把六步串起来,才算真正完成Meta分析
7.1 六步不是孤立动作,而是连续链条
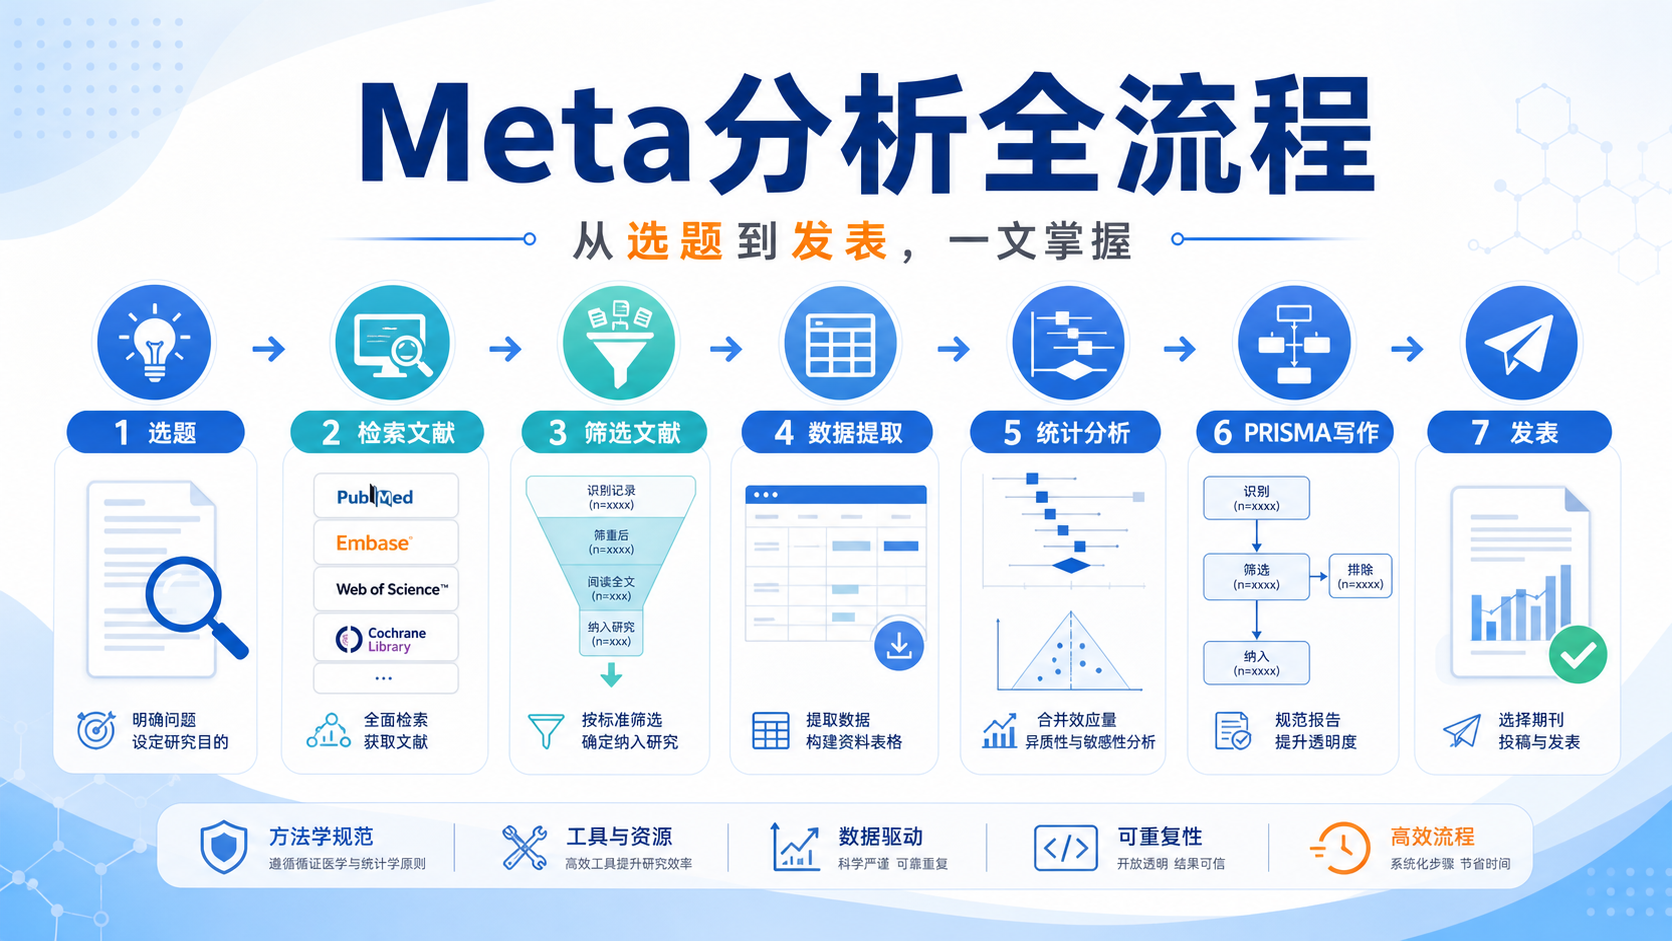
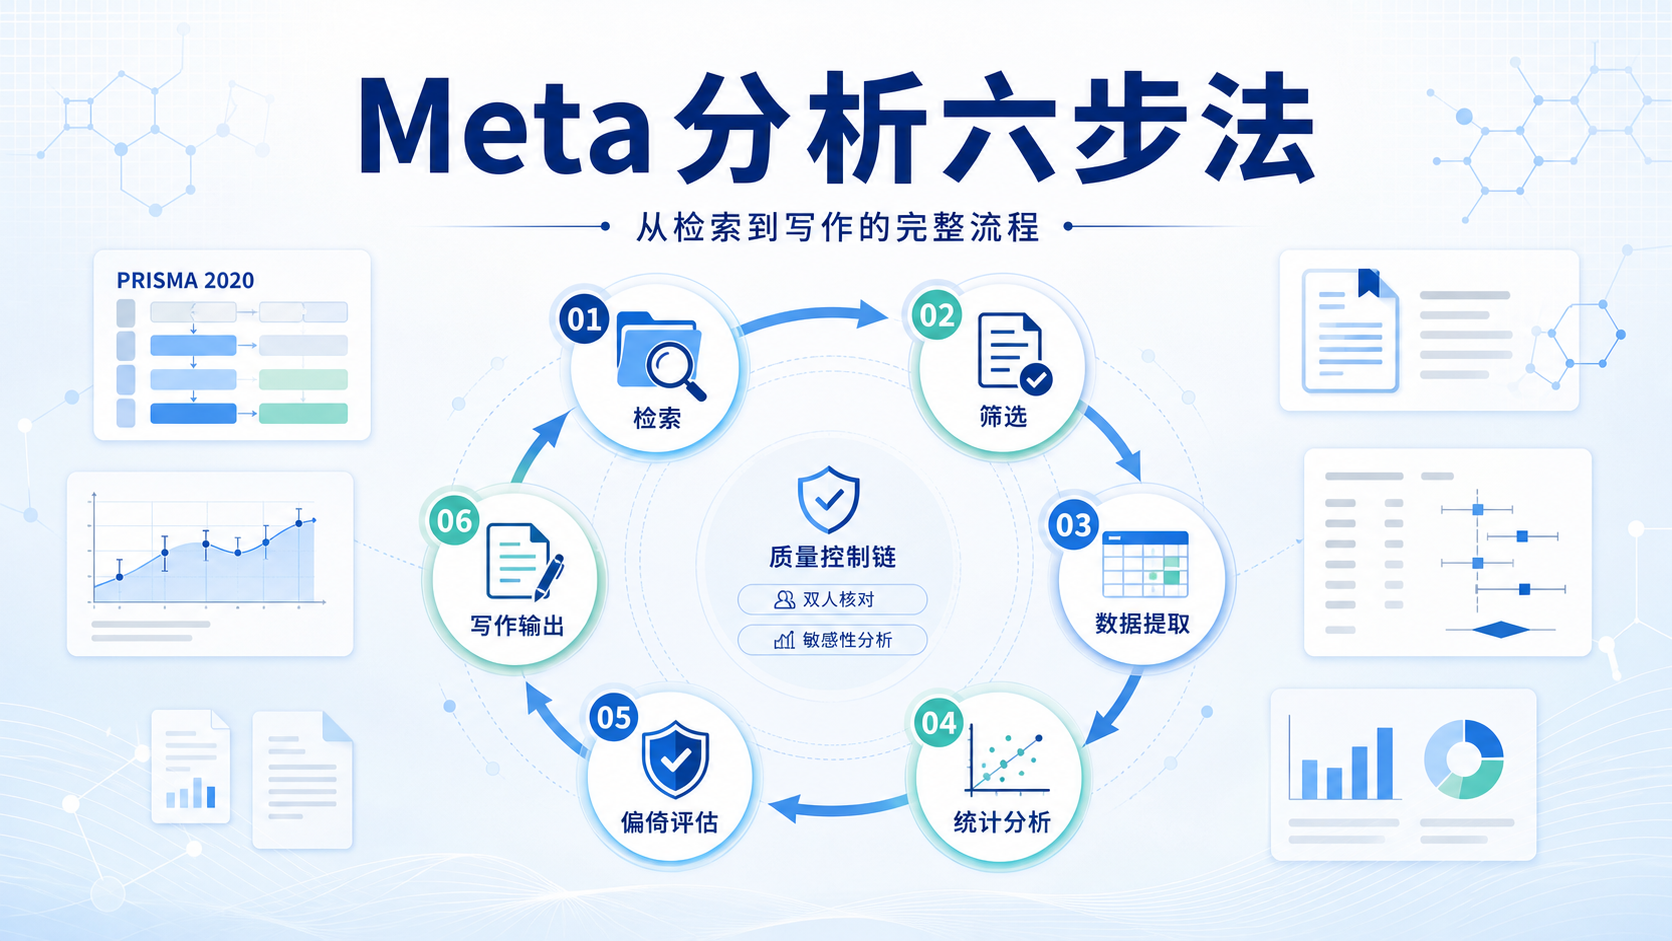
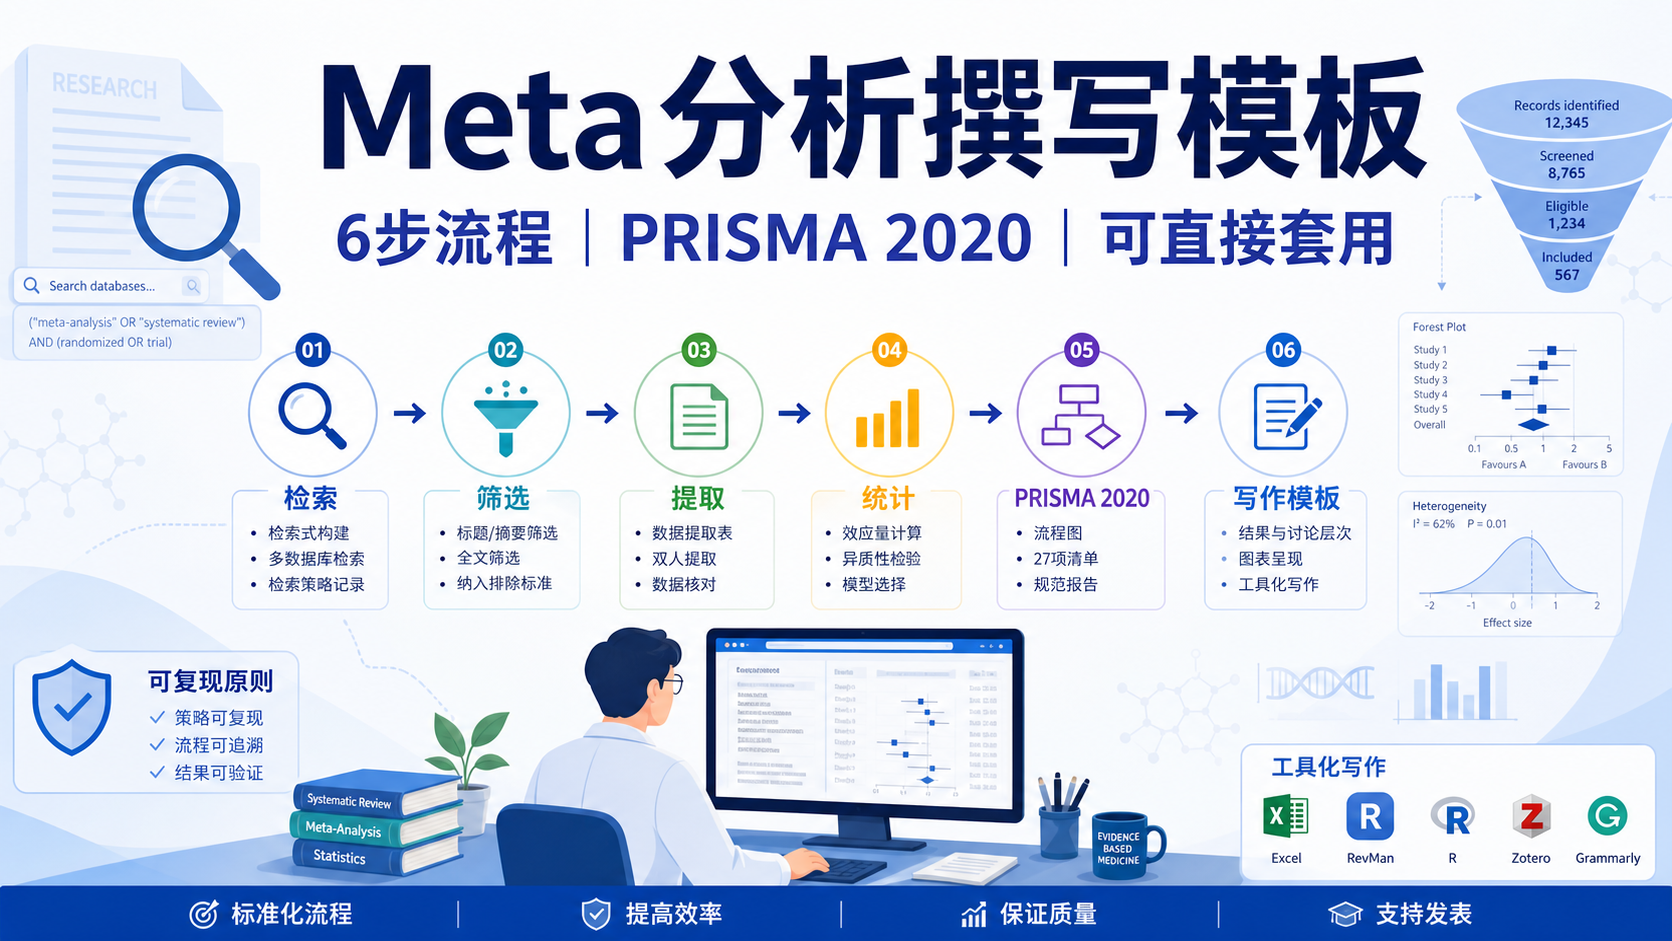
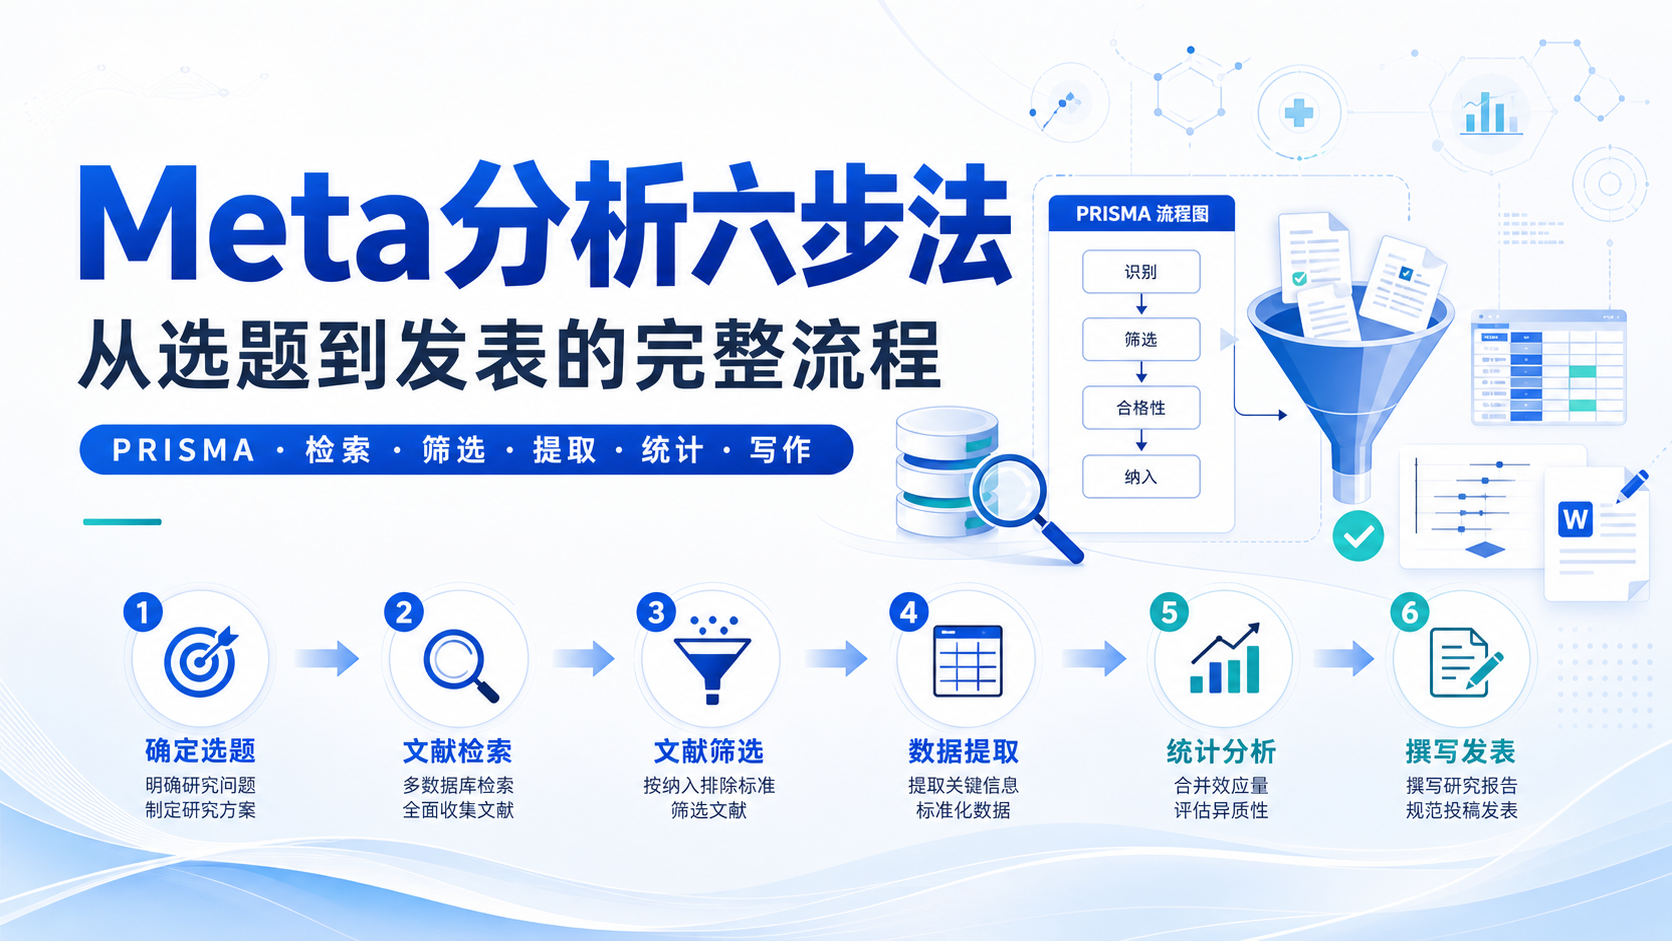
Meta分析的六步核心很清楚:
- 确定选题。
- 文献检索。
- 论文筛选,含初筛和精筛。
- 数据提取。
- 统计分析。
- 写文章。
前一步没做好,后一步一定要返工。
这也是为什么Meta分析看起来流程固定,真正做起来却很耗时。
7.2 规范化工具能减少重复劳动
对于医学生、医生和科研人员来说,最耗时的往往不是统计本身,而是检索、筛选、提取和整理的重复工作。
如果这些环节没有标准流程,整个项目就会不断拖延。
像解螺旋这类专业工具和服务,更适合帮助研究者把前期流程标准化,把检索、筛选、提取和写作中的重复工作压缩掉。当流程更清晰,Meta分析文献筛选写作就不再靠经验硬扛,而是靠规范推进。
总结Conclusion
Meta分析的本质,是把证据按规则组织起来。选题要准,检索要全,筛选要严,提取要细,统计要稳,写作要合规。只要六步链条完整,Meta分析文献筛选写作就会更高效,也更容易达到可发表标准。
如果你正在做Meta分析,建议尽早建立规范流程,或者直接借助解螺旋这类专业支持,减少返工,让研究更快进入可提交阶段。

- 引言Introduction
- 1. 先把选题定准
- 2. 检索决定了结果上限
- 3. 筛选要严格,过程要透明
- 4. 数据提取决定分析质量
- 5. 统计分析要回答“结果是否可靠”
- 6. 写作要遵循规范,也要讲清逻辑
- 7. 把六步串起来,才算真正完成Meta分析
- 总结Conclusion