18
 分享

引言Introduction
生存分析常见,但很多人卡在两点。第一,不会画生存曲线。第二,不知道两组曲线差异到底该怎么检验。Log-rank检验就是最常用的答案。 它能帮助你判断不同组别的生存结局是否存在统计学差异。
1. 生存曲线和Log-rank检验到底在回答什么问题
1.1 生存曲线不是“活没活”,而是“活了多久”
生存曲线研究的是时间到事件 。事件可以是死亡,也可以是复发、进展、转移。关键不在事件本身,而在事件发生所需的时间 。
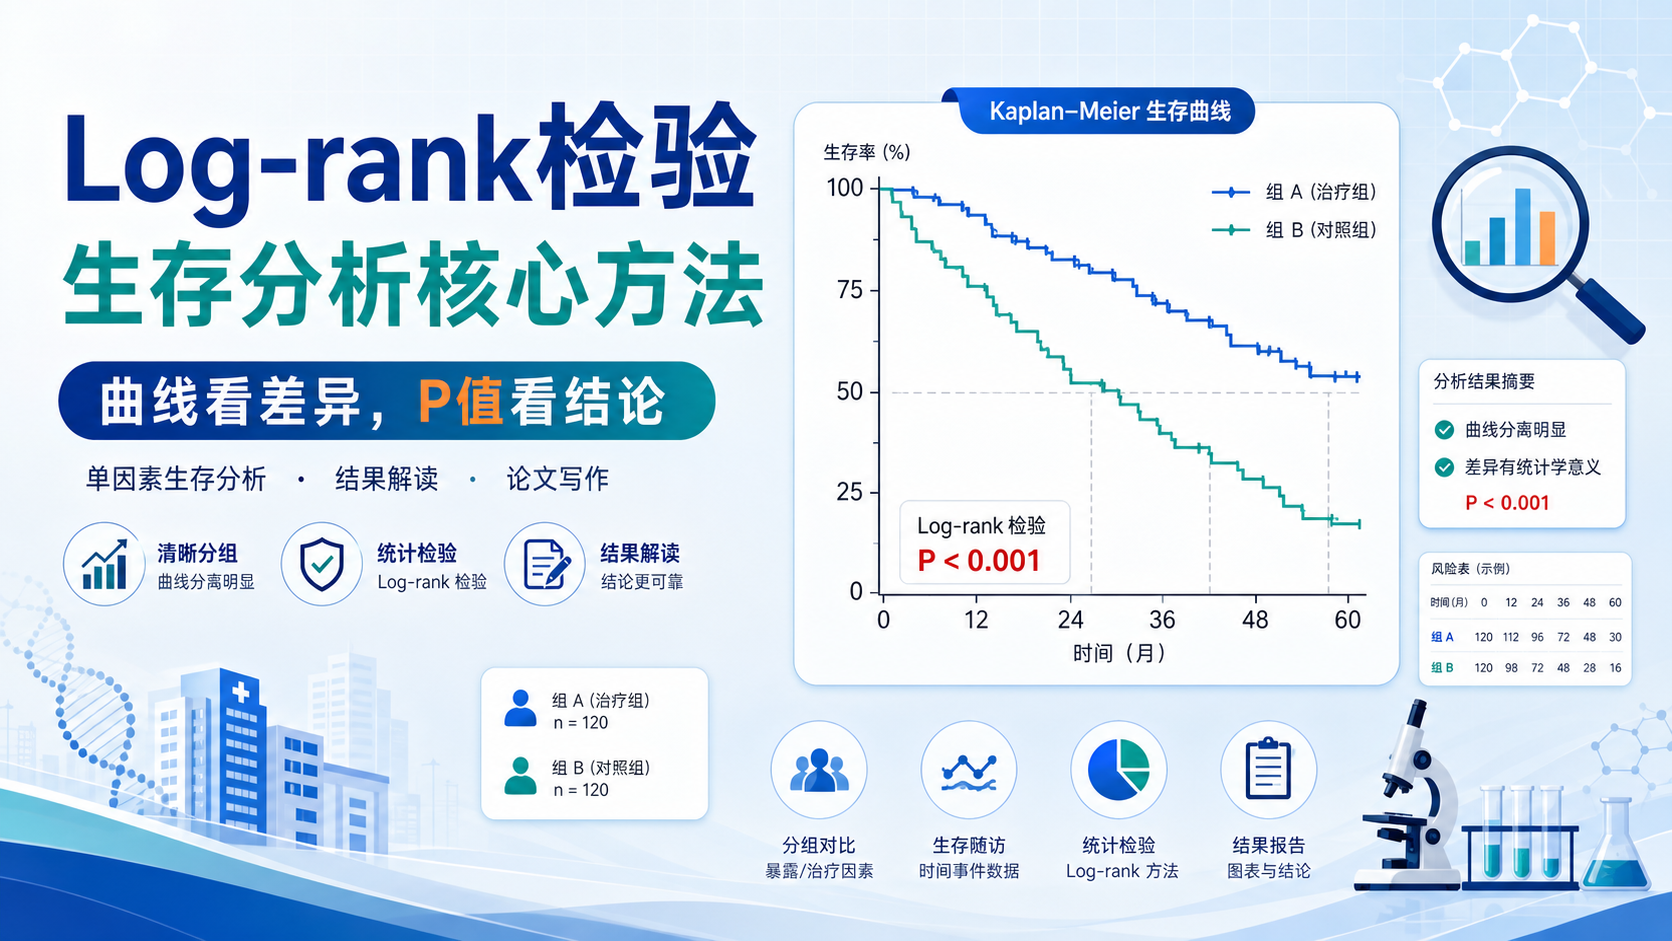
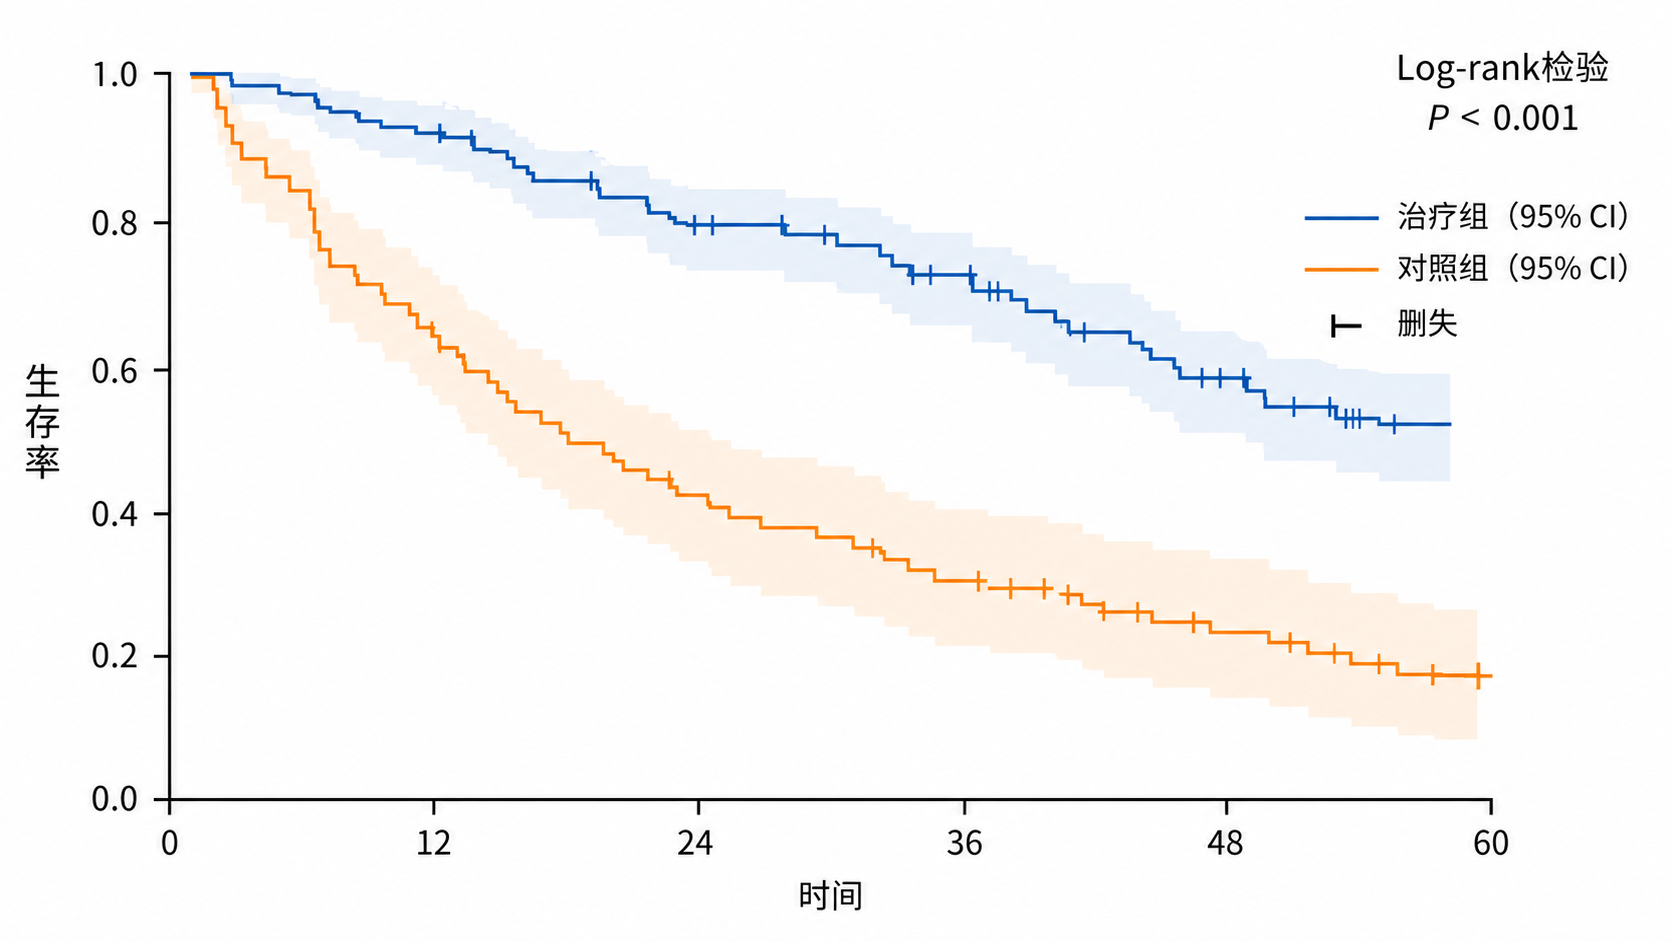
在临床研究里,生存曲线最常见的是Kaplan-Meier曲线。它把时间放在横轴,把生存概率放在纵轴。随着随访时间延长,生存率通常逐步下降。曲线越高,说明该组总体预后越好。
生存分析之所以重要,是因为它能处理两类现实问题。
- 随访时间不一致。
- 部分患者失访或尚未发生事件。
这类数据不能简单用均值比较。因为没有发生事件的人,信息并没有消失,只是属于删失数据。KM曲线和Log-rank检验正是为此设计的。
1.2 Log-rank检验比较的,是整条曲线
很多初学者以为Log-rank检验只是在比较某一个时间点。实际上不是。Log-rank检验比较的是两组在整个随访过程中的生存差异。
它的原假设很明确。
- 原假设:两组生存曲线无差异。
- 备择假设:两组生存曲线有差异。
如果P值小于0.05,通常认为两组生存曲线差异有统计学意义。也就是说,组别变量可能与预后相关。
在经典研究中,常见流程是:
- 先按某个因素分组。
- 画KM曲线。
- 用Log-rank检验比较组间差异。
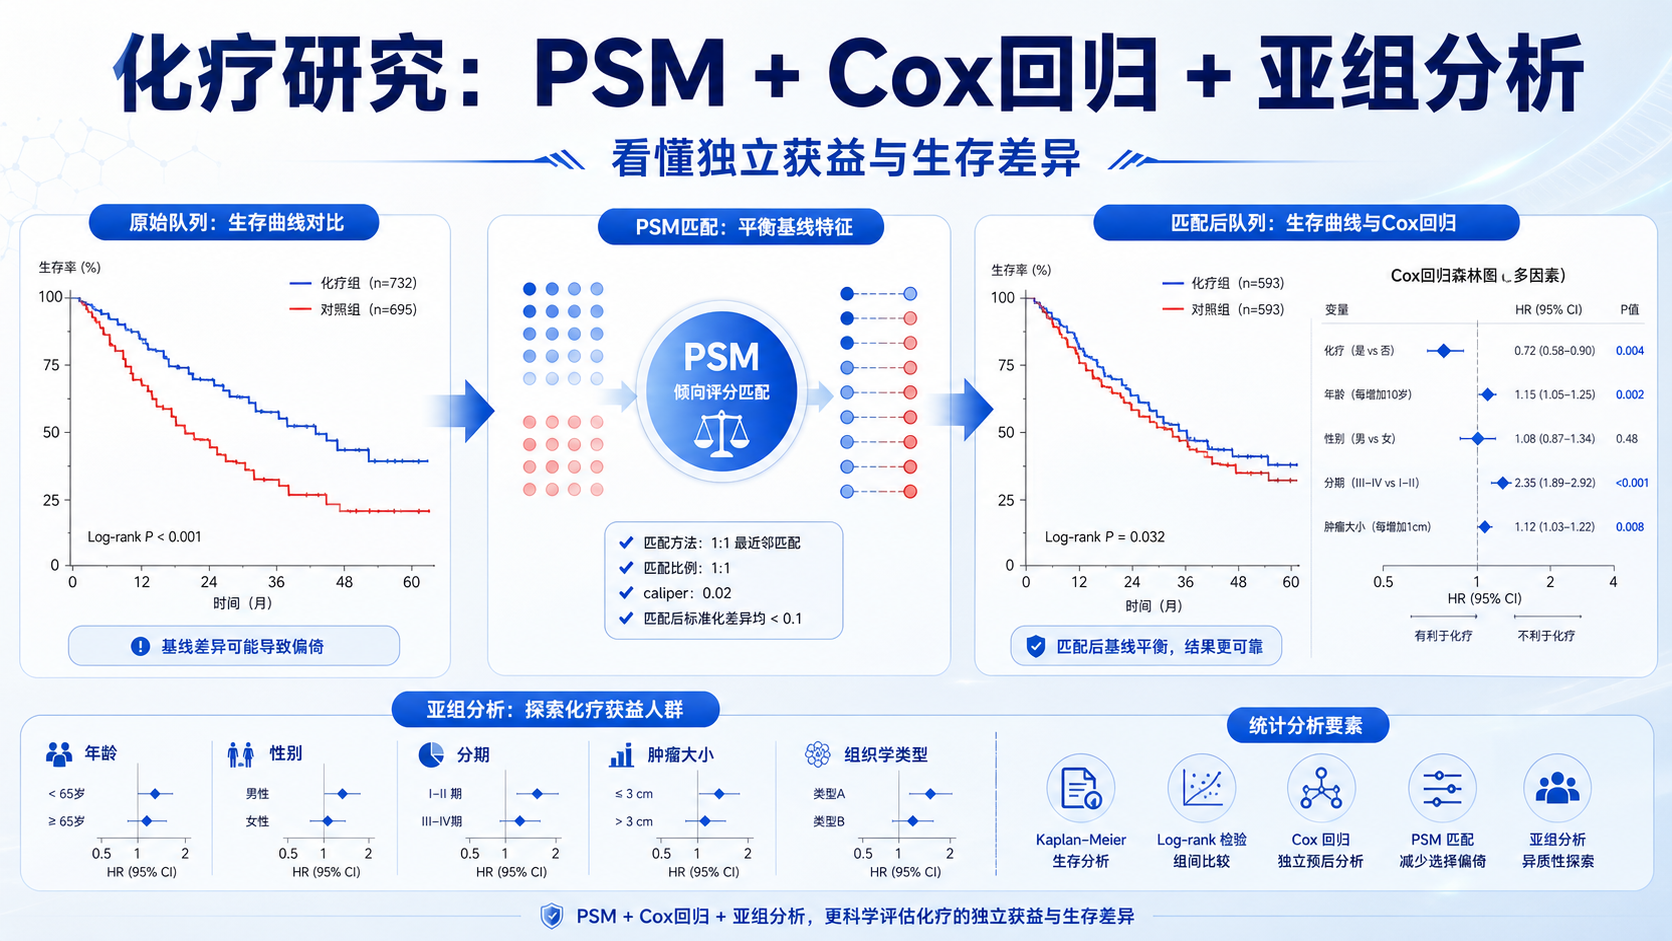
- 再进入Cox回归,判断是否为独立预后因素。
这是一条标准路径。很多文章的结果部分,本质上都沿着这条路径展开。
2. Log-rank检验为什么是生存分析的核心方法
2.1 它适合临床研究的真实数据
临床数据有一个典型特点,样本量往往不算大,而且随访时间不整齐。Log-rank检验在这种场景下非常实用。它不要求每个人在同一时间入组,也不要求每个人都完整随访到终点。
这也是它被广泛使用的原因。对医学生、医生和科研人员来说,它几乎是生存分析的“入门标配”。特别是在肿瘤预后、基因高低表达分组、治疗方案比较中,Log-rank检验都非常常见。
一个典型例子是按基因表达高低分组。
- 高表达组。
- 低表达组。
然后比较两组患者的总生存期或无进展生存期。如果P值显著,就提示该分组变量可能与预后相关。这类结果常用于筛选潜在生物标志物。
2.2 它和KM曲线是配套出现的
KM曲线负责展示趋势,Log-rank检验负责判断差异是否显著。 两者不是独立使用的,而是常常一起出现。
KM曲线告诉你,看起来哪组更好。
Log-rank检验告诉你,这种差异是不是“偶然波动”。
在论文写作中,常见表达是:
- “Kaplan-Meier曲线显示A组生存率高于B组。”
- “Log-rank检验提示两组差异具有统计学意义,P=0.01。”
这两个信息必须配合。只有曲线,没有统计学检验,证据不完整。只有P值,没有曲线,结果不直观。
2.3 它的优势在于解释简单
与很多复杂模型相比,Log-rank检验很容易解释。如果你想快速判断两组生存结局是否不同,它是最直接的方法。
它尤其适合下面这些场景。
- 两组或多组生存比较。
- 变量分组后初步筛选。
- 文章结果部分的基础展示。
- Cox回归之前的单因素分析补充。
但要注意,它只能说明“有无差异”,不能说明“为什么有差异”。如果你要控制年龄、分期、治疗等混杂因素,还是要用Cox回归。
3. Log-rank检验怎么做,结果怎么读
3.1 先确认你的数据格式
做生存分析前,数据必须清楚。一般至少需要三项。
- 生存时间。
- 结局状态。
- 分组变量。
其中,状态变量通常编码为0和1。
- 1,表示发生事件。
- 0,表示删失。
这里的事件要和研究终点一致。比如总生存研究中,事件可以定义为死亡。无进展生存研究中,事件可以定义为进展或死亡。终点定义不统一,结果就没有可比性。
如果数据中删失较多,也不用紧张。删失是生存分析的常态,不是错误。真正需要检查的是失访率。如果失访过高,研究可信度会下降。
3.2 统计软件里最常用的流程
无论是SPSS、R还是其他统计软件,Log-rank检验的思路都差不多。
标准流程通常是:
- 导入生存时间和状态。
- 按目标变量分组。
- 生成KM曲线。
- 输出Log-rank检验结果。
- 读取卡方值和P值。
在结果解释上,你只需要抓住两个重点。
- 卡方值。
- P值。
P值小于0.05,说明组间生存差异有统计学意义。P值大于0.05,说明当前样本中未观察到显著差异。但这不等于“完全没有差异”,只能说明证据不足。
3.3 论文里应该怎么写
在结果部分,建议写得简洁明确。
例如:
- “Kaplan-Meier曲线显示,高表达组的总体生存率低于低表达组,Log-rank检验提示差异有统计学意义(P<0.05)。”
- “两组患者的无进展生存曲线存在显著差异,Log-rank检验结果为P=0.012。”
如果你想写得更规范,可以把卡方值也报告出来。比如:
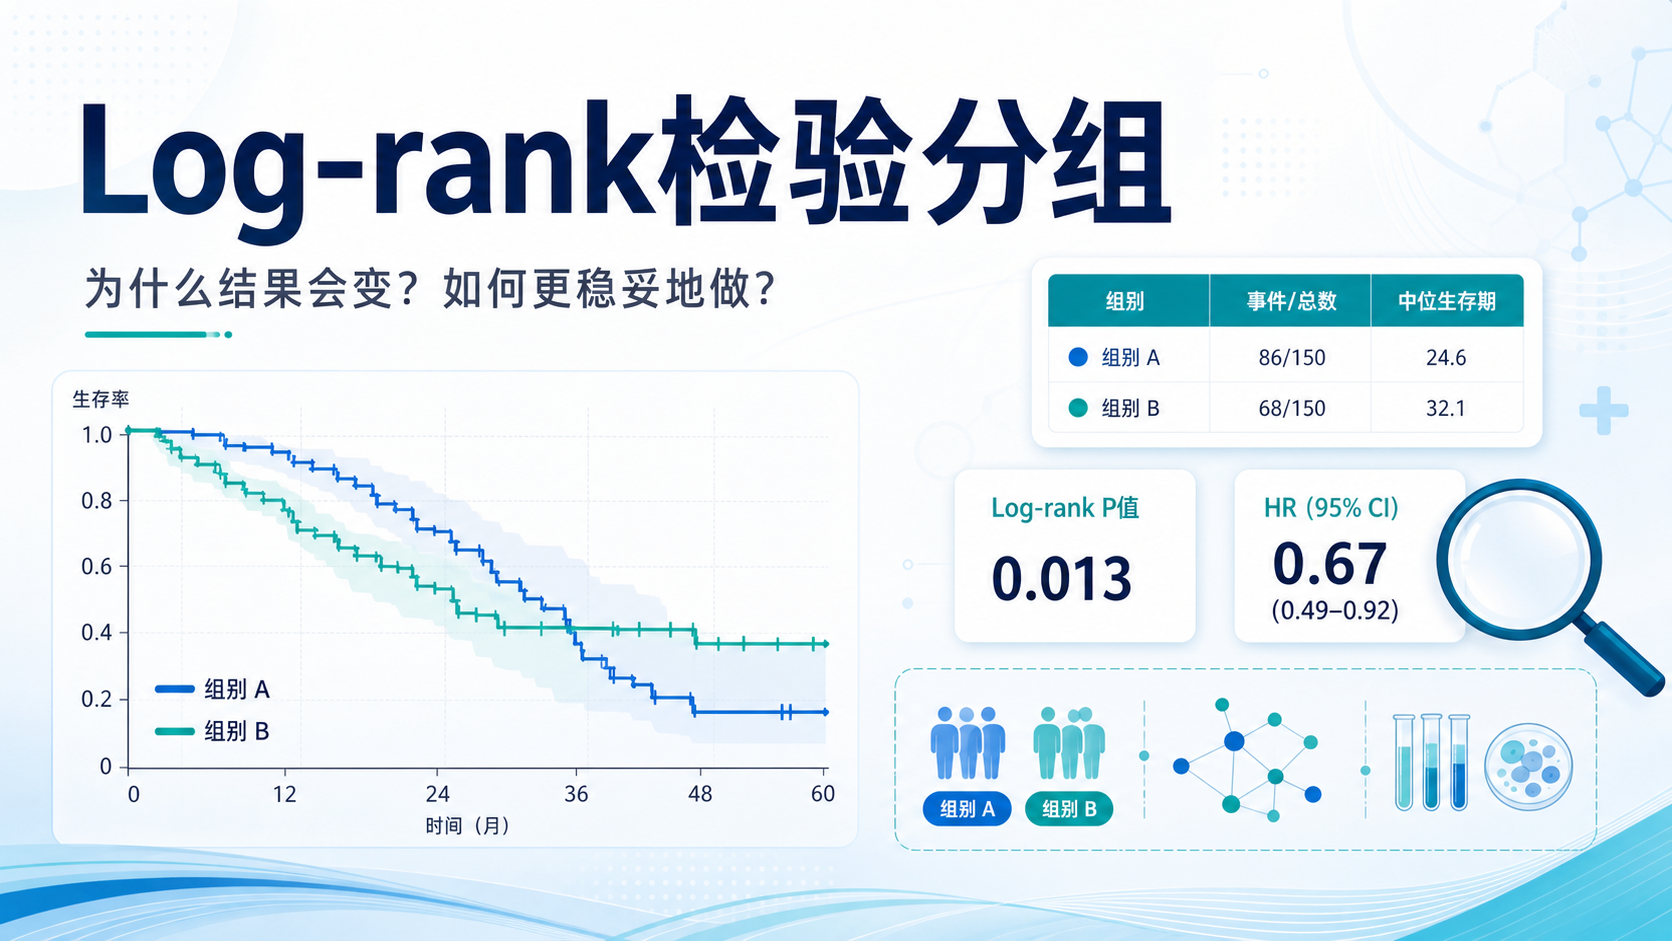
- “Log-rank检验提示两组生存差异显著,χ²=6.5,P=0.01。”
把统计量写全,有助于提高结果呈现的规范性。
4. 做Log-rank检验时,最容易踩的坑
4.1 曲线交叉时要特别小心
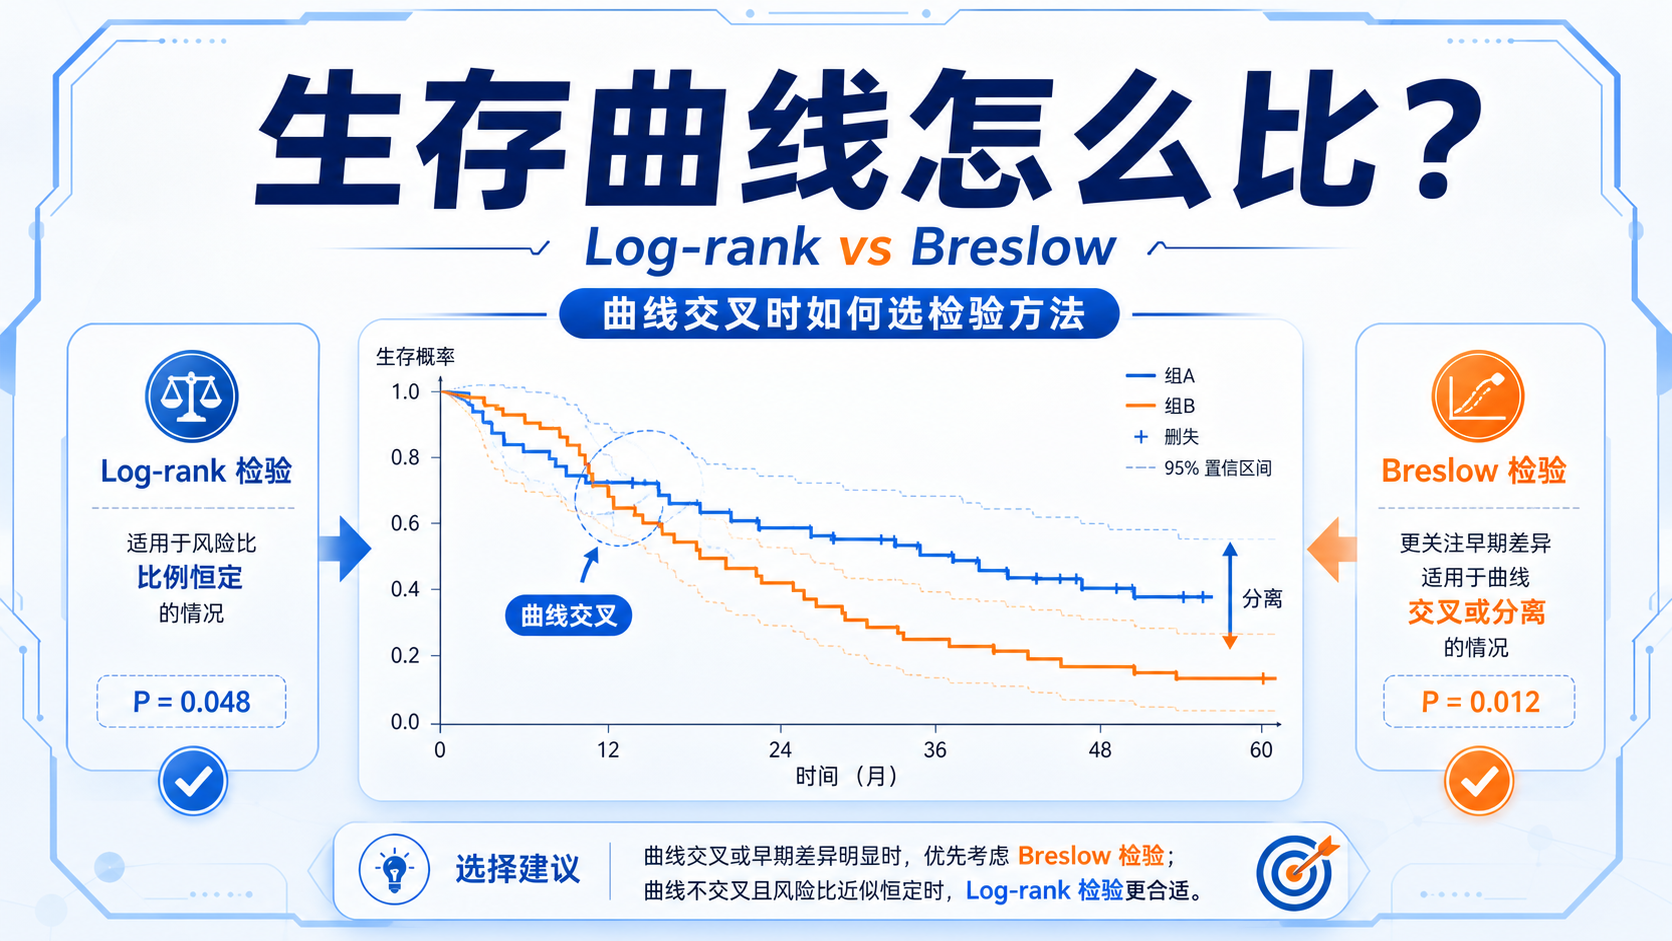
Log-rank检验有一个前提。它对两组整个随访过程中的差异比较敏感,适合生存曲线大体分离的情况。如果两条曲线明显交叉,结果就要谨慎解释。
为什么?因为曲线交叉说明不同时间段的风险可能方向相反。前期一组更好,后期另一组更好。这时单纯用Log-rank检验,可能掩盖时间依赖效应。
遇到这种情况,通常要考虑:
- 分段分析。
- Landmark分析。
- Two-stage方法。
所以,看到交叉曲线,先不要急着下结论。先检查分层是否合理,再考虑更适合的统计方法。
4.2 分组方式会影响结果
生存分析很依赖分组。分组方式不合理,结果就会偏。
常见分组方式包括:
- 按中位数分组。
- 按临床阈值分组。
- 按高低表达二分。
- 按分期、分级分组。
这里没有绝对标准,但要符合研究问题。分组不是为了追求显著,而是为了回答临床问题。
如果为了P值反复调整切点,很容易引入偏倚。
4.3 不要把Log-rank检验当作最终结论
Log-rank检验只能说明分组与结局有关,不能证明因果关系。
例如,一个基因高表达组生存差,不代表这个基因一定直接导致死亡风险升高。它也可能只是疾病进展严重程度的标记。
因此,经典文章通常会继续做Cox回归。
- 单因素Cox。
- 多因素Cox。
这样才能进一步判断该变量是否为独立预后因素。Log-rank检验是入口,不是终点。
5. 从经典文章结果中学会规范呈现
5.1 结果展示要“图表结合”
一篇规范的生存分析文章,通常至少包含两部分。
- KM生存曲线图。
- Log-rank检验结果表。
如果研究变量较多,还会加入临床特征表和Cox回归表。这样逻辑会更完整。
在表格呈现上,建议突出以下内容。
- 每组样本量。
- 事件数。
- 生存率。
- χ²值。
- P值。
图负责直观,表负责精确。 这是结果呈现的基本原则。
5.2 经典研究的思路值得借鉴
在预后研究中,常见做法是先比较临床特征,再做生存分析。比如某个分子在高低表达组间是否与年龄、分级、切除范围等因素相关。之后再看它是否影响预后。
这种思路的优点很明确。
- 先描述分布。
- 再比较组间差异。
- 再做生存分析。
- 最后进入多因素模型。
这是一套标准的预后文章写作框架。 对于医学生和科研人员来说,掌握它就能快速读懂大多数经典文章。
5.3 工具选择上,入门阶段不必复杂
如果你刚开始做生存分析,完全可以从基础工具入手。SPSS就能完成大部分常见分析。R当然更灵活,但并不是一上来就必须使用。
关键不是软件本身,而是你是否真正理解:
- 时间和事件怎么定义。
- 删失怎么处理。
- 曲线怎么解读。
- P值代表什么。
方法清楚,结果才可信。
总结Conclusion
生存曲线和Log-rank检验,是预后研究中最核心、最常用的一组方法。前者展示生存差异,后者检验差异是否显著。对医学生、医生和科研人员来说,掌握它,意味着你已经具备了阅读和完成基础生存分析的能力。
如果你希望进一步把生存分析做得更规范,下一步就要学习Cox回归、删失处理和模型评价。从读懂KM曲线到独立完成预后分析,这条路并不复杂,关键是方法要系统。
如果你想更高效地完成生存分析、图表整理和论文结果呈现,可以继续关注解螺旋 。它能帮助你把复杂统计流程变成更标准、更高效的科研工作流。

- 引言Introduction
- 1. 生存曲线和Log-rank检验到底在回答什么问题
- 2. Log-rank检验为什么是生存分析的核心方法
- 3. Log-rank检验怎么做,结果怎么读
- 4. 做Log-rank检验时,最容易踩的坑
- 5. 从经典文章结果中学会规范呈现
- 总结Conclusion