15
 分享
引言Introduction
Log-rank检验常用于生存分析,但很多人只会看P值,不会判断分组是否合理。结果一旦分组偏差,曲线再漂亮也可能不可靠。真正影响结论的,不只是“显著”,还有分组策略是否稳健。
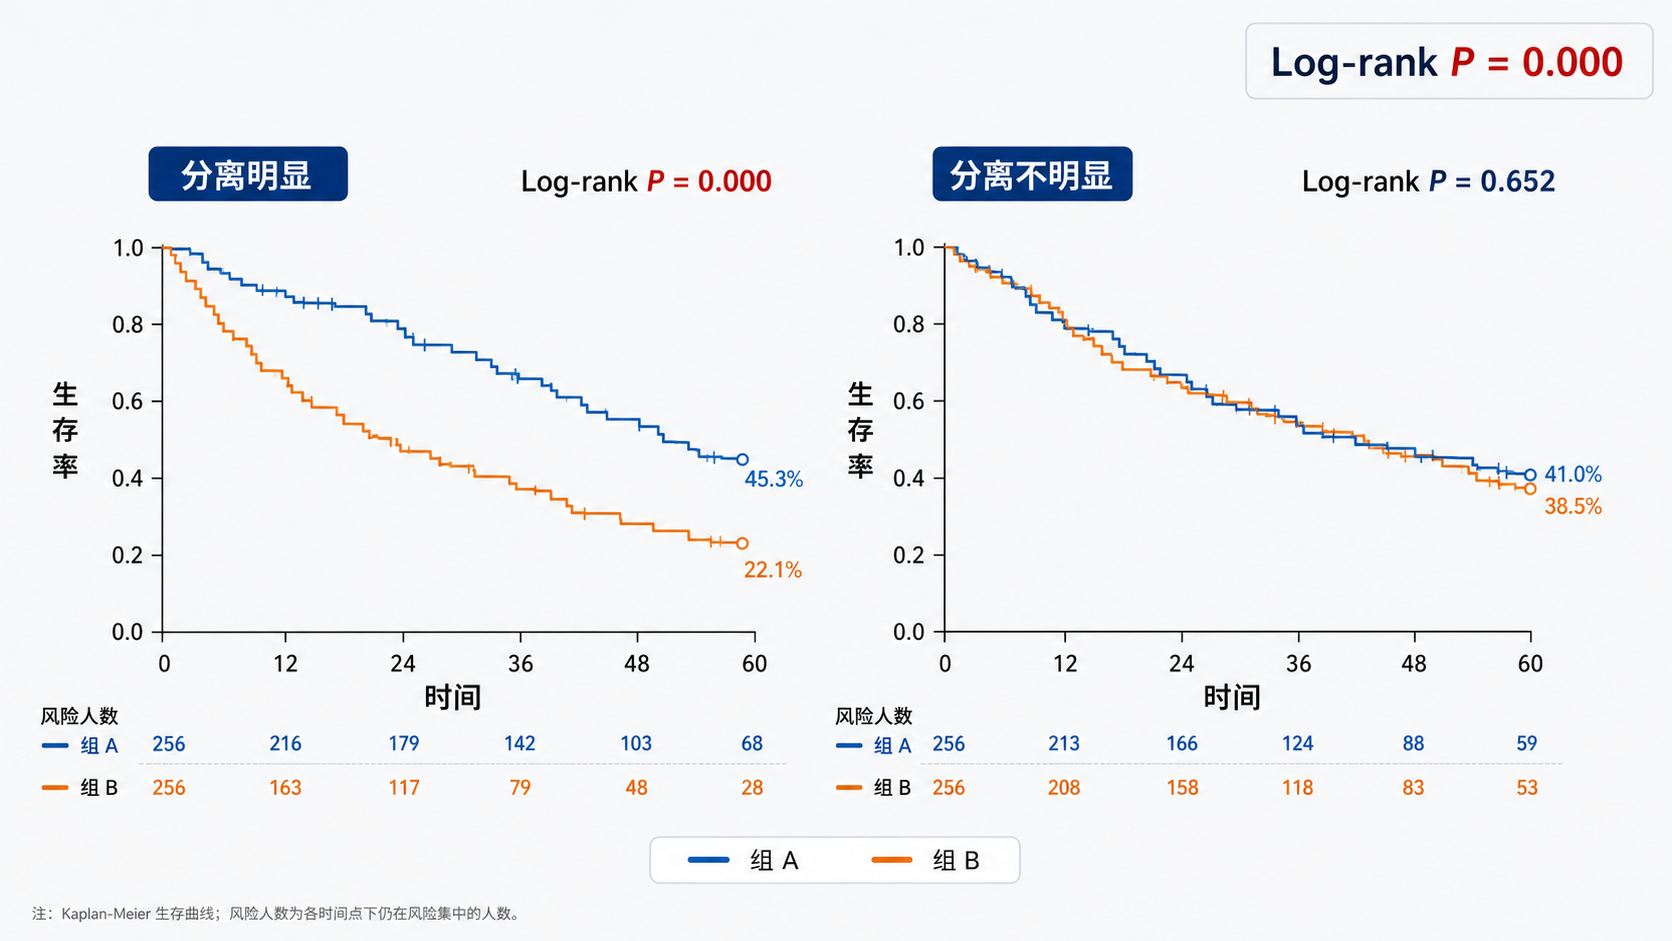
1. Log-rank检验到底在检验什么
1.1 先理解它比较的不是“平均生存期”
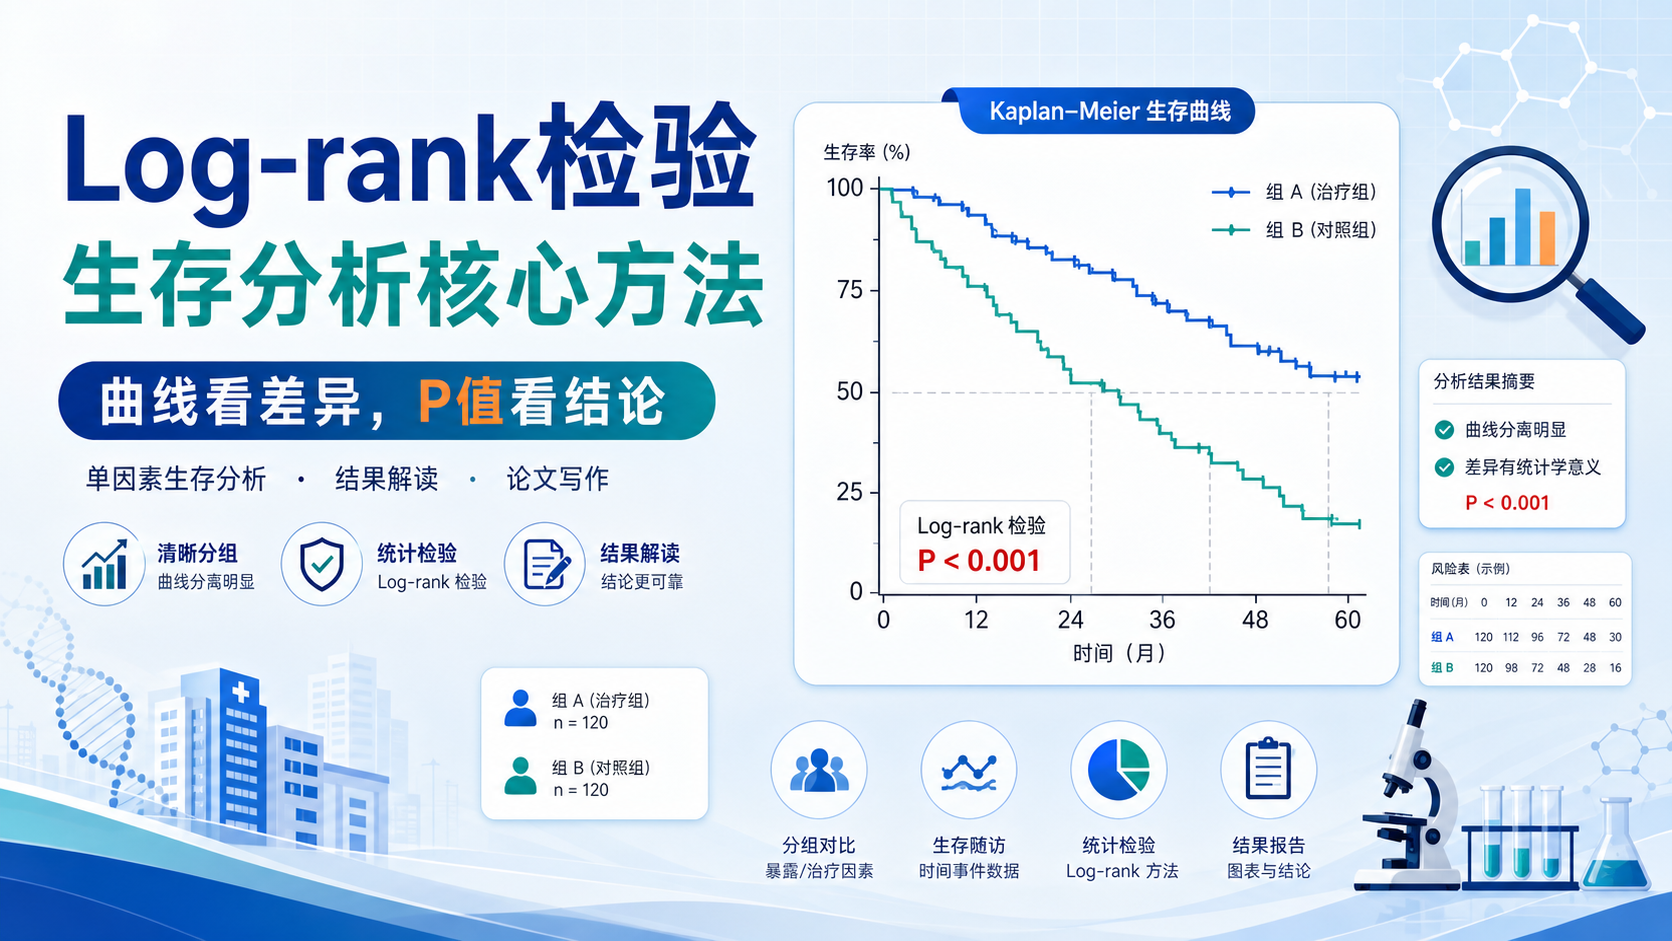
Log-rank检验本质上是在比较两组或多组的生存分布是否相同 。它关注的是整个随访期间,事件发生的累计差异,而不是单点时间的差别。
这也是为什么它常用于Kaplan-Meier曲线。只要各组在多个时间点的风险差异持续存在,Log-rank检验就更容易得到显著结果。它回答的是“曲线是否分开”,不是“谁活得更久一点”。
1.2 结果解读不能只看P值
P值小于0.05,说明组间生存曲线存在统计学差异。但这不等于分组方式好,也不等于模型有临床价值。
解读时至少要同时看以下几点:
- 曲线是否在早期、中期、晚期都有稳定分离。
- 各组样本量是否极不平衡。
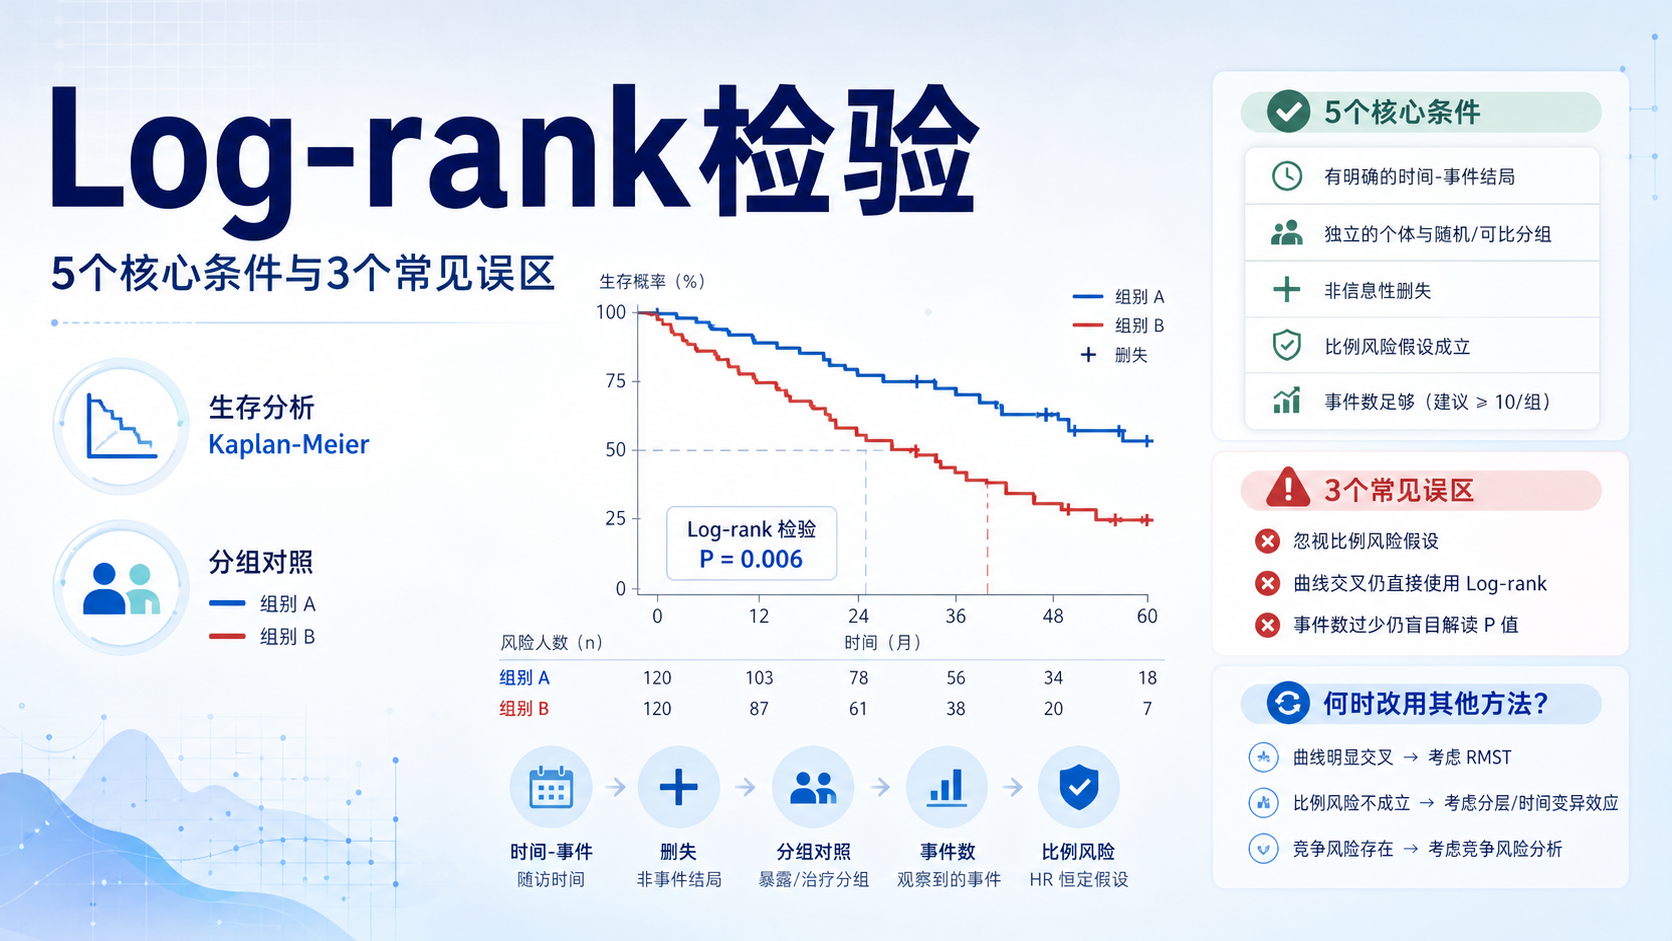
- 事件数是否足够,尤其是死亡或复发事件。
- 是否存在明显交叉曲线。
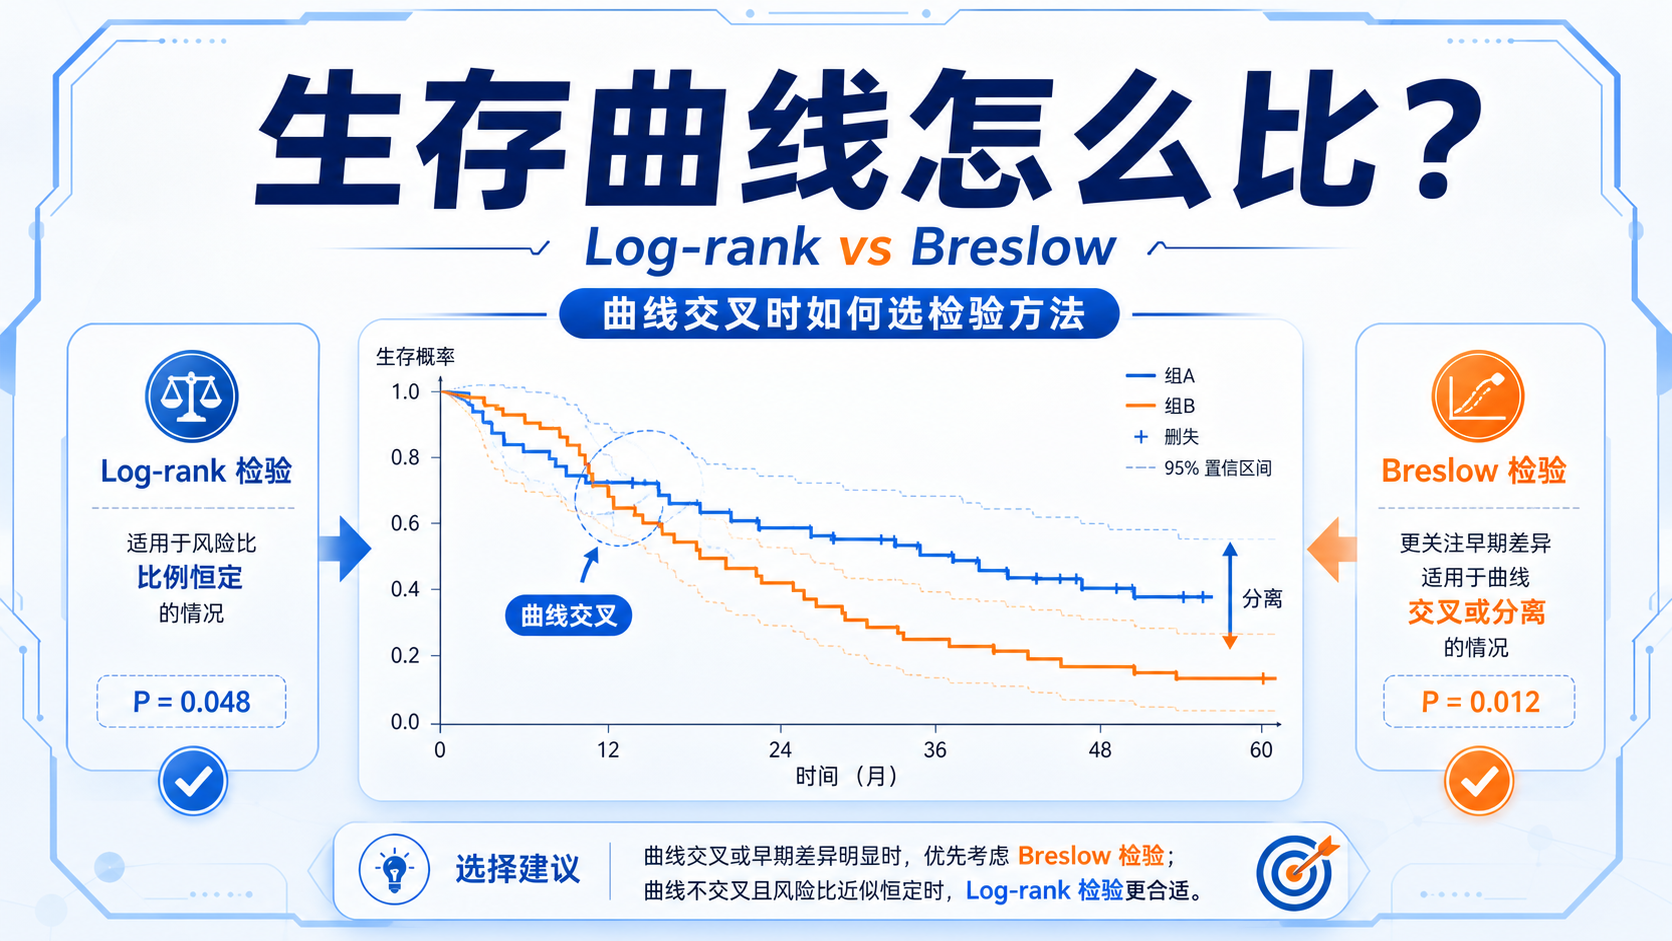
如果曲线频繁交叉,Log-rank检验可能低估真实差异,甚至给出误导性结论。
1.3 交叉曲线要特别小心
Log-rank检验最适合风险比相对稳定的情况。如果某组前期风险高,后期风险反而低,曲线交叉就会削弱检验效能。
这种情况并不少见。例如免疫治疗相关队列中,早期可能因假性进展出现曲线重叠,后期才拉开差异。此时只依赖Log-rank检验,结论可能不完整。
更稳妥的做法是结合:
- 分段生存分析。
- Cox回归。
- 时间依赖性ROC。
- 风险比随时间变化的模型。
2. Log-rank检验分组为什么会影响结果
2.1 分组边界决定统计功效
很多研究会把连续变量按中位数、四分位数或最佳截点分组。分组边界一旦变化,P值和曲线形态都可能改变。
例如同一个表达量指标:
- 按中位数分组,样本均衡,但效应可能被稀释。
- 按三分位分组,能看到梯度趋势,但每组样本减少。
- 按最佳截点分组,差异可能最强,但存在过拟合风险。
所以,分组不是越“显著”越好,而是要兼顾可重复性和生物学解释。
2.2 连续变量硬切分会丢失信息
如果一个指标本来是连续变化的,强行二分往往会损失大量信息。尤其是分布接近正态时,二分后会压缩组内差异。
这会带来两个问题:
- 统计功效下降。
- 不同队列复现性变差。
如果研究目的不是做临床阈值,而是探索关联,优先考虑保留连续变量。
2.3 最佳截点不等于最优科学解释
很多人喜欢用“最佳截点”找最显著的分组方式。但这个方法本质上是在多次尝试中挑选最优结果,如果没有校正,容易夸大显著性。
因此,使用最佳截点时要注意:
- 是否进行了多重检验校正。
- 是否有独立验证队列。
- 截点是否有明确的生物学依据。
- 是否能被临床或实验解释。
没有外部验证的最佳截点,更多适合探索,不适合直接下结论。
3. 如何更稳妥地做Log-rank检验分组
3.1 优先按研究问题选择分组逻辑
不同研究目的,分组方式应不同。
- 机制探索。可用中位数、四分位数或连续变量建模。
- 风险预测。可寻找可复现的截点,并做外部验证。
- 临床转化。尽量采用有现实意义的阈值,如指南标准或已知临界值。
分组逻辑应该先服务于问题,再服务于统计。
3.2 检查样本量和事件数
Log-rank检验不是单看总样本数,而是看事件数。若事件太少,哪怕总样本不少,统计功效也会不足。
建议在分组前先检查:
- 每组样本量是否至少保持基本均衡。
- 每组事件数是否过低。
- 随访时间是否足够长。
- 是否有大量删失集中在某一组。
如果某组事件数明显太少,曲线再漂亮也要谨慎解释。
3.3 用多种方案交叉验证
一个稳健的分组结果,通常不应只依赖单一切分方法。可以对同一变量尝试以下方案:
- 中位数分组。
- 三分位或四分位分组。
- ROC或时间依赖ROC辅助分组。
- 临床阈值分组。
- 外部队列复现。
若多种方案下方向一致,结论可信度更高。方向一致,比单次P值更重要。
4. 解读结果时最容易忽略的细节
4.1 看曲线,不只看表格
论文里很多人先报P值,再贴KM曲线。但真正的判断应该先看曲线形态。
重点看:
- 是否存在早期分离。
- 是否持续分离。
- 是否晚期才突然分离。
- 是否有明显交叉。
如果曲线只是末端分开,而中前期高度重叠,临床意义往往有限。
4.2 要结合HR和置信区间
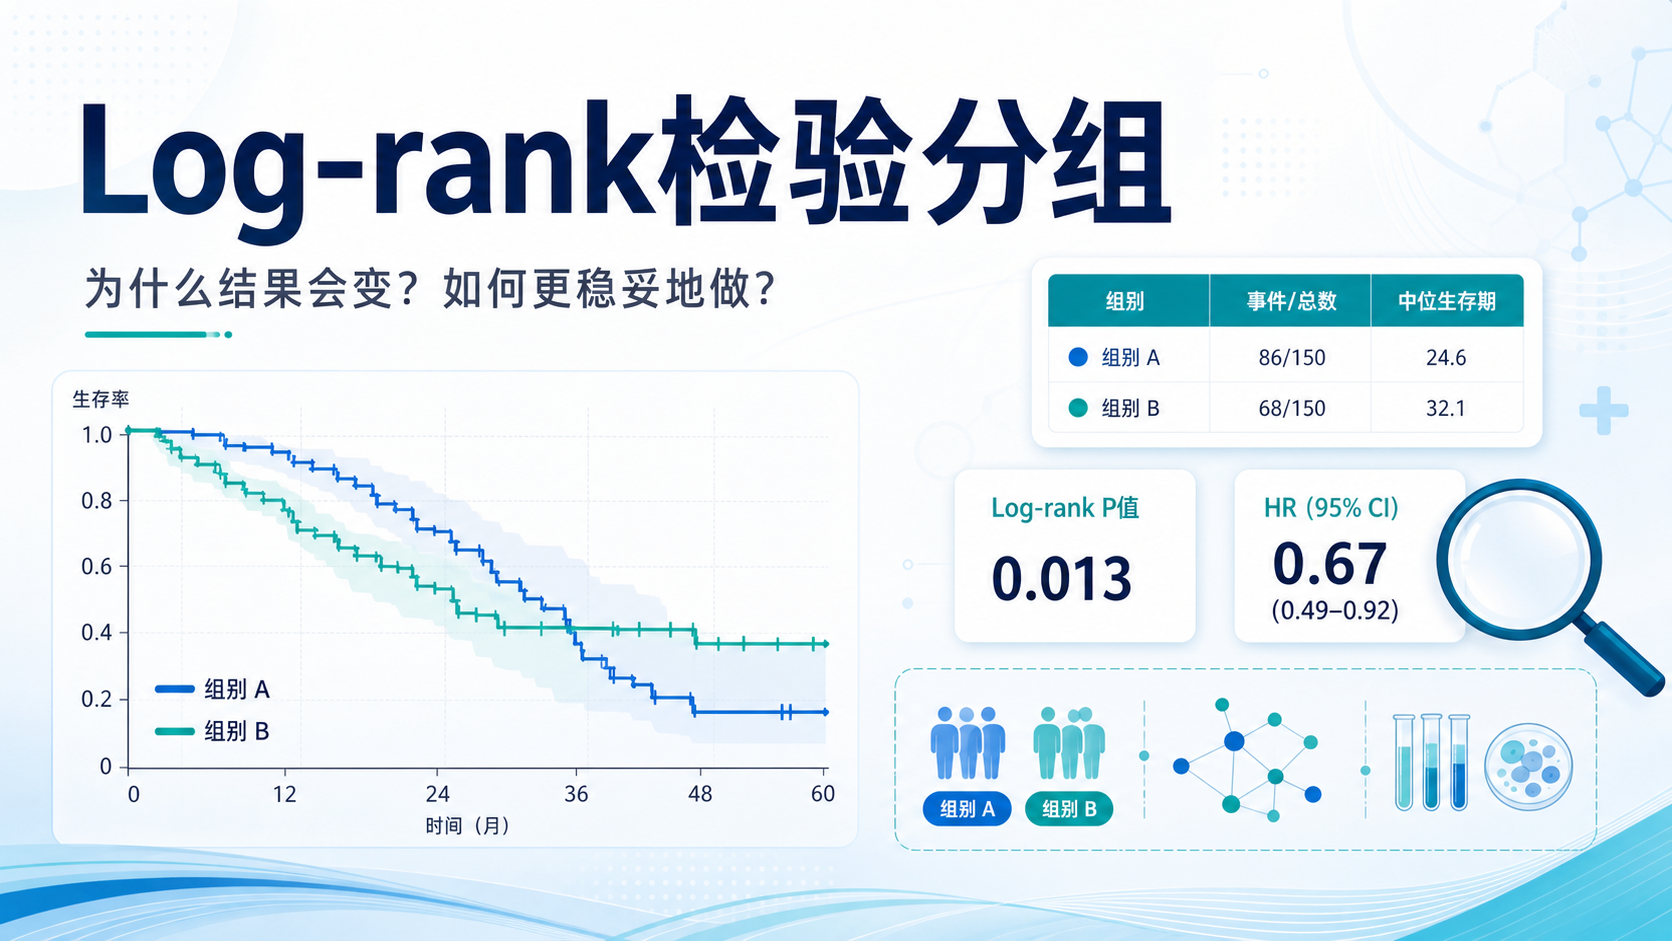
Log-rank检验只告诉你差异是否存在。它不告诉你效应大小。此时应结合Cox回归的HR和95%CI。
- HR > 1,表示事件风险升高。
- HR < 1,表示事件风险降低。
- 95%CI跨1,说明结果稳定性不足。
P值显著不代表效应强,HR才体现方向和强度。
4.3 别忽视混杂因素
如果只做单因素Log-rank检验,结果可能受年龄、分期、治疗方案影响。尤其在临床队列中,这类混杂非常常见。
因此建议至少进行:
- 单因素Log-rank分析。
- 多因素Cox回归。
- 分层分析。
这样才能判断分组变量是否独立影响生存结局。
5. 实战中如何优化Log-rank检验分组
5.1 先做数据清洗
分组前先确认数据格式是否规范。常见问题包括:
- 时间变量单位不统一。
- 事件结局编码错误。
- 缺失值未处理。
- 极端值影响截点判断。
这些基础问题一旦存在,后面的Log-rank检验结果都可能失真。
5.2 避免“为了显著而分组”
这是最常见的错误。研究者在多个阈值中反复试验,直到得到P<0.05,再把它写成“最佳分组”。
这种做法的问题在于,它增加了假阳性风险。分组优化的目标是提高可重复性,不是单纯追求最小P值。
5.3 结合可视化一起判断
对医学生、医生和科研人员来说,图形判断非常重要。除了KM曲线,还可以配合:
- 风险表。
- 删失标记。
- 分组前变量分布图。
- 火山图或箱线图辅助解释分组依据。
在实际分析中,像解螺旋这类科研工具可以帮助你更快完成分组可视化、曲线绘制和结果拼图。把数据整理、作图、排版整合到同一流程,能明显减少重复操作,提高分析效率。
6. 什么时候应重新考虑分组方案
6.1 曲线严重交叉时
如果两组KM曲线频繁交叉,说明单一Log-rank检验可能并不合适。此时应考虑:
- 改用分层分析。
- 使用时间依赖模型。
- 重新定义分组逻辑。
6.2 样本分布极不均衡时
若一组人数过少,模型稳定性会下降。即便P值显著,也可能只是偶然波动。此时应重新寻找更均衡的阈值,或改用连续变量分析。
6.3 外部验证失败时
如果训练队列显著,验证队列不显著,说明分组可能不稳健。此时应回头检查:
- 截点是否过拟合。
- 数据标准化是否一致。
- 队列来源是否存在异质性。
能在独立队列复现的分组,才更接近真正可用的结论。
总结Conclusion
Log-rank检验的核心,不只是得到一个P值,而是判断分组是否真实反映了生存差异 。解读时要同时看曲线形态、样本平衡、事件数、HR和混杂因素。分组优化也不应追求单次显著,而应优先保证可重复性、可解释性和外部验证。
如果你希望更高效完成生存分析分组、KM曲线绘制和结果整理,可以尝试使用解螺旋 ,把数据分析、可视化和报告输出整合到一个流程中,减少手工操作,更快得到可发表、可复现的结果。

- 引言Introduction
- 1. Log-rank检验到底在检验什么
- 2. Log-rank检验分组为什么会影响结果
- 3. 如何更稳妥地做Log-rank检验分组
- 4. 解读结果时最容易忽略的细节
- 5. 实战中如何优化Log-rank检验分组
- 6. 什么时候应重新考虑分组方案
- 总结Conclusion