22
 分享
引言Introduction
Log-rank检验常用于比较两组或多组生存曲线,但很多人只会看P值,不会读结果,更不会结合KM曲线判断临床意义。真正有价值的解读,必须把P值、卡方值、曲线形态和研究设计放在一起看。 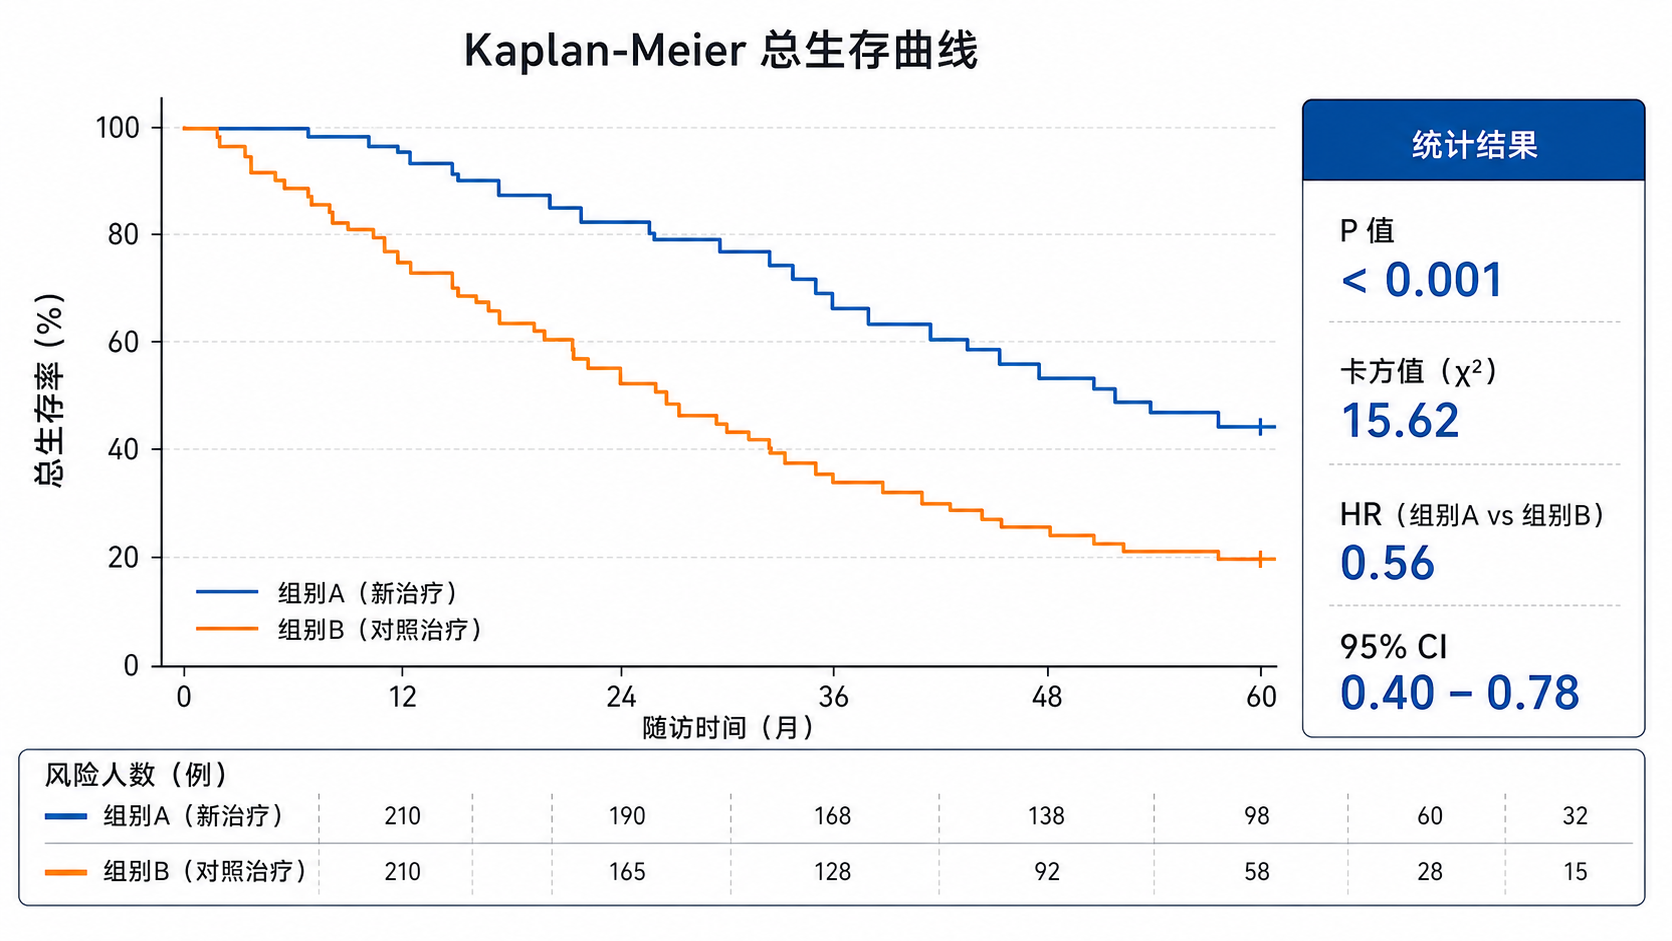
1.Log-rank检验是什么
1.1 它回答的核心问题
Log-rank检验用于比较不同组别的生存分布是否存在差异。它最常见于KM曲线分析。
它检验的不是“某一个时间点谁更高”,而是“整个随访期间两组生存曲线是否不同”。
在临床研究中,它常用于比较不同治疗组、不同分子分型组,或高低表达组的总体生存差异。
如果研究对象存在删失数据,Log-rank检验依然适用,这也是它在生存分析中最常见的原因之一。
1.2 它和KM曲线的关系
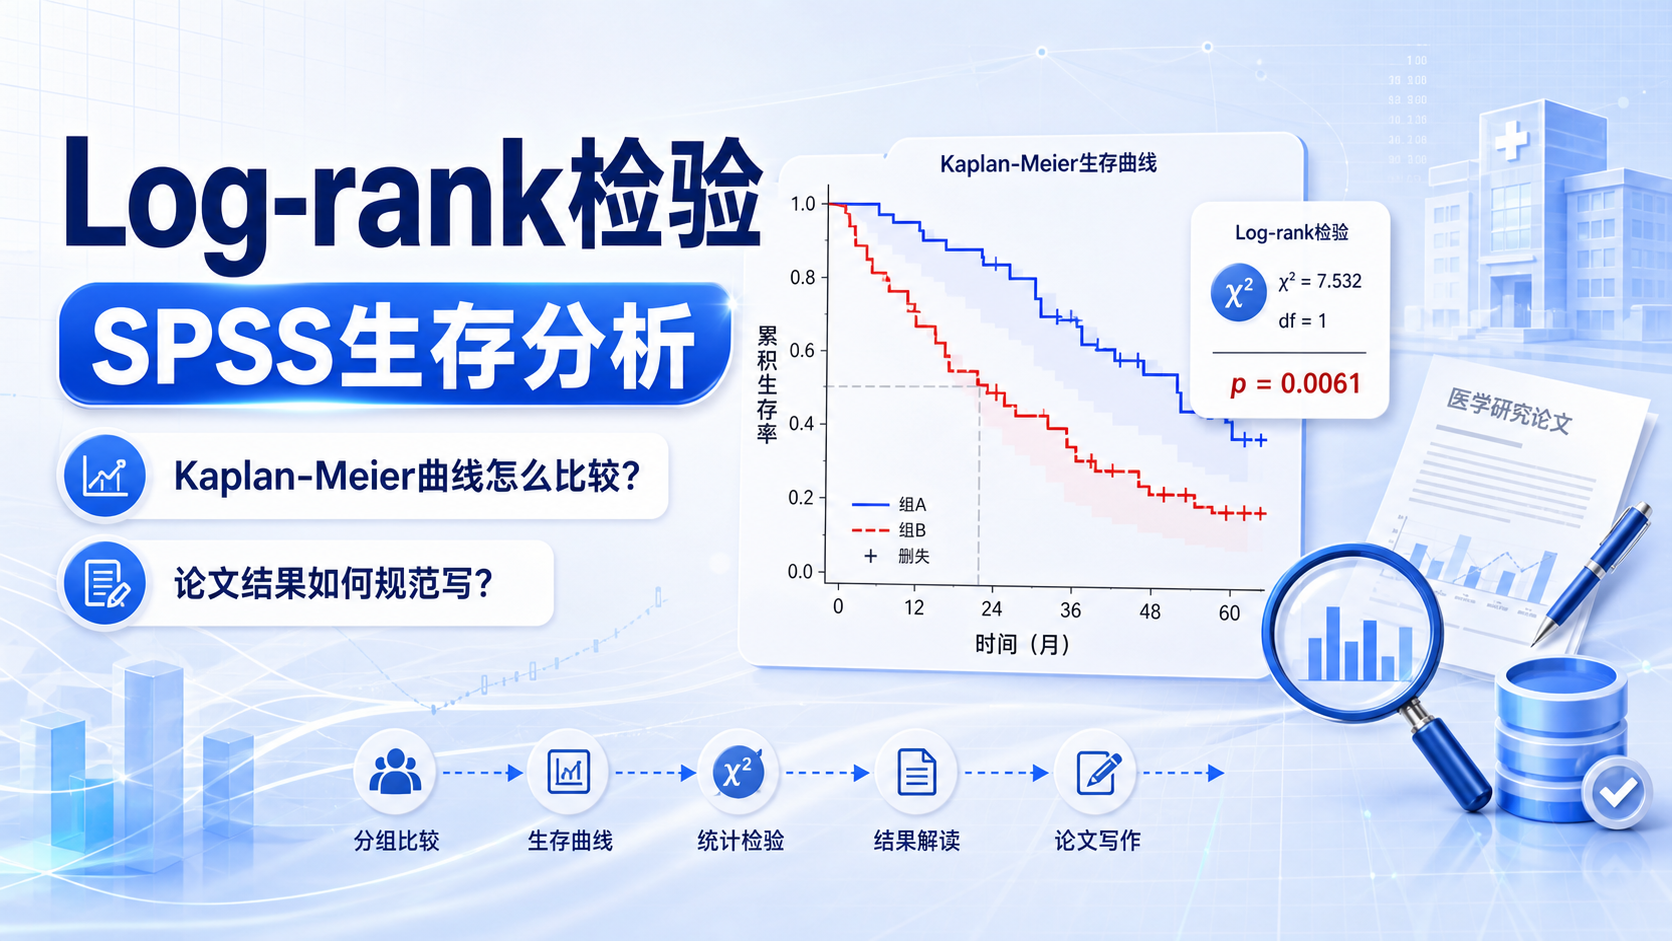
KM曲线负责“展示”,Log-rank检验负责“比较”。
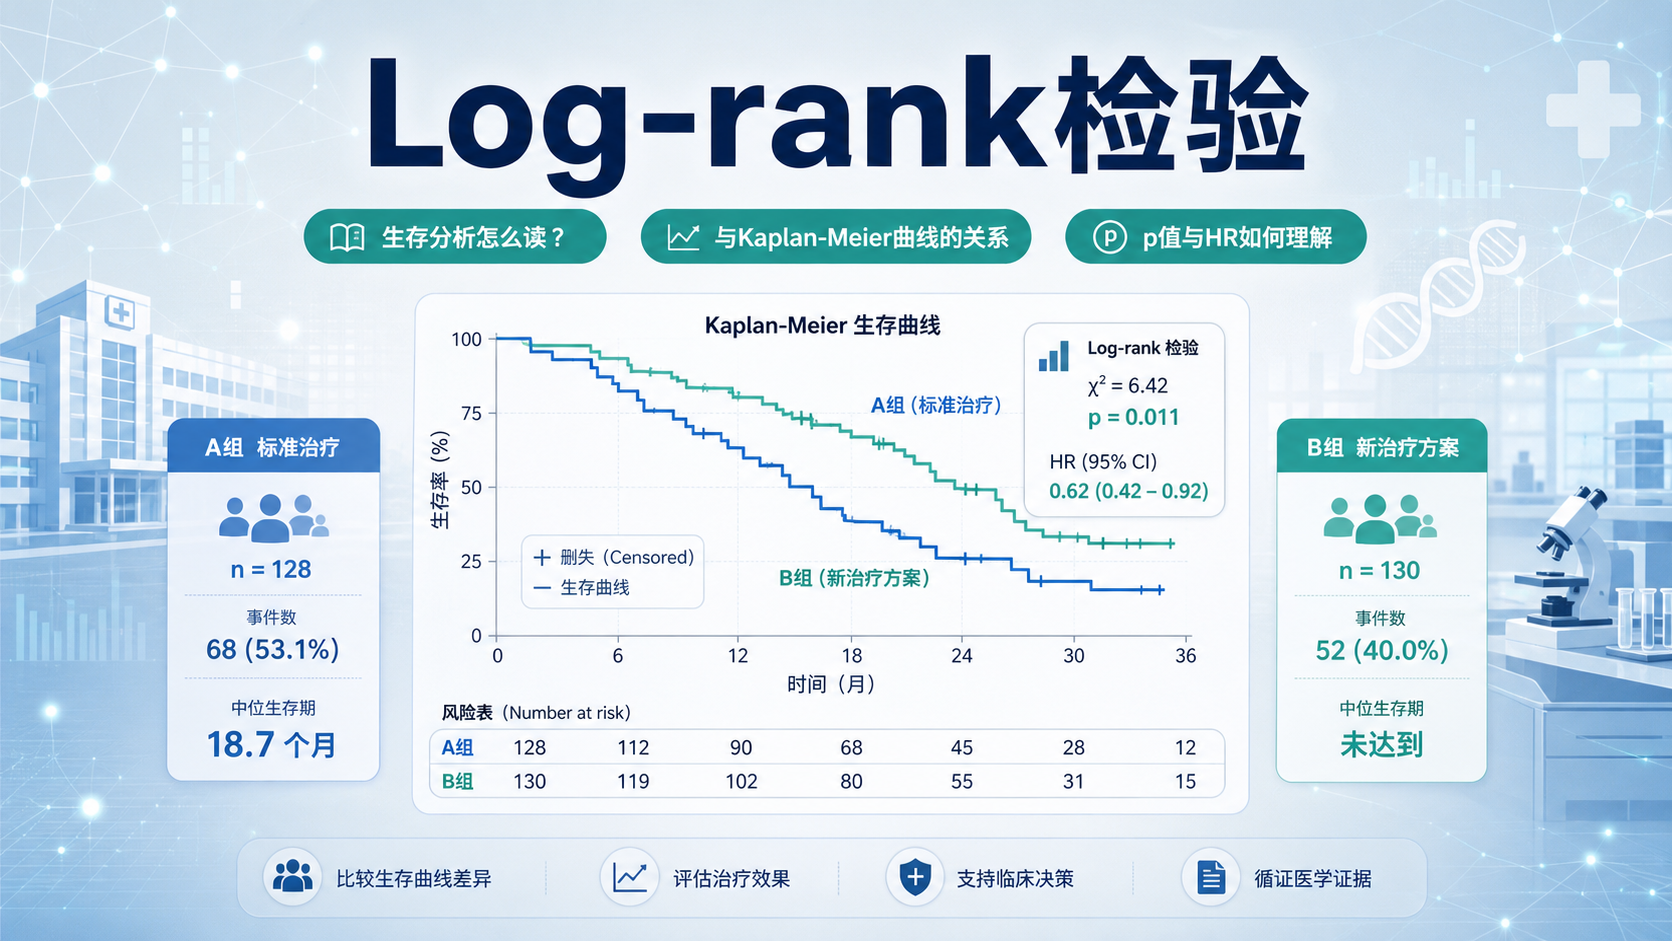
曲线能直观看出两组生存概率随时间变化的趋势,Log-rank检验则给出这种差异是否具有统计学意义。
换句话说,KM曲线看形态,Log-rank检验看显著性。
如果只看P值,不看曲线,很容易忽略交叉、早期分离、后期重叠等关键现象。
2.结果中最先看的指标
2.1 P值怎么读
Log-rank检验结果里,最常见的就是P值。
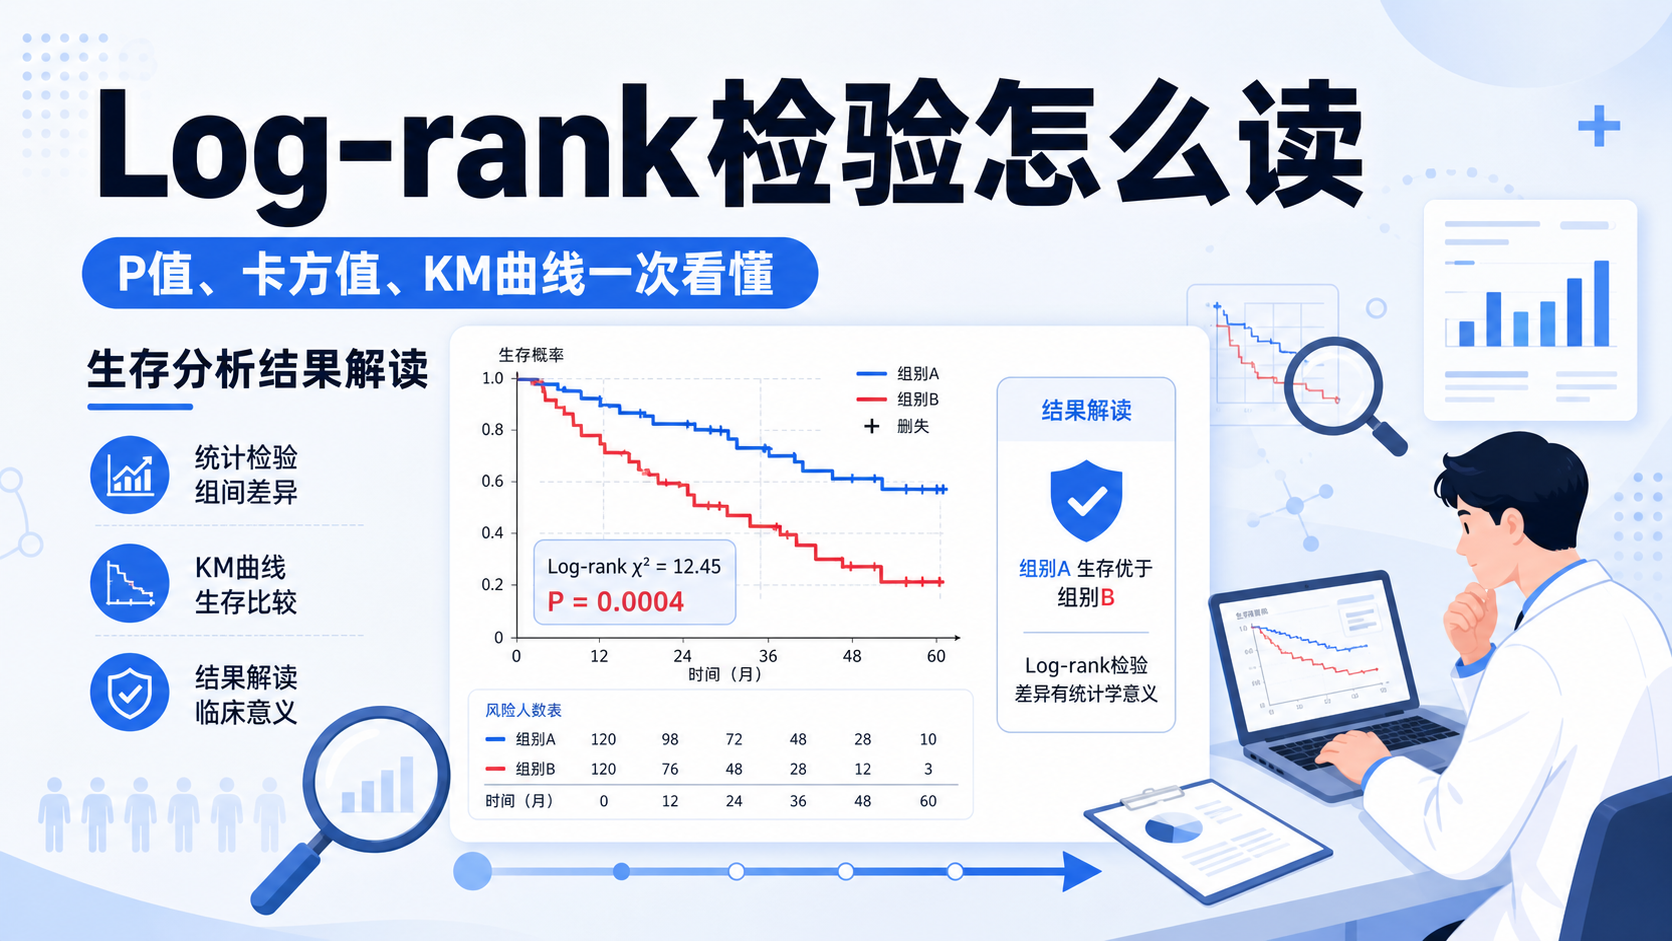
P值小于0.05,通常提示组间生存曲线差异有统计学意义。
但要注意,P值只说明“是否有差异”,不说明“差异有多大”,也不说明“谁更好”。
例如,两组曲线差异很大,但样本量太小,P值可能不显著。
相反,样本量足够大时,哪怕差异很小,也可能得到显著P值。
2.2 卡方值怎么读
很多软件会同时报告卡方值。
在Log-rank检验中,卡方值反映的是组间生存差异的统计量大小,P值则是其显著性结果。
一般来说,卡方值越大,提示两组生存差异越明显。
但卡方值本身不能单独解释临床意义,必须结合P值、曲线形态和效应量一起看。
2.3 组数不同,解读方式相同吗
两组比较和多组比较都可以用Log-rank检验。
但多组比较时,结果通常只告诉你“至少有一组不同”,并不会自动告诉你哪两组不同。
这时需要进一步做事后两两比较,或结合分层分析、Cox回归进行更深入判断。
不要把“整体显著”直接等同于“每两组都不同”。
3.只看P值,容易犯的3个错误
3.1 把统计学显著当成临床显著
这是最常见的问题。
P<0.05不等于有足够的临床价值。
临床上更应该关注差异幅度。
如果两组中位生存期只差几天,即便P值显著,也未必有实际决策意义。
反过来,如果差异很大但未显著,可能提示样本量不足或随访时间不够。
3.2 忽略曲线交叉
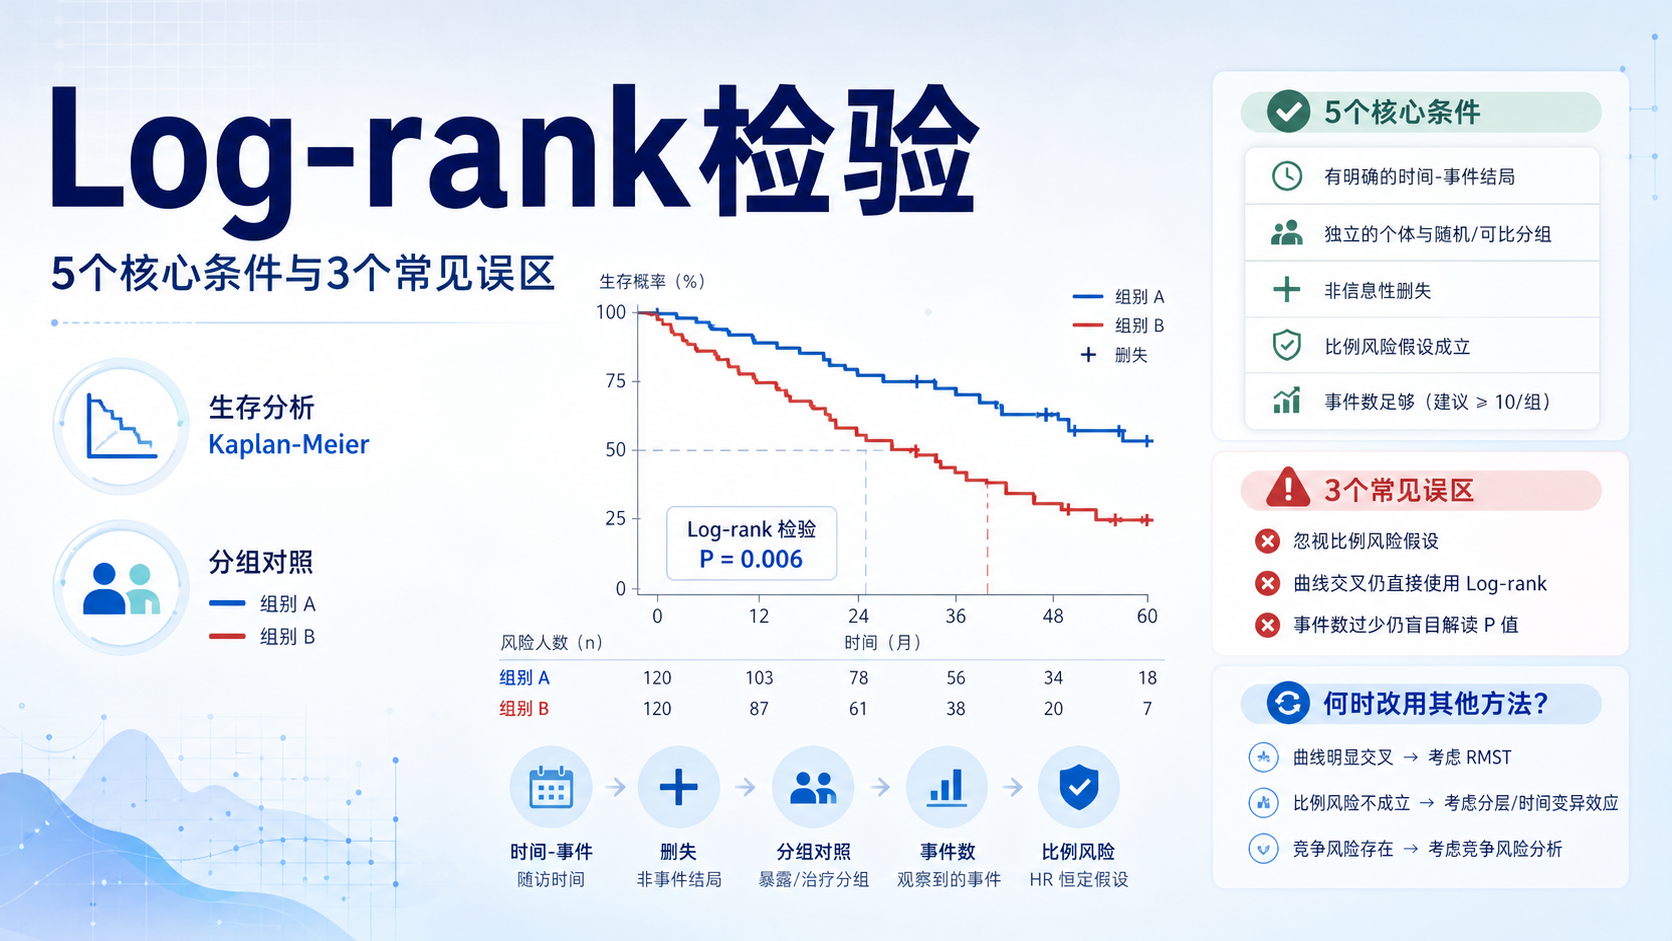
Log-rank检验默认两组风险差异在整个随访期内相对稳定。
如果KM曲线明显交叉,这个前提可能被破坏。
曲线交叉时,单纯依赖Log-rank检验容易低估或误判真实差异。
这种情况需要进一步考虑时间依赖效应、分段分析,或改用更合适的模型。
3.3 把“无显著差异”理解为“完全没有差异”
P>0.05不代表两组完全没有差异。
它只说明当前数据下,未能观察到足够证据支持差异存在。
常见原因包括:
- 样本量过小。
- 随访时间不足。
- 事件数太少。
- 分组方式不合理。
4.如何结合生存曲线做完整解读
4.1 先看曲线分离方向
解读结果时,第一步不是看P值,而是看曲线谁更高。
高的那条曲线代表更高的累积生存概率,也就是更好的生存结局。
例如,治疗组曲线始终高于对照组,说明治疗组生存更好。
如果高低组在早期分离、后期接近,需要考虑这种差异是否稳定。
4.2 再看中位生存期
如果KM曲线能估计中位生存期,就应纳入解读。
中位生存期能帮助读者理解绝对差异,而不是只停留在“显著或不显著”。
但要注意,不是所有数据都能顺利计算中位生存期。
如果随访不足,曲线未降到50%,中位生存期可能无法估计。
4.3 最后看删失情况和风险表
风险表能告诉你各时间点仍处于随访中的人数。
如果后期风险集人数很少,曲线末端的波动就要谨慎解释。
尤其是随访后段的“看起来差很大”,有时只是因为样本数太少。
因此,结果解读不能只盯着曲线尾部。
5.标准结果应该怎么报告
5.1 推荐报告要素
一个规范的Log-rank检验结果,通常至少应包含以下内容:
- 分组方式。
- 生存终点,如总体生存、无进展生存。
- 卡方值。
- P值。
- 生存曲线方向。
- 是否存在曲线交叉。
如果条件允许,还应补充:
- 中位生存期。
- HR及95%CI。
- Cox回归结果。
5.2 写作时的常用表述
可以写成:
- KM曲线显示,两组患者生存结局存在差异,Log-rank检验P<0.05。
- 高表达组的生存概率低于低表达组,提示该指标可能与不良预后相关。
- 曲线在随访后期出现交叉,提示需进一步采用Cox模型或分层分析验证。
这些表达比单纯写“P<0.05”更完整,也更符合论文写作习惯。
6.从统计显著到临床解释
6.1 统计结果不等于因果关系
Log-rank检验只能说明组间生存曲线有差异,不能证明某因素导致了结局改变。
尤其在回顾性研究中,混杂因素可能非常多。
因此,Log-rank检验通常只是生存分析的第一步,不是结论的终点。
接下来往往需要Cox回归来判断是否为独立预后因素。
6.2 为什么要接着做Cox回归
KM曲线和Log-rank检验都属于单因素层面。
它们不能调整年龄、分期、治疗方式等混杂因素。
如果某变量在Log-rank检验中显著,但在多因素Cox回归中不显著,说明它可能不是独立预后因素。
反之,如果两者都显著,证据会更强。
6.3 适合医学生和科研人员的判断框架
你可以按这个顺序读结果:
- 看两组曲线是否分离。
- 看高低组谁的生存更好。
- 看P值是否显著。
- 看是否交叉。
- 看风险表是否支持末端结论。
- 结合Cox回归判断独立性。
这个流程比只看P值更接近真实科研决策。
7.解读时常见的研究场景
7.1 生物标志物高低表达分组
这是最常见的应用场景。
例如按基因表达中位数分为高低两组,再比较生存差异。
这种情况下,Log-rank检验可以初步提示该基因是否与预后相关。
但分组阈值是否合理,仍需进一步验证。
7.2 治疗组与对照组比较
在临床试验中,Log-rank检验常用于比较不同治疗方案的生存差异。
如果曲线明显分离,且P值显著,说明治疗可能带来生存获益。
不过,若研究是非随机设计,仍需警惕选择偏倚。
统计显著不代表证据等级足够高。
7.3 分层分析后的结果
有时整体分析不显著,但某个亚组显著。
这时要谨慎解释,避免过度解读。
亚组分析更容易出现偶然显著。
如果没有预设假设,亚组结果更适合用于生成假说,而不是直接下结论。
8.解螺旋如何帮助你把结果做对
8.1 从分析到发表的一体化支持
如果你在生存分析中经常遇到这些问题:
- 不会解读Log-rank检验结果。
- 不知道KM曲线怎么写论文结果。
- 不清楚如何把P值、HR、CI串起来。
- 不会把结果整理成规范表格和图注。
那么你需要的是一套能直接上手的研究支持工具。
解螺旋可以帮助你把生存分析结果从“会算”提升到“会写、会报、会发表”。
8.2 把碎片化结果变成规范表达
解螺旋围绕临床研究与生信分析常见场景,能帮助你更快完成:
- KM曲线绘制。
- Log-rank检验结果整理。
- Cox回归结果表达。
- 图表规范化呈现。
- 论文结果段落写作。
这对医学生、医生和科研人员尤其重要。
因为真正影响效率的,往往不是计算本身,而是结果整理和表达。
总结Conclusion
Log-rank检验是生存分析中最常见的组间比较方法,但它的价值不在于单独一个P值,而在于与KM曲线、中位生存期、风险表和Cox回归联动解读。
读结果时,先看曲线分离方向,再看P值和卡方值,最后判断是否存在交叉和混杂因素。这样才能避免误读。
如果你希望更高效地完成生存分析结果整理、论文图表输出和规范化写作,可以进一步了解解螺旋 ,把复杂的分析流程变成可复用的科研路径。

- 引言Introduction
- 1.Log-rank检验是什么
- 2.结果中最先看的指标
- 3.只看P值,容易犯的3个错误
- 4.如何结合生存曲线做完整解读
- 5.标准结果应该怎么报告
- 6.从统计显著到临床解释
- 7.解读时常见的研究场景
- 8.解螺旋如何帮助你把结果做对
- 总结Conclusion