29
 分享
引言Introduction
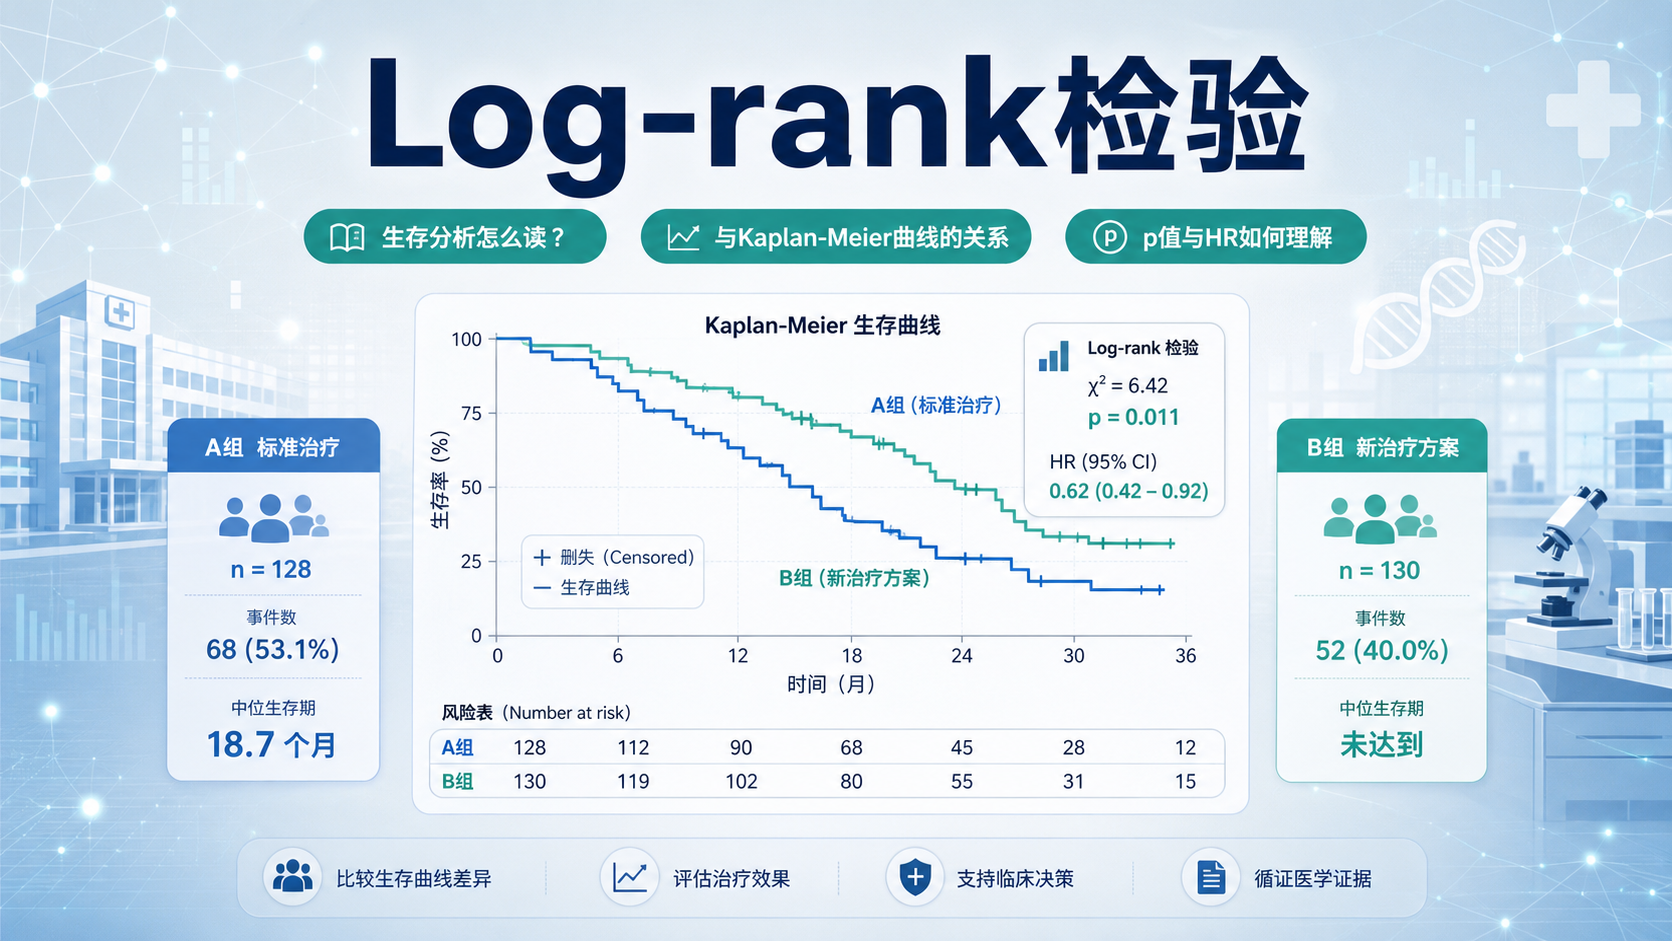
在生存分析中,很多研究不是“有没有差异”,而是“谁活得更久”。Log-rank检验正是比较两组或多组生存曲线差异的核心方法 。但不少医学生和科研人员常卡在三点:原理看不懂、统计量不会解释、临床结果不会写。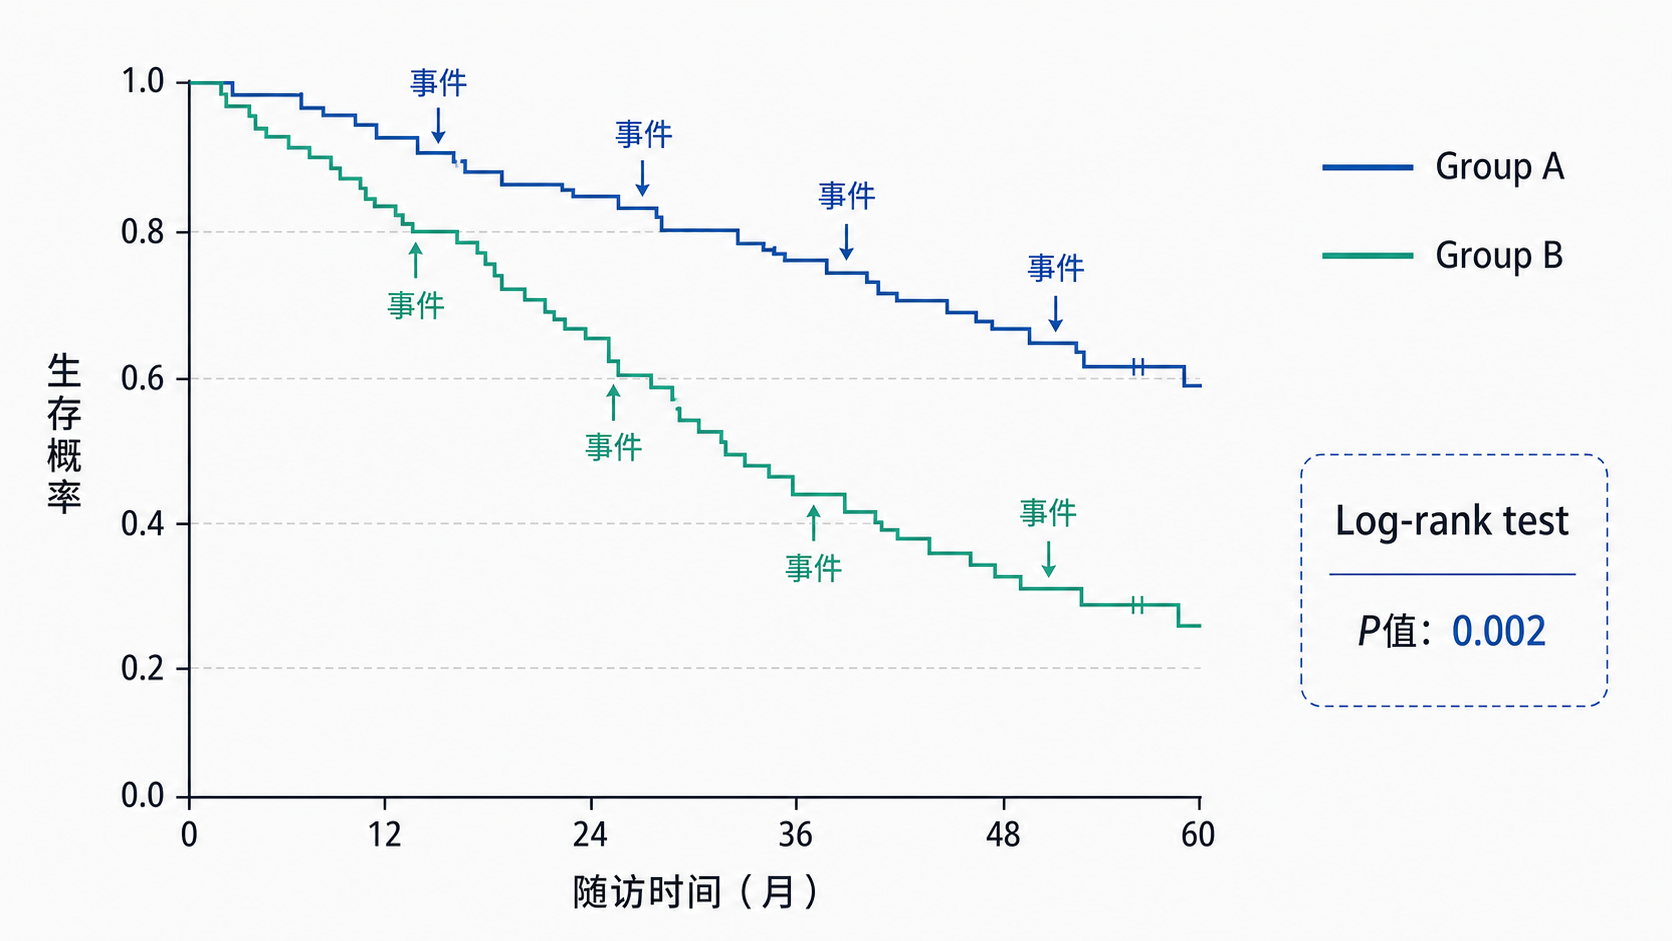
1.Log-rank检验是什么
1.1 它解决的核心问题
Log-rank检验用于比较不同组别的生存曲线是否存在统计学差异。这里的“生存”不只指死亡,也可以是复发、进展、失访前时间等结局。只要结局是时间到事件数据,并且存在删失数据,就属于它的典型应用场景 。
它本质上是在每一个事件发生时点,比较“实际观察到的事件数”和“理论上期望的事件数”。如果两组在整个随访过程中差异持续存在,Log-rank检验就更容易检出差别。
1.2 它与Kaplan-Meier曲线的关系
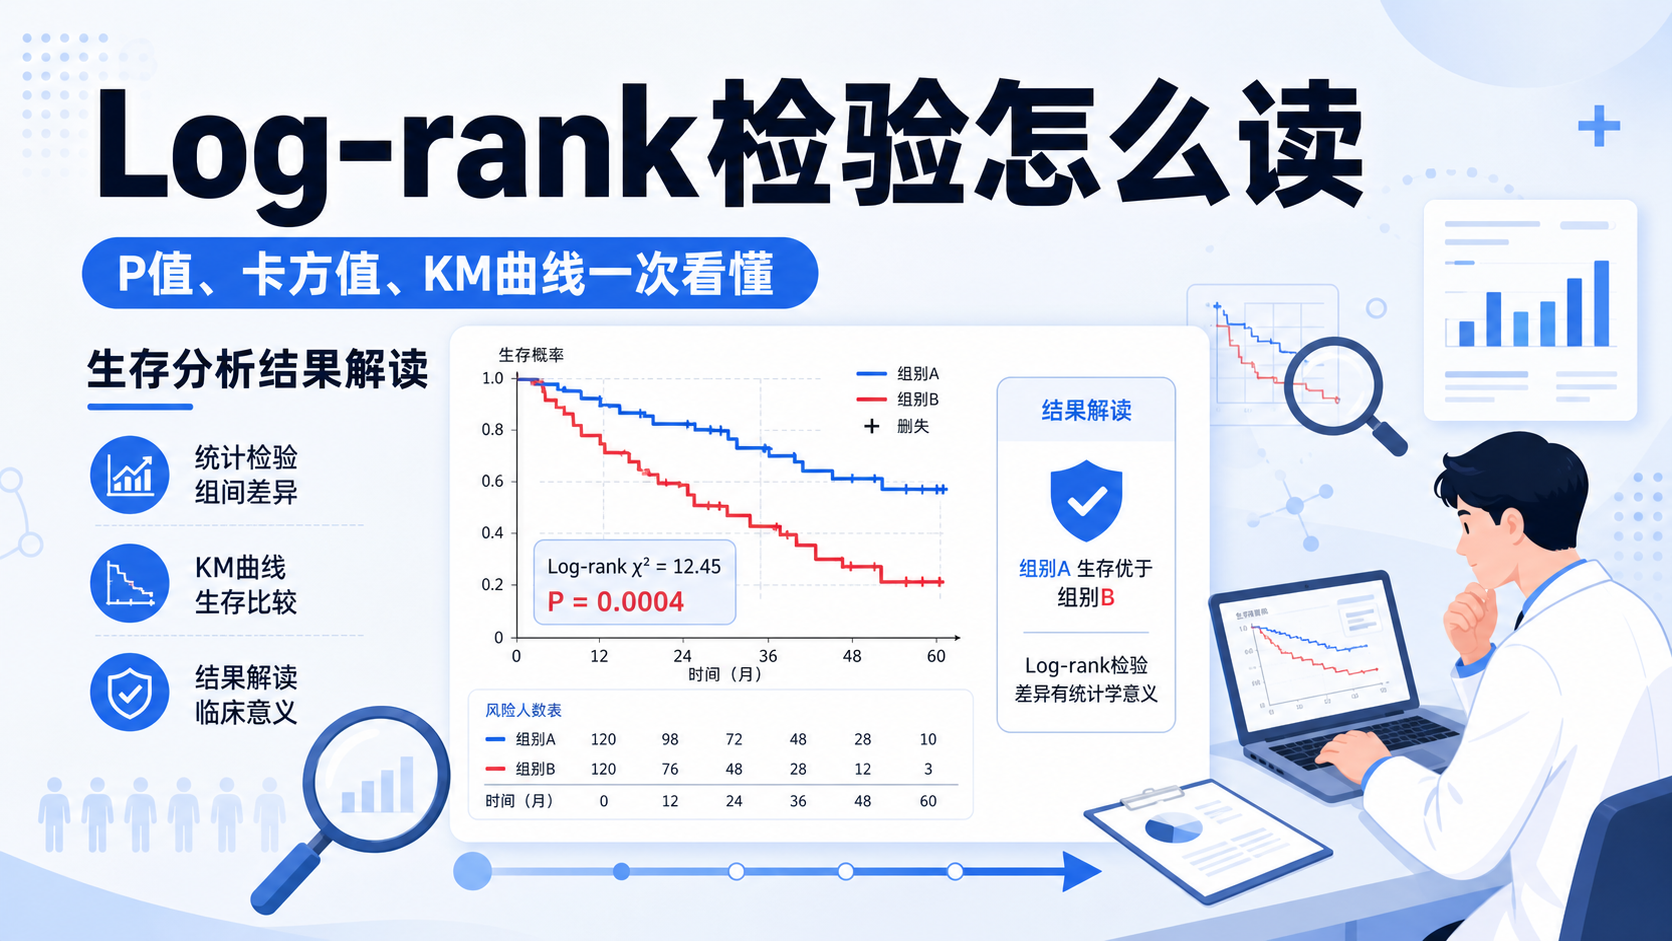
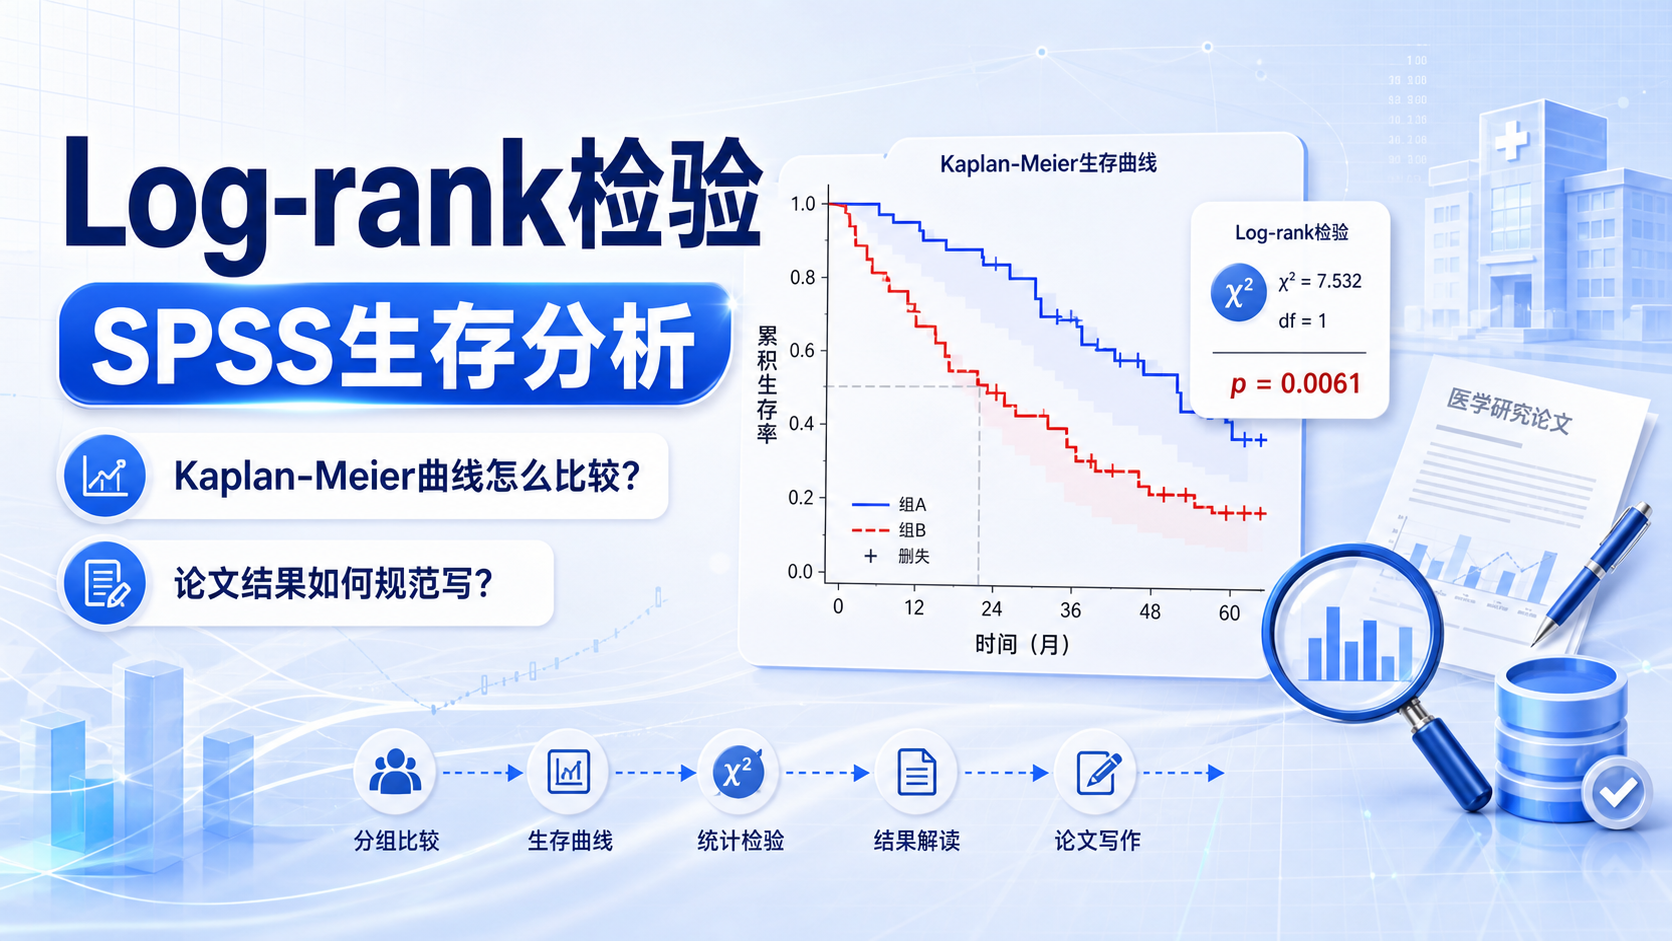
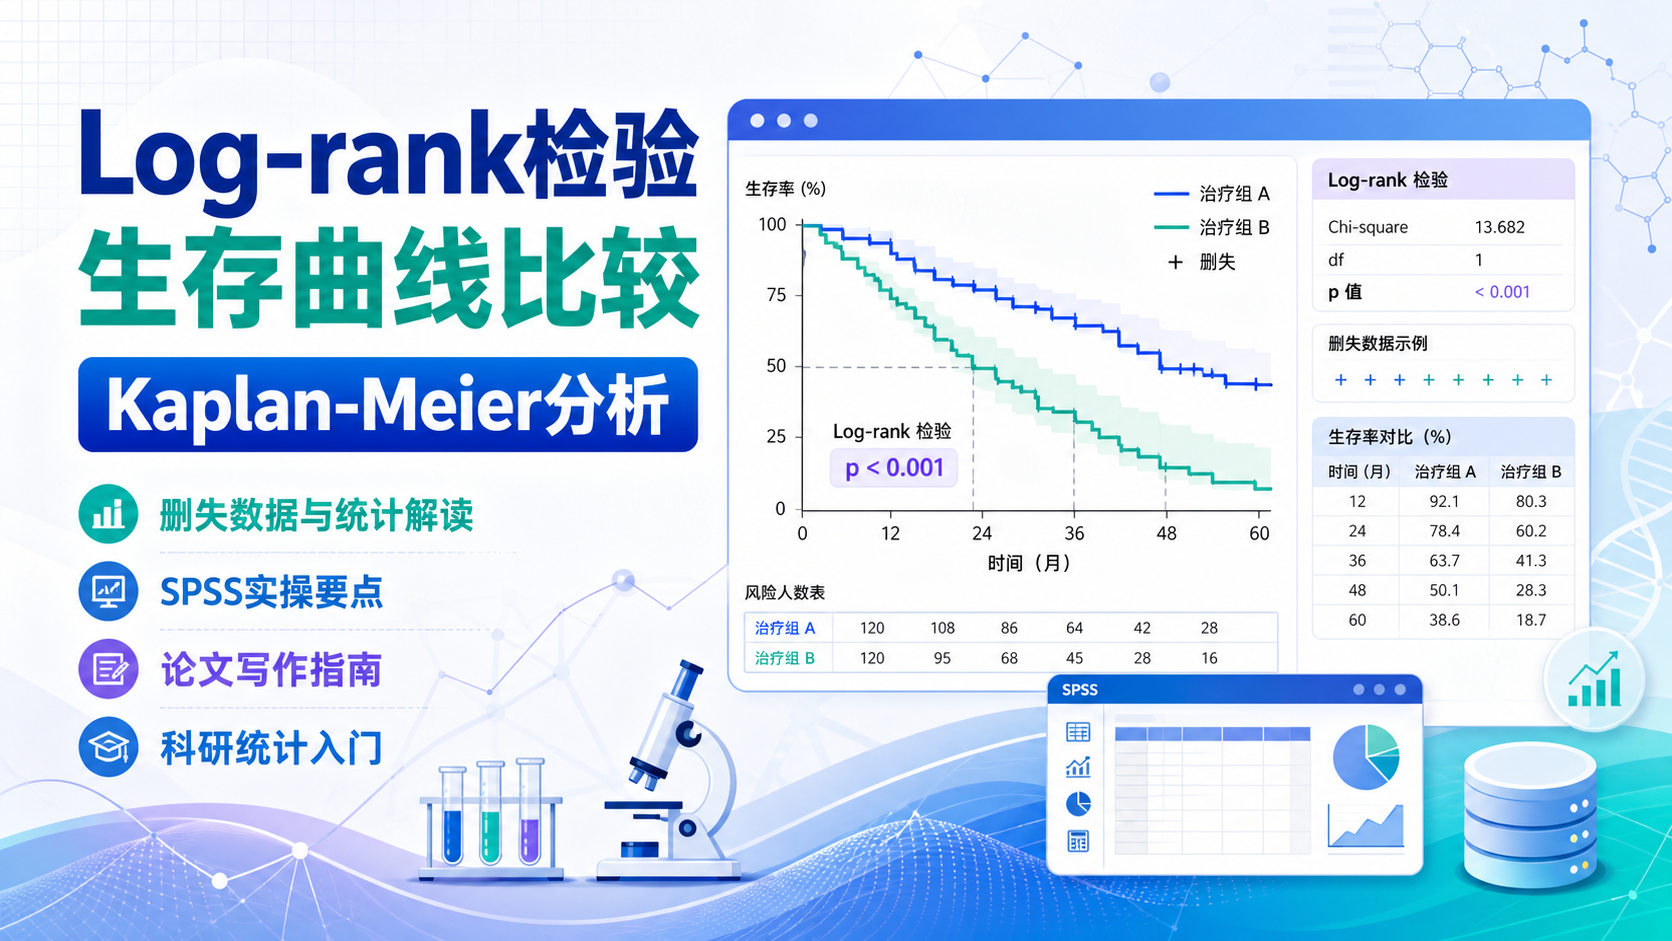
在论文中,Log-rank检验常和Kaplan-Meier曲线同时出现。前者回答“差异是否显著”,后者展示“差异如何变化”。曲线看趋势,Log-rank给结论 。这是生存分析中最常见的组合。
需要注意的是,曲线分开并不一定代表统计学显著。样本量小、删失多、随访短,都可能导致视觉差异明显,但p值不显著。反过来,曲线差距不大,也可能因为样本量足够而显著。
2.Log-rank检验的统计学原理
2.1 基本思想:观察值和期望值的比较
Log-rank检验属于非参数检验。它不要求生存时间服从正态分布。其核心思想是:在每个事件时间点,计算各组的事件观察数O和期望数E,再把全程的差异累加。
如果某组在多个时点都发生了“事件数高于期望值”的情况,说明该组生存更差。若“事件数低于期望值”,则提示该组生存更好。
2.2 统计量是怎么来的
Log-rank检验的统计量通常近似服从卡方分布。对于两组比较,常见形式可理解为:
- 先计算每个事件时点各组的期望事件数。
- 再把所有时点的观察值减期望值进行累加。
- 用累积差异与其方差标准化后,得到卡方统计量。
统计量越大,说明组间生存差异越明显。
随后根据卡方分布得到p值。若p<0.05,通常认为两组生存曲线差异有统计学意义。
2.3 为什么它适合生存数据
生存数据有两个关键特点。
第一,结局是“时间到事件”。
第二,存在删失,即随访截止时部分受试者尚未发生事件。
Log-rank检验能自然处理删失数据。未发生事件但仍在随访中的个体,在其最后一次可观察时点之前都会被纳入风险集。这也是它比简单均值比较更适合临床随访资料的原因。
3.适用条件与常见前提
3.1 适用场景
Log-rank检验适合以下情形:
- 比较两组或多组生存曲线。
- 结局为时间到事件数据。
- 存在删失。
- 关注整个随访期间的总体差异。
临床研究中,常见于总生存期、无进展生存期、无病生存期、复发时间等终点。
3.2 重要前提:风险比例大致恒定
Log-rank检验对“比例风险”更敏感。也就是说,它最适合比较两组风险差异在整个随访期间相对稳定的情况。如果两条曲线早期交叉、后期反向,Log-rank检验的效能可能下降。
这时不能只看p值,还要结合曲线形态、HR估计、分层分析或其他模型进一步判断。
3.3 常见误区
有些人把Log-rank检验当成“比较平均生存时间”的方法,这是不准确的。它比较的是整个生存分布是否不同,不是简单比较均值。
还有人认为样本量越大越好。其实如果事件数太少,即使总样本不少,检验效能也可能不足。
4.如何理解Log-rank检验结果
4.1 结果通常报告什么
在论文中,Log-rank检验常报告以下内容:
- 卡方值,χ²。
- 自由度,通常为1或组数减1。
- p值。
- 必要时配合中位生存时间。
例如可以写成:两组Kaplan-Meier曲线比较,Log-rank检验显示差异有统计学意义,χ²=6.42,p=0.011。
4.2 p值代表什么
p值反映的是:如果原假设成立,即各组生存曲线无差异,那么当前观察到的差异有多不容易出现。
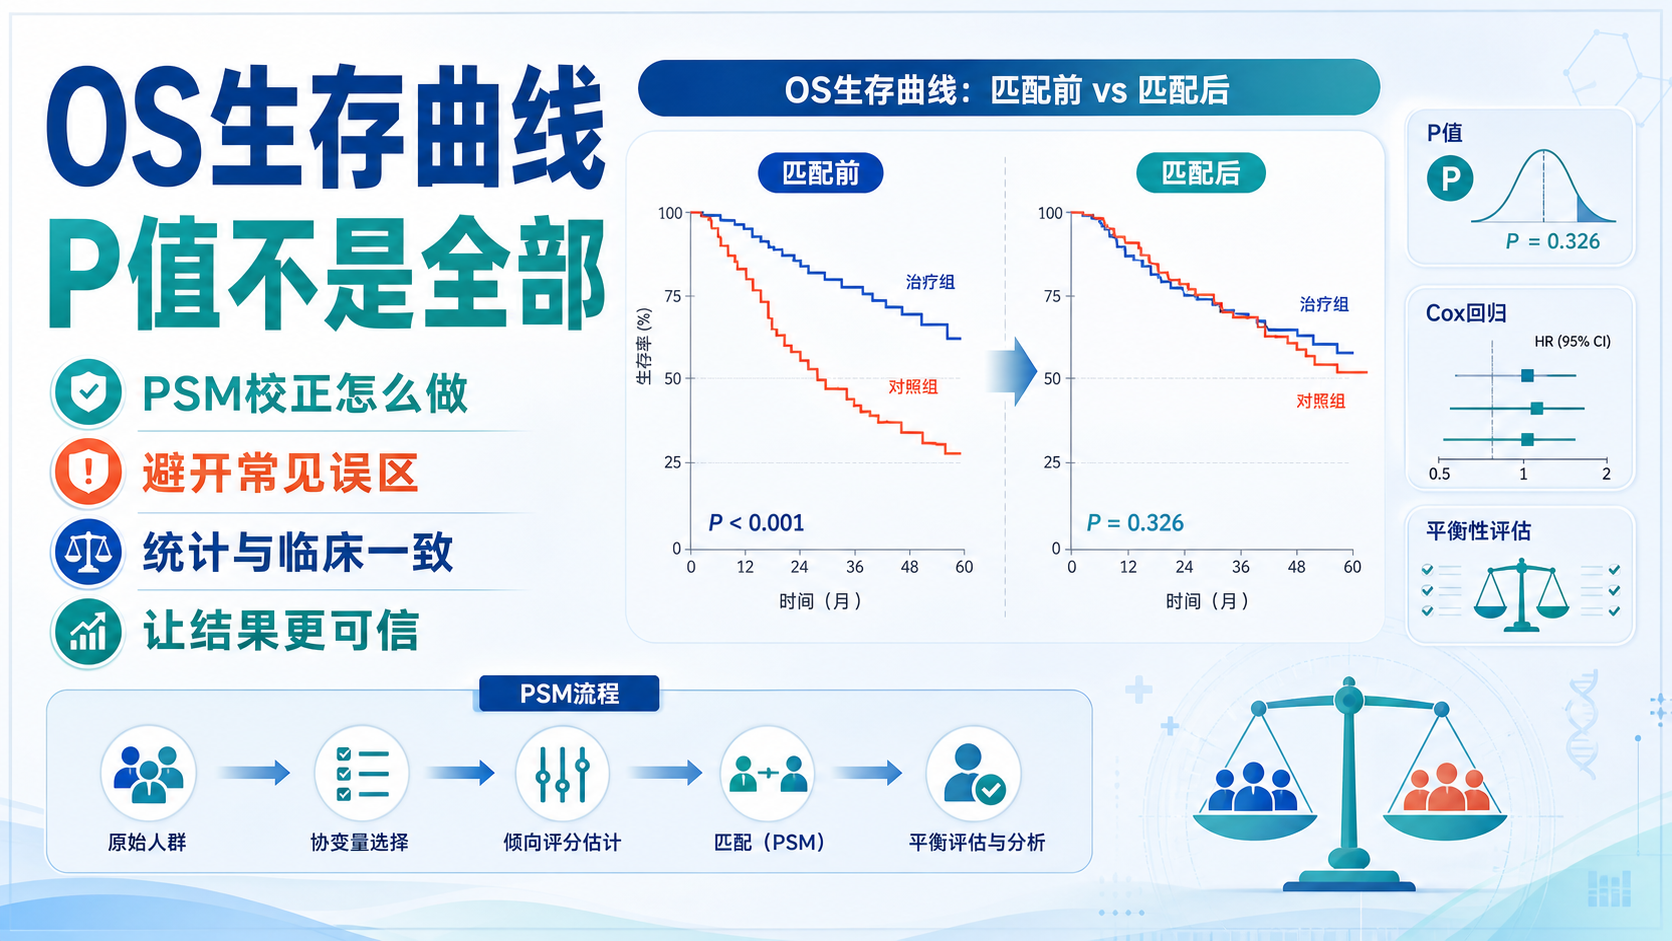
p<0.05只说明“统计学显著”,不等于“临床必然重要”。
临床意义还要看风险下降幅度、绝对获益、治疗负担和安全性。
4.3 与HR的区别
Log-rank检验回答的是“是否存在差异”。
Cox回归更进一步,回答“差异有多大”。通常会给出HR及95%CI。
- Log-rank偏向组间总体比较。
- Cox回归偏向效应量估计和协变量调整。
在临床论文中,两者经常一起使用。先做曲线和Log-rank,再做Cox回归,是非常常见的分析路径。
5.临床研究中如何正确使用
5.1 典型分析流程
一个规范的生存分析通常包括以下步骤:
- 明确终点事件。
- 绘制Kaplan-Meier曲线。
- 使用Log-rank检验比较组间差异。
- 必要时进一步做Cox回归。
- 报告HR、95%CI、p值及中位生存时间。
如果研究目标是“比较两组预后”,Log-rank检验通常是第一步。
5.2 什么时候不能只用Log-rank
如果研究有多个混杂因素,如年龄、分期、治疗方式、合并症等,单纯Log-rank检验不足以控制混杂。此时应进入多因素Cox模型。
如果曲线明显交叉,也要谨慎。因为此时总体差异可能被抵消,导致Log-rank不敏感。
5.3 一个临床理解例子
假设比较两种术后辅助治疗对肺癌无进展生存期的影响。
两组随访中都存在删失。研究者先画出Kaplan-Meier曲线,再用Log-rank检验。若p<0.05,可初步认为两种方案的生存结局不同。
但若想判断治疗本身是否独立影响预后,还需要进一步纳入分期、年龄、吸烟史等因素做Cox回归。
6.与其他检验方法的区别
6.1 与t检验、方差分析不同
t检验和方差分析主要用于计量资料,关注均值差异。
Log-rank检验处理的是生存时间和删失数据。数据类型不同,方法就不能混用。
6.2 与卡方检验不同
卡方检验适用于计数资料或分类资料,比较比例差异。
Log-rank检验虽也使用卡方分布形式的统计量,但它分析的是生存事件时间,不是简单的分类频数。
6.3 与Wilcoxon检验的区别
有些软件中还可见Peto-Peto、Breslow或Wilcoxon类生存检验。这些方法对早期事件更敏感。
Log-rank检验对整个随访区间权重更均衡,因此是最常用的标准方法 。
7.写论文时要注意什么
7.1 结果表述要规范
建议写清以下信息:
- 研究终点。
- 分组方式。
- 生存曲线比较方法。
- χ²值和p值。
- 是否进一步做了Cox回归。
例如:Kaplan-Meier分析显示,两组无病生存期存在差异,Log-rank检验χ²=5.87,p=0.015。
7.2 不要忽略删失信息
删失是生存分析的关键。如果不说明删失比例、随访中位时间,读者很难判断结论可靠性。
删失过多时,Log-rank检验的稳定性会下降。
7.3 关注事件数,而不只是样本数
生存分析更看重事件数。样本量大但事件少,统计效能可能仍然不足。
这是很多初学者最容易忽略的地方。
8.从学习到实战,如何提高分析效率
对于医学生和科研人员来说,真正难点往往不是“听懂原理”,而是“在自己的项目中选对方法、写对结果”。Log-rank检验原理看似简单,但涉及终点定义、删失处理、曲线解读和结果表达,任何一步出错都可能影响论文质量。
如果你正在准备临床回顾性研究、队列研究或生存分析文章,建议把统计流程、变量选择和结果表述提前规范化。解螺旋 提供面向临床科研的写作与统计支持思路,能帮助你更快完成数据整理、方法选择和结果呈现,减少反复返工,把时间留给真正重要的研究问题。
总结Conclusion
Log-rank检验是生存分析中的基础方法。它通过比较各组在不同时间点的观察事件数和期望事件数,判断生存曲线是否存在总体差异。它适合时间到事件数据,也适合存在删失的临床随访资料。
在实际研究中,Log-rank检验常与Kaplan-Meier曲线、Cox回归联合使用。前者看差异,后者看效应量。写作时要规范报告χ²值、p值、删失情况和临床意义。若你希望进一步提升生存分析论文质量,可以借助解螺旋 ,把统计方法选择和结果呈现做得更专业。

- 引言Introduction
- 1.Log-rank检验是什么
- 2.Log-rank检验的统计学原理
- 3.适用条件与常见前提
- 4.如何理解Log-rank检验结果
- 5.临床研究中如何正确使用
- 6.与其他检验方法的区别
- 7.写论文时要注意什么
- 8.从学习到实战,如何提高分析效率
- 总结Conclusion