11
 分享
引言Introduction
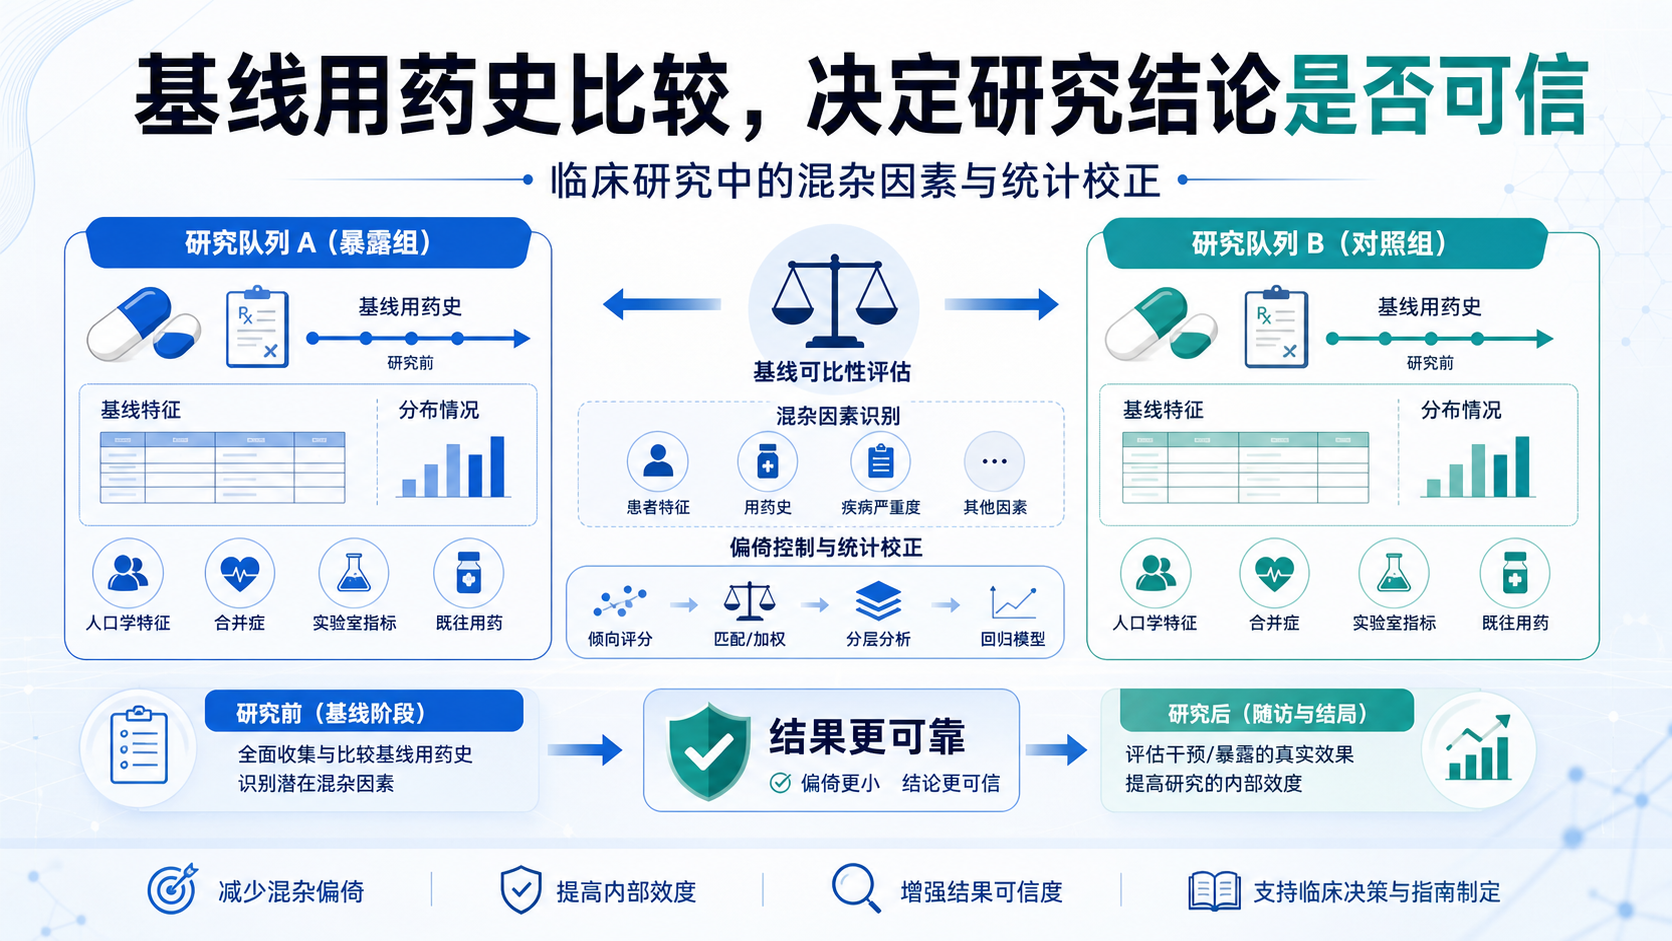
临床研究里,很多“结果不一致”并不是药物本身没效,而是两组基线用药史不一样 。这会直接影响结局、混杂分析和论文可信度。对医学生、医生和科研人员来说,先把基线用药史比较做好,往往比盲目追求复杂统计更重要。
1. 基线用药史为什么是临床研究的核心变量
1.1 它不是背景信息,而是潜在混杂因素
基线用药史不是简单的“既往史记录”。它可能直接改变患者的病程、实验室指标、症状评分和终点事件发生率。
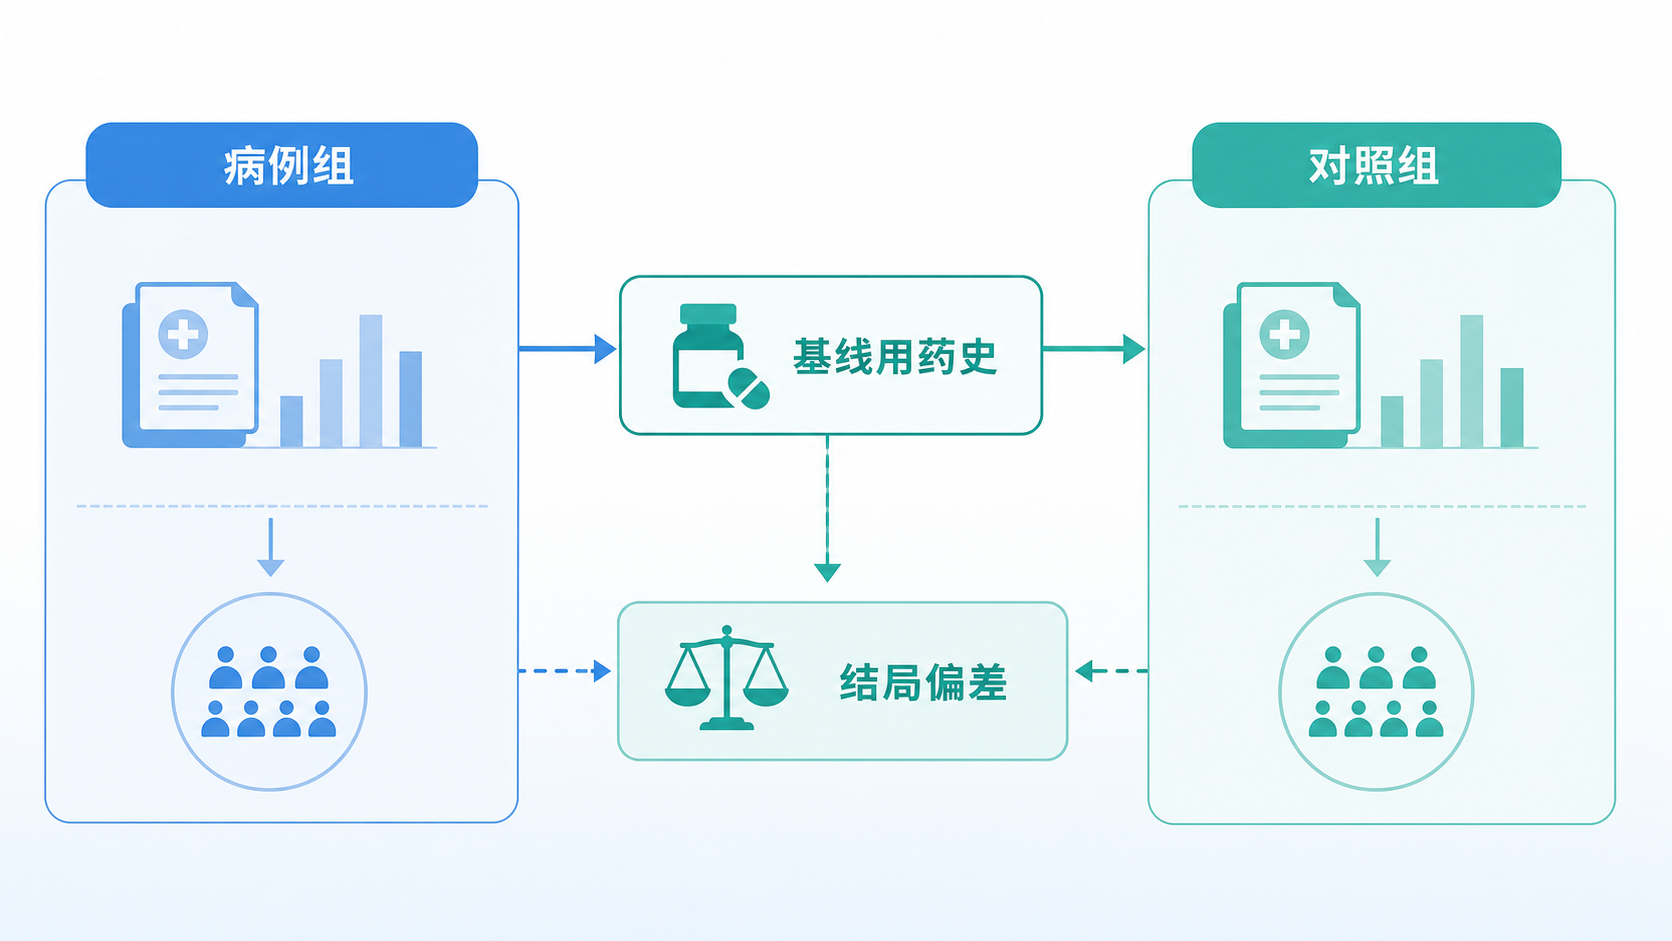
例如,高血压研究中,降压药、利尿剂、他汀、抗血小板药都可能影响血压波动、炎症水平和心血管结局。若两组在入组前的用药结构不同,后续比较就不再纯粹。
1.2 基线不平衡会让结果“看起来有差异”
临床研究最怕的不是无差异,而是假差异 。
如果病例组长期使用糖皮质激素,而对照组没有,后续比较骨密度、血糖、感染率时,结论可能被药物史严重干扰。
同样,如果两组在使用抗凝药、免疫抑制剂、PPI、NSAIDs方面不平衡,很多结局都会被放大或掩盖。
1.3 研究设计阶段就要预判药物影响
基线用药史比较必须在研究设计前就想清楚。
不要等数据收集完才发现某类药物是关键混杂因素。更好的做法是:
- 先明确主要结局。
- 再列出可能影响结局的既往药物。
- 最后决定纳入、排除、分层或匹配策略。
2. 基线用药史比较如何改变研究结论
2.1 影响疗效判断
在疗效研究中,既往用药会影响初始疾病状态和治疗反应。
比如,已有长期降脂治疗史的患者,基线 LDL-C 可能更低,后续降脂幅度也可能不同。
这会导致同样的治疗方案,在不同基线用药史人群中表现出不同效果。
2.2 影响安全性判断
安全性终点对基线药物更敏感。
例如:
- 抗凝药史会影响出血风险。
- 肝毒性药物史会影响转氨酶变化。
- 肾毒性药物史会影响肌酐和 eGFR。
如果研究没有控制这些基础用药,安全性信号可能被误判。不是研究药物更安全,而是对照组本来就更“干净”。
2.3 影响预后和生存分析
在队列研究中,既往用药往往与基础疾病严重程度相关。
例如,使用胰岛素、双联抗血小板、免疫抑制剂,常提示病情更重。
如果不校正,生存分析中的 HR 很可能偏离真实值。
因此,基线用药史比较不是附属表格,而是决定模型是否可信的前提。
3. 研究中如何规范进行基线用药史比较
3.1 先定义“用药史”的时间窗口
必须明确记录窗口。常见做法包括:
- 入组前 7 天。
- 入组前 30 天。
- 入组前 3 个月。
- 入组前 6 个月。
时间窗不同,结果会完全不同。
短窗口更适合急性研究,长窗口更适合慢病或暴露累积研究。没有统一时间窗,基线比较就不可重复。
3.2 记录到足够细的药物层级
不要只写“有用药”或“无用药”。
至少要区分:
- 药物类别,如降压药、降糖药、抗凝药。
- 具体药名。
- 剂量。
- 使用频率。
- 是否联合用药。
- 是否长期连续使用。
对于回顾性研究,常见问题是病历写了“口服药物”,却没法判断真正暴露强度。此时结论会明显变弱。
3.3 统一编码,便于统计
在数据表中,建议把药物史分成清晰变量:
- 二分类变量:有/无。
- 多分类变量:未用、单药、联合用药。
- 连续变量:药物数量、累计用药时间。
变量编码越规范,后续统计越稳。
这也是很多论文能否顺利完成回归分析的基础。
4. 基线用药史比较时最常见的4个错误
4.1 只比较“有没有用药”,不看药物类别
不同药物作用完全不同。
把所有药物混成一个变量,几乎没有解释力。
例如,阿司匹林和激素不能归为同一层次去比较。
4.2 忽略联合用药
真实临床中,患者常常不是单药。
联合用药本身就是疾病严重程度和治疗策略的信号。
如果只统计单药史,不统计联用史,混杂会被低估。
4.3 忽略药物持续时间
短期服药和长期服药的影响不可等同。
临床研究里,药物暴露强度通常比“是否用过”更重要。
这在慢病、肿瘤、风湿免疫和神经系统研究中尤其明显。
4.4 只做P值,不看临床意义
基线比较不是为了机械追求P值大于0.05。
样本量足够大时,微小差异也可能显著。
更合理的做法是同时看:
- 差异方向。
- 效应量。
- 标准化差异。
- 临床可解释性。
P值不显著,不代表没有偏倚。
5. 在统计分析中如何处理基线用药史不平衡
5.1 优先考虑设计阶段控制
最好的控制发生在分析前。
常用方法包括:
- 随机分组。
- 分层随机。
- 匹配。
- 限制性纳入。
- 分中心同步招募。
如果能在设计阶段减少药物史差异,后续统计压力会小很多。
5.2 回归模型校正
当基线用药史不可避免不平衡时,可以在模型中纳入协变量。
比如逻辑回归、Cox 回归、线性回归都可以加入药物史变量。
但前提是变量质量够高。垃圾进,垃圾出。
如果药物史记录本身不完整,模型再复杂也救不了。
5.3 倾向评分方法
在观察性研究中,倾向评分匹配、加权或分层常用于平衡基线。
但要注意,倾向评分只能平衡“已测量变量”。
对未记录的用药、OTC 药物、院外购药,仍然无能为力。
所以数据源越完整,方法越可靠。
5.4 分层分析更适合临床解释
如果某类药物是强混杂因素,建议分层分析。
例如按是否使用糖皮质激素、抗凝药、免疫抑制剂分层,往往比单纯总模型更能解释真实临床现象。
分层结果更接近临床思维。
6. 对回顾性研究和真实世界研究的特别提醒
6.1 病历数据必须先判断可用性
回顾性研究中,基线用药史常常来自病历、处方、护理记录和检查单。
如果这些来源不一致,就会出现信息偏差。
所以在正式统计前,先做数据核对非常重要。
6.2 研究对象要有可比性
两组患者如果来自不同医院、不同时间段,基线用药结构可能天然不同。
这时比较结果容易受地区诊疗习惯影响。
同源人群、同时间窗、同疾病阶段,才有比较价值。
6.3 基线用药史与疾病严重程度常常绑定
很多药物并不是“致病因素”,而是“病情标记”。
例如胰岛素、免疫抑制剂、利尿剂,经常提示更重的基础疾病。
所以解释结果时,不能只说“药物导致结局变化”,还要考虑“严重程度本身”的作用。
7. 写论文时,如何把基线用药史比较写得更专业
7.1 方法部分写清楚
建议明确写出:
- 药物史定义。
- 时间窗口。
- 记录来源。
- 分类标准。
- 统计方法。
例如,是否将入组前 3 个月内的处方记为暴露,是否包括院外用药,是否处理重复处方。
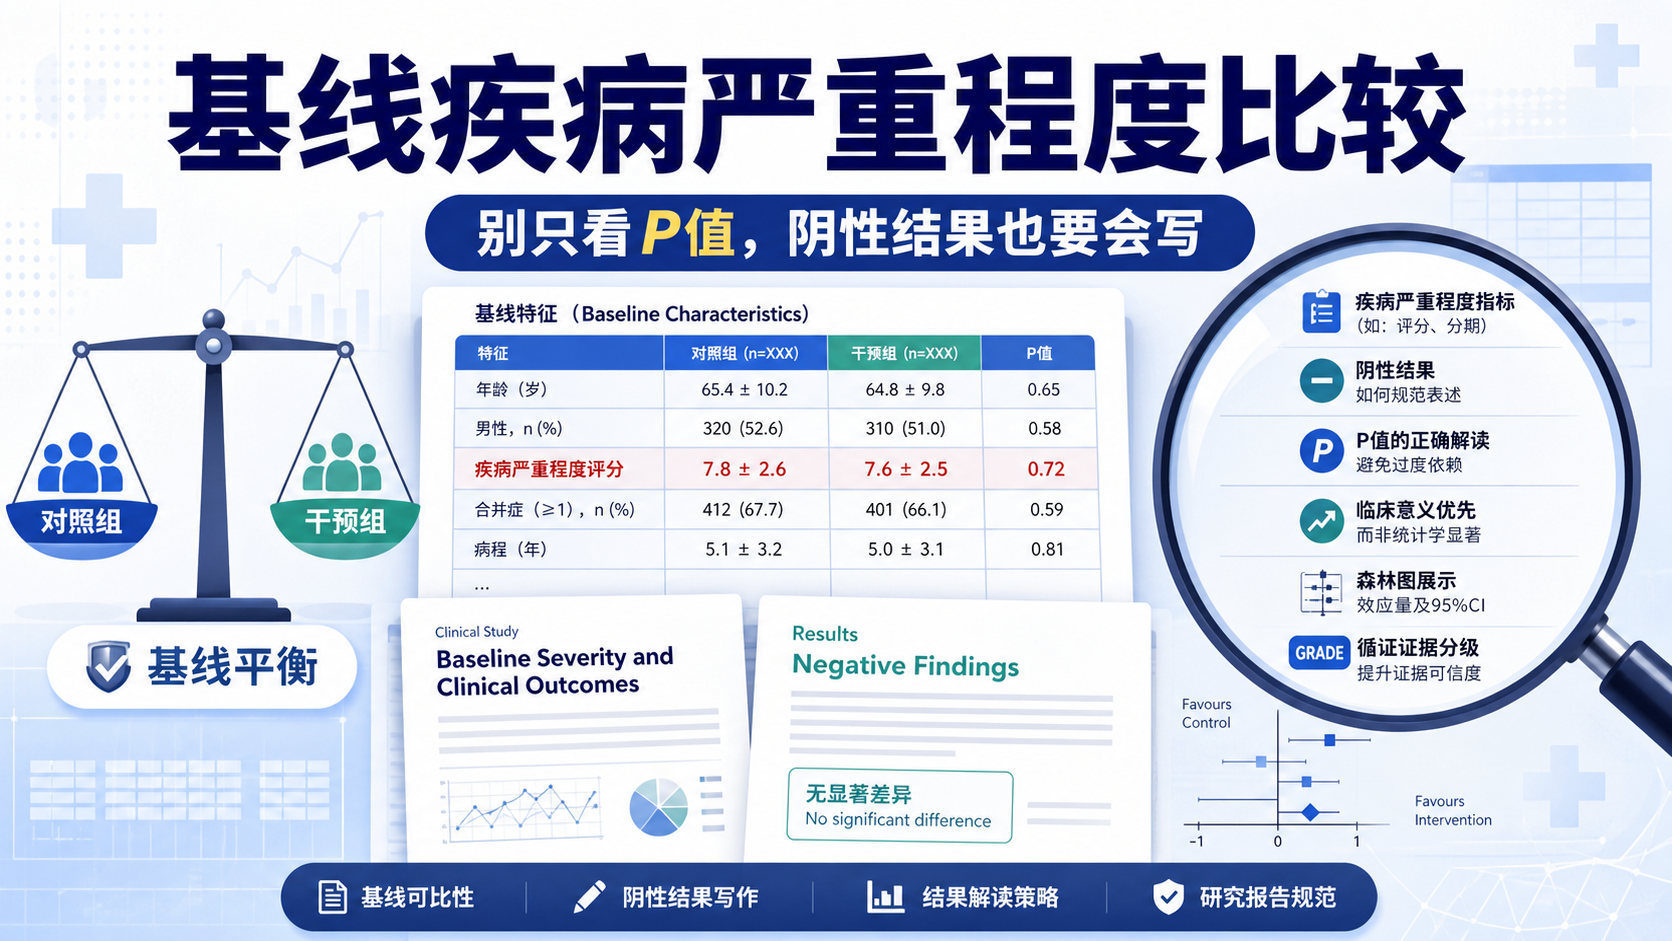
7.2 结果部分不要只列P值
更推荐同时呈现:
- 例数和百分比。
- 均值或中位数。
- 效应量。
- 标准化差异。
这样读者能更直观看到两组差别。
这比单纯堆砌显著性更有说服力。
7.3 讨论部分要解释偏倚来源
如果基线用药史不平衡,要主动讨论其对结果的影响。
不要回避。
高质量论文的特点,不是没有问题,而是能清楚解释问题为什么存在,以及如何控制。
8. 结论:真正决定比较质量的,是基线是否可比
临床研究中,基线用药史比较不是形式步骤,而是决定结论可信度的关键环节。
如果两组药物暴露结构不同,后面的疗效、安全性和预后比较都可能偏离真实世界。
因此,研究者应在设计、收集、编码和分析四个层面同时控制。
如果你正在做回顾性队列、病例对照或真实世界研究,建议从一开始就把基线用药史比较设计好,避免后期反复补救。需要更系统的数据整理、变量定义和论文结构支持,可以借助解螺旋 ,让研究从源头更规范,结果更可信。
- 引言Introduction
- 1. 基线用药史为什么是临床研究的核心变量
- 2. 基线用药史比较如何改变研究结论
- 3. 研究中如何规范进行基线用药史比较
- 4. 基线用药史比较时最常见的4个错误
- 5. 在统计分析中如何处理基线用药史不平衡
- 6. 对回顾性研究和真实世界研究的特别提醒
- 7. 写论文时,如何把基线用药史比较写得更专业
- 8. 结论:真正决定比较质量的,是基线是否可比