8
 分享
引言Introduction
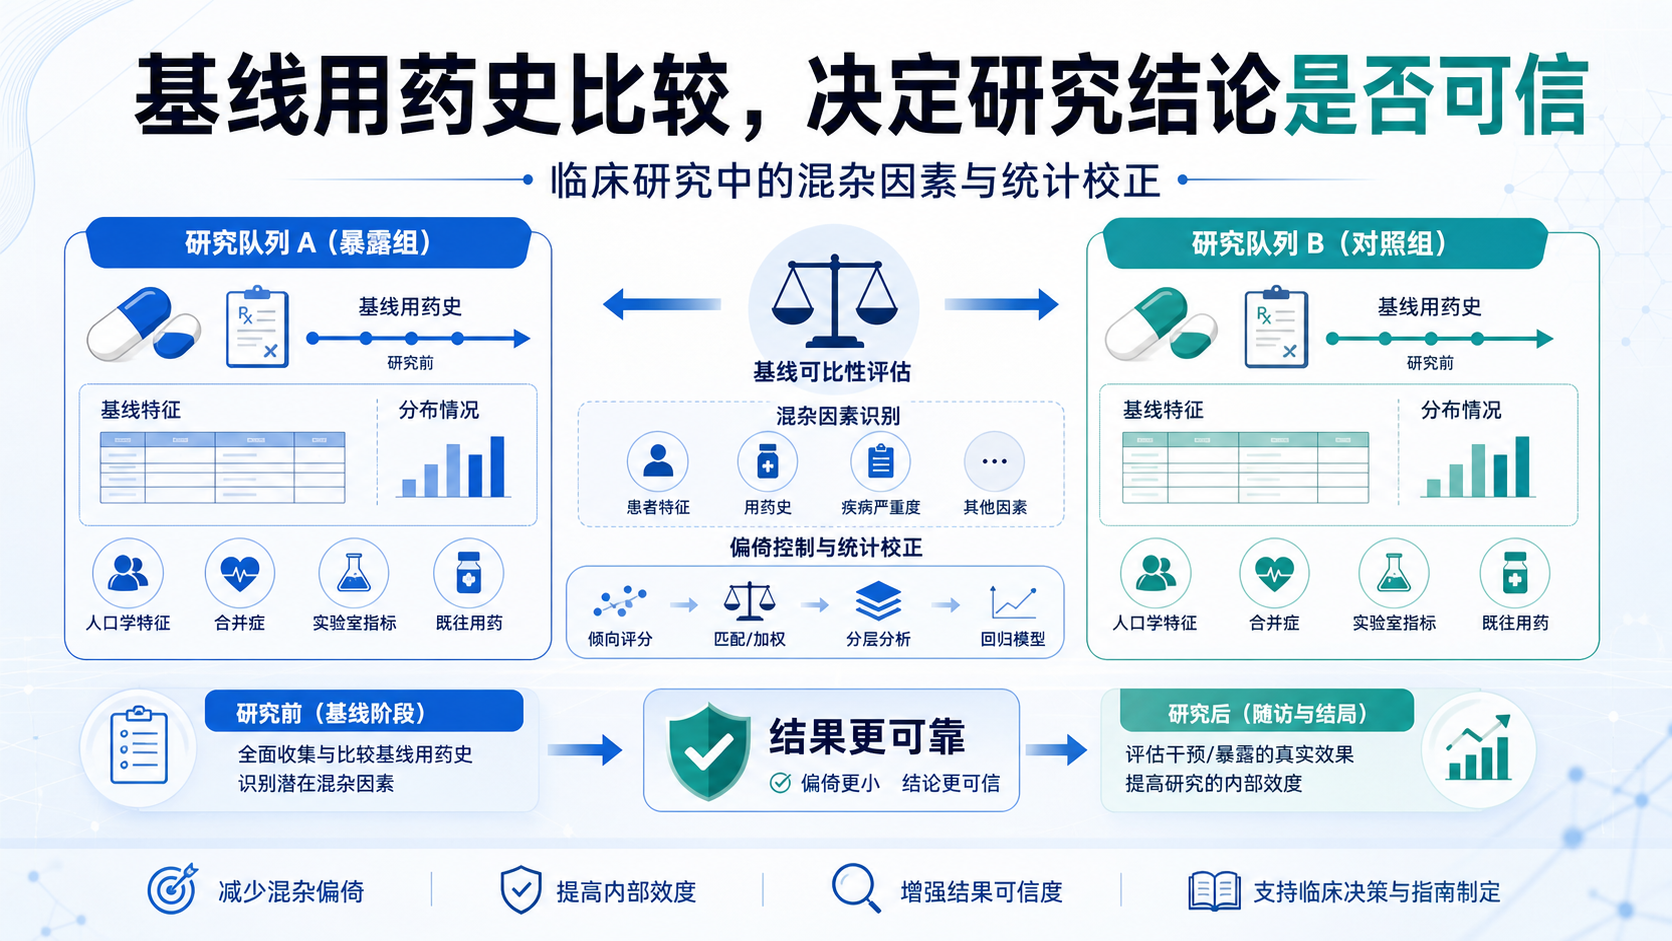
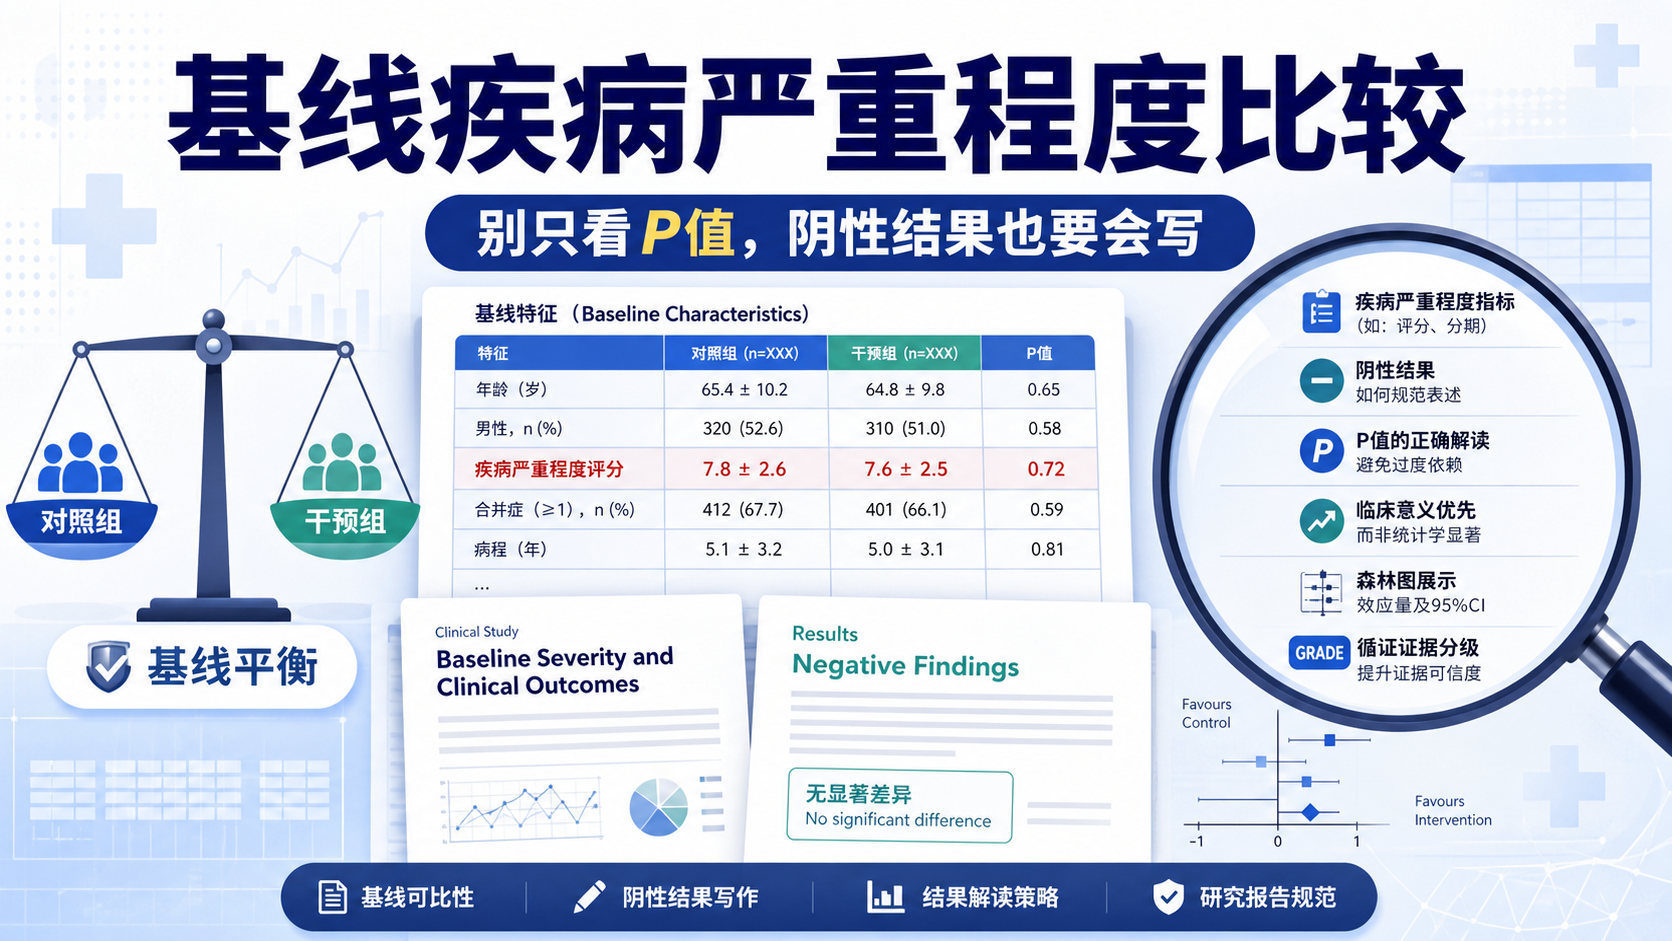
基线疾病严重程度比较,是RCT和队列研究里最容易被忽视,却最影响读者判断的一步。很多作者只展示显著差异,阴性结果则省略。但基线是否平衡,直接关系到组间可比性、偏倚风险和后续结论可信度 。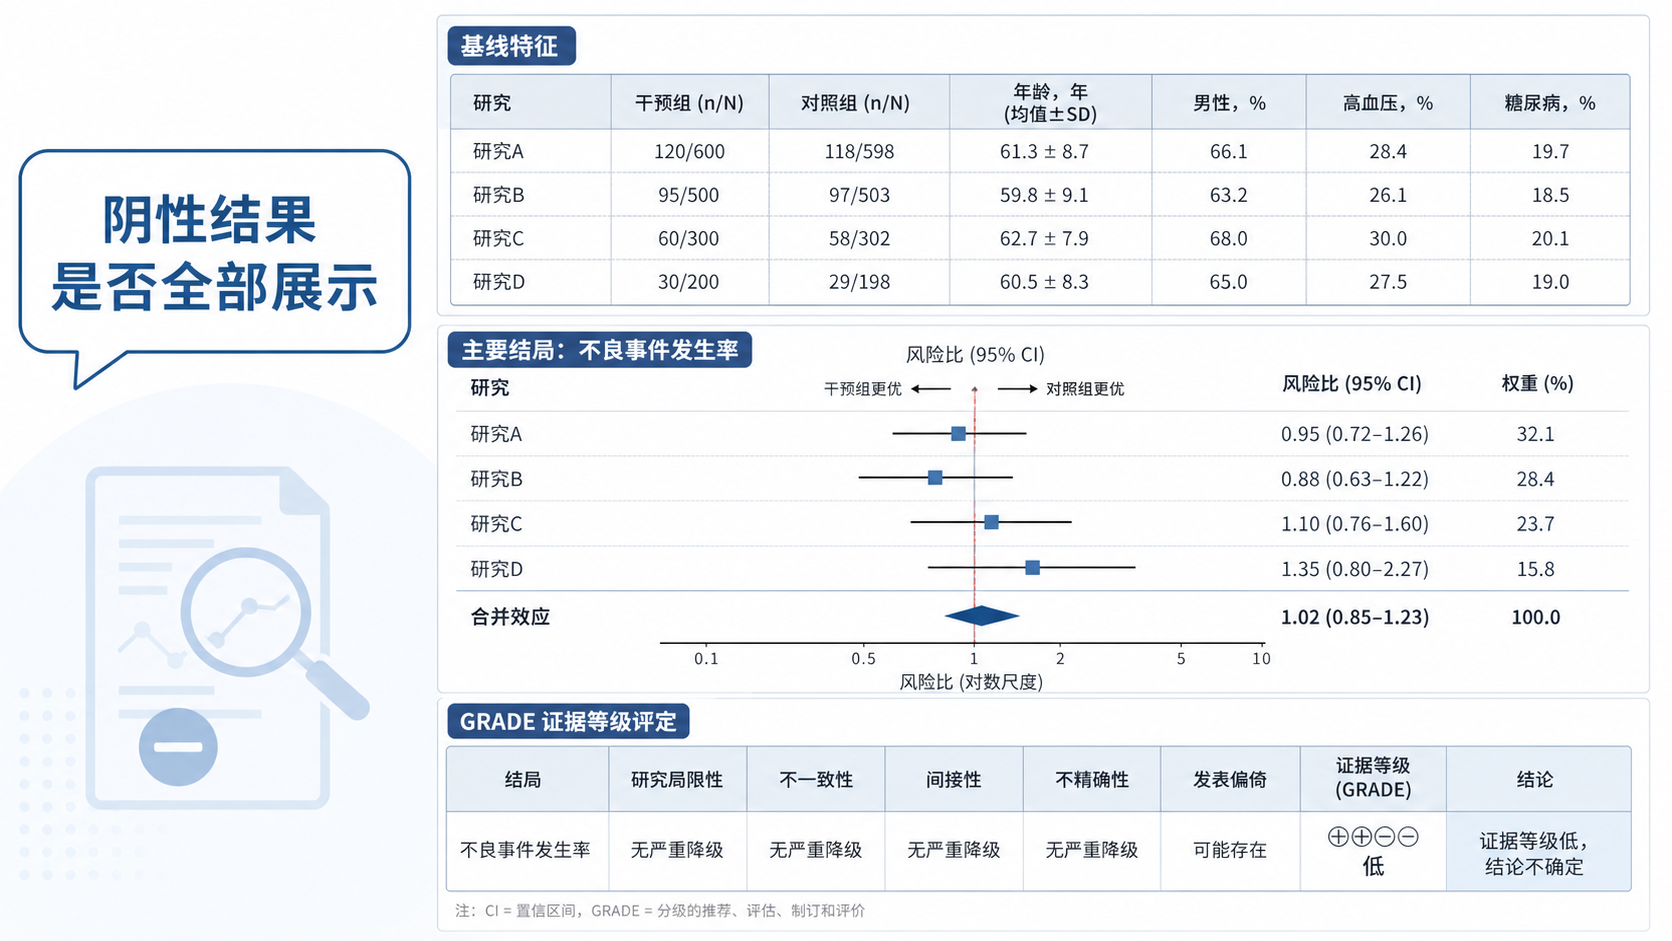
1. 为什么基线疾病严重程度比较不能只看“显著差异”
1.1 基线表不是装饰,是偏倚判断的起点
基线疾病严重程度比较,核心不是“有没有P值显著”,而是看随机后或入组时两组是否在关键预后因素上接近。对临床研究而言,疾病严重程度往往比年龄、性别更能影响结局。比如感染范围、肿瘤分期、器官功能分级、APACHE II、SOFA、NIHSS、NYHA,这些都可能改变疗效判断。
如果基线严重程度不平衡,后续疗效差异就可能混入混杂。
这时你看到的“治疗有效”,未必全是干预本身造成的。
1.2 只报阳性结果,会放大选择性报告风险
很多论文在基线表里只放“显著不平衡”的变量,认为无差异项目没有意义。这个做法的问题有两个。
- 读者无法判断整体平衡情况。
- 作者可能在无形中做了选择性呈现。
对于基线疾病严重程度比较,阴性结果同样重要。
因为它告诉读者,研究对象是否真的来自同一疾病谱,是否存在系统性偏倚。
1.3 研究设计不同,基线比较的意义也不同
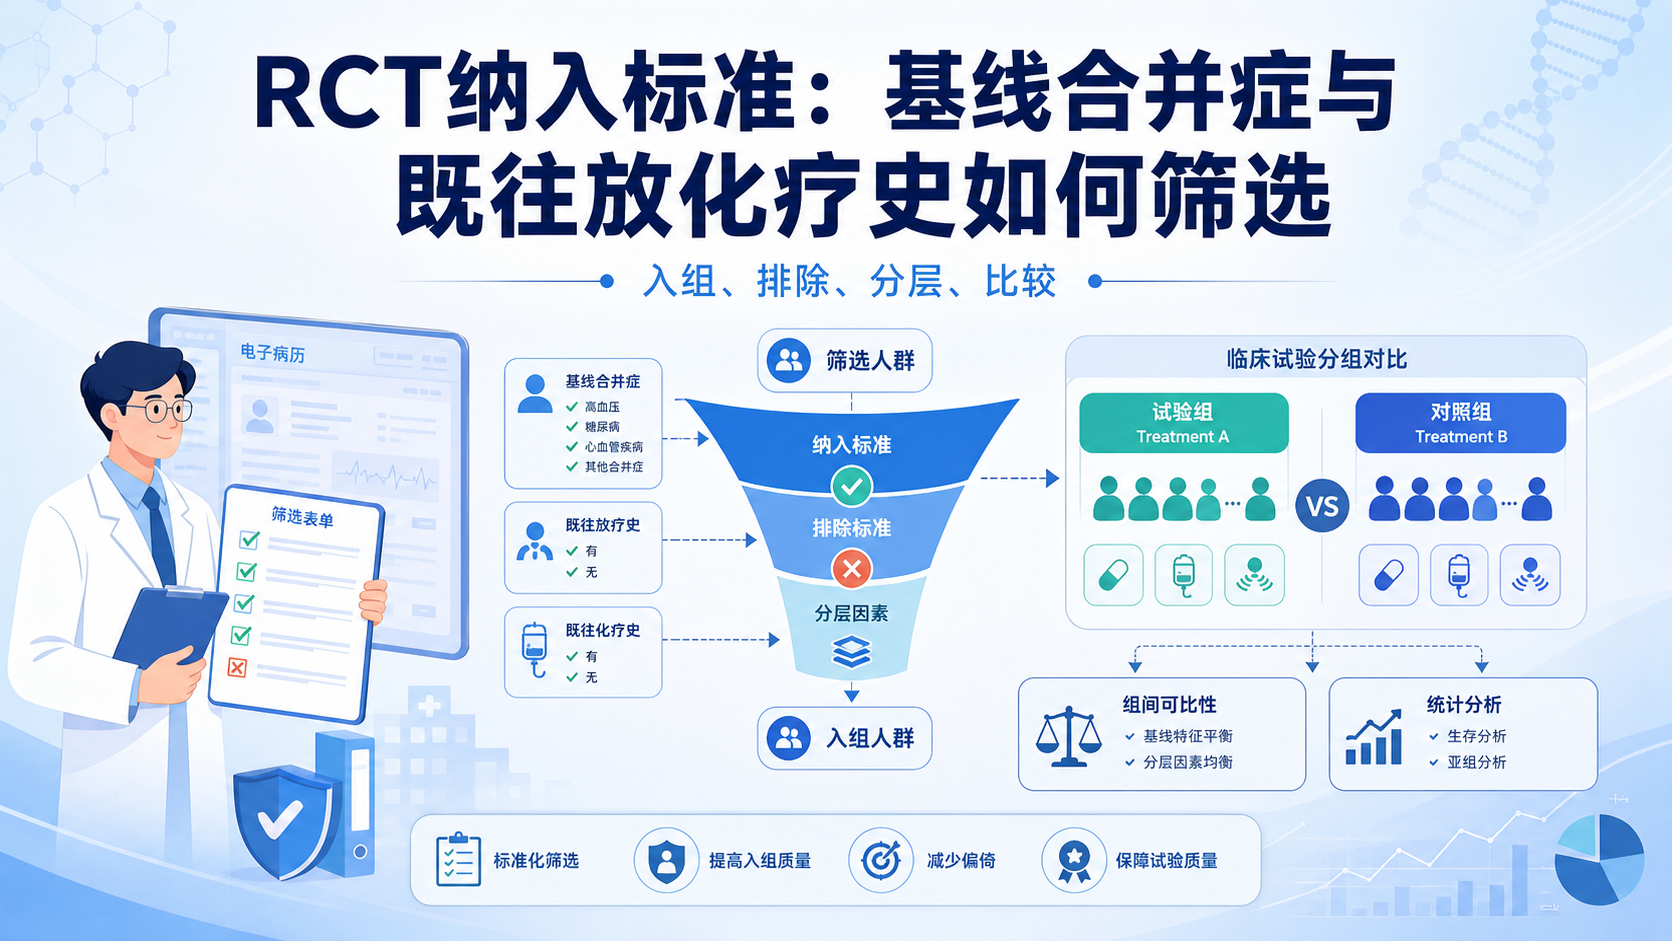
- RCT中 ,基线比较主要用于检查随机化是否大体成功。
- 观察性研究中 ,基线比较更关键,因为组间本来就可能存在明显选择偏倚。
- 回顾性队列中 ,疾病严重程度常常是最重要的混杂因素之一。
所以,基线疾病严重程度比较不是形式步骤,而是解释全文的前提。
2. 阴性结果该不该全放,关键看“信息价值”
2.1 该放,尤其是与预后相关的严重程度指标
凡是能直接影响结局的基线指标,建议完整呈现。
尤其包括以下几类:
- 疾病分期、分级、分层
- 器官功能状态
- 病情持续时间
- 既往治疗史
- 主要合并症负担
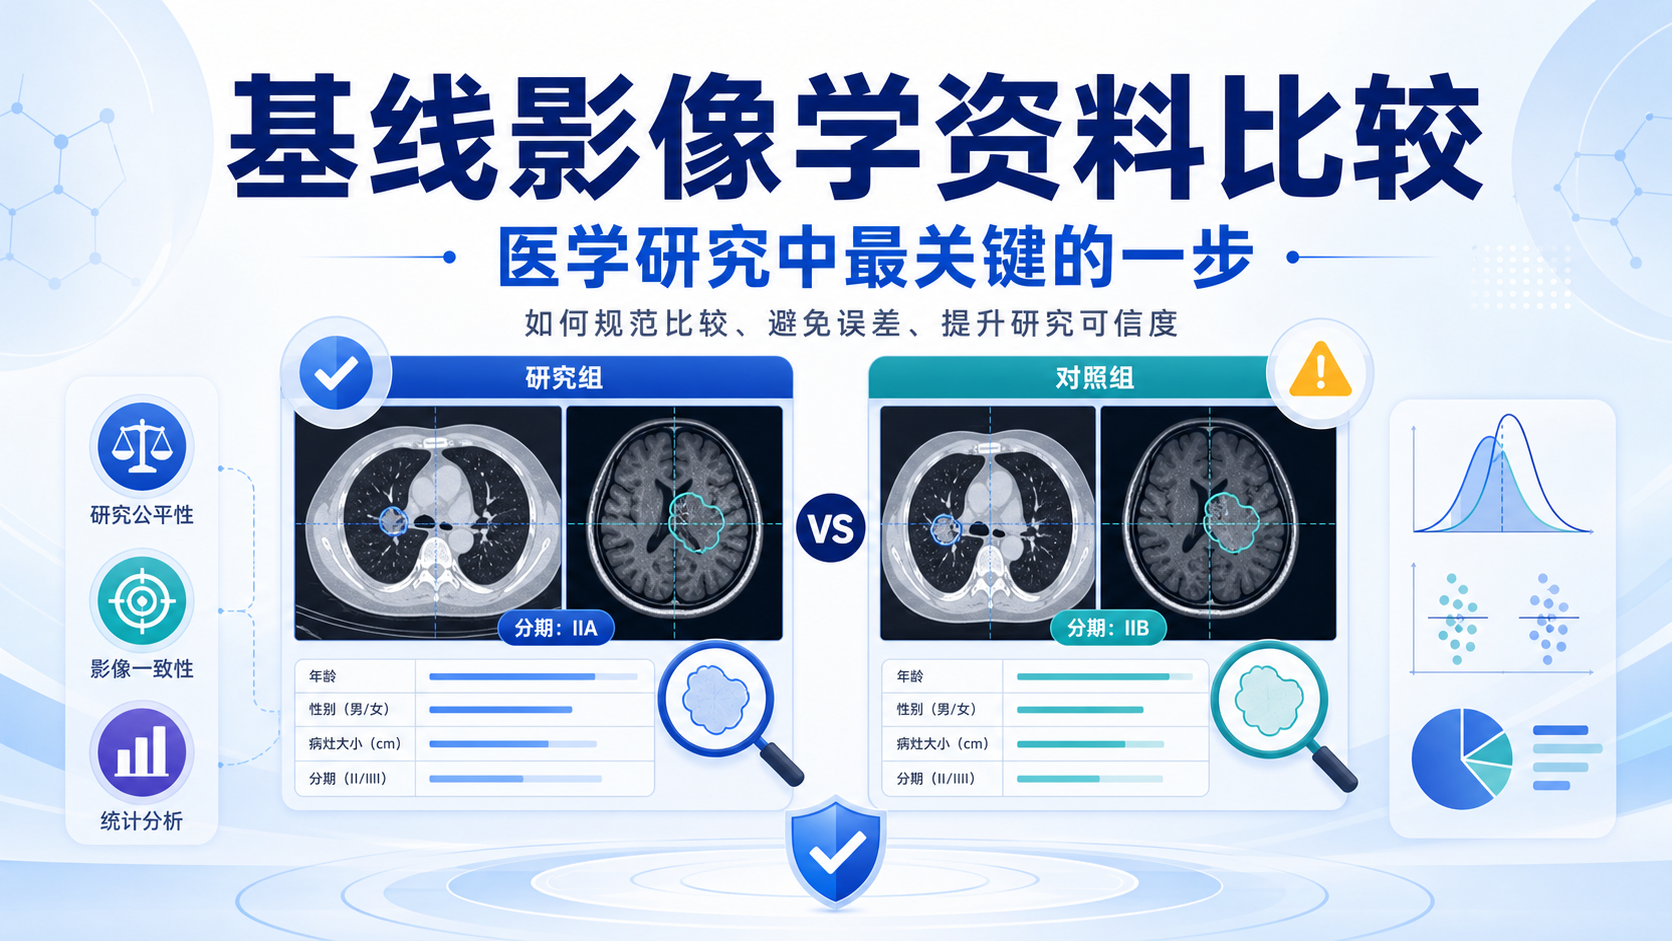
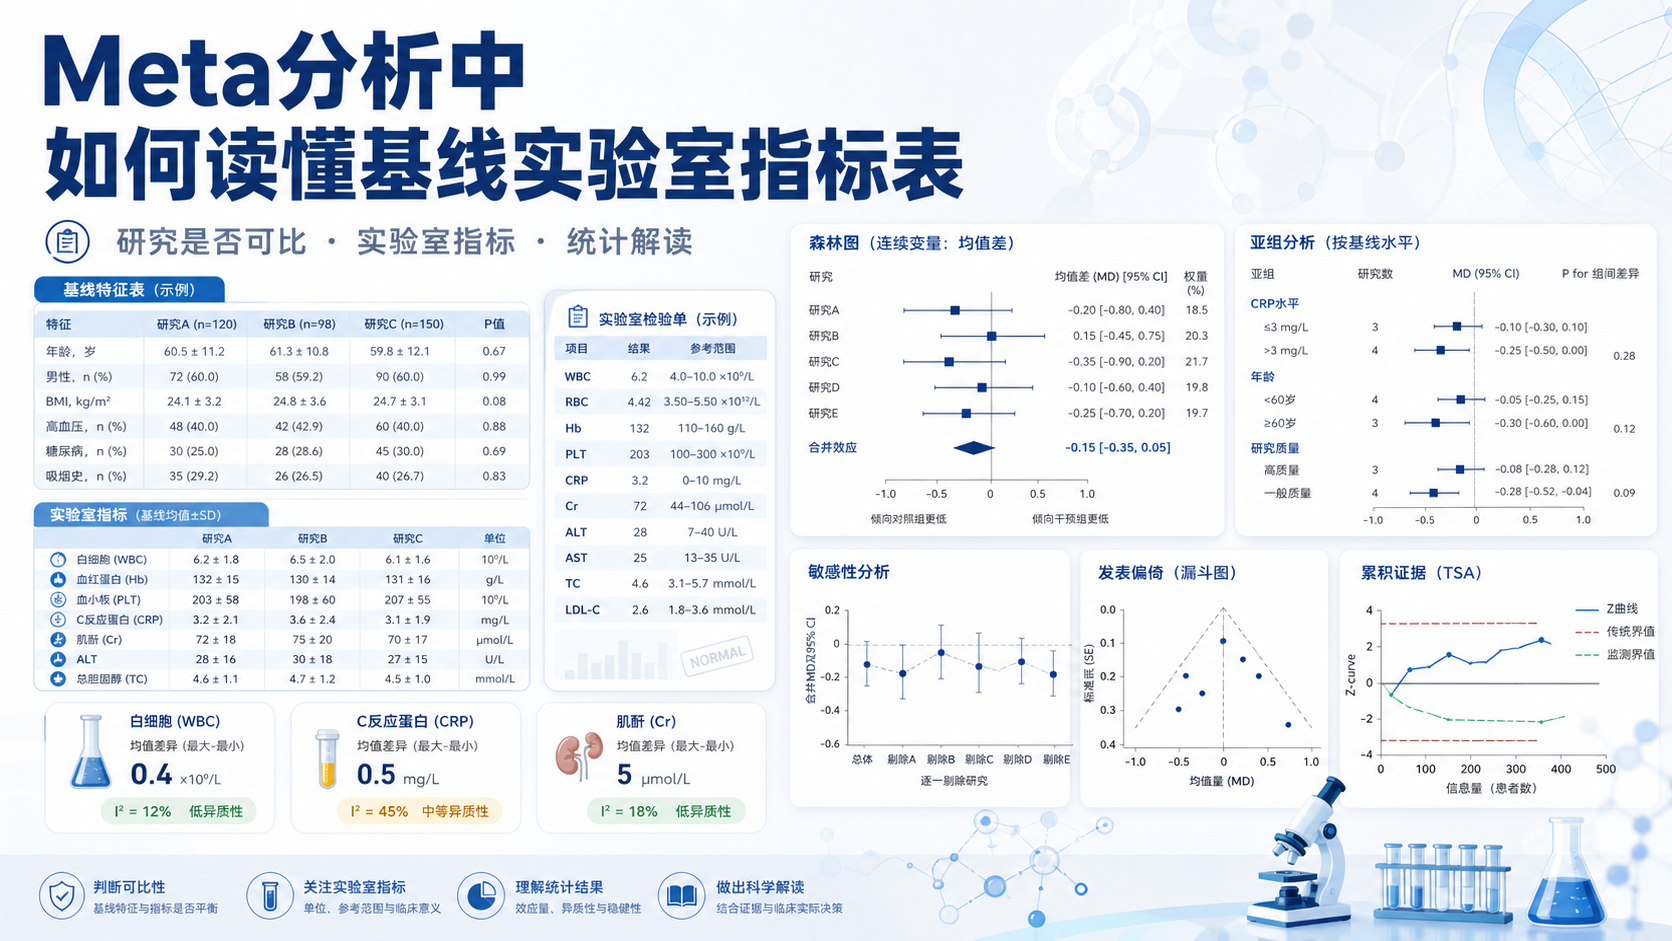
- 关键实验室和影像学严重程度指标
这些变量即使“P值不显著”,也应该放在基线表里。因为它们决定了读者能否判断两组起点是否一致。
2.2 不必把所有无关变量都堆进正文
阴性结果“全放”不等于“无差别地全塞”。
如果变量与主要结局几乎无关,且对疾病严重程度解释价值有限,可以放入补充材料。
更合理的原则是:
- 正文放关键预后变量
- 补充材料放扩展变量
- 方法部分说明预设基线指标选择依据
这样既完整,又不冗余。
2.3 “全放”最适合什么场景
以下场景尤其建议把阴性结果完整展示:
- 样本量较小,随机失衡风险更高。
- 疾病异质性大,严重程度分布可能影响结论。
- 文章采用亚组分析、敏感性分析或合并结局。
- 期刊要求透明报告基线平衡情况。
当研究的可信度依赖“起点是否可比”时,阴性结果就不是累赘,而是证据。
3. 怎么判断基线疾病严重程度比较是否足够严谨
3.1 不要只盯着P值,先看临床意义
基线比较最常见的误区,是把P>0.05当成“完全平衡”。这并不严谨。
因为P值受样本量影响很大,样本小可能看不出差异,样本大则微小差异也会显著。
更好的做法是同时看:
- 均值或中位数差异
- 标准化差异,SMD
- 95%CI
- 是否符合临床可接受范围
在基线平衡判断中,SMD比单纯P值更稳定。
一般经验上,SMD < 0.1 常提示平衡较好,但仍需结合疾病背景判断。
3.2 严重程度指标最好分层展示
对医学研究而言,单一总分有时不够。
建议把疾病严重程度拆成多个层面:
- 病理严重程度
- 结构损害程度
- 功能损害程度
- 炎症或感染负荷
- 生命体征不稳定程度
例如同样是肺炎,氧合指数、呼吸支持方式、影像累及范围,信息价值不同。
只给一个总分,往往不足以说明两组病情起点一致。
3.3 需要预先定义“关键严重程度变量”
严谨的研究不会等到结果出来再挑变量。
应该在方案或统计分析计划里预先规定:
- 哪些指标属于关键基线变量
- 哪些是次要变量
- 哪些进入多变量模型
- 哪些用于敏感性分析
这样做的好处是避免“结果导向选择”。
也能让阴性结果展示更有逻辑,而不是堆数据。
4. 阴性结果如何呈现,才更像高质量论文
4.1 基线表要完整,但信息层级要清楚
一张高质量基线表,通常应做到:
- 主要疾病严重程度指标放前面
- 次要一般人口学特征放后面
- 变量定义清晰
- 单位统一
- 统计方法一致
不要让读者在一堆无关变量里找重点。
重点是让人一眼看到,两组是否在“病情起点”上可比。
4.2 文字结果要解释,而不是重复表格
正文不需要把基线表每一项再念一遍。
更好的写法是概括性总结,比如:
- 两组在主要严重程度指标上总体可比。
- 个别次要变量存在轻度不平衡。
- 相关混杂因素已在多变量分析中调整。
这样既简洁,也符合医学论文的阅读逻辑。
4.3 阴性结果不能掩盖真正的不平衡
如果某些关键严重程度变量确实不平衡,不能因为“阴性结果很多”就淡化。
这种情况应如实报告,并说明处理方式,例如:
- 多变量回归
- 倾向评分匹配
- IPTW
- 分层分析
- 敏感性分析
高质量论文的核心不是“看起来平衡”,而是“如实呈现并正确处理不平衡”。
5. 从论文解读角度看,基线严重程度比较要和结论一起读
5.1 基线平衡好,结论可信度更高
如果两组在关键严重程度指标上接近,而主要结局又有稳定差异,那么读者更容易相信干预效应。
这也是为什么很多系统评价和临床研究解读会优先关注基线表。
5.2 基线不平衡,不代表文章一定不能信
如果作者提供了足够的调整分析、敏感性分析,并且结果方向一致,那么结论仍可能成立。
但这时你需要更谨慎地阅读。
可重点看:
- 调整前后效应是否一致
- 亚组结果是否稳定
- 95%CI是否跨线
- 证据等级是否足够高
在证据分级上,通常更应优先采信 high 或 moderate 证据。
如果基线严重程度比较不充分,再好的显著性也要打折扣。
5.3 森林图和GRADE也能帮助判断“阴性结果值不值得全放”
很多高质量文章会把所有主要结局都做成森林图,不只展示阳性结果,也展示阴性结果。
这有两个好处:
- 让读者看到完整证据链
- 避免只报有利结论
同时,GRADE证据等级表能帮助判断结果可采信程度。
如果基线严重程度比较清楚、结局报告完整、证据等级较高,阴性结果本身就是论文质量的一部分。
6. 写作实操:基线疾病严重程度比较怎么写更稳妥
6.1 推荐写法
可以采用“总括+关键变量”的结构:
- 先说明两组基线总体可比。
- 再点出主要疾病严重程度指标的差异情况。
- 如有不平衡,说明调整方法。
- 将完整数据放入表格或补充材料。
6.2 避免的写法
以下表达不够严谨:
- “两组完全一致。”
- “无任何差异。”
- “P值都>0.05,所以平衡。”
- “未发现不平衡,因此无需调整。”
这些说法都过于绝对。
医学研究更适合用“总体可比”“主要指标接近”“存在轻度不平衡但已调整”这类表述。
6.3 一个实用原则
凡是可能影响主要结局解释的基线严重程度指标,都应该优先完整展示。
这比只筛选阳性结果更符合E-E-A-T要求,也更有利于同行评审。
6.4 如果你要高效完成论文解读和写作
在基线疾病严重程度比较、结果图表整理、证据分级和论文结构化写作上,专业工具能显著提升效率。
如果你需要更快完成文献筛选、图表整理和论文表达优化,可以借助解螺旋 ,把分散的基线信息、阴性结果和结局证据整合成更清晰、更可发表的表达。
总结Conclusion
基线疾病严重程度比较,决定了研究起点是否可信。阴性结果不应简单删除,尤其是关键预后变量,最好完整呈现。 但“全放”不等于无差别堆砌,正文应突出与结局最相关的严重程度指标,其他变量可放补充材料。对于医生、医学生和科研人员来说,真正重要的是:如实报告、正确解释、合理调整。若你希望把基线表、阴性结果和结局分析写得更规范、更高效,可以进一步借助** 解螺旋**来优化论文表达与整理流程。
- 引言Introduction
- 1. 为什么基线疾病严重程度比较不能只看“显著差异”
- 2. 阴性结果该不该全放,关键看“信息价值”
- 3. 怎么判断基线疾病严重程度比较是否足够严谨
- 4. 阴性结果如何呈现,才更像高质量论文
- 5. 从论文解读角度看,基线严重程度比较要和结论一起读
- 6. 写作实操:基线疾病严重程度比较怎么写更稳妥
- 总结Conclusion