19
 分享
引言Introduction
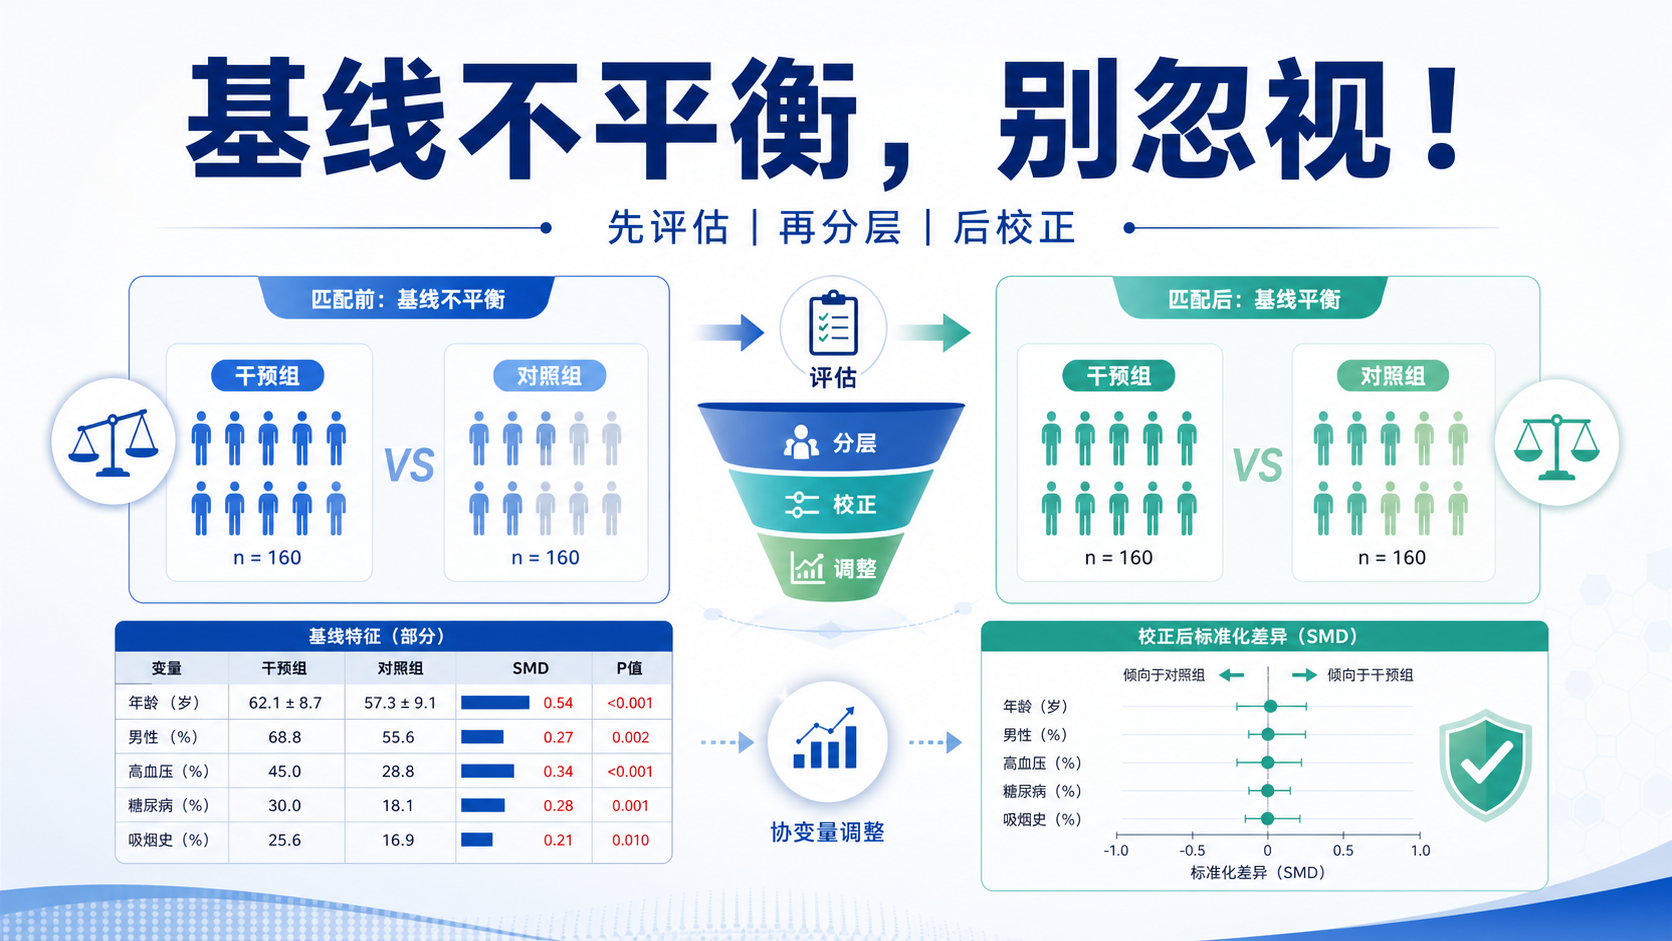
Meta分析最怕什么。不是没有显著性,而是基线不均衡悄悄把结论带偏 。尤其在预后、干预和回顾性研究里,年龄、病程、病情严重度一旦分布不同,就可能把真实效应“放大”或“稀释”。
1. 基线混杂偏倚为什么会伤害Meta结论
1.1 基线不均衡,不只是“看起来不同”
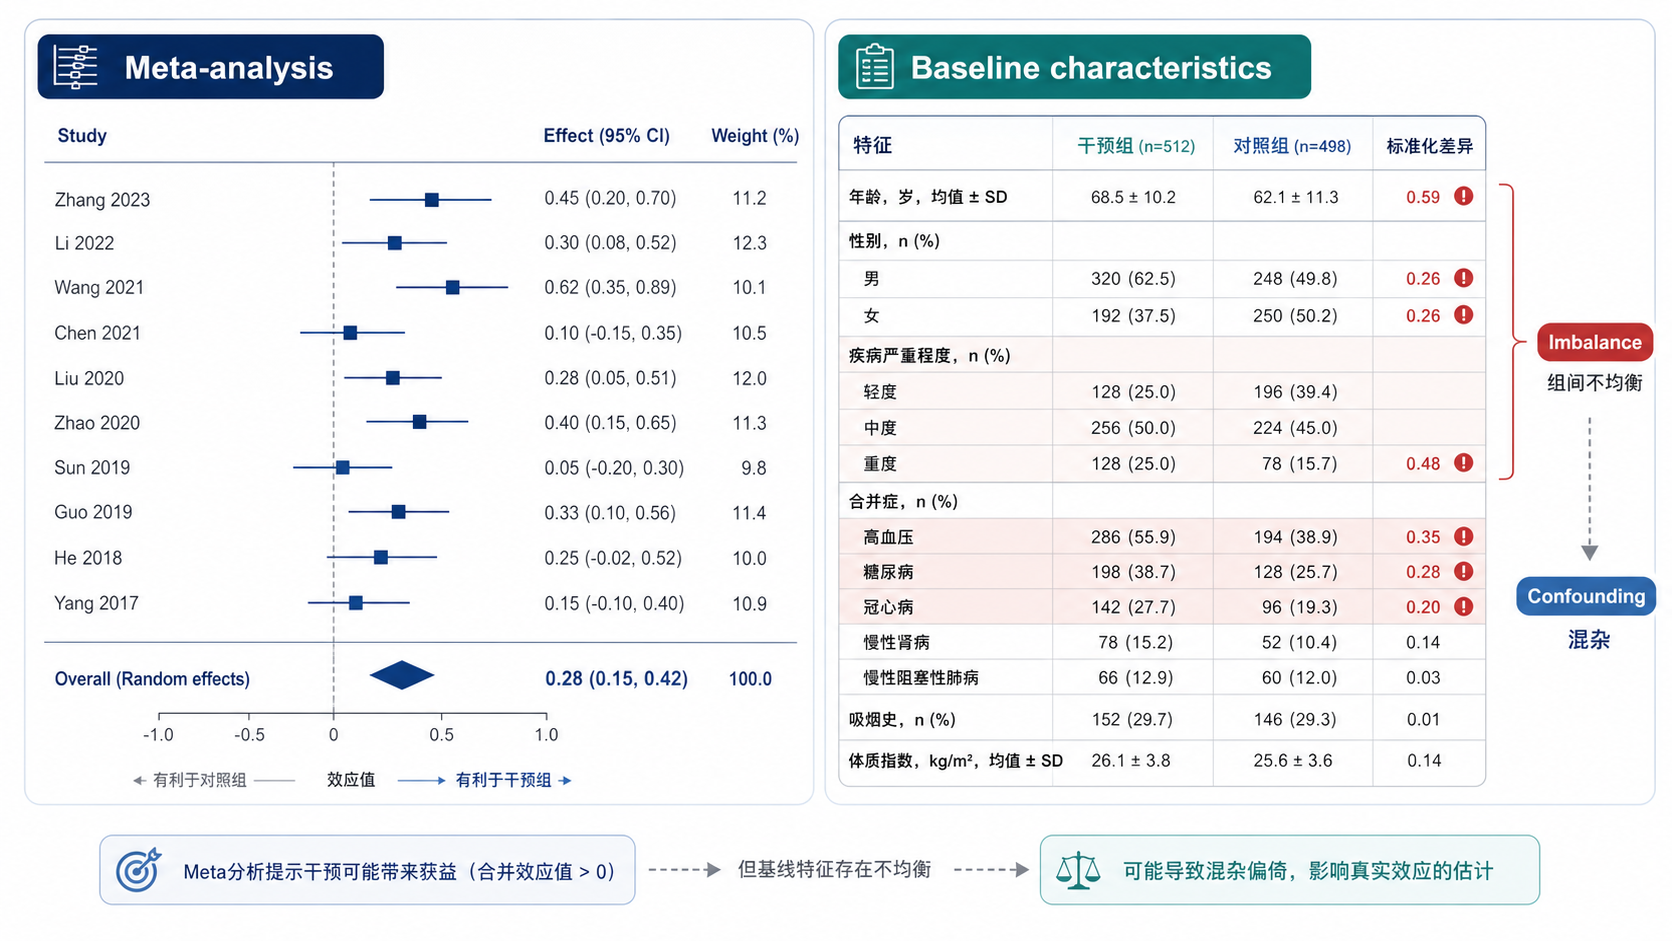
在Meta分析中,研究间差异并不等于偏倚,但当关键基线变量系统性不一致时,结果就可能被混杂 。例如某组患者年龄更大、基础疾病更多、病情更重,结局更差并不一定是干预无效,而可能是基线风险更高。
混杂偏倚的核心,是第三变量同时影响暴露和结局。 在临床研究里,年龄、性别、吸烟、疾病分期、合并症,都是最常见的混杂因素。它们不处理好,合并效应就可能失真。
1.2 为什么Meta里更容易被忽视
单篇研究里,研究者还能直接看原始基线表。但到了Meta层面,很多人只盯着效应量和I²,忽略了每项研究内部是否可比。结果就是,统计学上“合并”了,临床上却未必可比 。
常见问题包括:
- 干预组与对照组年龄差异明显。
- 研究之间纳入标准不同。
- 不同研究使用的终点定义不一致。
- 调整变量不统一,只有部分研究报告校正结果。
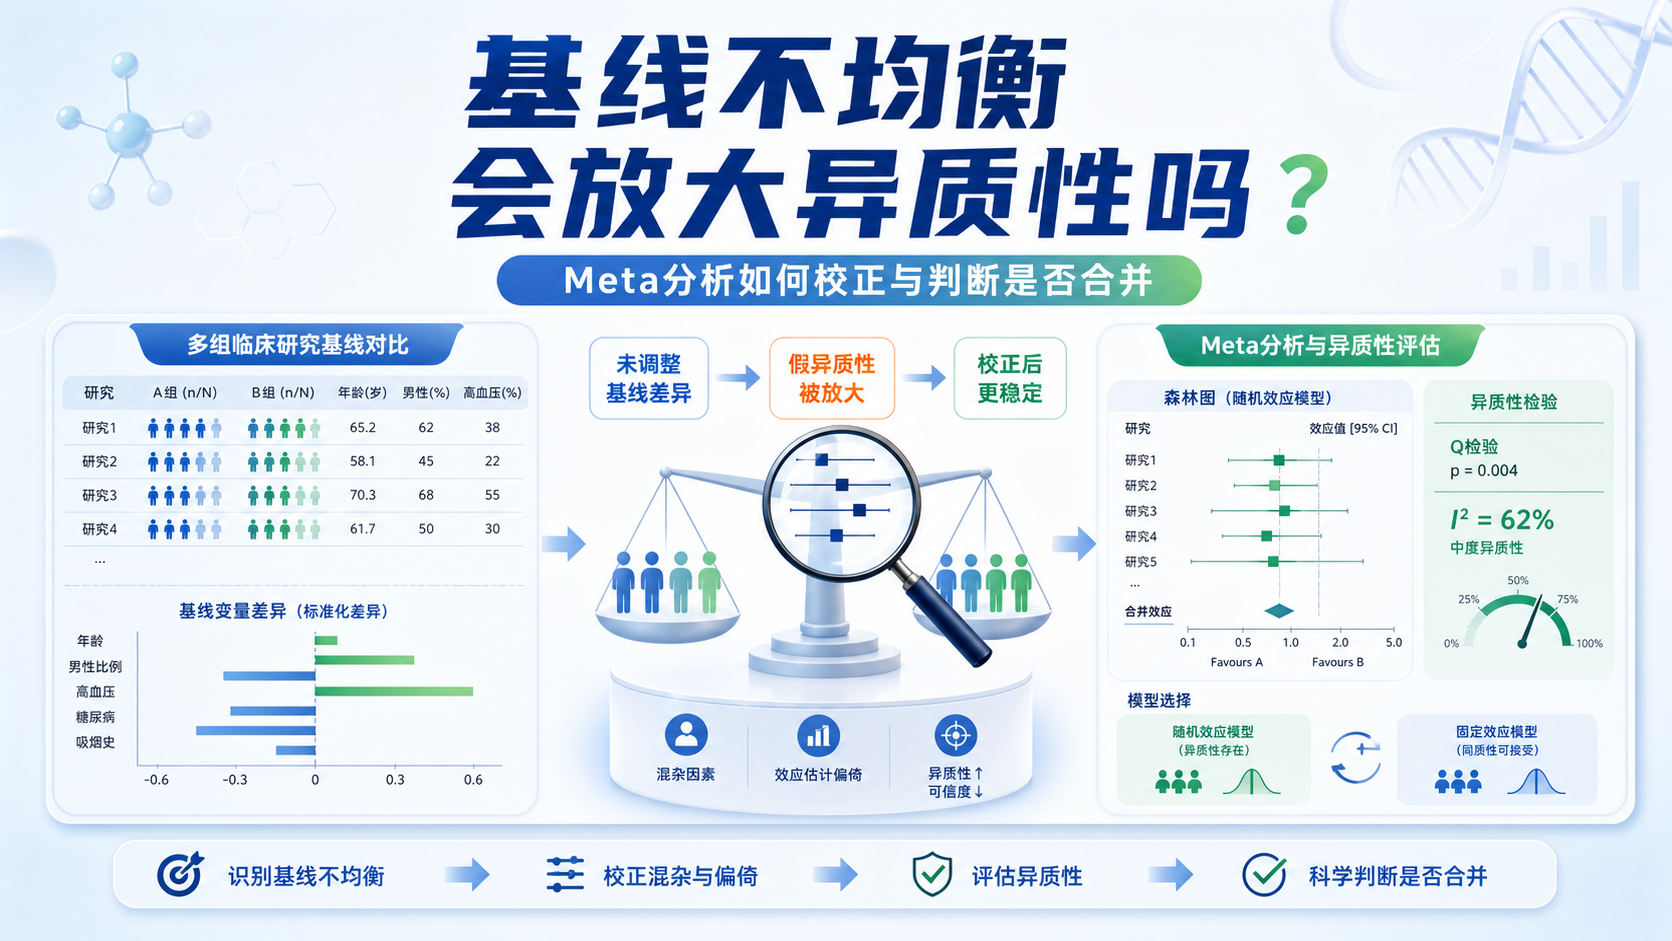
这些问题不会自动消失。它们会以亚组差异、异质性升高,甚至方向翻转的形式出现。
1.3 识别混杂,不要只看P值
P值不能直接证明没有混杂。 很多时候,基线变量样本量小、统计功效不足,即使存在临床重要差异,也可能不显著。对医生和科研人员来说,更应关注:
- 差异是否符合临床逻辑。
- 是否影响预后。
- 是否与暴露因素相关。
- 是否可能改变效应方向。
在Meta中,真正重要的是效应可比性 ,不是单纯的显著性。
2. 三步精准诊断基线混杂偏倚
2.1 第一步,看基线表,先做临床判断
诊断混杂偏倚,第一步不是跑模型,而是看基线表。重点检查两类信息。
一类是结局相关变量 ,比如年龄、肿瘤分期、病程、炎症指标、肾功能、既往史。另一类是与暴露相关的变量 ,比如某治疗更常分配给重症患者,或某术式只用于低风险人群。
建议按以下顺序判断:
- 找出与结局强相关的变量。
- 判断这些变量在组间是否不平衡。
- 评估不平衡是否足以改变结论。
如果差异大到足以解释结局差异,就要高度怀疑混杂。
2.2 第二步,看研究设计和分析方式
同样是基线不均衡,处理方式不同,偏倚风险也不同。你需要看原研究是否做了控制。
重点看三点:
- 是否限制纳入标准,例如只纳入某年龄层或同一分期患者。
- 是否做了匹配,保证暴露组与对照组可比。
- 是否进行了多因素校正,如回归模型、分层分析或标准化。
如果研究只报告了未校正效应,而基线差异又明显,Meta合并时就要优先考虑偏倚风险 。如果有校正效应和原始效应,最好分别分析,观察结论是否一致。
2.3 第三步,看异质性来源是否指向混杂
当I²升高时,不要急着把原因归结为“研究质量差”。要回到临床和方法学层面,判断是否由混杂造成。
可用的诊断思路包括:
- 按年龄、病程、疾病严重度分层。
- 按是否校正混杂因素分层。
- 对关键协变量做Meta回归。
- 比较调整前后效应值是否明显变化。
如果一旦分层或校正,合并效应明显改变,混杂偏倚的可能性就很大。 这比单看异质性数值更有解释力。
3. 如何把混杂影响降到最低
3.1 设计阶段,先减少不均衡
最稳妥的方法,永远是前移到设计阶段控制。对于原始研究,推荐优先采用以下策略:
- 严格纳入排除标准。
- 尽量匹配关键混杂因素。
- 在研究方案中预设协变量。
- 提高基线资料完整性。
设计越规范,后续Meta越容易得到可信结论。 如果原研究本身混杂控制薄弱,后续统计补救的效果往往有限。
3.2 分析阶段,做分层和敏感性分析
Meta分析中,常用的补救策略包括:
- 按混杂水平分层。
- 只纳入校正后效应值。
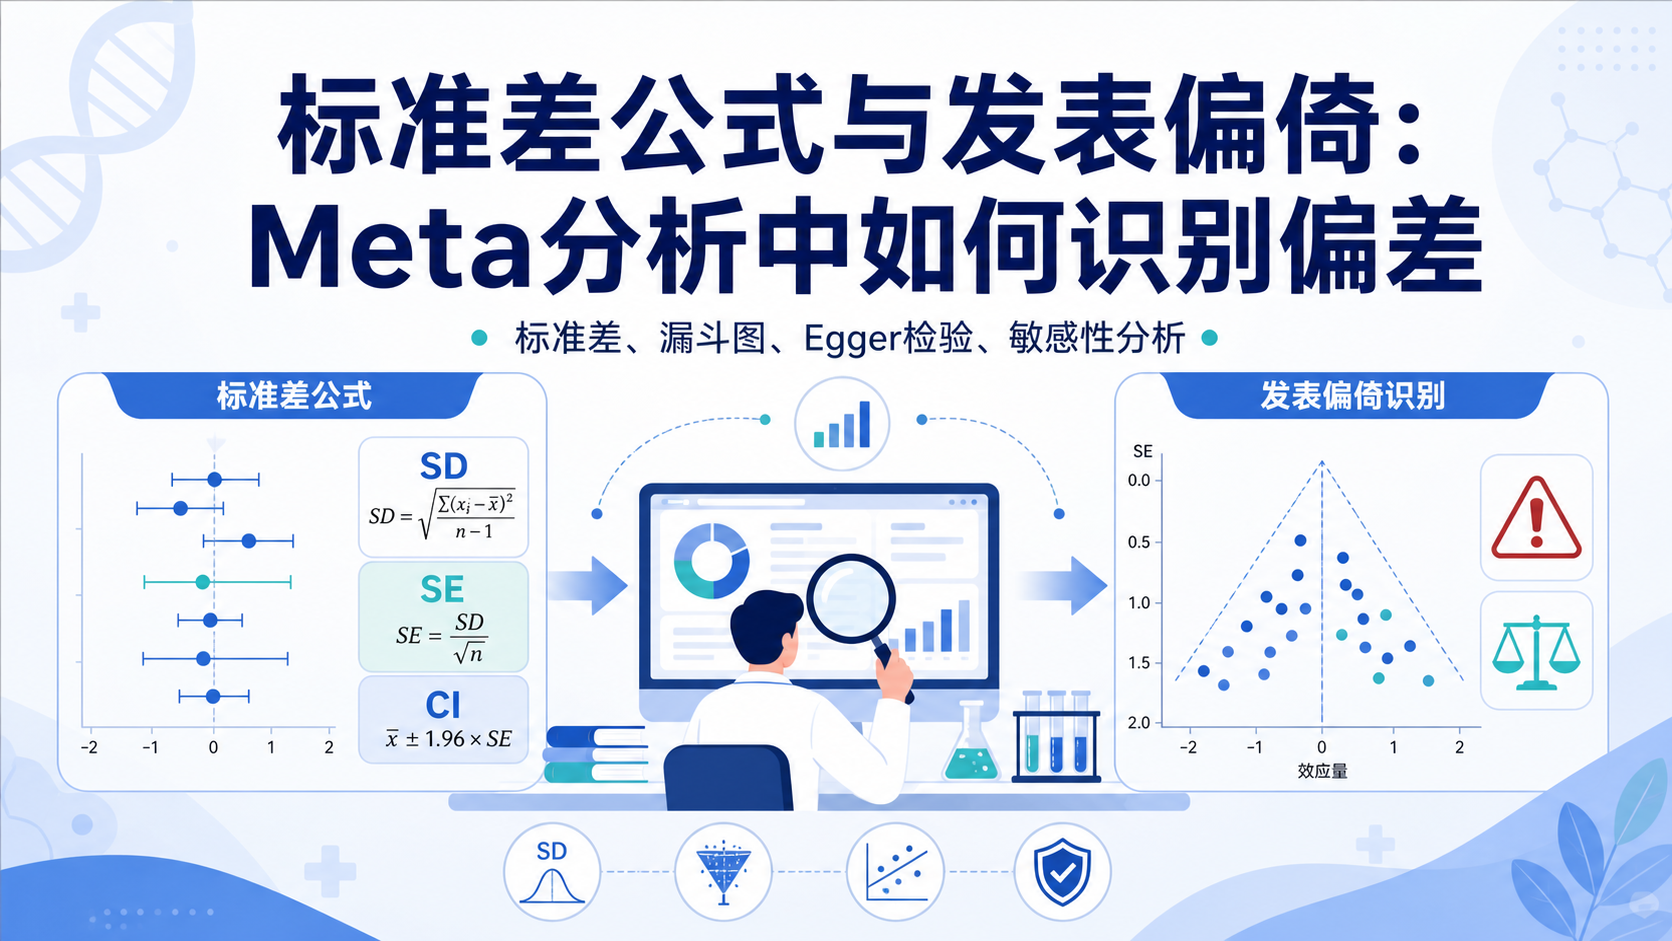
- 做敏感性分析,逐一剔除高风险研究。
- 用随机效应模型评估稳健性。
如果结果在不同分析策略下都稳定,说明结论相对可靠。反之,若结论高度依赖某几项研究,就要在正文中明确提示。
结论是否可信,不只看合并结果,还要看它是否经得起“删一项、换一种方法、换一组人”的检验。
3.3 报告阶段,明确写出局限
很多Meta的价值,不在于“证明有效”,而在于诚实地说明证据边界 。如果存在明显基线混杂,建议在结果和讨论中直接写明:
- 哪些变量存在不均衡。
- 哪些研究未校正混杂。
- 这种不均衡可能如何影响效应方向。
- 最终结论应谨慎解释。
这类写法并不会削弱论文,反而更符合E-E-A-T要求,也更容易获得审稿人认可。
4. 典型场景:什么情况下要特别警惕
4.1 预后研究和回顾性队列
这类研究最容易出现基线差异。因为暴露不是随机分配,重症患者往往更可能接受某种治疗,或者更早进入某种管理路径。此时,治疗效果和病情严重度常常纠缠在一起 。
如果不校正,研究可能高估或低估治疗真实作用。
4.2 小样本研究合并
样本越小,基线不均衡越常见。小样本研究中,一个变量偏移就足以改变结局。把这类研究直接合并,往往会放大不稳定性。
因此,小样本Meta更需要:
- 逐篇检查基线。
- 优先使用校正值。
- 结合临床判断,而不是只依赖统计显著性。
4.3 多中心、跨地区研究
不同地区患者谱不同,基线差异常常来自入组人群本身,而不是研究者偏差。比如年龄结构、疾病谱、治疗习惯、随访长度都可能不同。此时,研究间差异未必是“随机波动”,而可能是真实人群差异。
这类Meta特别适合做亚组分析和Meta回归。
5. 解螺旋如何帮你更快识别这类问题
做Meta分析,真正难的不是“会不会合并”,而是能不能看出合并后的结论有没有被基线混杂悄悄污染 。解螺旋的价值,就在于把这一步前移。通过规范化的数据整理、基线对照和模型分析流程,帮助你快速识别哪些研究可比,哪些研究需要谨慎纳入,哪些结果应该只做探索性解释。
当你把基线不均衡、混杂偏倚和敏感性分析放到同一条工作流里,Meta结论才更接近真实世界。 这也是科研人员提高文章质量、医生提升证据解读能力的关键。
总结Conclusion
基线混杂偏倚不会总是制造明显错误,但它足以悄悄削弱Meta结论的可信度 。最实用的做法,就是按“三步法”处理:先看基线表,再看设计和分析,最后用异质性和敏感性分析验证。只要关键变量不平衡,就不能默认合并结果等于真实效应。
如果你正在做Meta分析,或者想系统提升偏倚识别能力,建议进一步使用解螺旋的专业工具和方法支持。它能帮你更快完成基线核查、混杂诊断和结果整合,让结论更稳、更准,也更容易发表。
- 引言Introduction
- 1. 基线混杂偏倚为什么会伤害Meta结论
- 2. 三步精准诊断基线混杂偏倚
- 3. 如何把混杂影响降到最低
- 4. 典型场景:什么情况下要特别警惕
- 5. 解螺旋如何帮你更快识别这类问题
- 总结Conclusion