17
 分享
引言Introduction
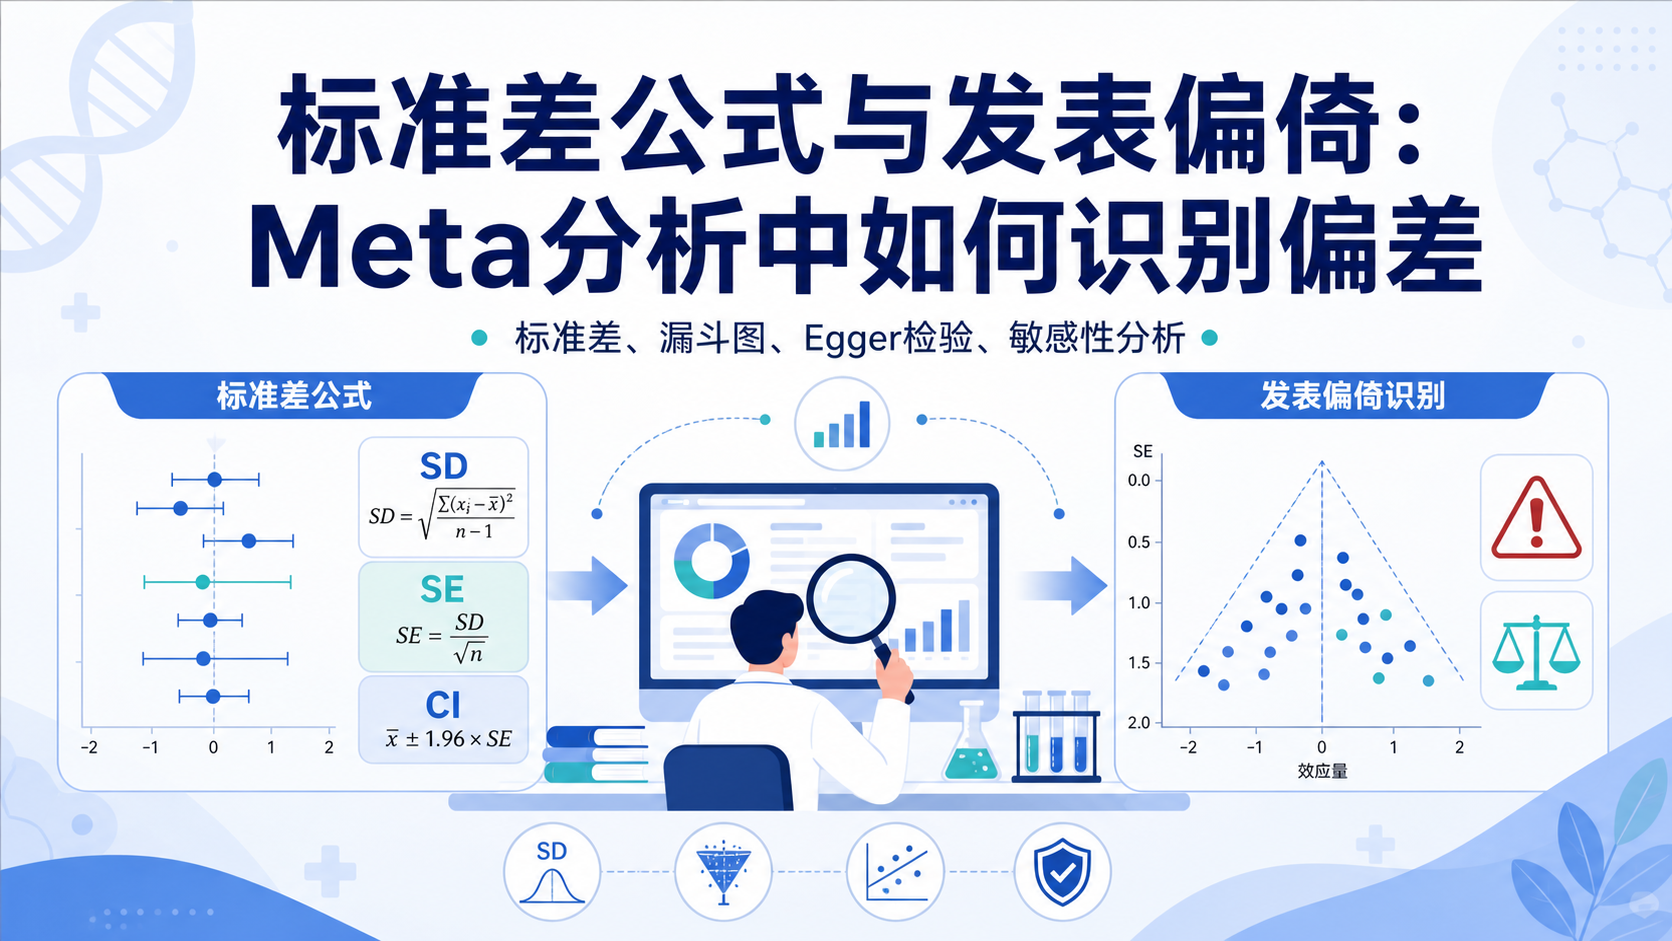
在Meta分析里,很多人只会看森林图,却忽略了发表偏倚和标准差计算。结果是,合并效应看似显著,结论却可能不稳。如果标准差公式用错,漏斗图和敏感性分析的判断也会被连带影响。
1. 为什么要把发表偏倚和标准差公式放在一起看
1.1 标准差决定了效应量的“可信底座”
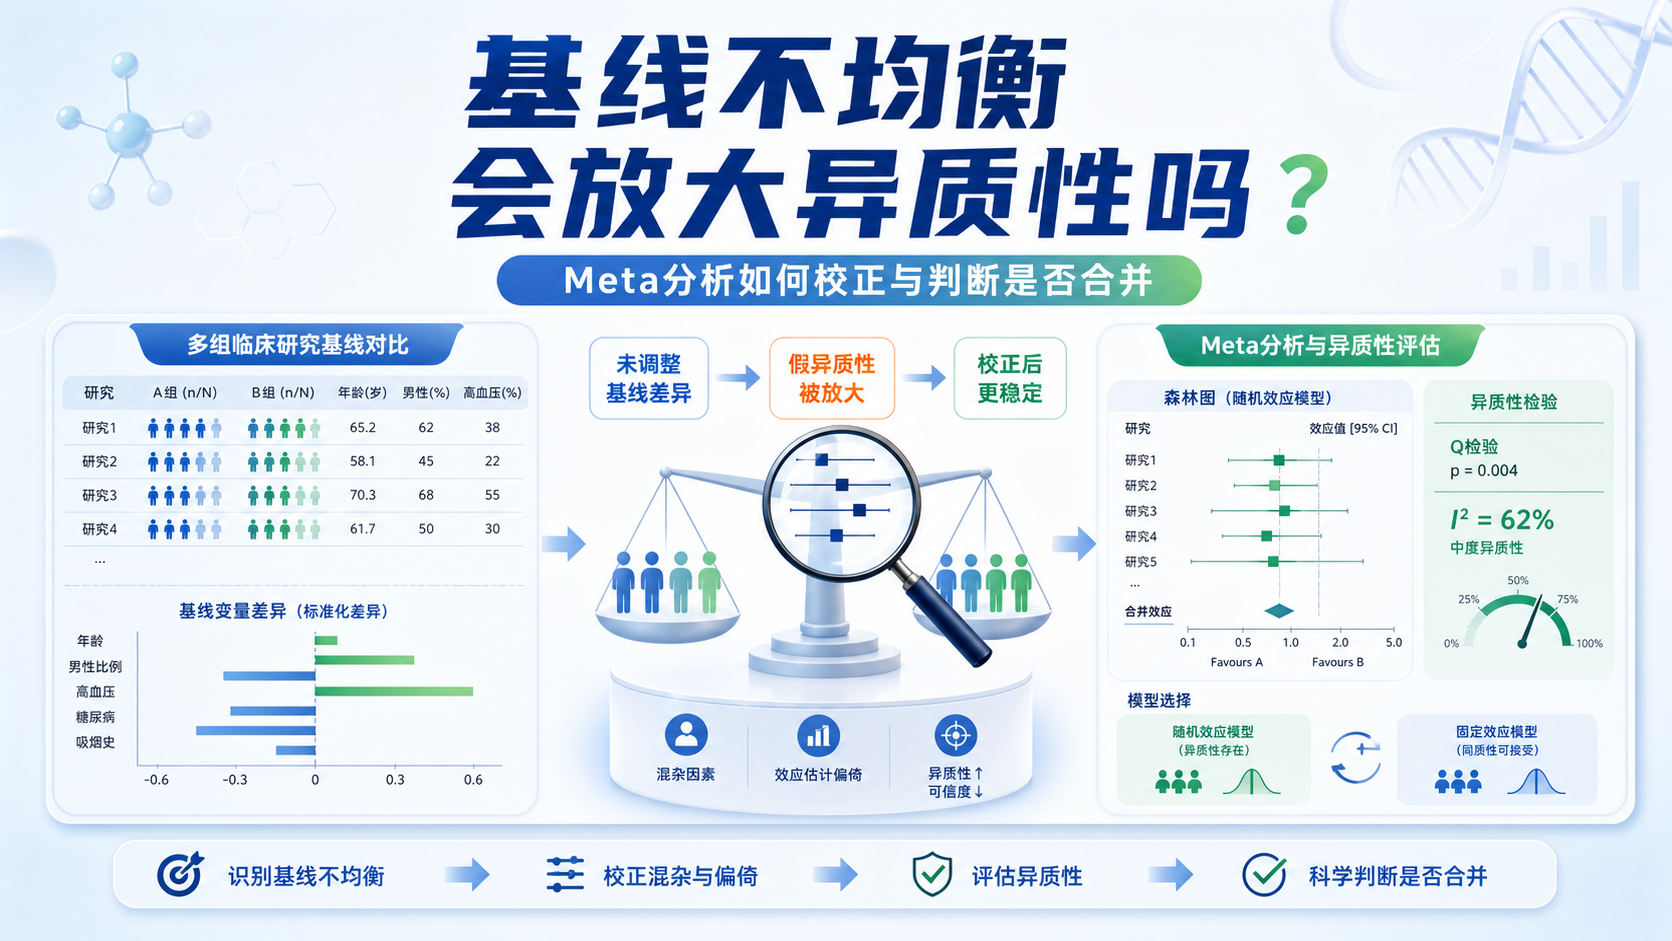
在Meta分析中,效应量不是孤立存在的。无论是均数差、标准化均数差,还是比值类指标,标准差公式都会影响标准误和置信区间的宽窄 。标准差越大,估计越不稳定,点位在图中的分布也会更散。
对医学生和科研人员来说,这一点很关键。因为很多原始研究只给出均值、范围、四分位数,或者只给出P值,不给标准差。此时如果换算方法不一致,后续合并就会出现系统偏差。
1.2 发表偏倚会放大数据不完整的问题
发表偏倚的核心,不是“图好不好看”,而是阳性结果更容易被发表,阴性结果更容易消失 。当纳入研究本身就不完整时,标准差的估算误差会进一步放大这种偏差。
常见后果有三类。
- 漏斗图不对称。
- Egger检验或Begg检验提示异常。
- 敏感性分析中,某一项研究一删,合并结果明显改变。
所以,标准差公式不是单纯的统计细节,而是判断发表偏倚是否可信的重要前提。
2. 标准差公式在Meta分析中的常见应用
2.1 已知均值和标准差时,直接进入合并分析
如果原始研究报告了均值和标准差,处理最简单。此时可以直接进入效应量计算。这类数据最稳定,也最适合后续做亚组分析和敏感性分析。
但现实中并不总是如此。很多临床研究只给中位数和范围,或者给均值但没给标准差。这个时候就需要按统计规则转换。
2.2 已知范围或四分位数时,需先估算标准差
常见近似方法包括以下几类。
- 已知样本量、最小值、最大值时,可用范围估算标准差。
- 已知中位数和四分位数时,可按分布假设估算标准差。
- 已知均值和95%CI时,可反推标准误,再换算为标准差。
这里最重要的是,转换公式必须与数据分布、样本量和结局类型匹配 。如果研究对象分布偏态明显,简单套用正态近似,误差会更大。
2.3 标准差、标准误和置信区间不能混用
这是初学者最容易出错的地方。
- 标准差,反映个体离散程度。
- 标准误,反映样本均值的不确定性。
- 置信区间,反映参数估计的范围。
三者不能直接等同。
很多发表偏倚判断失败,并不是因为真有偏倚,而是因为输入数据单位搞错了。比如把标准误当成标准差,森林图会变窄,漏斗图也会失真。
3. 发表偏倚的识别,不只看漏斗图
3.1 漏斗图是第一步,但不是终点
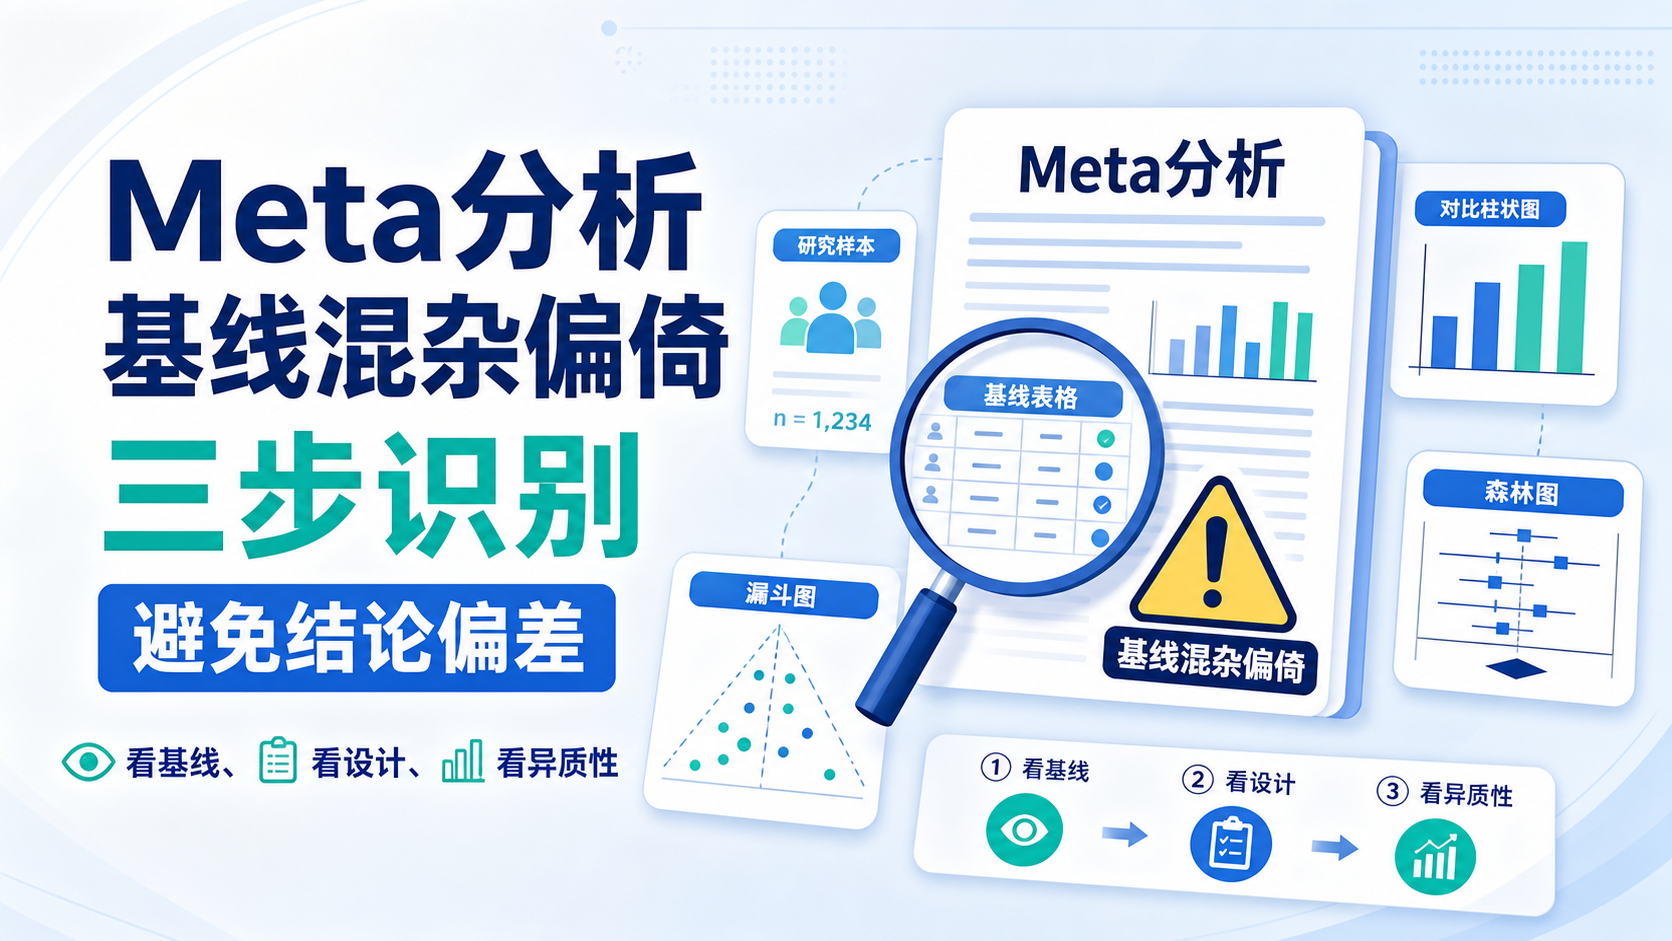
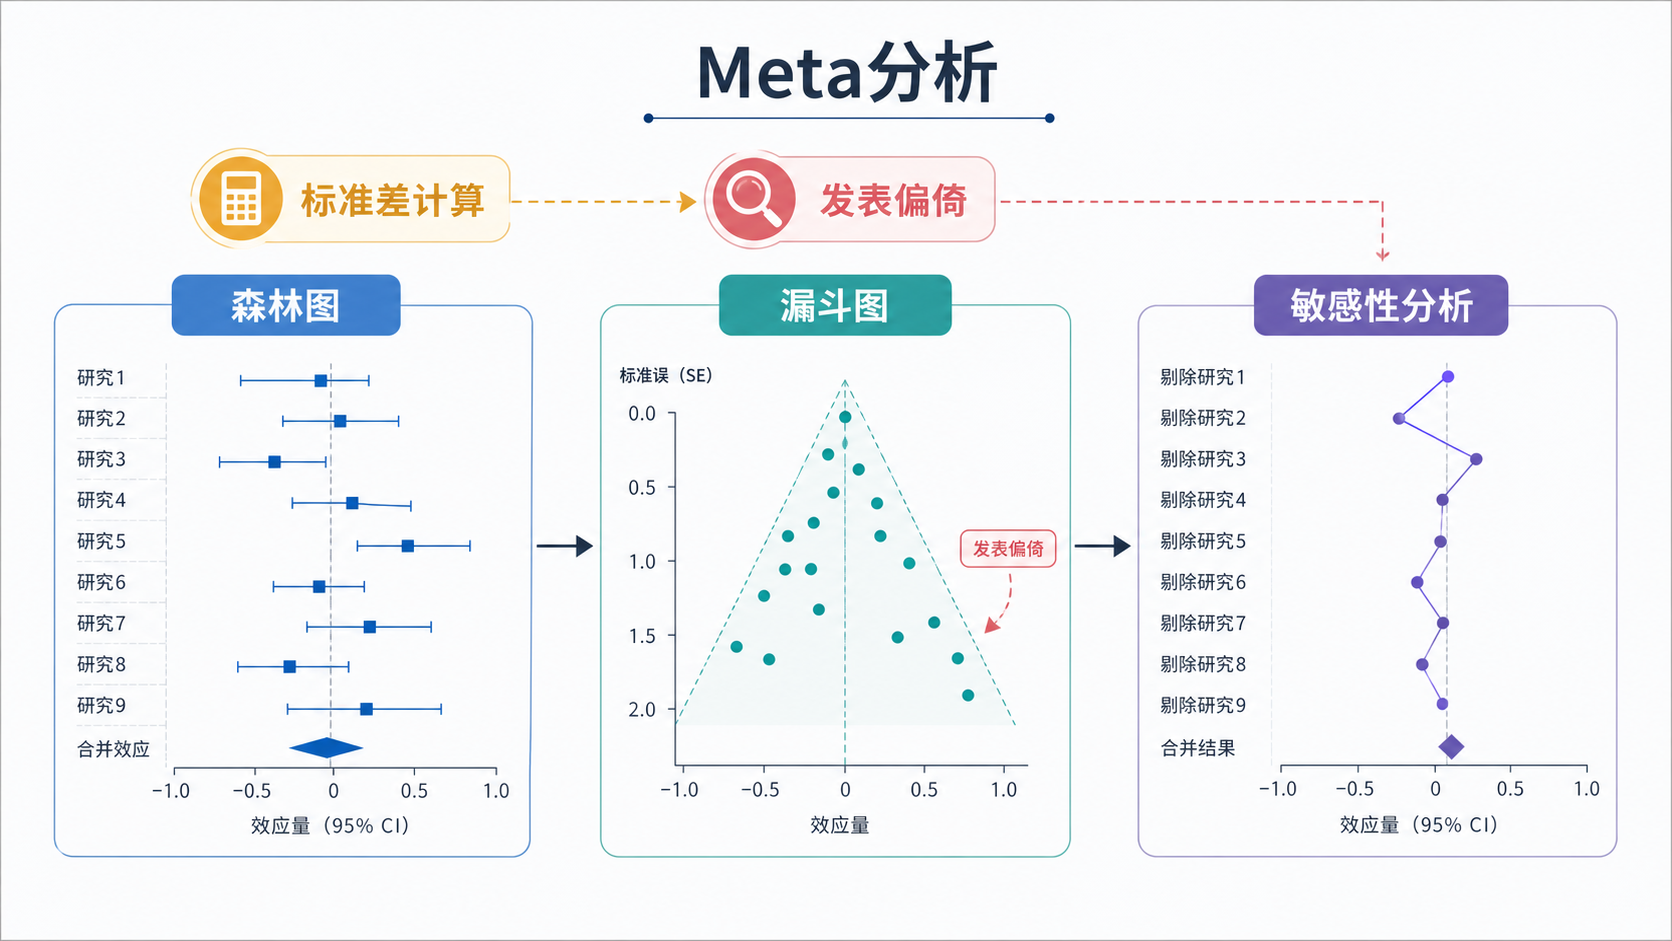
漏斗图最常用。横轴是效应量,纵轴通常是标准误或其倒数。样本量大的研究更靠上,样本量小的研究更靠下。理想状态下,图形应大致对称,呈倒置漏斗。
但要注意,漏斗图不对称不等于一定有发表偏倚 。异质性、样本量不足、研究质量差,都可能导致不对称。
因此,漏斗图更适合做筛查,不适合单独下结论。
3.2 Egger和Begg检验更适合定量判断
定量检测常见两种。
- Egger检验,适合发现小样本效应。
- Begg检验,基于秩相关思路。
在实际写作中,通常会同时报告漏斗图和定量检验结果。如果研究数少于9篇,检验效能往往不足。 这时要在局限性中说明,不建议过度解读。
3.3 发表偏倚的来源要区分
发表偏倚并不总是“故意隐瞒”。常见原因包括:
- 阳性结果更容易发表。
- 小样本研究质量较低。
- 真实异质性导致图形散开。
- 数据录入或提取错误。
- 少数情况下存在选择性报告。
这意味着,处理发表偏倚时,不能只盯着统计图,还要回到研究设计本身。
4. 标准差公式如何影响发表偏倚判断
4.1 标准差估错,会让漏斗图“假不对称”
漏斗图的纵轴通常依赖标准误,而标准误又与标准差和样本量相关。标准差估计偏大,点会被推向底部。标准差估计偏小,点会过度上移。
这会改变图形的整体轮廓,造成假性的非对称。对新手来说,这种问题很隐蔽。图画出来了,不代表结果就对。
4.2 研究间标准差差异,会增加异质性
如果纳入研究来自不同人群、不同终点、不同测量工具,标准差会有明显差异。此时即便没有发表偏倚,漏斗图也可能不对称。
这也是为什么在解释漏斗图之前,要先看异质性。
- I²≤50%,异质性相对可接受。
- I²在50%到75%之间,异质性偏高。
- I²>75%,提示异质性很高。
异质性高时,先别急着说发表偏倚。
4.3 标准差公式要与研究类型匹配
不同类型结局,标准差换算策略不同。
- 连续型结局,常需要均值和标准差。
- 生存结局,多数不直接用标准差,而是看HR及其SE。
- 二分类结局,核心通常是RR、OR或RD。
所以,标准差公式不是万能模板。必须结合结局类型和原始数据形式使用。
5. 敏感性分析是验证标准差和发表偏倚结论的关键一步
5.1 逐一剔除研究,看结果是否稳健
敏感性分析的核心很直接。把每篇研究轮流剔除,观察合并效应量是否明显变化。 如果删掉某一项后,结果从显著变成不显著,或者方向发生逆转,就说明该研究影响很大。
这一步对发现“抑制性来源”很有价值。它能帮助你判断,究竟是某篇研究的数据质量有问题,还是整体现象真的不稳定。
5.2 敏感性分析能间接提示标准差问题
如果某篇研究的标准差是估算出来的,而不是原始报告的,那么它对总体结果的影响可能更大。
一旦敏感性分析显示“删掉它后结果明显稳定”,就要回头检查:
- 标准差公式是否选对。
- 是否误把标准误当标准差。
- 是否存在极端值。
- 是否录入错误。
敏感性分析不是附加项,而是方法学自检。
5.3 结论不稳定时,应主动降低解释强度
如果异质性高、漏斗图不对称、敏感性分析不稳,就不要强行给出强结论。更稳妥的做法是:
- 如实报告偏倚风险。
- 说明标准差来源和换算方法。
- 在讨论中承认证据等级有限。
- 必要时补做定性分析。
6. 写作和投稿时,如何把这两部分交代清楚
6.1 方法部分要写明标准差来源
建议明确写出以下内容。
- 标准差来自原文报告,还是通过公式换算。
- 若换算,采用了什么规则。
- 是否对连续变量做了分布假设。
- 是否进行了统一单位转换。
这能显著减少审稿人对统计方法的质疑。
6.2 结果部分要同时报告偏倚和稳健性
结果部分建议至少包含三点。
- 漏斗图是否对称。
- Egger或Begg检验的P值。
- 敏感性分析是否改变总体结论。
只有把这三部分一起写,才能形成完整证据链。
6.3 讨论部分要解释局限,而不是回避问题
如果研究数量少于9篇,或者标准差多来自估算,最好直接说明。
这不是减分项,反而体现严谨。
对临床论文而言,审稿人最看重的不是“结果显著”,而是你是否知道结果为什么显著、为什么不稳、以及哪里可能有偏差。
总结Conclusion
发表偏倚和标准差公式,表面上是两个问题,实际上紧密相连。标准差估算是否准确,会直接影响效应量、置信区间、漏斗图和敏感性分析。 在Meta分析中,只有把数据提取、公式换算、偏倚检测和稳健性分析放在同一条逻辑链上,结论才更可靠。
如果你正在做系统评价、Meta分析或论文投稿,建议从一开始就规范处理标准差来源,减少后期返工。想更高效地完成文献整理、统计分析和图表输出,可以了解解螺旋,让复杂的Meta分析流程更清晰、更省时。
- 引言Introduction
- 1. 为什么要把发表偏倚和标准差公式放在一起看
- 2. 标准差公式在Meta分析中的常见应用
- 3. 发表偏倚的识别,不只看漏斗图
- 4. 标准差公式如何影响发表偏倚判断
- 5. 敏感性分析是验证标准差和发表偏倚结论的关键一步
- 6. 写作和投稿时,如何把这两部分交代清楚
- 总结Conclusion