

 13
 分享
全文概要
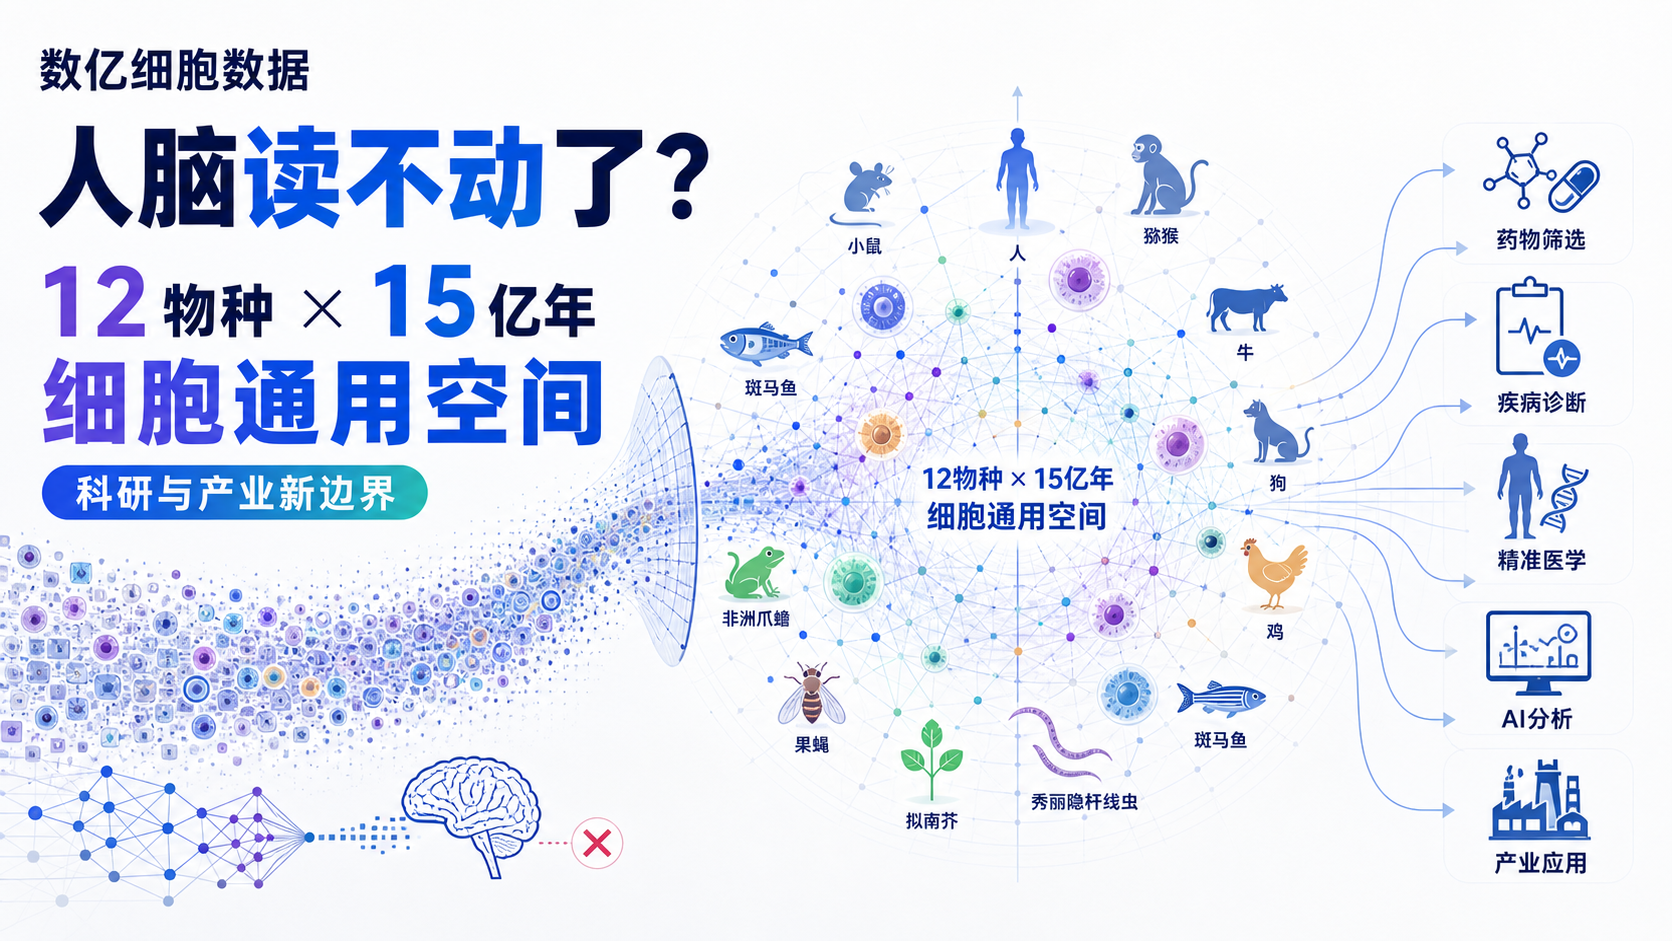
2026年9月,斯坦福大学Stephen Quake与Jure Leskovec团队联合Chan Zuckerberg Initiative(CZI)在《自然》与《科学》背靠背发表两项成果:通用细胞嵌入(Universal Cell Embedding, UCE)与生成式细胞基础模型TranscriptFormer。前者把来自不同实验室、组织甚至物种的细胞映射到统一的数学空间;后者以1.12亿个细胞、12个物种、跨越15.3亿年进化的基因表达数据训练,像"细胞界的ChatGPT"一样学习跨物种通用的细胞"语言"。团队称这标志着一个全新领域的开端,并为疾病研究、跨物种比较与细胞治疗设计带来新工具。
1. 数亿个细胞数据,人脑已经"读不动"了
每个细胞携带同一套基因组,却只"打开"其中一部分基因:胰腺β细胞开启胰岛素相关基因,B细胞开启抗体基因,皮肤细胞开启色素相关基因。正是"打开哪些基因"决定了细胞的身份与状态。近年来,单细胞图谱已积累数亿个细胞、数万个基因的表达数据,但如何同时理解如此海量、异质、跨物种的信息,成为人脑无法企及的难题。
斯坦福团队的答案是"给研究者加一双AI的眼睛"。两个模型分工明确:UCE先建立坐标,把不同来源的细胞放进同一个可度量"相似或不同"的抽象数学空间,让原本拼不起来的图谱有了统一底图;TranscriptFormer再完成"完形填空"——它的训练方式类似ChatGPT,只是预测的不是缺失的词语,而是缺失的基因表达值,从而学会细胞内基因协同工作的通用规律。
2. 12个物种、15亿年进化训练出的"细胞通用空间"
TranscriptFormer的训练集覆盖12个物种——从单细胞酵母,到小鼠、兔、鸡、斑马鱼、果蝇、非洲爪蛙、疟原虫、海胆、海绵、秀丽隐杆线虫,直至人类,最大跨物种进化距离达6.85亿年,全部细胞被映射到一个1280维的潜空间。尽管物种差异巨大,模型发现不同物种的细胞遵循相似的基因协同规则,这正是它能跨物种工作的原因。
在应用层面,这套模型展现出几个引人注目的能力:对未参与训练的物种完成细胞类型鉴定;零样本区分人类健康与病变细胞;甚至"想象"出当前尚不存在的功能细胞,为细胞治疗与再生医学的理性设计提供搜索空间。一个耐人寻味的进化生物学验证是:在"海绵没有神经元,但哪类细胞最接近神经元"这一老问题上,模型提示领细胞(choanocyte)的表达谱最接近线虫与蛙的神经元,可能是神经元进化起源的候选者;而名字里带"神经"的"类神经细胞"表达谱反而更接近蛙的腺细胞。Quake表示,这只是一个全新领域的开端,后面还有十年工作等着全球生物学家去做。
3. 对科研与产业的意义及边界
对科研工作者而言,这套"细胞基础模型"意味着研究非模式生物不必再"瞎子摸象",可直接在通用空间中与已知细胞类型对齐;对产业端而言,最大的想象空间在于"设计不存在的细胞"——若其预测能被湿实验反复验证,将直接影响CAR-T、类器官、干细胞分化等细胞治疗管线的设计效率。但边界同样需要正视:模型目前主要学习转录组,尚未整合表观、蛋白与空间组学等多模态信息;12个物种仍偏向模式生物,植物、真菌与无脊椎动物覆盖不足;其生成的"虚构细胞"的生物学可行性,仍需实验室逐一验证。
来源:《自然》UCE论文、《科学》TranscriptFormer论文、斯坦福大学医学院新闻稿、科技日报等媒体报道
声明:本文资讯来源于公开报道及学术期刊,仅作行业信息传播,不构成临床用药建议。转载需注明来源。
- 1. 数亿个细胞数据,人脑已经"读不动"了
- 2. 12个物种、15亿年进化训练出的"细胞通用空间"
- 3. 对科研与产业的意义及边界