30
 分享
引言Introduction
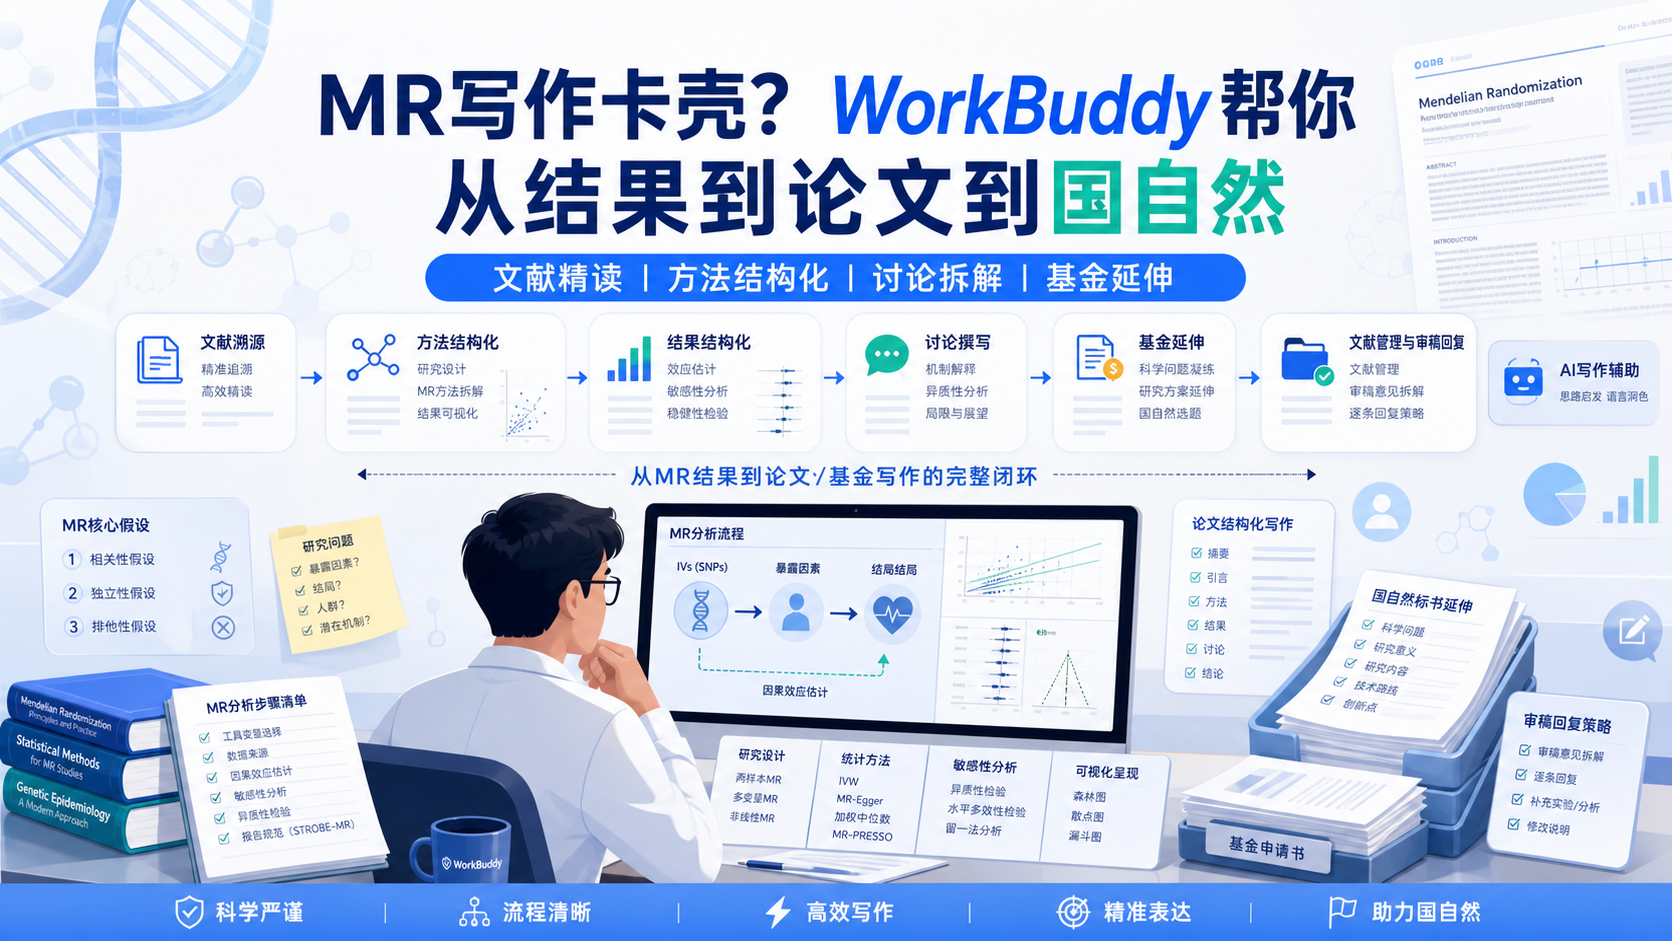
孟德尔随机化写作最耗时的,不是下分析结论,而是文献溯源、方法整合和课题表达。很多人能跑完MR,却卡在“怎么把结果写成一篇像样的论文,甚至国自然标书”。WorkBuddy把分析、文献、写作串成一条流程,能明显减少重复劳动。
1. 为什么孟德尔随机化写作最容易卡壳
1.1 结果有了,论文还是写不出来
MR研究的核心难点,往往不在统计本身。IVW、MR-Egger、加权中位数、异质性检验、敏感性分析,这些结果很多团队都能做出来。真正耗时的是把这些数字转成可投稿的语言。
常见问题有三个。
- 方法部分重复套写,缺少针对MR设计的表达。
- 讨论部分没有围绕因果推断展开,容易写成泛泛综述。
- 文献分散,既往研究、机制解释和局限性难以快速串联。
对于医学生、临床科研人员和基础转化研究者来说,这些问题会直接拉长成文周期。尤其是当项目还要兼顾开题、结题和基金申请时,时间成本会被进一步放大。
1.2 文献溯源是最容易被低估的一步
MR写作不是只看你自己的结果,还要回到原始证据链。比如:
- 暴露因素是否已有流行病学支持。
- 工具变量是否稳定、可重复。
- 终点疾病是否存在既往MR研究。
- 机制解释是否能与临床证据对上。
如果文献没有整理好,讨论部分就很难写深。这也是很多MR文章“结果完整、讨论空泛”的根本原因。
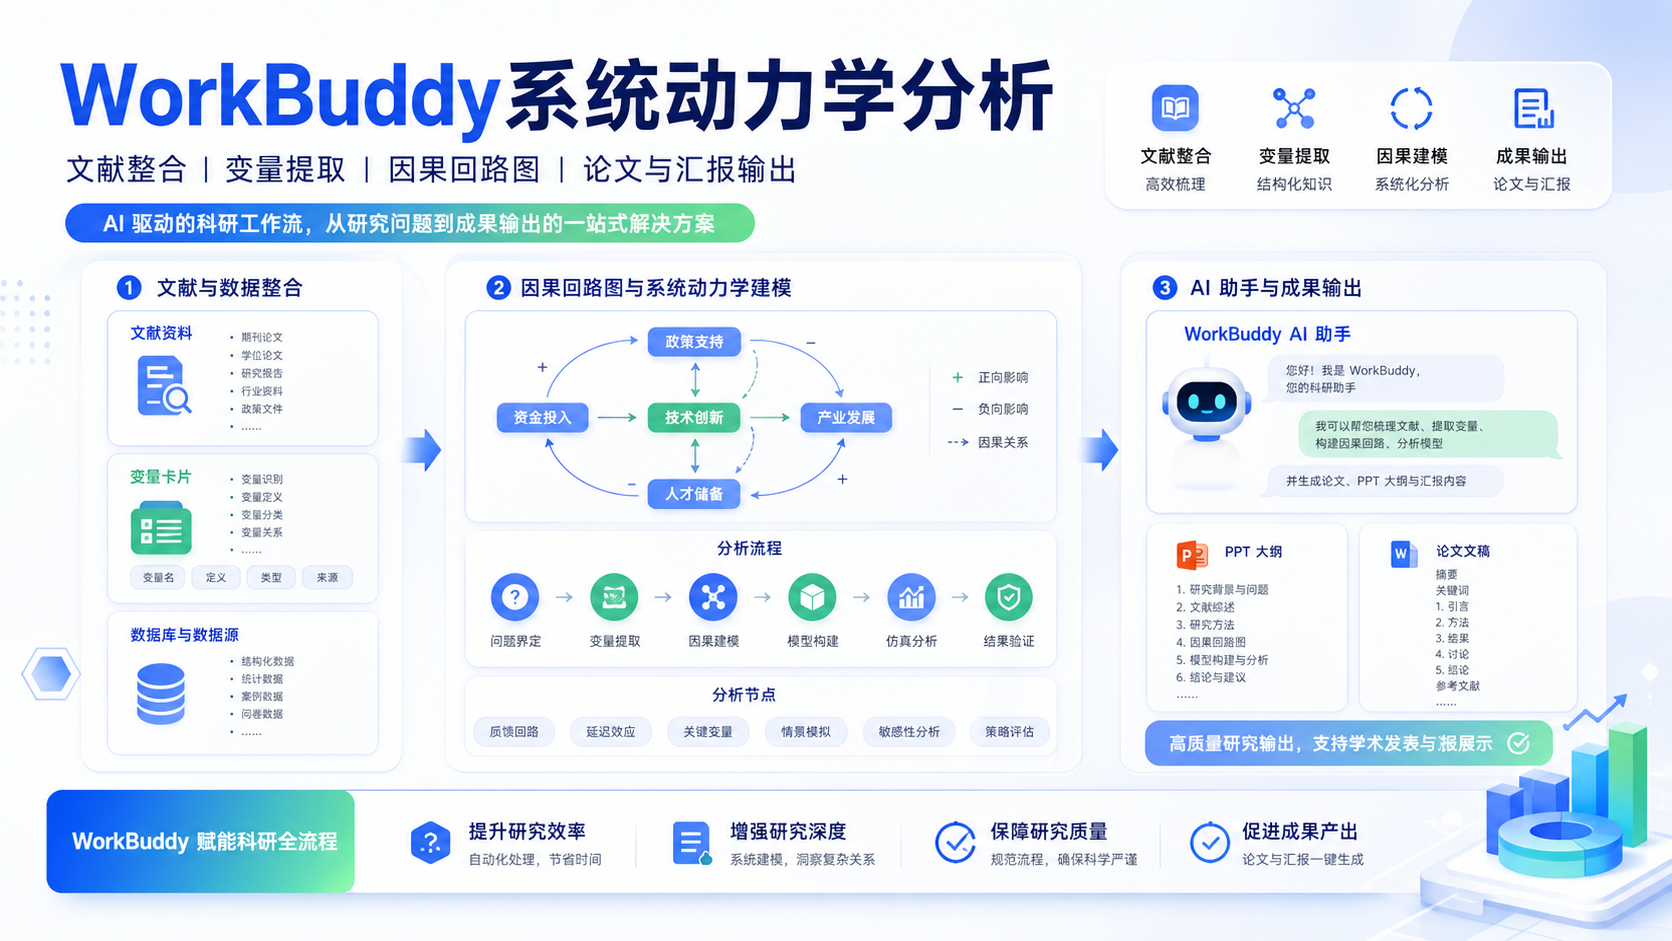
而WorkBuddy的价值,恰好就在于把文献精读、进展导读和写作组织到同一工作流中。
2. WorkBuddy如何覆盖MR全流程
2.1 从文献精读到一句话导读,先把材料理顺
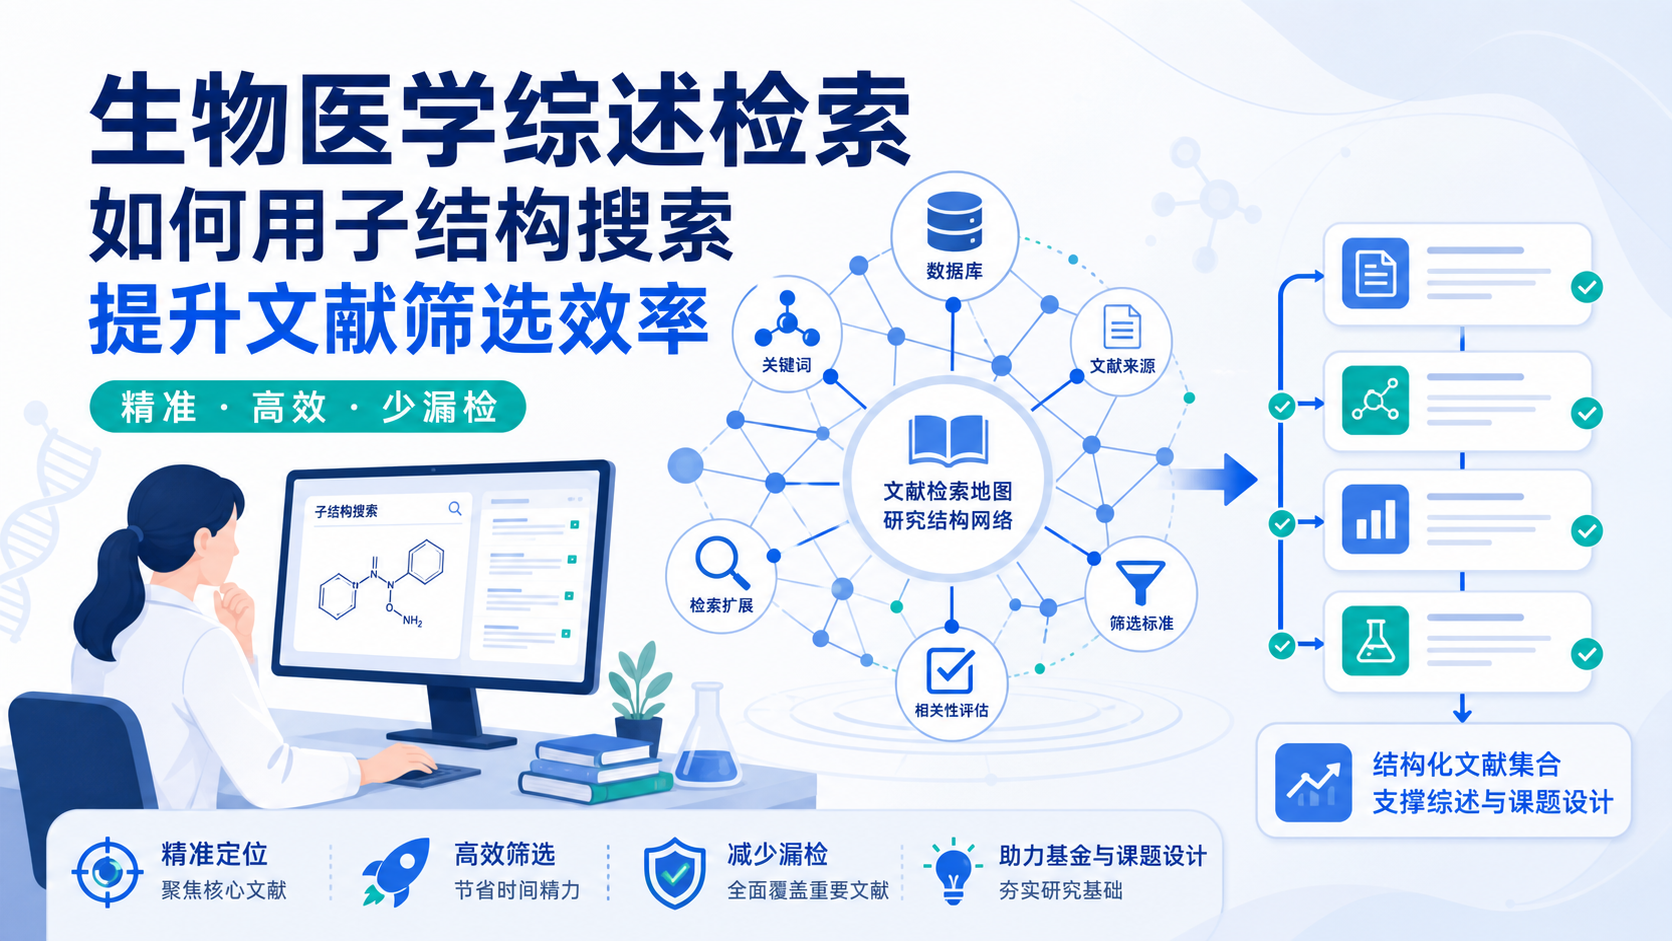
根据知识库中的实操演示,WorkBuddy区分了不同类型文献的处理方式。对于基础研究和生信文章 ,可以用文献阅读报告快速提取研究背景、发现、临床意义,并对图片进行解读。对于临床研究文章 ,则可使用临床文献进展导读和精读。
这对MR写作很关键。因为MR通常需要同时处理三类材料:
- 暴露相关的流行病学或机制文献。
- 终点疾病的临床研究文献。
- 既往MR研究和方法学参考。
导读模式适合快速筛选。精读模式适合单篇深挖。
在临床文献进展导读中,系统可以对多篇文章做一句话总结,便于你把文献放入综述或引言对应位置。对于写MR讨论,这种“一句话提炼”尤其实用,因为它能快速保留每篇文献的关键信息,而不是让你在几十篇PDF里反复翻找。
2.2 方法和结果先结构化,再交给AI生成
WorkBuddy在写作层面的核心思路很清晰:先把方法和结果提供给系统,再生成引言和讨论。
这符合科研写作的基本逻辑。因为AI最适合做的是结构化表达和语言组织,不是替代真实研究过程。
在知识库演示中,MR写作工具的输入包括:
- 方法部分。
- 结果部分。
这些内容通常可以直接来自个性化数据分析报告。换句话说,如果你的MR分析已经完成,WorkBuddy能把“数据结论”转成“论文表达”。
这一步对提升效率很明显,尤其适合需要批量推进文章的科研团队。
2.3 讨论部分被拆得更细,才更像专业写作
MR文章最难写的是讨论。WorkBuddy把讨论拆分为开头、主体和结尾,这一点非常实用。知识库中提到,它还进一步按分析类型和内容重点细分,比如:
- 通用讨论。
- 机器学习相关讨论。
- 孟德尔随机化相关讨论。
- 既往研究对照。
- 机制解释。
- 研究优势与局限性。
这种拆分的意义在于,讨论不再是“空写一大段”,而是按逻辑模块逐层展开。
对MR来说,标准讨论结构通常包括:
- 先概括主要因果发现。
- 再对照既往研究是否一致。
- 然后解释可能机制。
- 最后写局限性和临床意义。
如果用工具辅助,写作者就能把注意力放在“内容是否成立”上,而不是反复纠结句式和段落顺序。
3. 从论文到国自然,WorkBuddy的延伸价值
3.1 MR结果不仅能写文章,也能转化成课题语言
很多研究者把MR当成单篇论文工具,但实际上,它也适合国自然选题。原因很简单。MR能够帮助你从“关联”走向“因果假说”,这正是基金申请非常看重的逻辑起点。
知识库中提到,基金工作台支持两种场景:
- 有科学假说。
- 没有科学假说。
同时还支持:
- 有前期工作。
- 无前期工作。
这意味着,MR结果可以被进一步提炼为科研问题。
例如,当你已经有一个稳定的暴露-结局因果链条,就可以围绕分子机制、临床路径或干预靶点延伸。这样写出来的课题,不是凭空想象,而是建立在前期分析基础上的延续性工作。
3.2 国自然写作最需要的是“延续性”
知识库明确提到,系统会默认国自然喜欢延续性工作,并从上传文章中提炼分子和科研问题,设计延续性课题。这个思路非常符合基金评审逻辑。
国自然申请时,常见的高质量表达包括:
- 前期已经发现某暴露与疾病存在因果关联。
- 已有数据支持某通路或分子参与其中。
- 下一步拟验证机制链条或干预价值。
MR在这里的作用,不是替代实验,而是帮你把课题起点写得更硬。
如果你同时有临床样本、数据库分析或基础实验结果,WorkBuddy可以把这些内容接成一条完整叙事线,提升课题的连续性和可信度。
3.3 文献管理、降重和审稿回复也能补齐最后一公里
除了写作主流程,知识库里还提到几个实用功能:
- 英文文章润色。
- 论文降重。
- AI降痕。
- cover letter生成。
- 审稿回复生成。
对于MR论文来说,这些功能很现实。因为从投稿到修回,真正消耗时间的,往往是格式修改和审稿意见逐条回应。
如果你的MR文章已经写好,后续最需要的就是把语言打磨到投稿水平。
如果遇到返修,审稿回复工具可以帮助快速组织回应框架,再由作者进行事实核对和人工修订。这样能减少低价值重复劳动。
4. 实战建议:如何把WorkBuddy真正用在MR项目里
4.1 先做三步准备
要让工具真正发挥作用,建议先完成这三步:
- 统一整理方法部分,明确工具变量筛选、敏感性分析和统计模型。
- 汇总结果部分,保留关键效应值、P值和稳健性结论。
- 准备文献材料,按暴露、结局、机制三类归档。
准备得越结构化,AI生成的内容越稳定。
这是因为AI并不是在“理解你的项目”,而是在基于输入材料做高质量重组。输入越清晰,输出越接近可用稿。
4.2 写作顺序要对,别一上来就写引言
建议的顺序是:
- 先完成分析报告。
- 再整理方法和结果。
- 然后让工具生成引言和讨论。
- 最后人工补充文献和逻辑。
这个顺序很重要。因为MR文章最容易出问题的地方,恰恰是前后逻辑不一致。先有结果,再写叙事,往往比先写大纲更稳。
4.3 基金写作要把“因果发现”翻译成“科学问题”
如果你的目标不是单篇文章,而是国自然,建议重点关注两件事:
- 你的MR结果能否支持一个明确、可验证的问题。
- 这个问题能否自然延伸到机制或干预。
比如,因果链条明确后,就可以进一步问:
- 作用是否依赖某条通路。
- 是否存在组织特异性。
- 是否能在临床样本中验证。
这类问题,比单纯重复MR结论更适合基金写作。
而WorkBuddy的优势,在于它可以把文献导读、写作模块和基金思路串起来,减少从“数据”到“文字”之间的断层。
总结Conclusion
孟德尔随机化真正难的,从来不只是分析,而是如何把分析结果变成论文、综述和基金语言。WorkBuddy的价值,在于把文献溯源、结果组织、讨论拆分和国自然延续性写作连接成一条可执行流程。
对于医学生、医生和科研人员来说,这意味着更少的重复劳动,更快的成稿速度,以及更清晰的课题叙事。
如果你正在做MR项目,或者正在为国自然、综述、修回意见发愁,可以尝试用解螺旋的WorkBuddy把分析和写作衔接起来。 它更适合做“科研流程加速器”,而不是替你跳过专业判断。真正高质量的输出,仍然来自工具效率和研究者判断的结合。
- 引言Introduction
- 1. 为什么孟德尔随机化写作最容易卡壳
- 2. WorkBuddy如何覆盖MR全流程
- 3. 从论文到国自然,WorkBuddy的延伸价值
- 4. 实战建议:如何把WorkBuddy真正用在MR项目里
- 总结Conclusion