17
 分享
引言Introduction
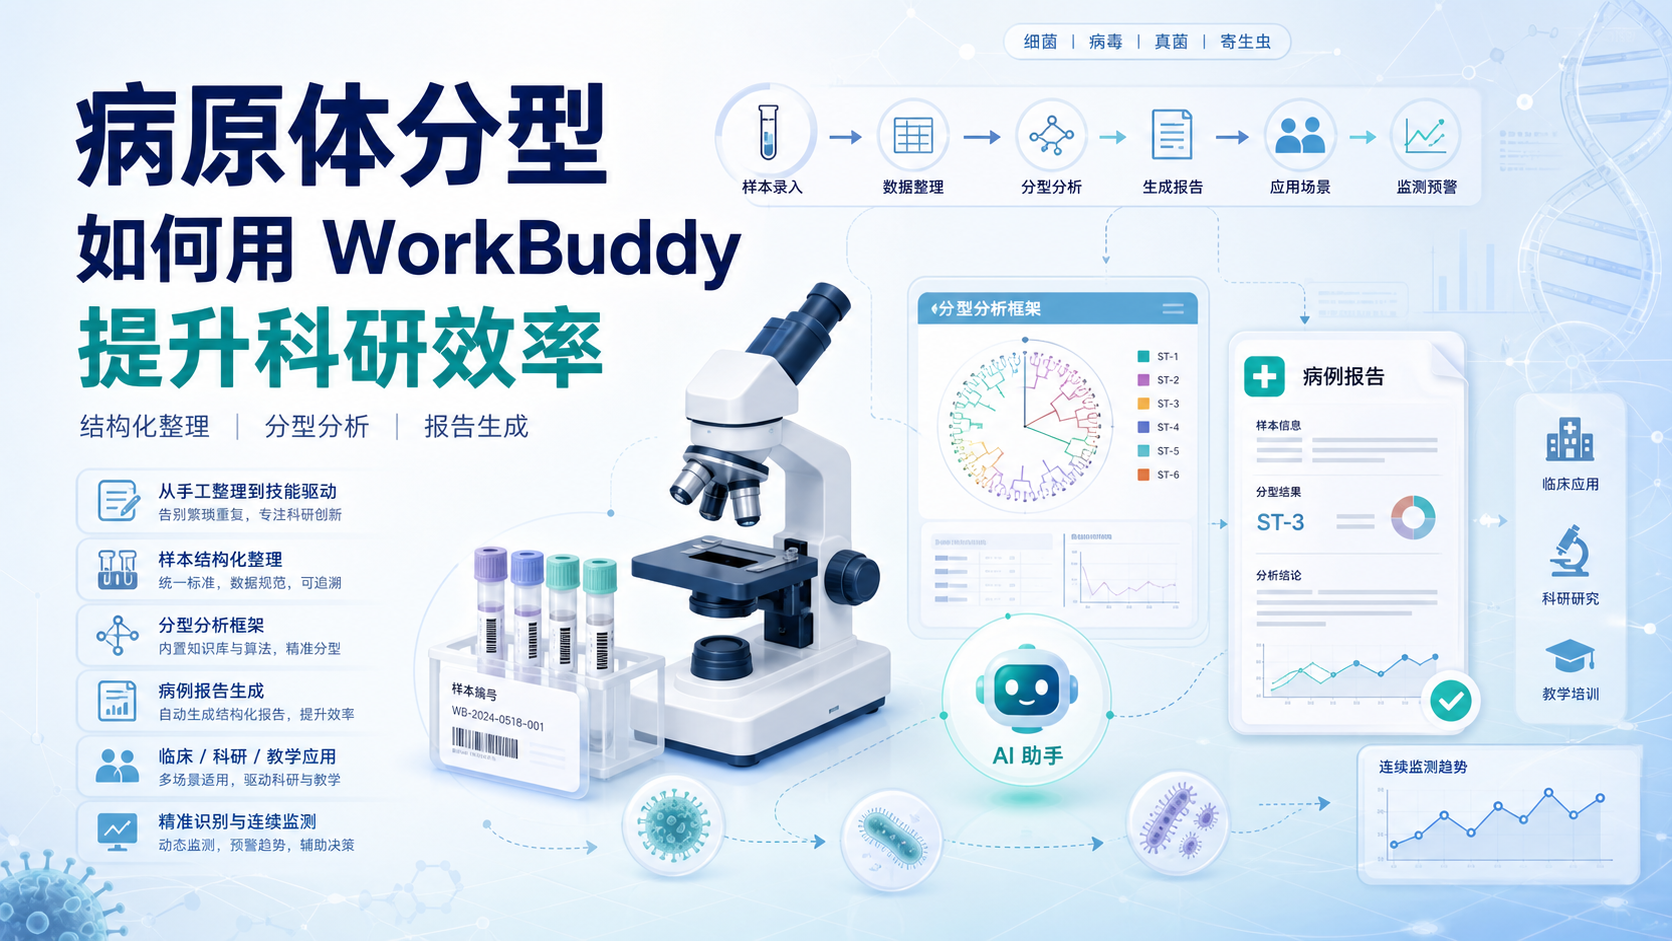
病原体分型是临床感染诊断和流行病学追踪的关键环节,但传统流程常受限于样本量大、分析链条长、人工整理耗时等问题。当数据越来越复杂,医生和科研人员最缺的不是信息,而是高效、可重复的分析路径。
1. 为什么病原体分型需要新的工作方式
1.1 传统分型流程的效率瓶颈
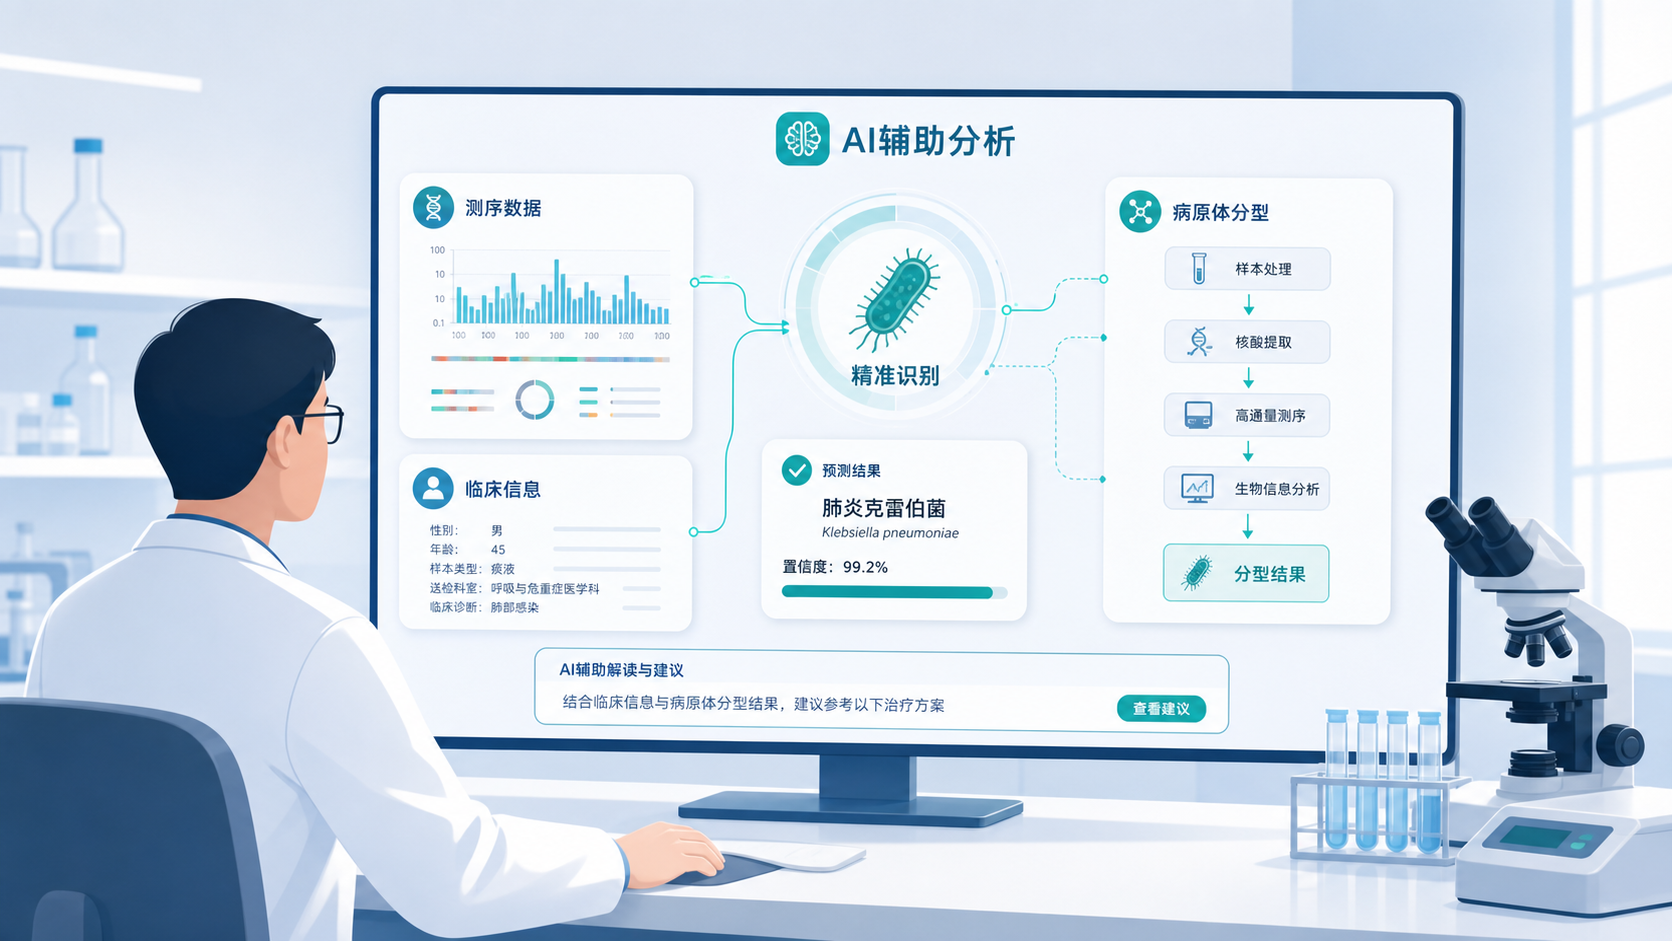
病原体分型常涉及培养结果、PCR、测序、耐药谱、临床表型等多源数据。每一步都可能产生大量待整理信息。对临床医生而言,最耗时的不是单个结果读取,而是把分散数据串成可解释、可复核的证据链 。
在科研场景中,这一问题更加明显。比如一项研究若包含多个菌株、不同时间点样本、不同患者结局,人工整理不仅费时,还容易出现字段遗漏、命名不一致、版本混乱等问题。对于需要提交课题、论文或院感分析报告的人来说,这些问题会直接拖慢进度。
1.2 病原体分型对标准化的要求更高
分型不是简单“分组”。它要求分析过程可追溯,判断标准一致,结果能对应临床问题。常见目标包括:
- 判断是否为同源传播。
- 区分定植与感染。
- 识别耐药克隆株扩散。
- 追踪院内暴发来源。
- 为治疗方案和感染控制提供依据。
如果输入数据格式不统一,输出结论再漂亮也难以落地。 这也是病原体分型比普通数据整理更依赖标准化流程的原因。
2. WorkBuddy如何重塑病原体分型流程
2.1 从“手工整理”转向“技能驱动”
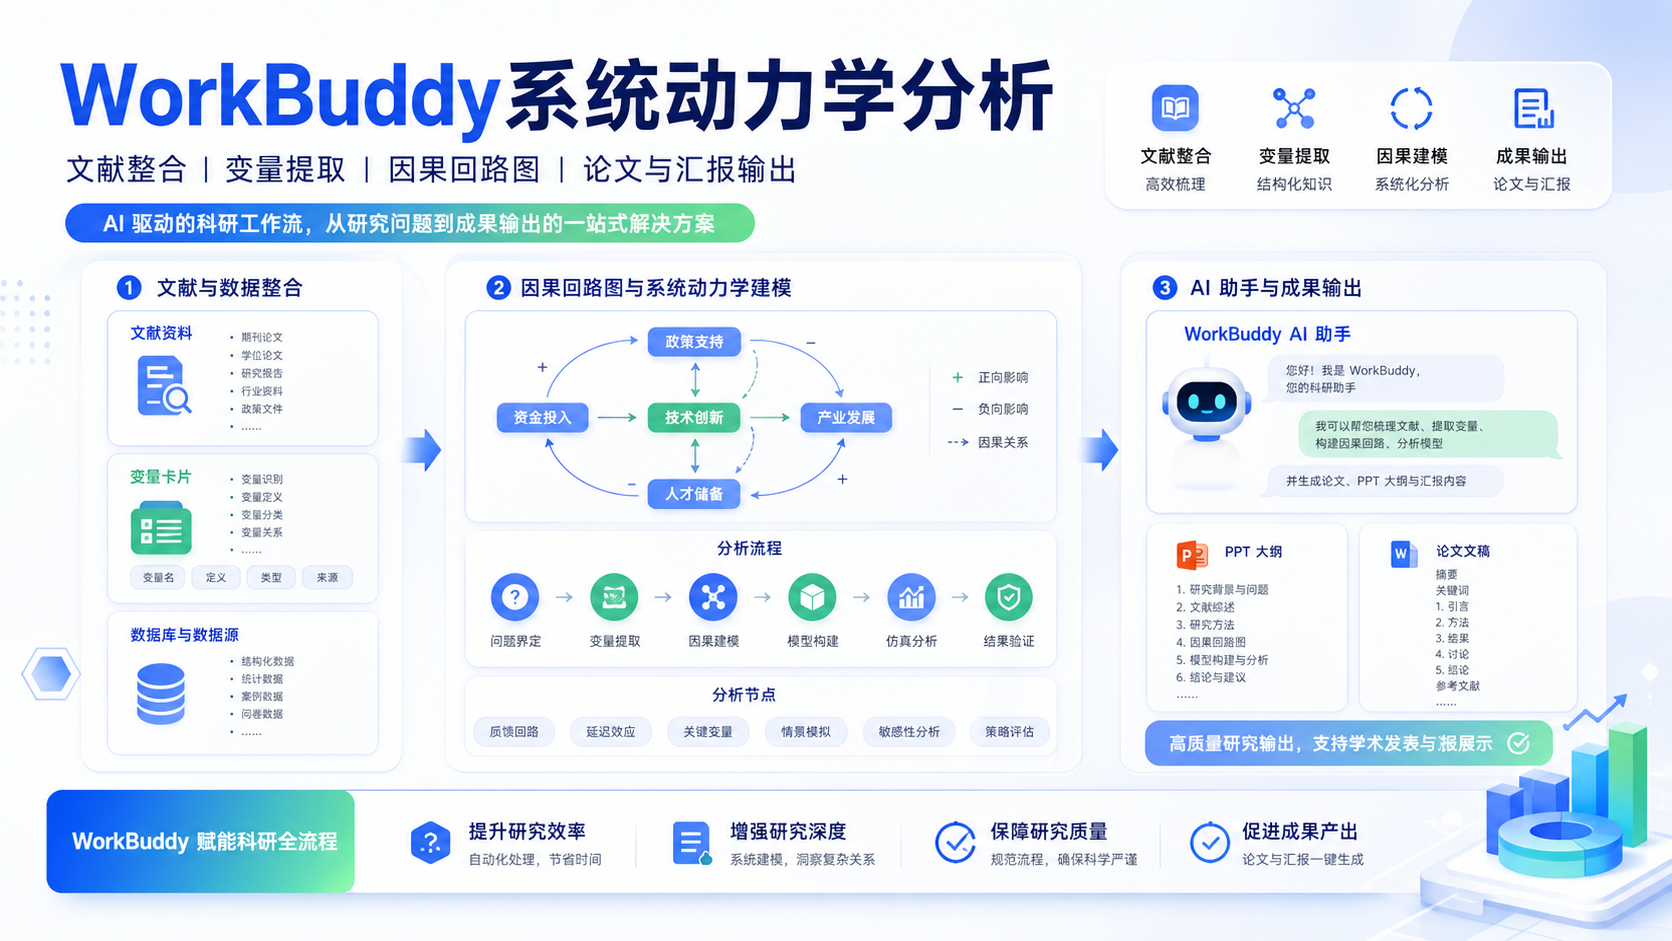
根据上游知识库中的实践思路,WorkBuddy的核心价值不在于单次回答,而在于通过“skill”把专业任务流程化。对于病原体分型,这意味着可以把分型所需的字段、判断逻辑、模板要求预先写入技能包,让系统按固定规则执行。
这种方式的优势很明确:
- 减少人工反复解释同一类任务。
- 提升分析路径一致性。
- 便于按科室、场景、病原体类型做定制。
- 更适合临床与科研的重复性任务。
例如,针对细菌分型,可以把样本来源、分离时间、菌种鉴定、药敏结果、序列类型、核心变异位点等设为必填字段。系统先完成结构化提取,再进入分型判断。这样比临时让AI“自由发挥”更稳定。
2.2 更适合复杂病例和多样本场景
病原体分型常遇到几个高频难点:
- 同一患者多次送检,记录分散。
- 不同实验平台结果格式不一致。
- 临床信息和实验室信息未对齐。
- 需要同时比较多个菌株或多个患者样本。
WorkBuddy的思路是把这些步骤拆开,再用技能包串联。先提取关键字段,再统一模板,再输出初步分析框架。这比直接生成最终结论更符合临床科研的真实工作流。
对医生来说,这种方式的价值在于节省时间。对科研人员来说,价值在于减少前期清洗成本,让更多精力回到问题设计和结果解释上。
3. 病原体分型场景中,WorkBuddy可落地的三类任务
3.1 样本信息结构化整理
病原体分型前,第一步通常是整理样本信息。包括患者基本资料、采样时间、样本类型、分离菌株编号、检测方法和实验结果。若缺少这一层整理,后续的分型分析很难稳定复现。
WorkBuddy可以将这类信息自动整理成统一模板。比如固定输出:
- 患者编号。
- 标本来源。
- 采样日期。
- 检测平台。
- 物种鉴定结果。
- 耐药表型。
- 分型相关关键指标。
结构化后的数据更利于后续统计、绘图和比较分析。 这对院感监测和论文撰写尤其重要。
3.2 分型分析框架生成
对于科研人员,真正难的是从“数据”走到“分析逻辑”。例如,一项菌株分型研究不仅要说明分型结果,还要说明分型依据、比较维度和临床关联。WorkBuddy可基于上传资料提炼分析套路,形成初步框架。
这类框架通常包括:
- 研究对象与纳排标准。
- 分型技术路线。
- 样本间相似性比较。
- 克隆传播或聚集性判断。
- 与临床结局的关联分析。
它解决的是“从哪里开始写、先分析什么”的问题。 这对研究生、住院医和青年科研人员非常实用。
3.3 病例报告和研究草稿生成
病原体分型常最终服务于病例报告、暴发调查报告或科研论文。WorkBuddy更适合作为起稿工具。它先把信息按逻辑排好,再由人工校验和补充。
这里要强调一点。AI输出不能替代专业判断。 尤其在分型结论、传播链推断和耐药机制解释上,必须由临床医生、微生物学者和感染控制团队共同审核。WorkBuddy的作用是提速,不是替代。
4. 为什么它比“通用AI问答”更适合专业分型任务
4.1 通用模型能回答问题,但不擅长固定流程
很多通用AI能解释名词,也能生成摘要,但在专业工作里,最缺的是流程一致性。病原体分型的输出必须满足固定字段和专业规则。若没有预设技能,模型很容易出现:
- 重点漂移。
- 字段缺失。
- 术语不统一。
- 结论过度泛化。
WorkBuddy的价值在于,它可以把这些要求写成可执行的技能包。也就是说,不是让AI“猜”,而是让AI按规范“做”。
4.2 适合临床、科研、教学三种角色
对临床医生,它能帮助整理病例,节省文书时间。
对科研人员,它能加速数据清洗和分析框架搭建。
对医学生,它能帮助理解分型逻辑,建立标准化思维。
这种工具的真正意义,不只是效率提升,而是让不同层级的用户都能在同一套规范下工作。这有助于提高结果的一致性,也更符合未来精准医学的数据协作方向。
5. 病原体分型如何与临床精准识别接轨
5.1 从“识别病原”到“识别传播模式”
精准识别不只是知道是什么菌,还要知道它是否属于同一传播链。对于院内感染、重症感染和耐药菌扩散,分型结果往往比单次药敏更能支持决策。
例如,在暴发调查中,如果多个病例的分离株显示高度一致,就提示可能存在共同来源或院内传播。此时,分型结果可以直接影响隔离策略、环境消杀和抗菌药物管理。
5.2 从单点结果到连续监测
临床精准识别的核心趋势是连续化监测。单个病原体分型结果价值有限,但将多个时间点、多个病区、多个患者的数据串联后,价值会明显放大。WorkBuddy在这里的意义,是帮助团队把零散记录快速整合成连续证据。
这对医院感染管理部门、检验科和科研团队都很重要。因为真正有价值的分型,不是只给出一个分类结果,而是能支持后续干预和回顾分析。
6. 实际使用中应注意的三个问题
6.1 输入数据必须足够规范
AI再强,也离不开高质量输入。 如果样本编号混乱、时间记录缺失、分型方法不明,输出质量一定受影响。使用前应先统一命名规则、字段格式和结果来源。
6.2 关键结论必须人工复核
尤其涉及传播关系、克隆同源、耐药机制推断时,必须由专业人员复核。AI可以帮助找线索,但不能替代最终判断。临床风险高的场景,宁可慢一点,也不能错一步。
6.3 技能包要持续更新
病原体分型方法在更新,数据库在更新,临床指南也在更新。技能包不是一次写完就结束,而是要持续迭代。只有这样,输出才不会过时。
7. 让WorkBuddy真正成为病原体分型的生产力工具
WorkBuddy最有价值的地方,在于它把病原体分型从“零散操作”变成“标准流程”。当你把病原体信息、病例资料、分型指标和分析规则写入skill后,系统就能更稳定地输出结构化结果。这类能力特别适合需要重复整理数据、频繁做分型比较、又必须保证规范性的临床科研场景。
如果你正在做病原体分型相关课题,或者需要把大量病例整理成可分析的数据表,建议优先建立自己的技能包模板。像解螺旋这样的专业平台,可以帮助你更快完成流程搭建、模板优化和科研起稿,让分型分析不再从零开始。
总结Conclusion
病原体分型正在从传统人工分析,走向标准化、流程化和智能化。WorkBuddy的优势,不是替代专业人员,而是通过技能包把复杂任务拆解、固化和提效。它适合临床医生、科研人员和医学生在分型整理、分析框架、病例写作中使用。
如果你希望把病原体分型做得更快、更稳、更规范,可以借助解螺旋完善你的工作流。让专业数据整理和科研表达更高效,也让临床精准识别真正落地。
- 引言Introduction
- 1. 为什么病原体分型需要新的工作方式
- 2. WorkBuddy如何重塑病原体分型流程
- 3. 病原体分型场景中,WorkBuddy可落地的三类任务
- 4. 为什么它比“通用AI问答”更适合专业分型任务
- 5. 病原体分型如何与临床精准识别接轨
- 6. 实际使用中应注意的三个问题
- 7. 让WorkBuddy真正成为病原体分型的生产力工具
- 总结Conclusion