52
 分享
引言Introduction
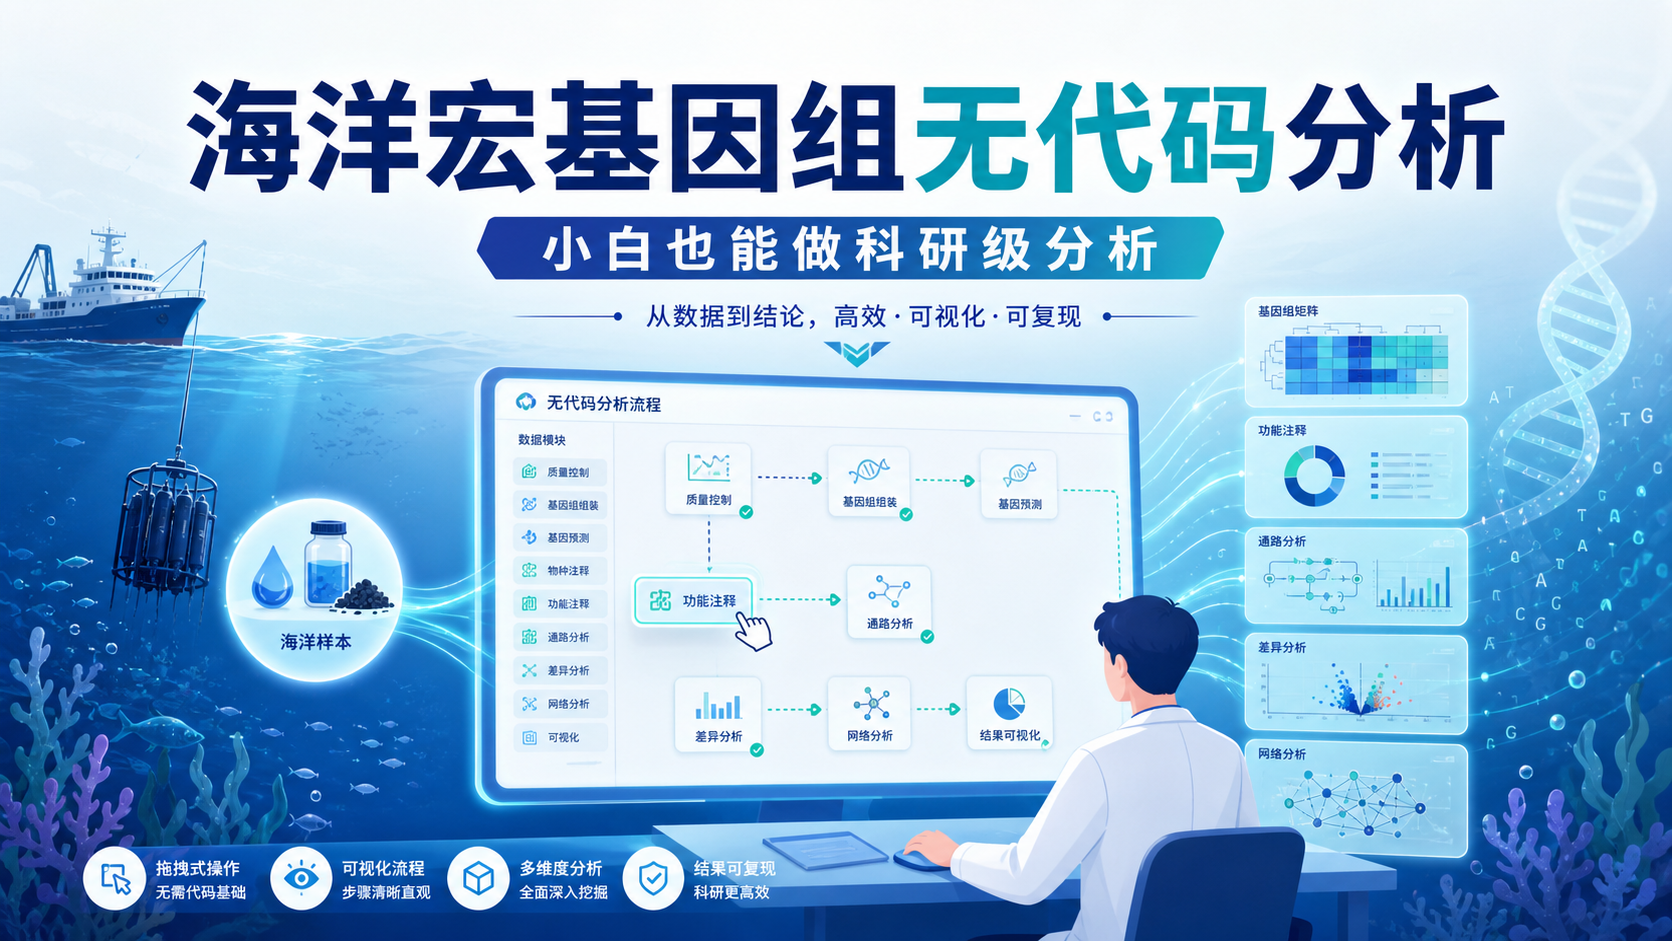
海洋宏基因组数据体量大、物种复杂、注释难度高。很多研究者拿到测序结果后,最卡的不是“有没有数据”,而是如何快速完成清洗、注释、筛选和可视化,并把结果转成可发表的问题 。对医学生、医生和科研人员来说,掌握无代码流程,能显著降低入门门槛。
1. 海洋宏基因组研究为什么更需要无代码流程
1.1 海洋样本的复杂性决定了分析门槛更高
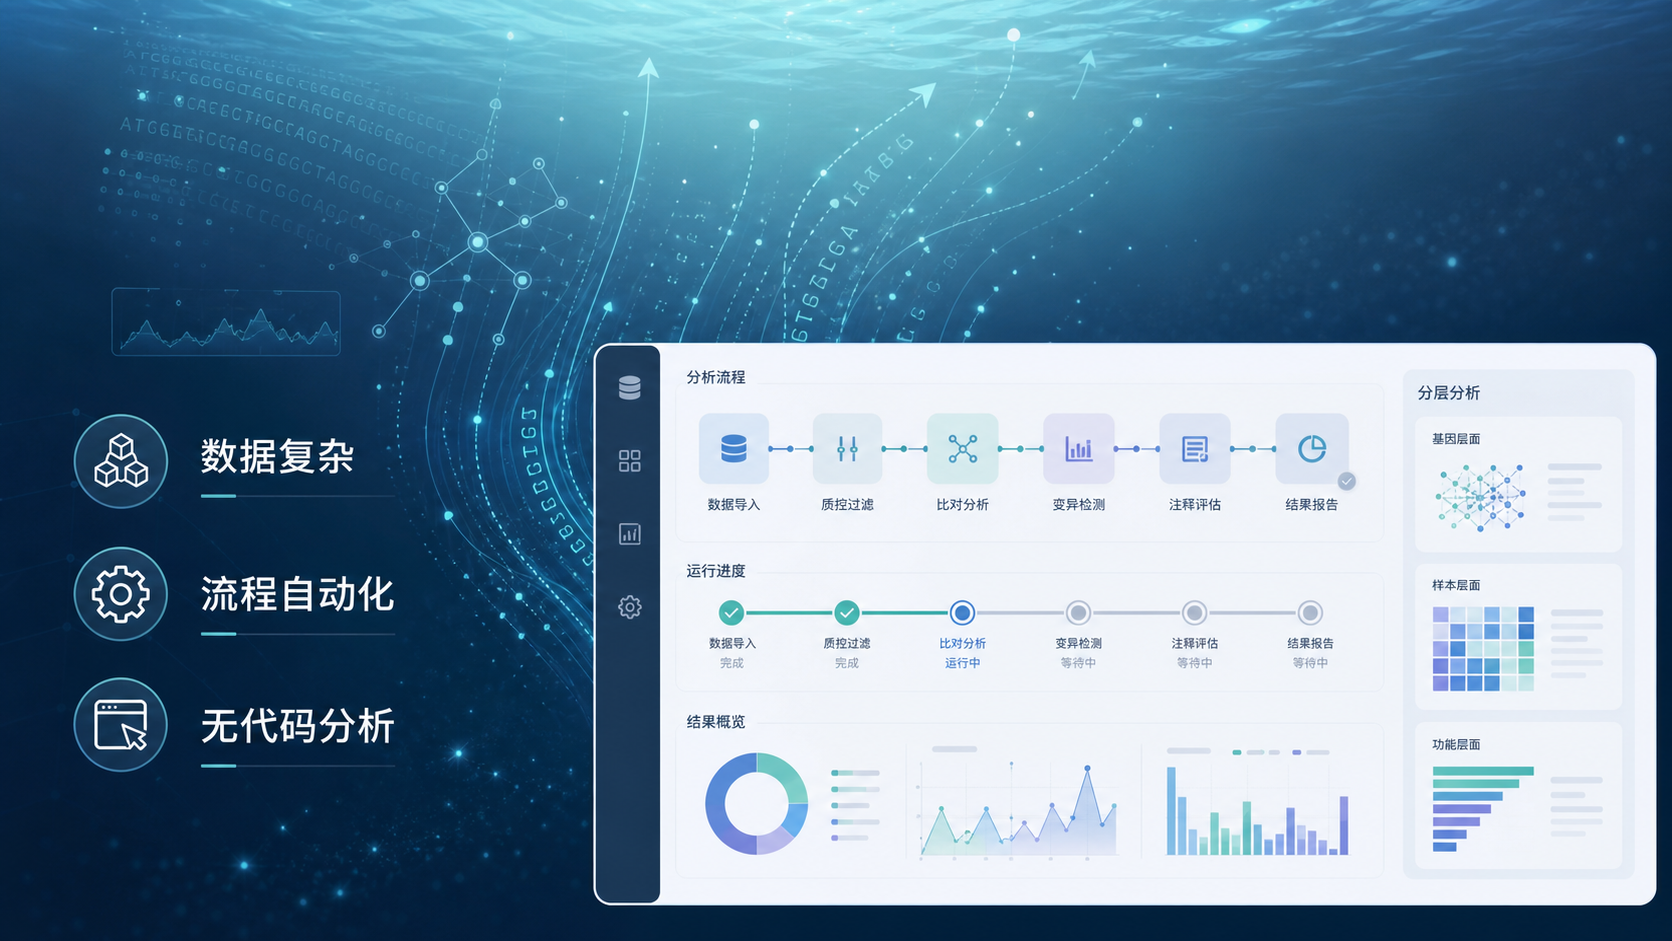
海洋宏基因组常见于海水、沉积物、珊瑚共生体系、深海热液和极端环境样本。与单个物种转录组不同,它面对的是混合群落、低丰度信号、污染序列和高维特征矩阵 。这意味着,研究者不仅要处理测序数据,还要面对组装、去冗余、物种注释、功能注释和群落比较等多个环节。
在实际项目中,最容易拖慢进度的是数据清洗和标准化。样本批次不同、测序深度不同、缺失值不同,都会影响后续差异分析。如果前处理不稳,后面的统计结论就很容易偏。 这也是为什么海洋宏基因组特别适合引入无代码流程,先把标准步骤固定,再把精力留给科学问题。
1.2 无代码分析的价值不只是“省时间”
无代码并不等于低水平。它的核心价值是把重复、标准化、耗时的步骤交给工具完成。对海洋宏基因组来说,常见收益有三点。
- 缩短从原始数据到结果图的时间。
- 降低脚本报错和环境配置成本。
- 让研究者更专注于假设设计和结果解释。
AI 和无代码工具最适合做的是效率提升,不是替代所有科研判断。 尤其在涉及样本筛选、参数选择和异常值判断时,仍需要研究者基于专业经验做决策。
2. 海洋宏基因组无代码革新的关键环节
2.1 从原始数据到可分析矩阵
海洋宏基因组的基础流程通常包括质控、去接头、宿主去除、组装、基因预测和功能注释。对非计算背景研究者来说,真正难的是把这些步骤串起来,并保持参数一致。
无代码流程的意义就在这里。它可以把上游流程模块化,形成固定模板。常见思路包括:
- 统一输入格式。
- 固定质控阈值。
- 输出标准化特征矩阵。
- 自动生成初步报告。
研究者拿到的不是零散文件,而是一套能直接进入统计分析的结果。
2.2 功能注释和通路分析是海洋样本的重点
海洋宏基因组不只是看“有哪些菌”。更重要的是看这些菌在做什么 。因此,功能注释、KO 分析、GO 分类、KEGG 富集、CAZy 酶家族和抗性基因分析,都是高频需求。
在无代码框架下,研究者通常会先完成以下几类分析:
- 群落组成分析。
- 功能丰度比较。
- 差异通路筛选。
- 相关性网络构建。
- 可视化输出,如热图、柱状图、气泡图和网络图。
如果研究目标是机制解释,功能层面的证据往往比单纯的分类结果更有说服力。
2.3 关联分析要围绕明确问题展开
海洋宏基因组的价值,往往不在“堆图”,而在于把数据和环境变量、临床变量或表型变量联系起来。比如:
- 温度、盐度、pH 与菌群功能是否相关。
- 特定代谢通路是否在不同海域显著富集。
- 抗性基因是否与污染来源有关。
- 共生体系中的关键功能模块是否变化。
这类问题适合用无代码工具做初筛,再决定是否进入更深入的统计建模。先筛问题,再做机制,比一开始就盲目深挖更高效。
3. 海洋宏基因组中值得优先关注的分析策略
3.1 先做差异,再做富集,再做网络
对于多数海洋宏基因组项目,推荐采用“先差异,后解释”的顺序。也就是先找出在不同组别中显著变化的特征,再做功能和通路富集,最后构建互作关系或模块网络。
这一策略的好处是清晰、可复现。常见输出包括:
- 差异丰度表。
- 富集通路列表。
- 核心功能模块。
- 相关性网络图。
- 可发表的结果图谱。
不要一开始就追求复杂模型。对大多数研究,稳定的差异分析和富集分析已经足够支撑高质量论文。
3.2 关注“明星功能模块”而不是只盯单个物种
海洋宏基因组里,单个物种的波动未必能解释表型变化。更有价值的是看功能模块和代谢通路。比如碳氮循环、硫循环、脂多糖合成、氧化应激响应、膜转运系统等,都可能是关键线索。
这与单基因研究的逻辑类似。真正值得追的,往往是处于网络节点位置的功能单元。
当某个模块同时出现在多个样本分组中,并且与环境梯度一致变化时,它就可能成为后续验证的重点。
3.3 用标准化图形输出提升论文表达
海洋宏基因组数据量大,最怕结果堆叠但不清楚。无代码流程的优势之一,就是能快速生成规范图形,帮助读者理解层次关系。
建议优先保留以下图形类型:
- 热图,展示核心特征变化。
- 小提琴图,展示分组差异。
- ROC 曲线,展示分类能力。
- 相关性网络,展示功能联系。
- GSEA 或类似富集图,展示通路方向性。
图不是越多越好,而是要服务于一个明确的科学问题。
4. 无代码并不意味着不需要专业能力
4.1 数据清洗仍然是最难的一环
很多人以为 AI 可以直接替代数据处理,但在海洋宏基因组里,现实并不是这样。样本缺失、异常值、批次效应、低质量 reads 和不一致注释,仍然需要人工判断。
尤其是以下环节,仍建议保留人工审核:
- 样本纳入和排除标准。
- 异常样本识别。
- 批次效应评估。
- 注释结果核对。
- 参数阈值选择。
AI 可以提高效率,但不能代替研究者对数据质量的判断。
如果前处理做得不好,再漂亮的图也只是表面结果。
4.2 学会基础编程仍然有长期价值
对于医学生和科研人员来说,即便主力使用无代码平台,学一点 R 语言或 Python 依然有价值。原因很简单,很多自动化平台在处理特殊样本、定制输出和批量修正时,仍然需要代码控制。
这也是现实中的最佳路径。
先用无代码跑通流程。再逐步学习基础脚本。最后做到:
- 能检查结果是否合理。
- 能识别分析漏洞。
- 能在特殊情况下手工修正。
- 能把自动化流程和个性化需求结合起来。
无代码是起点,不是终点。
5. 解螺旋如何帮助海洋宏基因组研究更快落地
5.1 把复杂流程变成可复用模板
海洋宏基因组项目最大的痛点,是流程长、步骤多、重复劳动多。解螺旋可以把这些高频分析模块标准化,帮助研究者更快完成从数据到图表的转换。对于需要反复做分组比较、功能注释和可视化输出的项目,这种方式能显著减少试错成本。
5.2 让研究者把时间留给科学问题
当工具把基础分析、图形生成和流程串联做好后,研究者就能把更多时间用于问题设计、结果解释和文章打磨。这正是海洋宏基因组从“能做”走向“做好”的关键。
总结Conclusion
海洋宏基因组研究的难点,不只是数据大,更在于流程长、清洗难、注释复杂。无代码生信的价值,在于把标准步骤固定下来,让研究者更快进入差异分析、功能富集和机制解释。对医学生、医生和科研人员来说,最有效的策略是先用工具提效,再用专业判断把结果做实。
如果你正在推进海洋宏基因组项目,可以借助解螺旋 把分析流程标准化,减少重复劳动,更快产出可发表、可解释、可复现的结果。
- 引言Introduction
- 1. 海洋宏基因组研究为什么更需要无代码流程
- 2. 海洋宏基因组无代码革新的关键环节
- 3. 海洋宏基因组中值得优先关注的分析策略
- 4. 无代码并不意味着不需要专业能力
- 5. 解螺旋如何帮助海洋宏基因组研究更快落地
- 总结Conclusion