5
 分享
引言Introduction
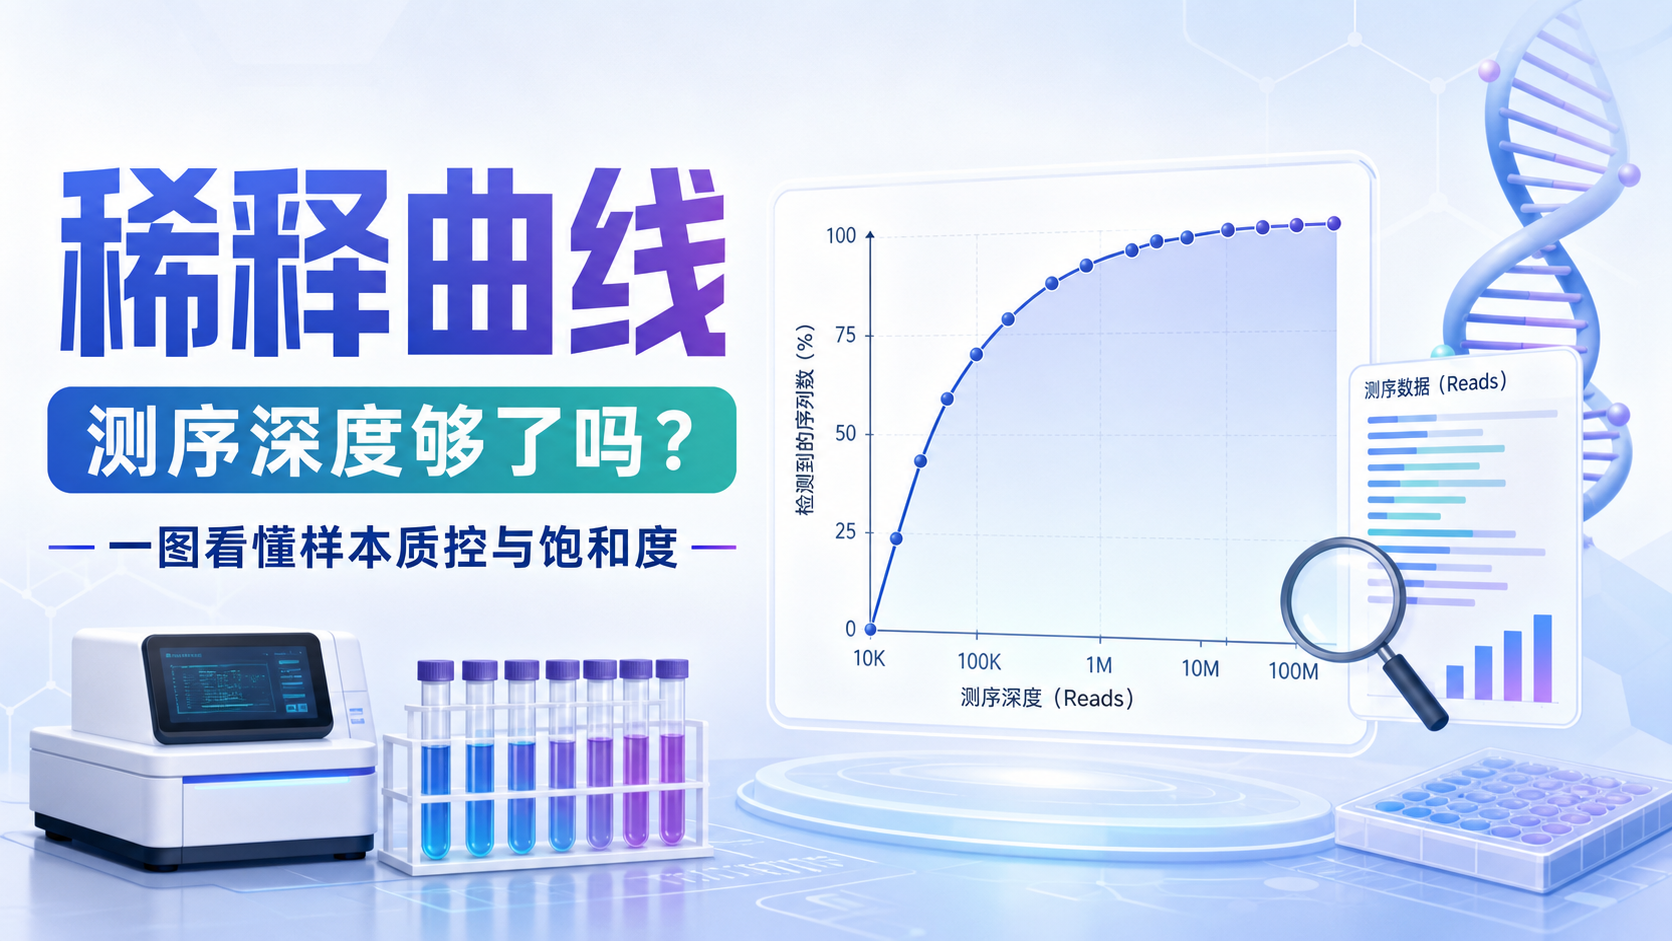
稀释曲线是测序数据分析中最常被忽视,却最能反映“测得够不够”的指标。很多人只看reads数量,却忽略了测序深度是否已经接近饱和,导致重复测序、数据浪费,甚至影响后续差异分析判断。
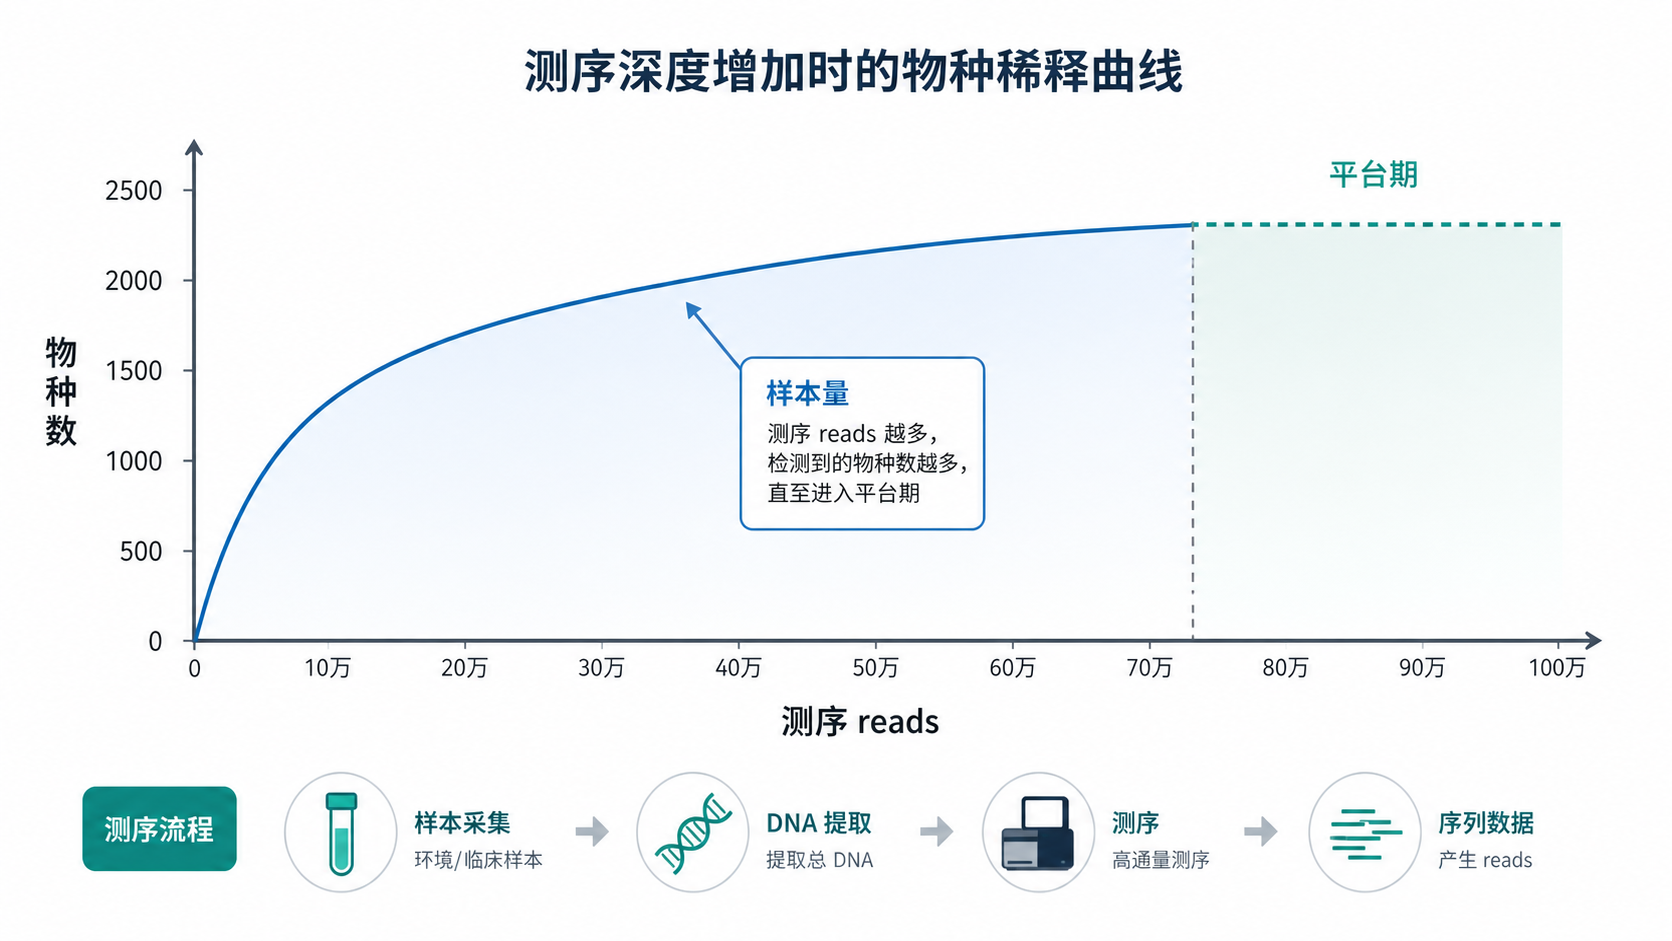
如果你在做转录组、单细胞或宏基因组分析,稀释曲线几乎是判断数据是否还值得继续加深测序的第一道门槛。 它能帮助你判断当前测序深度是否足够,是否还能发现更多基因、转录本或物种。
1. 什么是稀释曲线
1.1 核心定义
稀释曲线,英文常称 rarefaction curve,是通过逐步增加抽样量,观察已检测到的特征数变化形成的曲线。这里的“特征”可以是基因、OTU、ASV、转录本或物种。
它回答的是一个很直接的问题。 随着测序量增加,新的信息还会不会持续出现。
在理想情况下,曲线前期上升很快,后期逐渐变平,说明新增测序带来的新发现越来越少,数据接近饱和。
1.2 为什么它重要
稀释曲线不是单纯的图形展示,而是质量控制工具。它能帮助研究者判断:
- 当前测序是否足够覆盖样本复杂度。
- 是否需要继续增加测序深度。
- 不同样本之间的覆盖是否均衡。
- 后续定量分析是否建立在相对可靠的数据基础上。
对科研人员来说,稀释曲线本质上是“投入产出比”的可视化。 当曲线已经接近平台,继续加测带来的边际收益通常很低。
2. 稀释曲线如何形成
2.1 抽样与累积过程
稀释曲线通常基于随机抽样计算。分析时会从现有reads中逐步抽取不同数量的数据,统计每个抽样深度下能检测到的特征数,然后把结果连成曲线。
这个过程的关键点有两个。
- 抽样是随机的。
- 统计的是累计发现的特征数。
因此,曲线不是单次测序结果的静态截图,而是对“随着测序加深,信息增加速度”的动态描述。
2.2 曲线形态的常见解读
一般来说,稀释曲线可分为三种典型形态:
- 快速上升后趋于平缓。 说明已接近饱和。
- 持续上升但斜率下降。 说明仍可发现新特征,但新增速度在降低。
- 始终陡峭上升。 说明测序深度可能明显不足。
真正有价值的不是“曲线高不高”,而是“有没有进入平台期”。 这一点比单纯比较reads数更重要。
3. 稀释曲线能评估什么
3.1 判断测序深度是否够用
在转录组研究中,如果稀释曲线已经趋于平稳,通常提示大部分可检测基因已被覆盖。此时继续增加测序量,新增基因的发现可能有限。
在单细胞测序中,稀释曲线也可用于评估文库复杂度。若曲线过早饱和,可能提示某些细胞群的转录本捕获已经接近极限。
在16S或宏基因组场景下,稀释曲线常用于观察物种或特征丰度是否仍在持续增加。如果曲线远未平台,说明真实复杂度可能还没有被充分揭示。
3.2 评估样本间可比性
不同样本的测序深度常常不一致。此时,稀释曲线可以帮助判断这些样本是否处于可比区间。
如果某个样本曲线明显更早进入平台,说明该样本可能复杂度较低,或者测序深度已经足够。
如果另一个样本仍在持续上升,则它可能还有更多未被捕获的信息。
这对后续差异分析非常重要。 因为如果样本覆盖程度差异过大,结果可能更多反映测序深度,而不是真实生物学差异。
3.3 辅助判断文库质量
稀释曲线还能间接反映文库质量。一个高质量文库通常会在一定深度后逐渐饱和,因为新增reads更多来自重复片段,新增特征增长有限。
如果曲线异常平缓,但样本总reads并不低,要考虑:
- 起始材料是否不足。
- 文库复杂度是否偏低。
- PCR重复是否较高。
- 样本本身是否降解。
所以,稀释曲线不是孤立指标,而是和Q30、mapping率、重复率一起看的。
4. 读取稀释曲线时最容易犯的错误
4.1 把曲线高低等同于样本好坏
这是最常见的误区。曲线高,不一定样本就“更好”。
曲线低,也不一定样本就“更差”。
原因很简单。不同样本的复杂度不同,研究对象不同,测序策略也不同。菌群样本和肿瘤转录组样本,本来就不能直接用同一把尺子机械比较。
正确的比较方式是看趋势和平台期,而不是只看绝对值。
4.2 只看总reads,不看覆盖效率
有些研究者会认为reads越多越好。实际上,当曲线已接近平台时,再增加reads对新特征的贡献有限。
这时更合理的做法是把资源投入到:
- 更多生物学重复。
- 更合适的分组设计。
- 更稳定的文库制备。
- 更严格的批次控制。
测序深度不是越深越好,而是要深到“信息增量开始明显变慢”的临界点。
4.3 忽略抽样方法差异
不同软件、不同统计口径、不同特征定义,都会影响曲线形态。比如按基因、按转录本、按OTU统计,得到的结果就不完全一样。
因此,在论文和报告中使用稀释曲线时,要写清楚:
- 特征定义是什么。
- 采用了什么抽样方法。
- 曲线是基于哪些样本生成。
- 是否进行了标准化处理。
缺少这些信息,曲线的解释就容易失真。
5. 在实际研究中如何使用稀释曲线
5.1 作为建库和测序策略参考
在项目前期,稀释曲线可以帮助预估测序深度。
如果预实验中曲线很早达到平台,说明正式项目不一定需要极高深度。
如果曲线仍未饱和,可能需要提高测序量或优化样本制备。
对于预算有限的项目,这一点尤其重要。先用稀释曲线判断“够不够”,比盲目加深测序更科学。
5.2 作为数据质控的一部分
在正式分析流程中,稀释曲线通常与其他QC指标联合使用:
- 测序数据量。
- 过滤后有效reads数。
- 比对率。
- 重复率。
- 样本间相关性。
单独看稀释曲线不够,联合判断才更可靠。
如果某个样本曲线异常,同时伴随低比对率或高重复率,就要优先排查实验问题。
5.3 作为结果展示工具
在论文图表中,稀释曲线常用于展示样本测序是否充分。它可以放在补充材料,也可以作为正文中的质量控制图。
写作时建议明确说明:
- 曲线是否已接近平台。
- 不同样本的趋势是否一致。
- 是否支持后续分析结论。
对审稿人来说,稀释曲线是一个非常直观的证据。 它能提升数据可靠性的说服力。
6. 稀释曲线与测序深度的关系
6.1 为什么它能反映深度
测序深度本质上是对样本抽样的次数。抽样越多,理论上发现新特征的机会越大。
但这种增长不是无限的,因为样本中可检测的真实特征是有限的。
所以,稀释曲线会从“快速增长”逐渐转向“缓慢增长”,最终接近平台。
这个拐点就是评估测序深度是否足够的重要依据。
6.2 与饱和度判断的区别
很多人会把稀释曲线和饱和度混为一谈。实际上,二者相关,但不完全相同。
- 稀释曲线强调的是“随抽样量变化的趋势”。
- 饱和度强调的是“新增信息是否已经很少”。
可以简单理解为,稀释曲线是过程,饱和度是判断。
曲线越平,通常说明饱和度越高。
7. 结语中如何落地到分析流程
7.1 一条实用建议
如果你正在做测序项目,建议把稀释曲线放到分析前中期,而不是等到最后才看。
先用它判断深度是否合理,再决定是否继续追加测序,能明显减少无效成本。
同时,稀释曲线最好与RIN、Q30、比对率、重复率和样本分组设计一起解读。
这样才能把“技术问题”和“生物学问题”分开。
7.2 使用解螺旋提升分析效率
对于医学生、医生和科研人员来说,真正耗时的往往不是画出一张稀释曲线,而是如何把它和建库质控、测序深度判断、后续统计分析连成完整逻辑。如果你希望更高效地完成测序数据解读、图表整理和分析报告撰写,可以使用解螺旋。 它能帮助你更快梳理关键指标,减少重复试错,把时间集中在真正重要的科研判断上。
总结Conclusion
稀释曲线是评估测序深度是否足够的关键指标。 它能帮助你判断数据是否接近饱和,样本间覆盖是否可比,以及是否需要继续增加测序量。
在实际使用中,不要只看曲线高低,要看平台期、趋势和与其他质控指标的联合表现。
对于测序项目来说,懂得解读稀释曲线,意味着你能更科学地分配预算,更稳妥地解释结果,也能更早发现数据问题。
如果你希望把这些分析步骤更高效地落地,不妨进一步了解解螺旋,让复杂的测序解读变得更清晰。
- 引言Introduction
- 1. 什么是稀释曲线
- 2. 稀释曲线如何形成
- 3. 稀释曲线能评估什么
- 4. 读取稀释曲线时最容易犯的错误
- 5. 在实际研究中如何使用稀释曲线
- 6. 稀释曲线与测序深度的关系
- 7. 结语中如何落地到分析流程
- 总结Conclusion