5
 分享
引言Introduction
β多样性分析用于比较不同样本间菌群差异,是疾病队列研究里最常见,也最容易出错的一步。OTU表、距离矩阵、PCoA坐标、分组检验,任何一环处理不当,都会直接影响结论可信度。如果你想把“菌群差异”真正讲清楚,就必须先把β多样性分析做对。
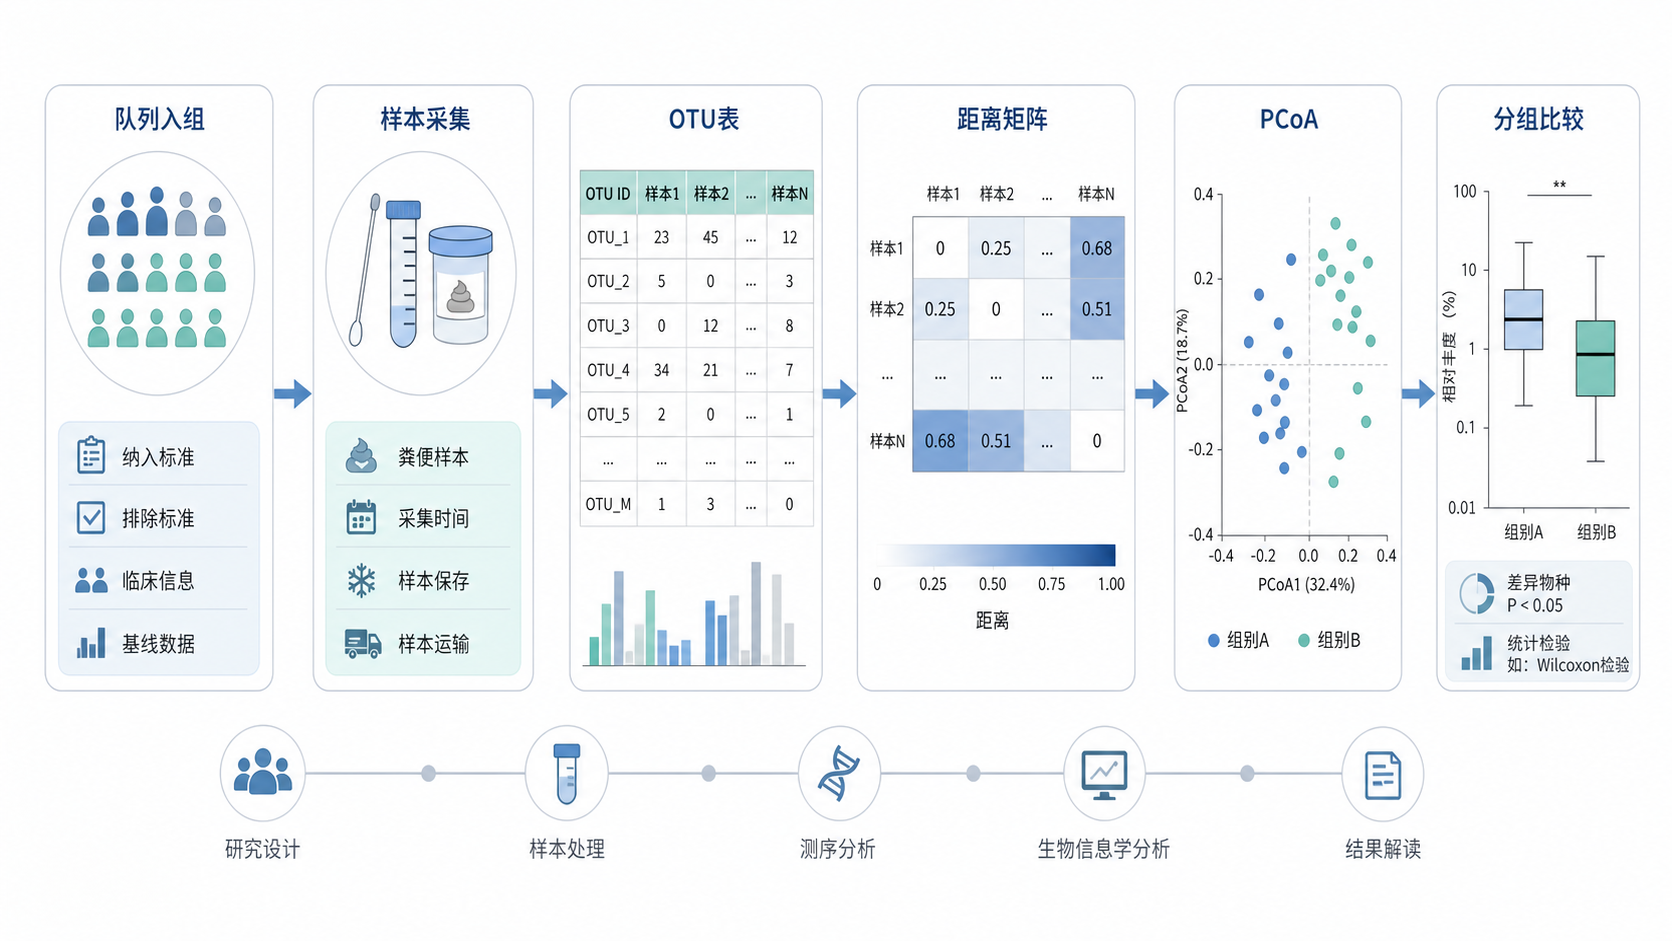
1. 先理解β多样性分析到底在回答什么问题
1.1 β多样性不是“谁多谁少”,而是“谁和谁不一样”
在微生物组研究中,α多样性关注单一样本内部的丰富度和均匀度。β多样性则关注样本与样本之间的群落差异。它回答的是,病例组和对照组的菌群结构是否整体不同 。
这一步常用于疾病队列。比如肠道炎症、代谢异常、神经退行性疾病,都可能表现为群落组成偏移。此时,单看某一个菌属不够,必须用β多样性从整体层面判断分组是否分离。
1.2 从OTU到PCoA,是一条标准分析链
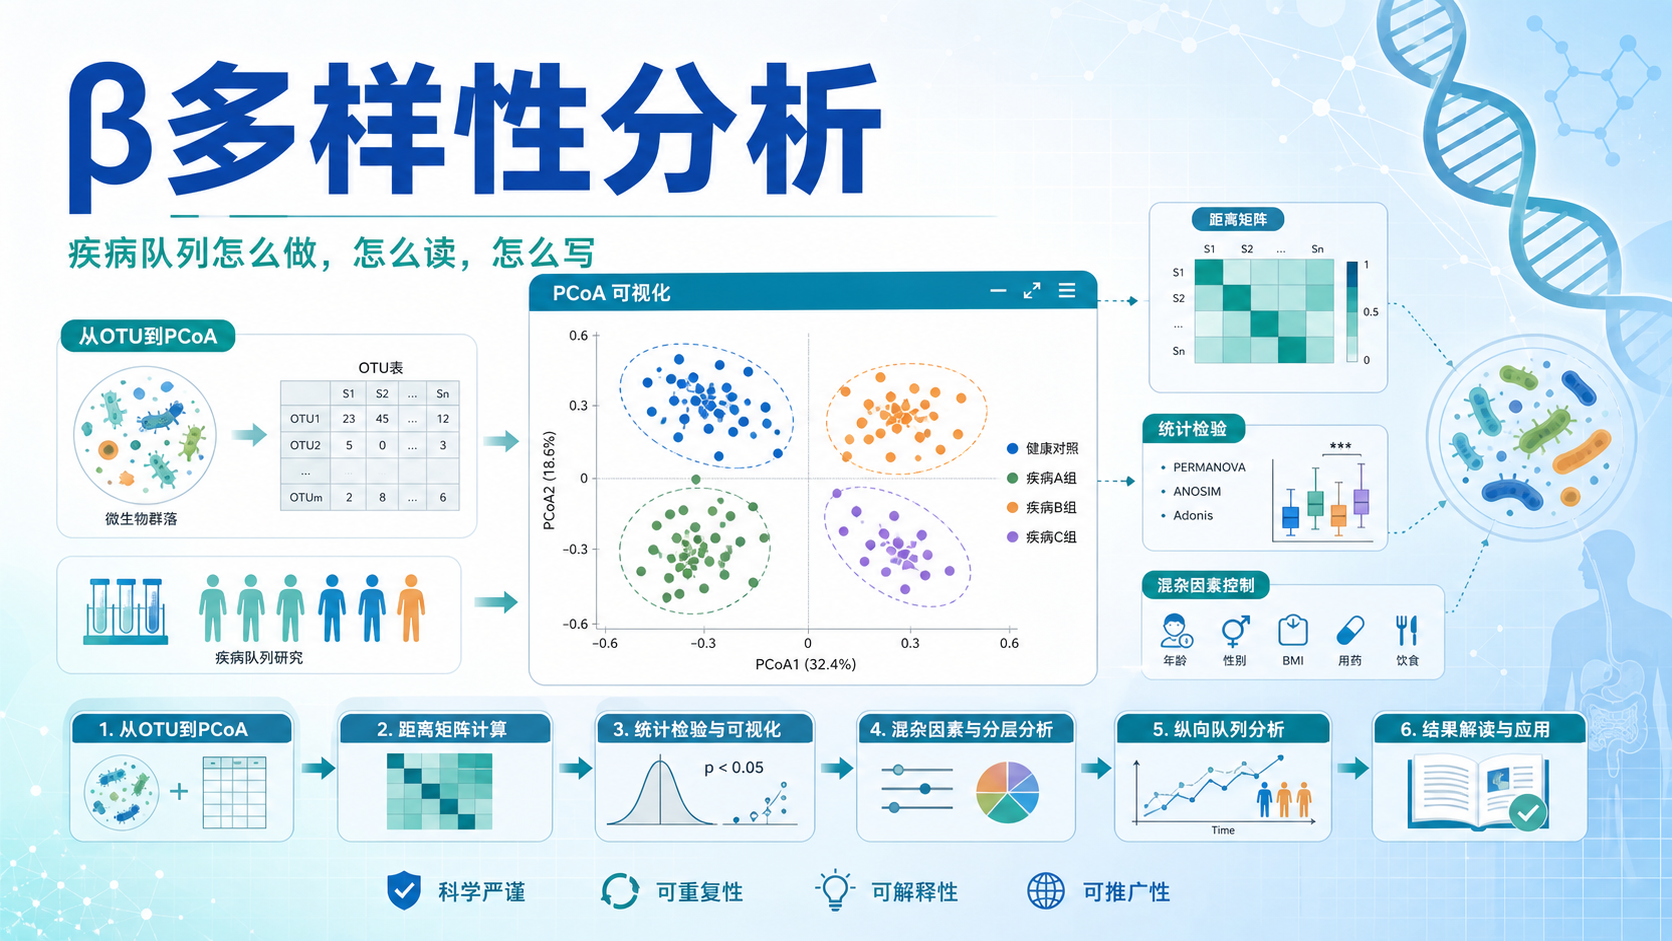
OTU表是起点。它记录每个样本中各OTU的丰度。接下来要把丰度转成样本间距离。常见方法包括 Bray-Curtis、Jaccard、Unweighted UniFrac、Weighted UniFrac。
得到距离矩阵后,通常用 PCoA、NMDS 或 PCA 进行降维可视化。PCoA不是结果本身,它只是把复杂距离关系投影到二维或三维空间。 真正的统计结论,还要结合置换检验、PERMANOVA 或 ANOSIM。
2. 疾病队列中,β多样性分析的标准实操流程
2.1 先确认数据层级和预处理方式
疾病队列分析最怕前处理不一致。OTU表、ASV表、物种注释表、样本分组信息,必须一一对应。样本命名要统一,缺失值要提前处理,污染样本和低测序深度样本要筛掉。
常见预处理步骤包括:
- 去除明显污染和低质量序列。
- 统一测序深度或采用合适的标准化方法。
- 选择分析层级,OTU、属、科或ASV。
- 明确距离算法是否考虑系统发育信息。
如果样本深度差异很大,却直接做距离比较,结果往往会被测序量偏差干扰。
2.2 距离矩阵选择要和研究问题匹配
不同距离指标强调的信息不同。Bray-Curtis反映丰度差异,适合看群落组成变化。Jaccard更关注有无差异,适合看定植或缺失。UniFrac引入系统发育信息,更适合解释进化关系相关的群落变化。
在疾病队列中,常见的选择逻辑是:
- 想看总体丰度结构差异,优先 Bray-Curtis。
- 想看菌群组成是否“换了人”,可用 Jaccard。
- 想纳入系统发育距离,使用 UniFrac。
- 想比较干预前后变化,可在纵向队列中重复计算距离。
不要为了“图好看”随意换距离。距离算法改变,生物学解释也会改变。
2.3 PCoA图要读懂坐标、解释度和分组趋势
PCoA图里,横轴和纵轴对应前两个主坐标。括号中的百分比是解释度,表示这两个轴能解释多少样本间差异。很多研究只看点是否分开,但这不够。
你还要看三件事:
- 组内点是否聚集。
- 组间是否明显分离。
- 是否存在离群点拉偏整体结构。
如果病例组和对照组分离,但组内离散度也很大,就要小心。这可能提示个体异质性强,而不一定代表稳定的疾病特征。
3. 统计检验怎么做,才算有说服力
3.1 只看PCoA分离,不足以证明差异
PCoA是可视化工具,不是显著性检验。很多初学者会把“图上分开”直接等同于“有统计学差异”,这是不严谨的。
更规范的做法是配合:
- PERMANOVA,用于检验组间整体差异。
- ANOSIM,用于比较组间和组内距离差别。
- PERMDISP,用于检验组内离散度是否不同。
如果只做PERMANOVA,不检查离散度,可能把“组内波动”误判成“组间差异”。
3.2 疾病队列里,混杂因素必须纳入设计
β多样性分析的结果很容易受年龄、性别、BMI、用药、饮食、抗生素暴露、采样时间影响。尤其是回顾性队列,临床信息越复杂,混杂越明显。
建议在设计阶段就明确:
- 是否做匹配。
- 是否分层分析。
- 是否进行协变量校正。
- 是否需要多中心分层比较。
如果样本量允许,PERMANOVA里可加入协变量,观察疾病状态是否仍然是主要解释因素。这一步决定你的结论是“相关”还是“更接近因果线索”。
3.3 纵向队列比横断面队列更容易看出真实变化
如果研究的是治疗前后、发病前后、随访转归前后,β多样性分析价值更大。因为同一受试者的基线差异会被部分抵消,更容易观察疾病进展或干预带来的群落漂移。
纵向设计中可以关注:
- 同一患者治疗前后是否向健康状态靠近。
- 不同时间点之间距离是否逐渐变化。
- 疾病进展快慢是否与群落重塑幅度相关。
对于疾病队列,纵向β多样性往往比单次横断面更能体现临床意义。
4. 结果解读时,最容易踩的几个坑
4.1 把“群落差异”误写成“菌群失衡”
“失衡”是临床语境较强的词,证据要求更高。β多样性只能说明样本间整体结构不同,不能单独证明病理机制已经成立。更稳妥的表述是:
- 病例组与对照组菌群结构存在显著差异。
- 不同临床分层间群落分布呈分离趋势。
- 干预前后菌群距离发生变化。
写论文时,结论要和证据强度匹配。
4.2 只报P值,不报距离和解释度
很多文章只写“P<0.05”,但没有交代使用哪种距离矩阵,也没有说明PCoA前两轴解释了多少变异。这样不利于复现,也不利于审稿人判断可靠性。
建议至少报告:
- 距离算法。
- 降维方法。
- 统计检验名称。
- P值或校正后P值。
- 解释度。
- 样本量和分组信息。
完整报告比单一显著性更重要。
4.3 忽略批次效应和测序平台差异
如果队列来自多个时间点或多个中心,批次效应可能比疾病效应更强。此时即便PCoA分开,也不一定是疾病导致。要尽量记录并控制:
- 提取批次。
- 建库批次。
- 测序批次。
- 分析软件版本。
对于多中心研究,最好在统计建模前做批次平衡检查。否则,β多样性图可能反映的是实验流程差异,而不是生物学差异。
5. 医学生、医生和科研人员如何把它真正做成一篇文章
5.1 一篇合格的β多样性结果,至少要回答三件事
第一,疾病组和对照组是否整体不同。
第二,这种不同是否稳定,是否被离群点或离散度驱动。
第三,临床变量是否能解释这部分差异。
这三点齐全,结果才有论文价值。若再结合差异菌、功能预测、临床评分或预后结局,文章层次会更完整。
5.2 推荐的写作表达模板
在结果部分,可以采用以下结构:
- 基于Bray-Curtis距离进行PCoA分析。
- 组间样本分布呈现分离趋势。
- PERMANOVA显示组间差异具有统计学意义。
- 进一步分层后,不同亚组间差异仍然存在。
这种写法比单纯描述“图上分开了”更符合医学论文规范。
5.3 如果数据量大,手工分析会明显拖慢进度
疾病队列越来越大,临床变量越来越多,单靠人工整理OTU表、距离矩阵、图形输出和统计检验,效率很低。尤其在多组比较、纵向随访和多维临床协变量并存时,反复跑图和改图非常耗时。
这也是为什么很多研究团队会借助标准化分析流程和自动化工具。像解螺旋 这类面向科研场景的支持体系,可以帮助研究者更快完成数据整理、统计分析和结果输出,把更多时间留给问题设计和论文打磨。对于想把β多样性分析真正做成可发表结果的人,规范流程比临时手工拼图更重要。
总结Conclusion
β多样性分析的核心,不是画一张PCoA图,而是用标准化方法回答“样本间是否真的不同”。从OTU表到距离矩阵,再到PCoA、PERMANOVA和协变量校正,每一步都决定最终结论是否可信。对于疾病队列研究,只有把距离指标、统计检验和临床解释同时做好,β多样性结果才有真正的科研价值。
如果你正在做微生物组疾病队列,想把分析流程做得更稳、更快、更适合发表,可以考虑借助解螺旋 的科研支持能力,减少重复劳动,把重点放回研究设计与结果解释上。
- 引言Introduction
- 1. 先理解β多样性分析到底在回答什么问题
- 2. 疾病队列中,β多样性分析的标准实操流程
- 3. 统计检验怎么做,才算有说服力
- 4. 结果解读时,最容易踩的几个坑
- 5. 医学生、医生和科研人员如何把它真正做成一篇文章
- 总结Conclusion