10
 分享
引言Introduction
在线临床预后分析正在改变研究流程。过去,研究者要手工整理数据、反复跑模型、逐项解释异质性,耗时且容易出错。真正的难点,不只是“能不能算出结果”,而是“结果是否可靠、是否可解释、是否能用于发表”。
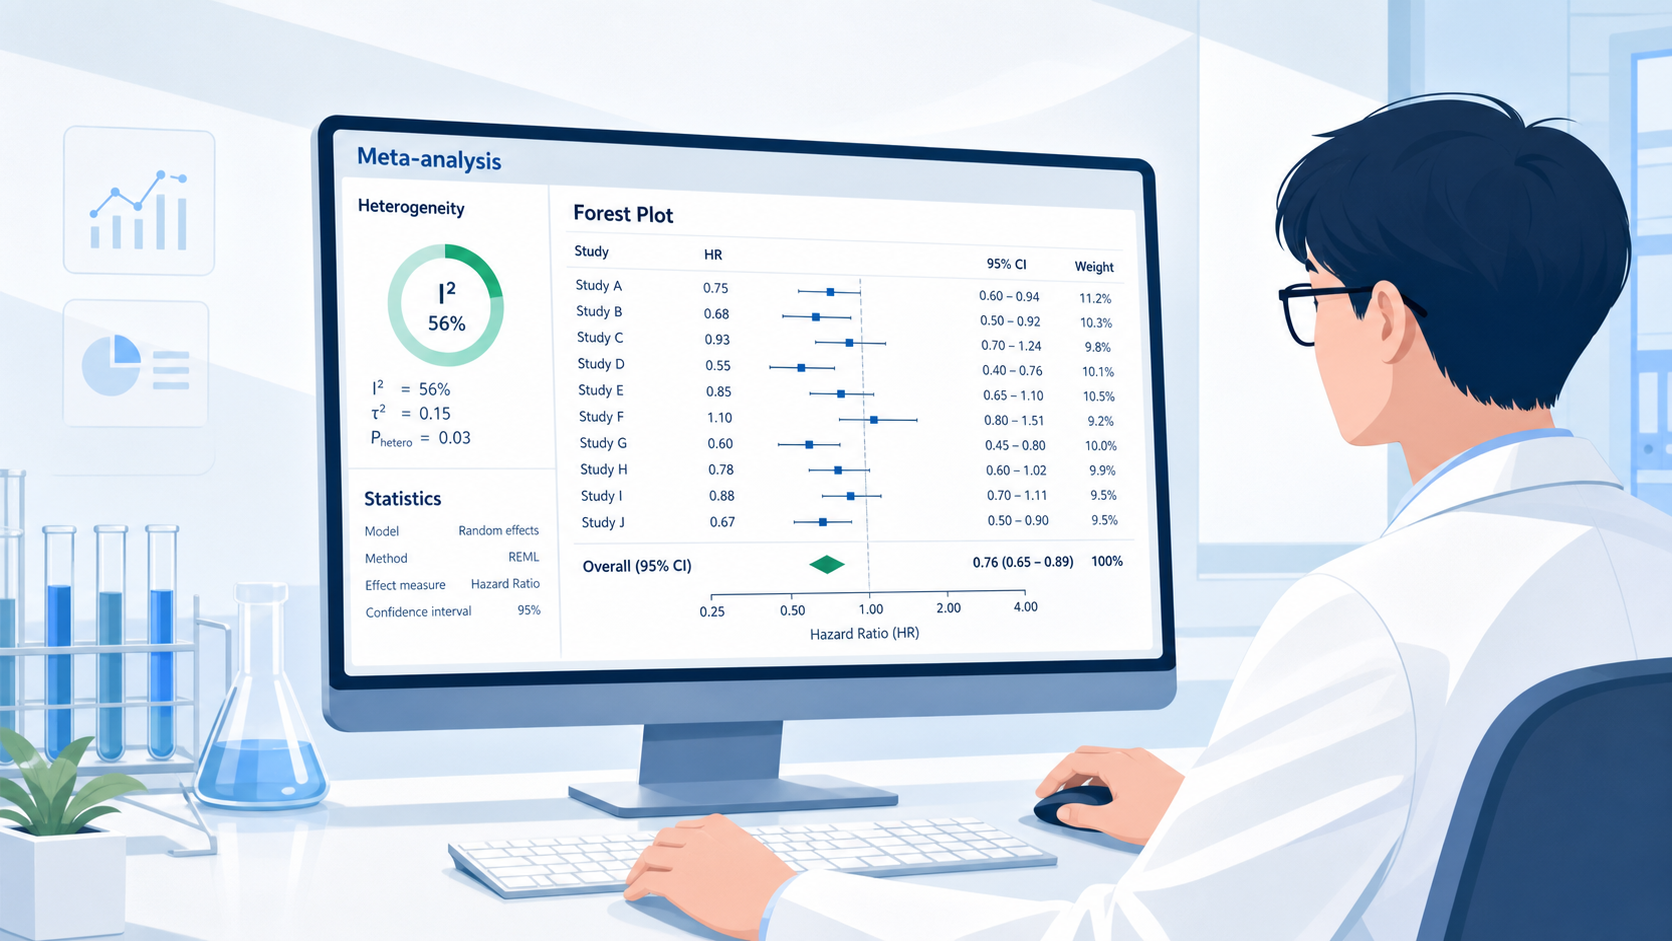
对于医学生、医生和科研人员来说,预后分析最常见的问题有三个。第一,数据整理复杂。第二,模型选择容易混淆。第三,异质性一高,结果就难以解释。本文将围绕自动化统计分析流程、异质性来源、评估方法和处理策略,给出一套可直接用于研究的思路。
1. 在线临床预后分析为什么越来越重要
1.1 预后研究的核心,不只是统计显著
预后分析关注的是,某个指标是否与结局相关。常见结局包括生存、复发、死亡、并发症发生等。研究中最关键的,不是单纯得到P值,而是判断风险效应是否稳定、是否具有临床意义 。
很多初学者会把“统计学阳性”等同于“研究有价值”。其实不完全正确。一个HR或OR即使显著,也可能因为样本量小、效应不稳定或异质性过高而缺乏推广价值。临床预后分析必须同时满足统计学可信和临床解释成立。
1.2 在线工具的价值,在于标准化和提速
在线临床预后分析工具的优势,主要体现在三点。
- 自动完成基础统计计算。
- 快速生成森林图、漏斗图和异质性指标。
- 降低手工操作带来的录入错误和模型误选风险。
对临床科研而言,这意味着研究者可以把更多时间放在研究设计、结局定义和结果解释上,而不是反复处理表格。工具能提高效率,但不能替代研究判断。 这也是高质量论文和普通分析之间的分水岭。
2. 自动化统计分析的基本流程
2.1 从数据到结果,先完成三步
一套规范的在线临床预后分析,通常先完成以下步骤。
-
明确研究对象。
需要定义疾病类型、纳入标准、随访时间和终点事件。 -
统一结局指标。
例如总生存期、无进展生存期、复发率或并发症发生率。 -
提取效应量。
常见包括HR、RR、OR及其95%CI。
如果前期数据不一致,后面的统计再准确,也只能得到“形式正确、解释困难”的结果。预后分析的第一步是标准化,而不是直接建模。
2.2 自动化分析通常输出哪些结果
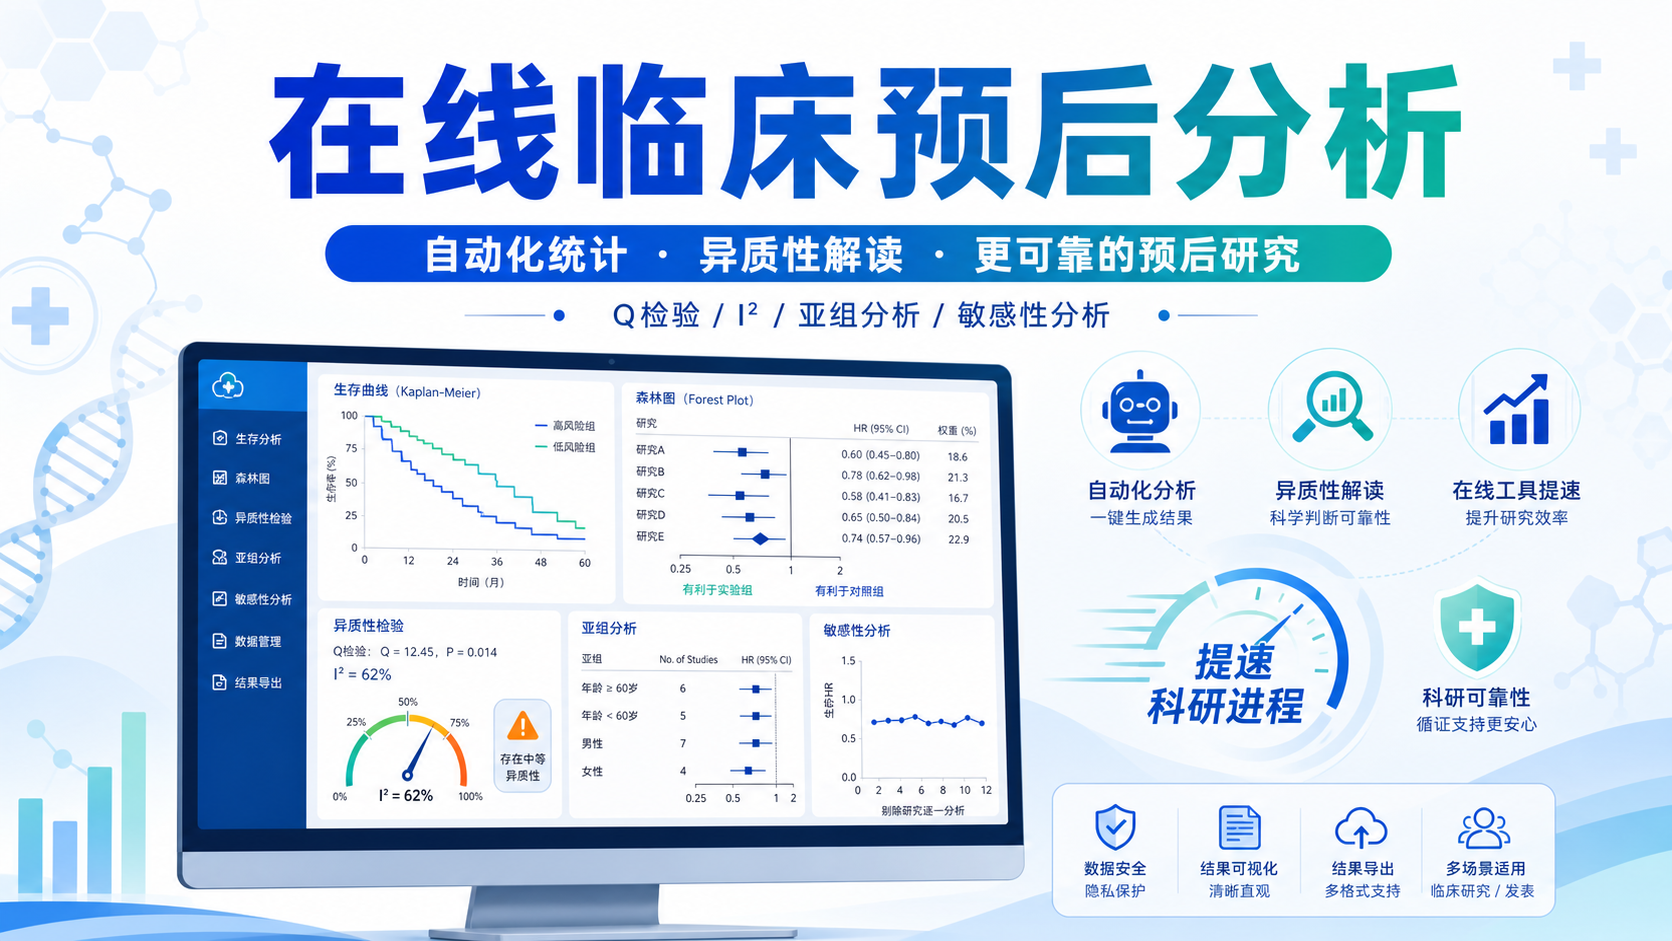
在线工具一般会自动生成以下内容。
- 合并效应量。
- 95%置信区间。
- Q检验P值。
- I²值。
- 森林图。
- 敏感性分析结果。
- 发表偏倚相关图形。
这些输出看似很多,但研究者真正要抓住的,是三个核心问题。
第一,研究之间是否存在明显差异。
第二,差异是否影响合并结果。
第三,合并结果能否支持结论。
如果只看P值而不看异质性,预后分析很容易得出过度乐观的结论。
3. 异质性从哪里来
3.1 临床异质性最常见
异质性并不神秘。它通常来自研究之间的真实差别。最常见的是临床异质性。
比如以下情况都会带来差异:
- 患者年龄不同。
- 病情严重程度不同。
- 干预措施不同。
- 对照组定义不同。
- 结局指标单位不同。
举例来说,同样研究某个生物标志物与预后的关系,如果一部分研究纳入早期患者,另一部分纳入晚期患者,结局自然可能不一致。这不是统计错误,而是临床人群本身不一样。
3.2 方法学异质性常被忽视
方法学差异同样重要。比如:
- 检测方法不同,PCR、免疫组化或其他技术结果可能不完全一致。
- 随机化和盲法实施质量不同。
- 随访时间不同。
- 终点判定标准不同。
这些差异会让同一个指标在不同研究中表现出不同效应。对于在线预后分析来说,方法学异质性往往比表面上的数值差别更值得警惕。
3.3 统计学异质性是结果,不是原因
统计学异质性是前两类差异在数据层面的体现。它告诉我们,研究间效应量变异较大。常用的两个指标是Q检验和I²。
- Q检验主要看P值。
- I²反映异质性的比例。
一般理解如下:
- I²接近0%,提示异质性很小。
- 25%左右,可视为轻度异质性。
- 50%左右,常提示中度异质性。
- 75%以上,提示高度异质性。
I²不是越低越“好看”,而是越低越利于直接合并。 研究者要做的是解释它,而不是回避它。
4. 如何解读Q检验和I²
4.1 Q检验适合判断“是否存在差异”
Q检验常用于判断研究间是否存在统计学异质性。一般来说,P值小于0.05,提示存在异质性;大于0.05,提示差异不明显。
但要注意,Q检验受样本量影响较大。样本少时,可能检不出异质性。样本多时,又可能对轻微差异过度敏感。所以Q检验不能单独作为判断依据。
4.2 I²更适合判断“差异有多大”
I²的优势是直观。它回答的是,研究间变异中有多少比例来自真实差异,而不是偶然误差。
在实际解读中,可以这样把握:
- I²低,优先考虑固定效应模型。
- I²高,优先考虑随机效应模型。
- I²很高时,要先找原因,再决定是否合并。
如果异质性过高却强行合并,结论的可信度会明显下降。
4.3 不能只盯着模型,要回到研究问题
模型选择不是目的,解释研究差异才是目的。固定效应模型假设研究估计的是同一个真实效应。随机效应模型则承认研究间真实效应可能不同。
在临床预后研究中,样本来源、疾病阶段和检测平台往往不同,所以随机效应模型更常见。模型应服务于数据结构,而不是让数据去迎合模型。
5. 异质性高时,怎么处理更合理
5.1 亚组分析是最常用方法
当异质性明显时,亚组分析往往是第一选择。它的目标是把可能造成差异的因素拆开看。
常见分组方式包括:
- 年龄组,成人和儿童。
- 地区组,亚洲、欧美或单中心与多中心。
- 时间组,早期研究和近期研究。
- 疾病分型组,轻症和重症。
- 检测方法组,不同实验平台。
亚组分析的意义,不只是降低I²。更重要的是看结论是否稳定。如果不同亚组方向一致,说明结果更稳健。 如果方向相反,就提示该指标可能只适用于特定人群。
5.2 敏感性分析用于验证结论是否稳固
敏感性分析通常通过逐一剔除研究来完成。目的是观察某一项研究是否对整体结果影响过大。
如果去掉某篇研究后,合并效应量变化很大,说明该研究可能是异质性的重要来源。此时应回看其设计、样本和结局定义。
如果结果变化不大,说明整体结论相对稳健。
敏感性分析不是补充步骤,而是质量控制步骤。 对预后分析尤其重要。
5.3 必要时要考虑不合并
不是所有研究都适合强行合并。以下情况要格外谨慎:
- 人群差异过大。
- 结局定义不一致。
- 检测方法完全不同。
- 研究质量差异明显。
- 异质性无法通过亚组解释。
此时,分层描述可能比合并更有价值。“不合并”并不等于失败,反而可能是更严谨的选择。
6. 在线工具如何帮助你做出更可靠的预后分析
6.1 工具能解决“快”和“准”的问题
在线临床预后分析工具最大的优势,是把复杂流程标准化。你可以更快完成效应量合并、异质性判断和图形输出,减少重复劳动。
对于科研人员来说,这意味着:
- 更少的人工录入错误。
- 更统一的统计流程。
- 更快的初稿产出。
- 更容易复现结果。
但要强调,自动化只能提升执行效率,不能替代专业判断。 研究者仍需决定纳入标准、亚组策略和结果解释。
6.2 解螺旋的价值,在于把分析和科研思维结合起来
如果你希望把在线分析真正用于论文和课题,而不是只停留在“出图”,那么需要的是一套更完整的支持。解螺旋可以帮助研究者把数据整理、统计分析和结果解读串联起来,减少在异质性判断、模型选择和结论表述上的反复试错。对于需要快速产出又要保证严谨性的临床科研团队,这类工具和方法整合尤其重要。
总结Conclusion
在线临床预后分析的核心,不只是自动化统计,更是对异质性和结果稳定性的专业解读。研究者要先识别异质性来源,再结合Q检验、I²、亚组分析和敏感性分析判断结论是否可靠。只有把“统计显著”与“临床合理”同时满足,预后研究才真正有发表和应用价值。
如果你正在做预后相关课题,建议把分析流程标准化,把异质性解释前置,把结论表述建立在证据上。想进一步提升在线分析效率和论文产出质量,可以了解解螺旋,让自动化统计真正服务于高质量临床科研。
- 引言Introduction
- 1. 在线临床预后分析为什么越来越重要
- 2. 自动化统计分析的基本流程
- 3. 异质性从哪里来
- 4. 如何解读Q检验和I²
- 5. 异质性高时,怎么处理更合理
- 6. 在线工具如何帮助你做出更可靠的预后分析
- 总结Conclusion