10
 分享
引言Introduction
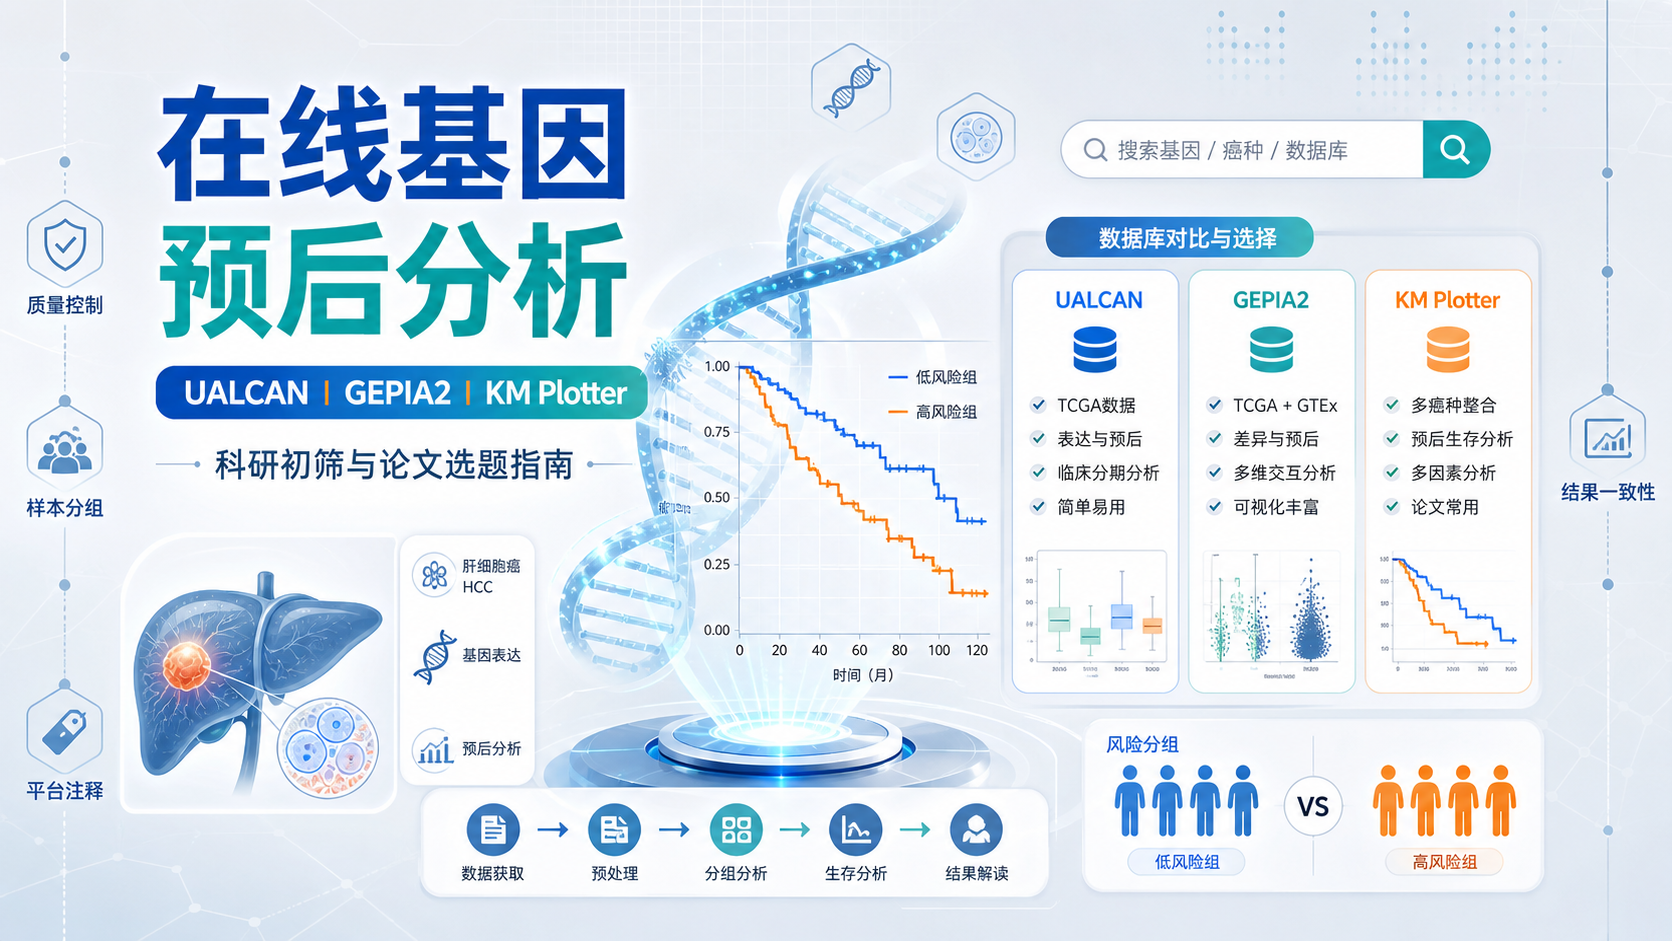
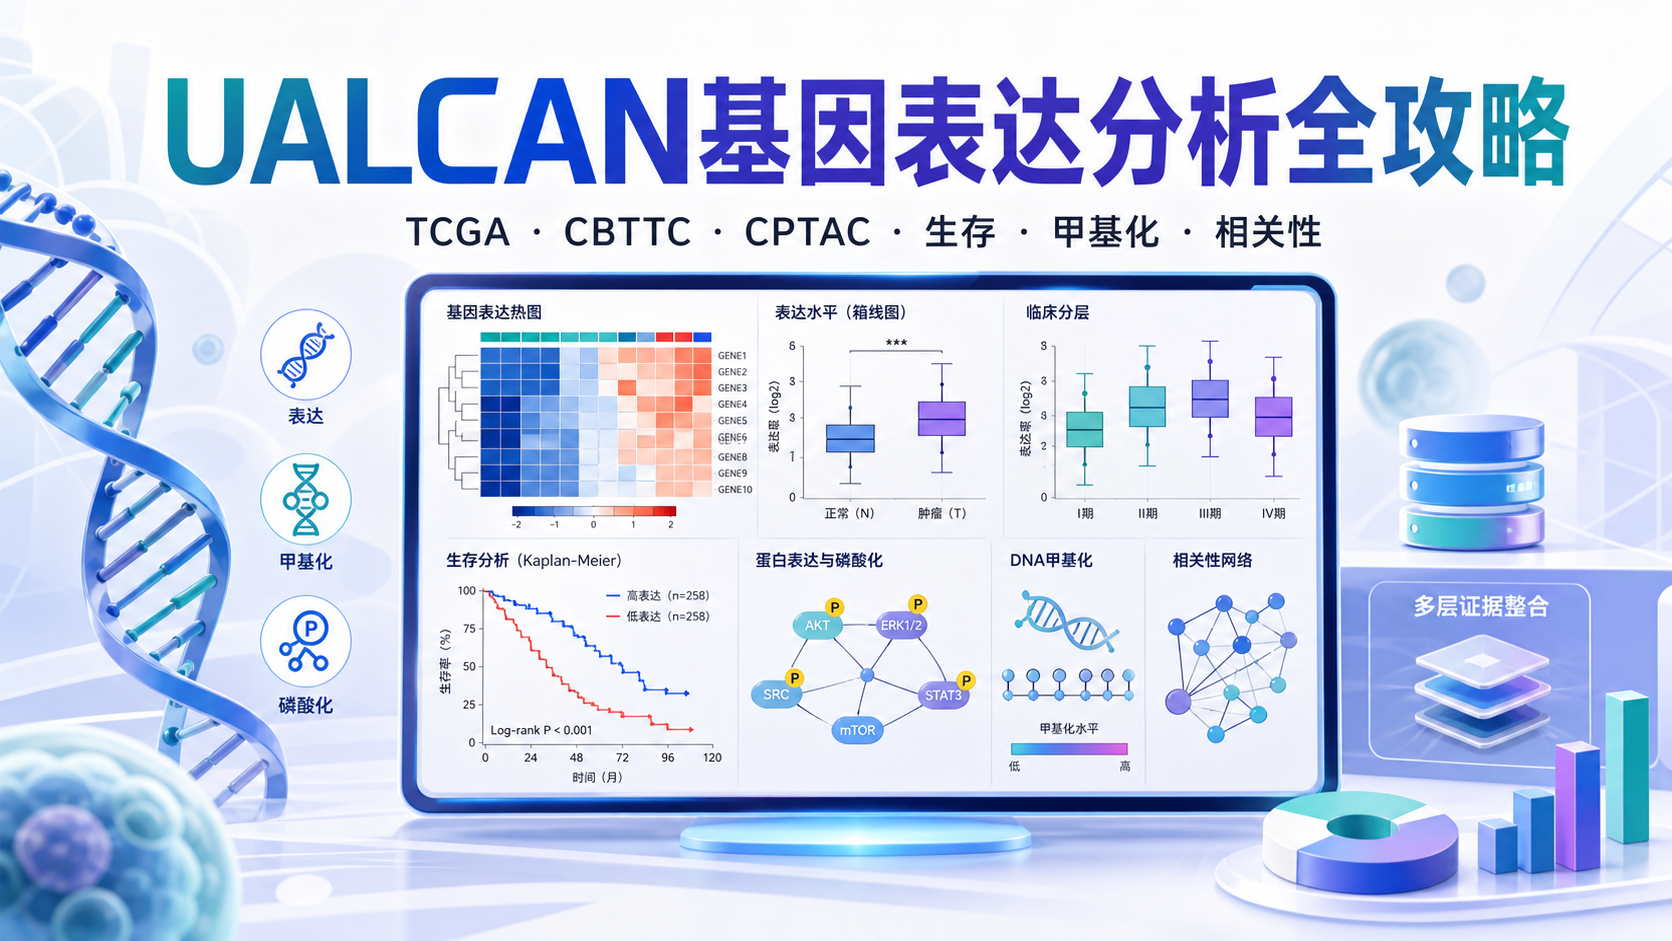
UALCAN是生信入门和科研验证中常用的在线分析平台。如果你想快速查看某个基因在TCGA或CBTTC中的表达差异、生存关联和临床分层结果,UALCAN非常高效。 但很多人卡在入口、数据集选择和结果页解读,导致分析停在“会点不会读”。
1. 先理解UALCAN能做什么
1.1 适合哪些基因表达问题
UALCAN的核心优势,是把公共队列的表达数据做成可视化结果。对于医学生、医生和科研人员,最常见的需求有三类。
- 看单基因在肿瘤和正常组织中的差异。
- 看基因在不同临床亚组中的表达变化。
- 结合生存、甲基化、蛋白或磷酸化结果,建立初步假设。
它不是替代统计软件,而是一个快速筛查和验证平台。 如果你已经有候选基因,UALCAN适合做第一轮证据整理。
1.2 数据来源决定解读边界
UALCAN并不是统一数据库,而是基于不同来源数据分别分析。常见入口包括TCGA、CPTAC和CBTTC。
- TCGA,偏向转录组和临床关联。
- CPTAC,偏向蛋白表达和磷酸化。
- CBTTC,主要用于小儿脑肿瘤相关数据。
解读时要先确认数据来源,否则同一基因在不同平台的趋势可能不同。 这是因为mRNA、蛋白和磷酸化层面的变化并不总是同步。
2. TCGA基因表达分析怎么做
2.1 进入Gene analysis的标准流程
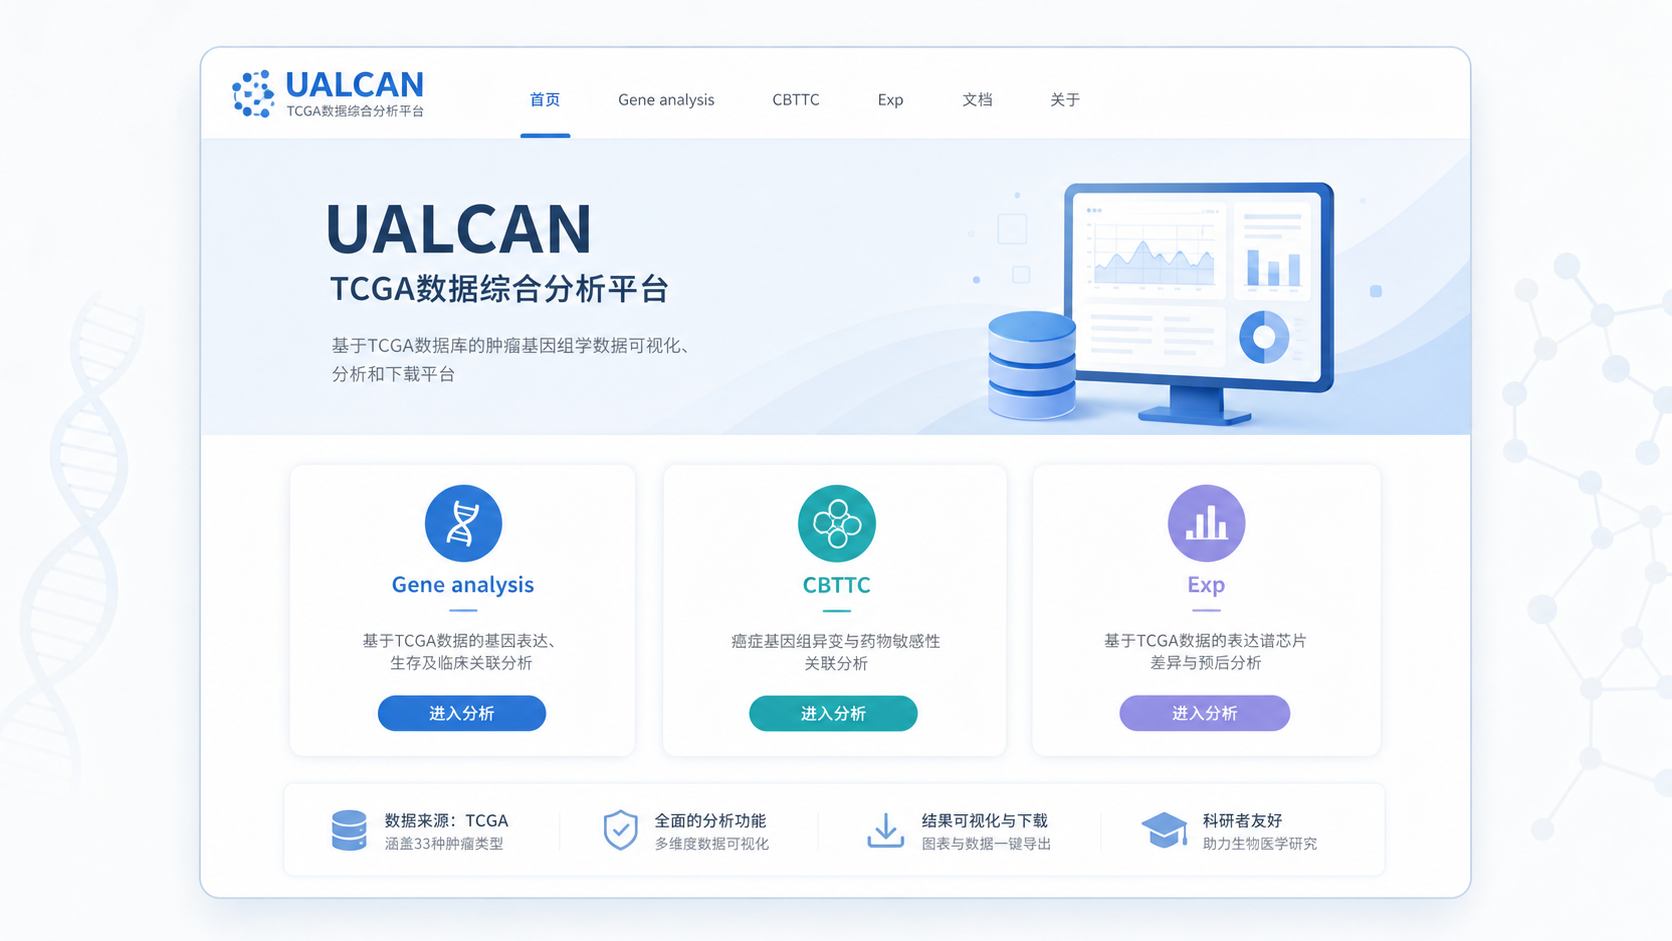
在主页面点击TCGA,进入TCGA来源数据分析界面,再点击TCGA Gene analysis。输入目标基因后,点击Explore即可进入结果页。
这个流程适合单基因分析,也适合miRNA和lncRNA相关分析。关键点是先确认你要看的到底是“表达”,还是后续的“生存”“甲基化”或“相关性”。
结果页通常包含两类信息。
- 总体表达概览。
- 针对该基因的详细分析入口。
2.2 结果页里最值得看的内容
以基因检索模式为例,结果页通常会给出柱形图、热图和关联入口。
你需要重点关注以下几个部分。
- 柱形图,反映基因在不同样本中的表达水平。
- 热图,展示目标基因在癌种中的表达分布。
- 分析链接,包括Expression、Survival、Methylation、Correlation等。
- 外部链接,便于进一步跳转验证。
真正有价值的不是“图好不好看”,而是图里比较的分组是否合理。 例如Normal vs Primary tumor,是否有明确的统计量,是否存在样本量不足的问题。
2.3 临床亚型分层怎么看
UALCAN的强项之一,是可以按临床特征分层看表达。常见分层包括:
- 肿瘤分期。
- 分子分型。
- 种族。
- 性别。
- 更年期状态。
例如在乳腺癌中,UALCAN可以进一步展示三阴型、Luminal、HER2等亚组。这对解释“总体无差异,但某个亚组显著”非常重要。
科研上,很多候选基因的价值并不体现在全体样本,而是体现在特定亚型。这个设计思路对后续文章写作很关键。
3. CBTTC数据如何用于儿童肿瘤表达分析
3.1 CBTTC入口和适用范围
如果研究对象是小儿脑肿瘤,可以在主页面点击CBTTC。进入欢迎界面后,UALCAN会调用CBTTC数据库数据进行基因表达分析。
目前该数据集右侧下拉菜单只有一个选项,即pediatric brain cancer 。输入基因后点击Explore,就能进入结果页。
这说明CBTTC的适用范围更聚焦,适合儿童脑肿瘤相关研究,不适合泛癌筛查。
3.2 结果页如何读
CBTTC结果界面的结构与TCGA类似。你会看到基因列表、分析链接和外部链接。分析部分一般包括:
- RNA表达分析。
- 蛋白表达分析。
- 磷酸化分析。
以CD274、HIF1A、CSF1R、GAPDH等基因为例,都可以在结果页中查看对应表达信息。如果你的研究涉及免疫、缺氧或肿瘤微环境,这类分析很适合做初步验证。
3.3 适合写论文的使用方式
CBTTC的价值主要在于提供一个公共数据支持。你可以用它完成以下任务。
- 验证候选基因是否在儿童脑肿瘤中异常表达。
- 比较RNA、蛋白和磷酸化层面的变化。
- 为后续机制实验提供方向。
对于文章写作,建议把CBTTC作为“补充验证”而不是唯一证据。 这样更符合E-E-A-T思路,也更稳妥。
4. 表达结果之外,哪些分析最值得一起看
4.1 生存分析不是“附加项”
很多人只看表达差异,忽略了生存分析。其实在UALCAN里,生存结果能帮助你判断基因是否具有潜在预后价值。
以S100P为例,系统可展示:
- 基因高低表达对总生存的影响。
- 联合临床变量后的生存曲线。
- 不同亚组下的生存差异。
如果表达差异明显,但生存不显著,结论就要谨慎。 反之,如果表达和生存都指向同一方向,研究说服力会更强。
4.2 甲基化分析能补上机制线索
UALCAN还可以看启动子甲基化。Beta值范围从0到1,越接近1代表甲基化程度越高。根据数据库说明,0.7到0.5可视为超甲基化,0.3到0.25可视为低甲基化。
这类分析适合回答一个常见问题。
- 为什么某基因在肿瘤中上调。
- 是否可能与启动子低甲基化有关。
- 表达升高是否可能具有表观遗传基础。
甲基化分析不能直接证明因果,但能显著增强假设的完整性。
4.3 相关性分析适合找共表达线索
如果你想寻找和目标基因相关的候选通路,UALCAN的相关性分析很实用。它会列出正相关和负相关基因,并给出Pearson相关系数。
常见应用包括:
- 找共表达基因。
- 做后续富集分析。
- 缩小机制验证范围。
需要注意的是,相关性只能说明线性关联,不能直接说明调控关系。 后续仍需结合实验验证。
5. 蛋白表达和磷酸化分析怎么补强证据
5.1 CPTAC让mRNA分析不再单薄
UALCAN的CPTAC模块来自临床蛋白质组学肿瘤分析联盟。它可分析的癌种包括结肠癌、乳腺癌、卵巢癌、透明细胞肾细胞癌和子宫体子宫内膜癌。
在CPTAC中,输入基因后点击Explore,可查看:
- 总蛋白分析。
- 磷酸化分析。
- 泛癌分析。
对医生和科研人员来说,这一步非常关键,因为mRNA高表达并不一定等于蛋白高表达。
5.2 蛋白与磷酸化结果的价值
蛋白表达更接近功能层面,磷酸化则常常指向激酶活性和信号通路状态。结果页中通常还会给出统计信息和分组说明。
你可以用它来回答三个问题。
- 目标基因是否在蛋白层面异常。
- 蛋白变化是否与RNA方向一致。
- 是否存在潜在的翻译后调控。
如果RNA、蛋白和磷酸化方向一致,结论会更完整。
6. 写作和汇报时最容易犯的三个错误
6.1 把“相关”写成“因果”
UALCAN提供的是公共数据库分析结果。它可以支持假设,但不能单独证明机制。
因此在论文或汇报中,建议使用更稳妥的表述。
- “提示可能相关”
- “支持进一步验证”
- “与预后趋势一致”
不要直接写成“证明基因导致了疾病进展”。这是科研表达中最常见的过度推断。
6.2 忽略样本量和分组
不同癌种、不同亚组的样本量差异会影响统计稳定性。尤其是某些分层后,样本可能明显减少。
所以在解读图时要注意:
- 正常和肿瘤组样本是否足够。
- 亚组是否存在过小样本。
- P值是否具有实际意义。
统计显著不等于生物学显著。 这句话在数据库分析里尤其重要。
6.3 只截图,不记录参数
很多人做完UALCAN分析后,只保存图片,没有记录癌种、分组、版本和分析路径。后期复现时就很难。
建议至少保留以下信息:
- 数据集名称。
- 基因名。
- 癌种类型。
- 分组方式。
- 下载图表格式,如svg或pdf。
这会让你的结果更符合可复现研究规范。
7. 一个更高效的实战思路
7.1 从单基因到多层证据
如果你手里有一个候选基因,建议按这个顺序做。
- 先看TCGA表达差异。
- 再看生存关联。
- 继续看甲基化或相关性。
- 有蛋白证据时补上CPTAC。
- 如果是儿童肿瘤,再补CBTTC。
这种“表达-预后-机制-蛋白”链条,比单独一张差异图更适合写进文章。
7.2 用解螺旋提高分析效率
如果你希望更快完成UALCAN结果整理、图表归纳和数据库分析框架搭建,解螺旋 可以帮助你把分散的数据结果整理成更适合论文和汇报的结构化内容。对于需要同时兼顾表达、预后、甲基化和蛋白证据的项目,这类工具能明显节省重复检索时间。
总结Conclusion
UALCAN的核心价值,在于让公共数据库分析变得快速、直观、可复核。对于基因表达研究,它最适合完成三件事,快速筛选差异表达,结合临床变量分层,进一步延伸到生存、甲基化和蛋白层面的验证。
但要记住,数据库结果是证据链的一部分,不是终点。想把结论写得更稳、更像高质量科研成果,就要把分组、样本量、统计方法和生物学解释一起考虑进去。
如果你希望把UALCAN分析结果更高效地整理成可发表、可汇报的结构,建议进一步了解解螺旋 ,让数据库分析从“会用”走向“用得规范、用得高效”。
- 引言Introduction
- 1. 先理解UALCAN能做什么
- 2. TCGA基因表达分析怎么做
- 3. CBTTC数据如何用于儿童肿瘤表达分析
- 4. 表达结果之外,哪些分析最值得一起看
- 5. 蛋白表达和磷酸化分析怎么补强证据
- 6. 写作和汇报时最容易犯的三个错误
- 7. 一个更高效的实战思路
- 总结Conclusion