7
 分享
引言Introduction
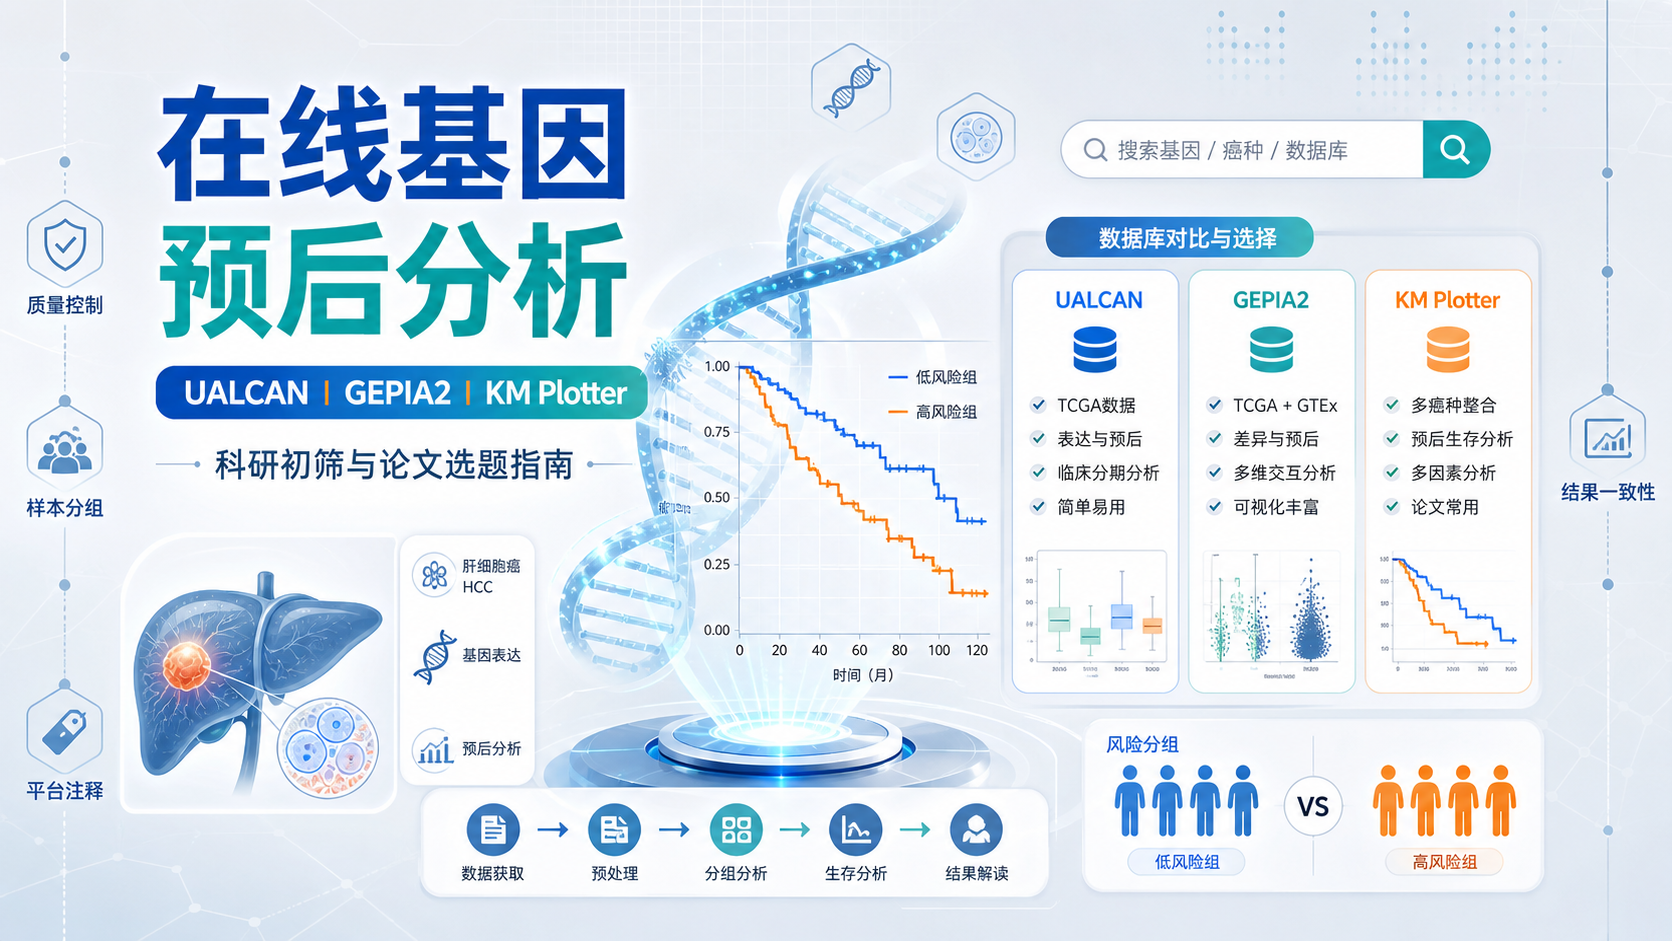
在线基因预后分析,能帮你快速判断候选基因是否与患者生存相关。对医学生、医生和科研人员来说,它适合做初筛、做验证,也适合补强论文结论。但前提是工具选对,数据选对,结果解释也要严谨。
1. 为什么要做在线基因预后分析
1.1 预后分析解决什么问题
在肿瘤研究中,表达差异不等于临床意义。很多基因在肿瘤里上调或下调,但未必和生存结局相关。预后分析的核心,是回答一个更接近临床的问题。这个基因高表达,患者生存是否更差,是否更好。
这一步很重要。因为它能把“统计学差异”推进到“临床相关性”。对于转录组、TCGA和公开队列分析而言,生存信息往往是文章结论能否成立的关键证据之一。
1.2 为什么适合科研初筛
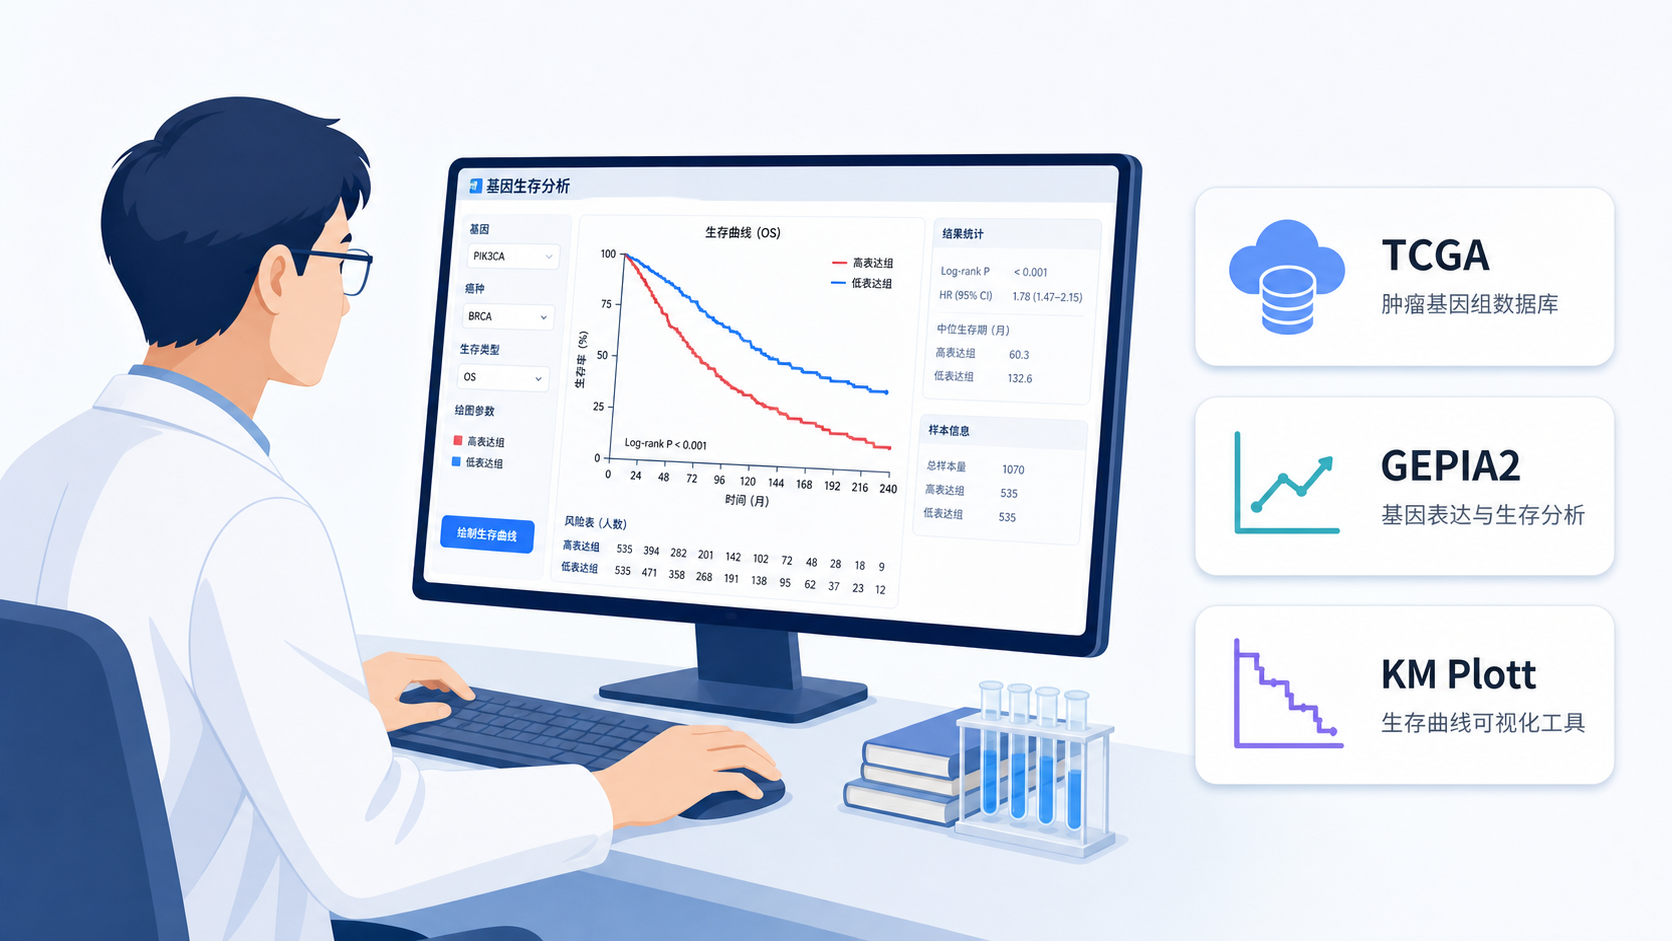
在线工具最大的价值,是快。你不需要先写复杂代码,也不必从头搭建生存模型。常见流程是输入基因,选择肿瘤类型,设定结局指标,如OS,再读取KM曲线和P值。
对于课题早期筛选,这种方法非常高效。
常见用途包括:
- 验证候选基因是否值得深入研究。
- 比较多个基因的生存相关性。
- 为后续qPCR、IHC和功能实验提供方向。
- 支持论文中的预后假设。
1.3 但不能把在线结果当终点
在线预后分析适合发现线索,不等于最终定论。原因很简单。不同数据库的数据来源、分组方式、样本构成和平台都不完全一样。即使同一个基因,在不同队列里也可能出现不同方向的结果。
所以,在线分析应当作为证据链的一环,而不是唯一证据。 论文中最好结合表达验证、临床分层和独立队列复核。这样更符合E-E-A-T要求,也更容易通过审稿。
2. 三个最常用的在线预后数据库
2.1 UALCAN,适合快速看表达和生存
UALCAN是一个交互式癌症OMICS分析平台,基于TCGA、MET500、CPTAC和CBTTC等公开数据。它的优势是界面直观,适合同时看表达、生存、甲基化和部分泛癌分析。
在TCGA模块中,可进一步选择TCGA Gene、TCGA miRNA、TCGA lncRNA和prognostic markers。对于mRNA预后分析,通常选择TCGA Gene。然后输入目标基因,选择癌种数据集,如LIHC肝癌,再点击explore。
它的实用价值在于一站式查看多个层面信息。
常见结果包括:
- 基因表达热图。
- 生存分析曲线。
- 启动子甲基化相关性。
- 泛癌表达概览。
- 外链数据库,如GeneCards、PubMed、HPA、GTEx等。
这意味着你不仅能看“是否影响生存”,还能顺手判断“为什么可能影响生存”。
2.2 GEPIA2,适合单基因和多基因预后分析
GEPIA2常用于差异表达和生存分析。它的生存分析模块分得比较清楚,适合做标准化展示。
主要有三个模块。
Survival Analysis 用于单基因分析,输入基因名后,通常选择OS,cut off设为中位数,再选癌种数据集,如LIHC。
Most Differential Survival Genes 可直接查看某癌种中差异预后基因列表。
Survival Map 则支持多基因生存分析,适合把一组候选基因一起放入分析。
对于科研写作来说,GEPIA2很适合做“候选基因筛选后的再验证”。尤其是多基因结果,能够把研究从单点观察推进到基因集层面。
2.3 KM Plotter,生存分析更成熟
KM Plotter是经典的在线生存分析网站。它支持mRNA芯片数据、mRNA测序数据和部分miRNA分析。其数据库覆盖样本量大,文献引用也很多,因此常被用于预后验证。
其特点是可以分析大量基因与癌症样本,并支持多种亚组参数。比如病理分期、患者基本信息和风险因素等。对于需要更深入临床分层的研究,这个平台很有用。
如果你关注的是“一个基因在不同临床背景下是否仍有预后价值”,KM Plotter很值得优先考虑。
3. 三个数据库怎么选,怎么用
3.1 按研究目的选工具
不同工具并不是互相替代,而是互补关系。建议按目的选择。
- 想快速初筛,先用UALCAN。
- 想做标准单基因或多基因展示,可用GEPIA2。
- 想做更成熟的生存验证和亚组分析,优先KM Plotter。
最理想的做法,是至少用两个数据库交叉验证。
如果同一基因在两个独立平台上都显示一致趋势,可信度会更高。
3.2 以肝癌TCGA分析为例
以LIHC为例,常见流程可以简化为三步。
- 在UALCAN中输入基因,选择TCGA Gene和LIHC数据集,查看表达和生存。
- 在GEPIA2中选择Survival Analysis,设定OS和中位数cut off,读取KM曲线。
- 在KM Plotter中输入单基因或多基因列表,设置结局指标后生成生存图。
如果一个基因在肝癌中高表达,并且生存曲线显示高表达组OS更差,那么它就可能是值得进一步研究的候选预后标志物。
但如果三者结果不一致,就要回到数据层面检查。
3.3 结果不一致时先查什么
在线分析里,结果不一致很常见。不要先下结论,先查以下几点:
- 癌种是否一致。
- 数据集是否一致。
- 结局指标是否一致,OS、DFS、RFS不能混用。
- cut off是否一致,中位数还是最佳截点。
- 单基因还是多基因模型。
- 是否存在亚组偏倚。
很多“矛盾结果”,其实来自分析设定不同,而不是基因本身无效。
4. 做在线预后分析时,必须注意的质量控制
4.1 样本和分组要合理
公开数据库并不意味着可以直接无脑使用。进行预后分析前,要确保样本来源、组织类型和分组信息合理。样本太少、分组混乱、处理条件特殊,都会影响解释。
一般来说,建议重点关注以下问题:
- 是否有明确对照和疾病组。
- 每组样本是否过少。
- 是否混入特殊处理样本,如加药、敲除、辐射等。
- 组织来源是否一致。
- 测序类型是否匹配研究目的。
4.2 不要忽略平台和注释问题
芯片数据和测序数据不能随意混用。芯片数据需要注意探针注释,尤其是不同平台之间的标准化问题。平台不一致时,同一基因的表达值可能有差异。
这也是为什么很多研究会优先选用大平台、成熟平台和已发表队列。
对科研人员而言,稳定性和可解释性比“样本越多越好”更重要。
4.3 只展示支持结论的结果
科研展示不是把所有图都堆上去。你要保留能支持主线结论的数据,同时保留必要的补充说明。对于在线预后分析也是一样。
建议保留的结果包括:
- 生存曲线。
- 风险分组方式。
- P值和HR,如工具提供。
- 数据集名称和癌种。
- 关键参数,如cut off和结局指标。
写论文时,必须把方法写清楚,别人才能复现。
5. 在线预后分析如何服务论文和课题
5.1 从候选基因到预后标志物
一个常见的研究路径是:差异分析筛基因,PPI或富集分析定机制方向,再用在线预后分析验证临床意义。这样逻辑更完整。
如果一个基因不仅在肿瘤中差异表达,而且在生存分析中显著相关,那么它就具备进一步开发的价值。接下来可以做:
- 临床样本验证。
- 免疫浸润相关分析。
- Cox回归分析。
- 机制实验验证。
5.2 如何让结果更可信
最关键的是独立验证。
理想情况下,至少有一个在线数据库验证,再加一个外部数据集或本地样本验证。这样能减少单一数据库带来的偏差。
此外,分析时不要只看P值。还要看:
- 方向是否稳定。
- 效应量是否足够。
- 是否存在明显分层差异。
- 结果是否具有生物学合理性。
5.3 结合解螺旋提高效率
如果你在做在线基因预后分析时,经常卡在数据筛选、数据库选择、结果解读和图表整理上,可以借助解螺旋的标准化分析思路与课程资源。解螺旋更适合帮助你把零散的在线结果整理成能用于课题和论文的证据链。 对医学生和科研新人来说,这能明显减少走弯路的时间。
总结Conclusion
在线基因预后分析,是生物医学研究中非常实用的第一步。它能快速筛出与生存相关的候选基因,帮助你从“表达变化”走向“临床价值”。但要记住,工具只是工具,真正决定结果质量的,是数据选择、参数设定和结果解释。
如果你正在做肿瘤转录组、TCGA挖掘或论文选题,建议把UALCAN、GEPIA2和KM Plotter作为基础工具组合使用。先初筛,再验证,再结合实验和独立数据集补强证据。
如果你希望更高效地完成这一步,欢迎进一步了解解螺旋,让在线基因预后分析真正服务于你的科研产出。
- 引言Introduction
- 1. 为什么要做在线基因预后分析
- 2. 三个最常用的在线预后数据库
- 3. 三个数据库怎么选,怎么用
- 4. 做在线预后分析时,必须注意的质量控制
- 5. 在线预后分析如何服务论文和课题
- 总结Conclusion