13
 分享

引言Introduction
TCGA数据量大、样本复杂、注释繁琐。很多人卡在下载、清洗、分组和差异分析这几步,最后图还没画出来,时间已经耗尽。如果你想快速完成TCGA数据在线可视化,并直接得到可解释的差异结果,关键不是会不会写代码,而是有没有一套稳定流程。

1. 为什么TCGA数据在线可视化不能只看“图”
1.1 在线可视化的价值,不只是出图
TCGA数据在线可视化的核心,是把复杂的测序表达数据转成可读结论。对医学生、医生和科研人员来说,最常见的需求有三类。
- 看肿瘤和正常样本是否分开。
- 看某个基因在不同组中的表达差异。
- 看差异基因能否支撑后续机制研究或模型构建。
真正有价值的可视化,不是图形好看,而是分组清楚、统计可靠、结果可复现。 如果样本注释错了,或者前处理不规范,PCA、火山图、热图都可能给出误导性结论。
1.2 差异分析前,先解决三个问题
在线可视化之前,至少要回答这三个问题。
- 样本来自哪里,TCGA还是TCGA合并GTEx。
- 样本如何分组,肿瘤、正常,还是癌旁。
- 数据是否经过过滤、标准化和批次处理。
在课程示范里,先对metadata做整理,再过滤低质量样本,最后提取表达矩阵。这个顺序不能反。 因为可视化展示的是结果,结果的可信度取决于前面的每一步。
2. TCGA差异分析的标准流程
2.1 从项目结构开始,避免一上来就跑图
在实际项目中,代码通常分成几个部分:自定义函数、差异分析代码、GO和KEGG分析代码、预后模型代码,以及数据下载代码。这样的结构有两个好处。
- 便于复用。
- 便于排错。
课程中先加载自定义函数,再读取RNA测序数据,如FPKM和TPM数据。先确认数据结构,再进入差异分析,是提升效率的第一步。 很多人直接做图,结果发现列名、样本ID、分组信息不一致,最后需要返工。
2.2 样本清洗决定了后续图是否可信
TCGA样本并不总是“肿瘤对正常”那么简单。课程里对metadata进行了整理,提取文件名、样本全名、TCGA ID、病人名称和组织类型ID,并根据组织类型建立group信息。
随后又读取样本质量注释文件,逐个检查并过滤不合适样本,最终过滤掉23个样本。这个步骤非常关键。因为一个异常样本,足以改变聚类方向和差异基因列表。
建议重点检查以下内容。
- 样本barcode是否和表达矩阵一致。
- 是否存在重复样本。
- 是否存在低质量或注释错误样本。
- 肿瘤和正常样本是否真正可比。
2.3 过滤后再标准化,结果更稳
在表达矩阵整理完成后,通常会筛选protein coding基因,并保留表达量大于0的基因。随后再进行标准化,比如使用DESeq2中的VST方法,或者在合并数据集时使用RUVSeq进行校正。
标准化的目的不是“美化数据”,而是减少技术噪音。
如果不做这一步,在线可视化很可能会把测序深度差异、批次差异误判为生物学差异。
3. 在线可视化最常用的三类图
3.1 PCA图:先看分组是否合理
PCA是最常见的第一步。它能快速判断肿瘤和正常样本是否有整体分离趋势。课程示例中,对合并数据集、单独数据集和TCGA数据集分别进行了PCA分析。
PCA图的作用有三个。
- 检查样本整体结构。
- 发现明显离群点。
- 评估分组是否有可分析性。
但要注意,PCA只能作为参考,不能单独作为结论。 课程中也明确提到,PCA的权重较低,不能完全反映数据真实情况。尤其是在合并TCGA与GTEx时,K值不同,样本的聚集形态也会变化。
3.2 火山图:直接展示差异基因分布
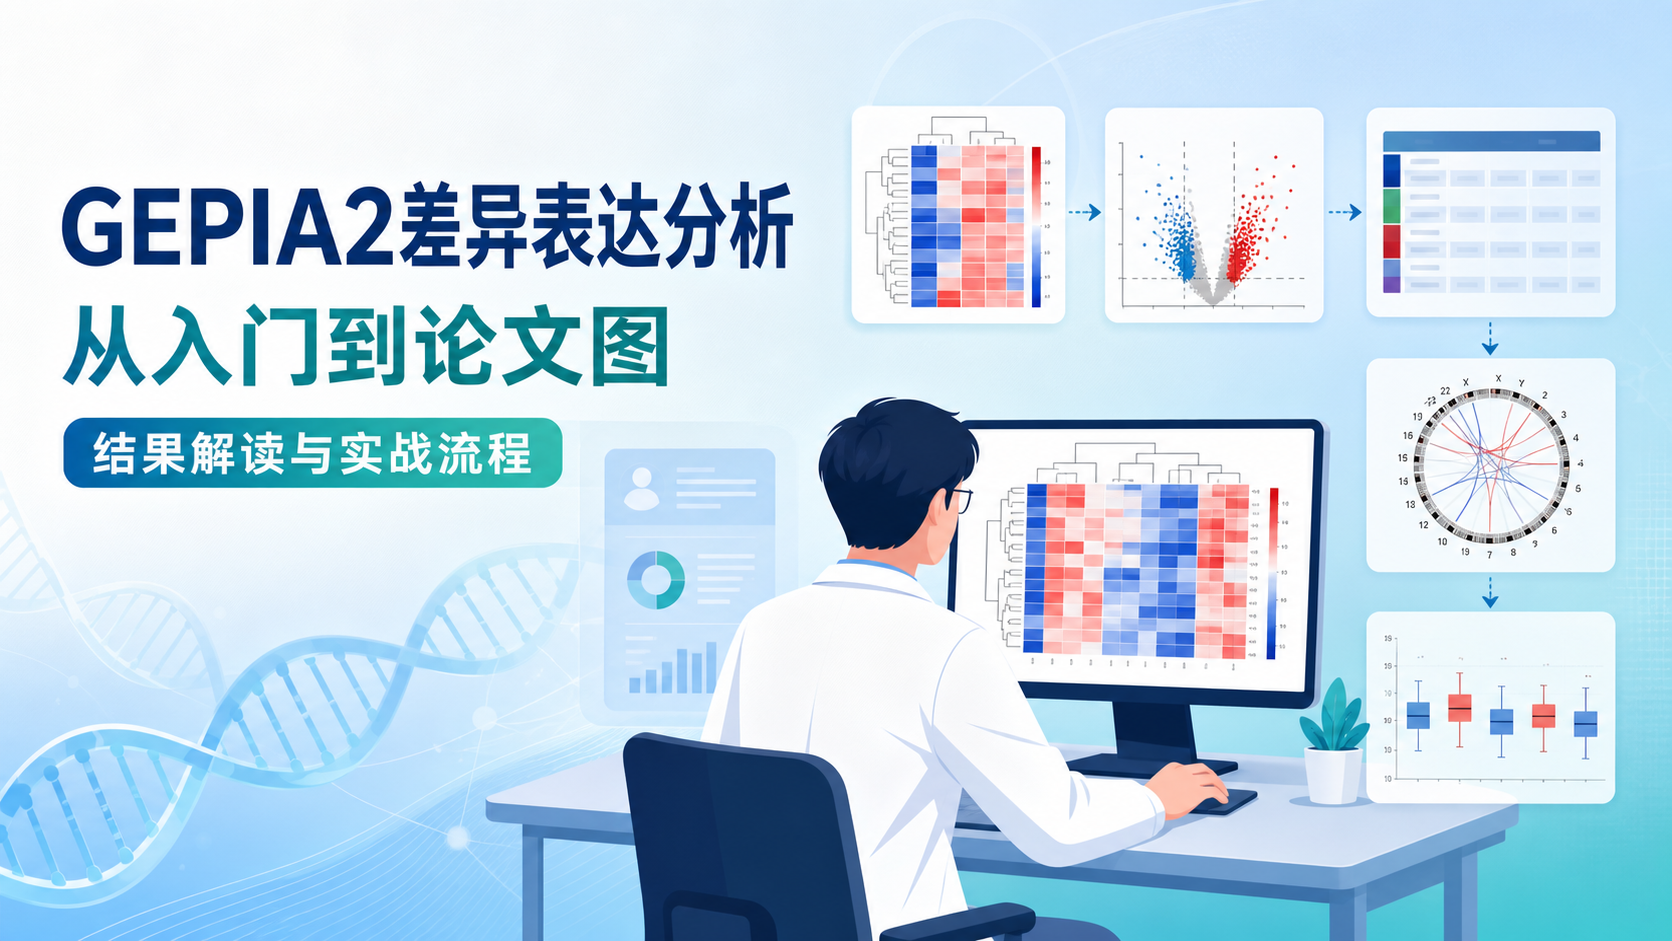
差异分析完成后,火山图是最直观的结果图。横轴通常是logFC,纵轴是显著性。图上可以直接看到上调基因、下调基因和无显著差异基因。
课程中在DESeq2结果基础上,重新注释基因name,并根据p值和logFC加入direction列,区分上调、下调和不显著。这是火山图能否准确表达生物学意义的关键。
常见判断逻辑是:
- p值显著且logFC为正,上调。
- p值显著且logFC为负,下调。
- 其余为无显著差异。
3.3 热图和箱线图:把单基因差异看清楚
当你已经锁定候选基因时,热图和箱线图更适合做展示。课程里用pheatmap绘制了15个有氧呼吸相关差异基因的表达矩阵,也用箱线图和小提琴图展示了单基因在不同组的表达。
这类图适合回答两个问题。
- 某个基因是否真的在肿瘤中升高或降低。
- 差异是否具有样本层面的稳定性。
对于论文图和汇报图来说,箱线图、热图和火山图往往是最核心的三张图。
4. 零代码也能做,但必须懂差异分析逻辑
4.1 在线平台适合快速验证假设
如果你的目标是快速验证一个基因或一个基因集,tcga数据在线可视化确实能节省大量时间。你不需要从头写R代码,也不必自己处理每个细节。
它适合这些场景。
- 预实验阶段的假设筛选。
- 课堂教学和结果演示。
- 临床科研中的初步观察。
- 候选基因的快速表达验证。
但零代码不等于零门槛。 你至少要懂样本分组、表达量标准、统计检验和图形解读。否则即使界面很简单,也容易用错数据类型或误读结果。
4.2 真正影响结果的,是几个细节参数
课程里在TCGA与GTEx合并分析时,特别强调了K值选择。无论是K=0、K=1还是更高的K值,结果都可能不同。示范中更倾向于K=1,因为它对管家基因进行了校正,而不是完全不校正。
这说明一个事实。在线可视化再方便,也离不开底层统计逻辑。
你需要关注的不是“能不能出图”,而是以下几点:
- 是否做了合适的归一化。
- 是否处理了批次效应。
- 是否对样本进行了正确分组。
- 差异基因是否经过合理阈值筛选。
- 可视化是否与统计结果一致。
5. TCGA和GTEx合并时,为什么更要谨慎
5.1 合并分析能扩大样本量,但也会引入偏差
TCGA本身常常缺少足够的正常对照样本,因此很多研究会与GTEx合并分析。这样做的优势很明显。
- 样本量更大。
- 正常对照更充足。
- 差异分析更有统计力量。
但问题也同样明显。不同数据库、不同测序流程、不同样本来源,都会带来技术偏差。
课程中用RUVSeq和管家基因列表进行校正,就是为了减少这种偏差。
5.2 合并分析的可视化,更适合看“校正前后差异”
在课程示范里,对recount2和TCGA数据进行了对比,并观察k=0、k=1、k=2、k=3时差异基因的重合度。结果显示,部分基因在不同设置下不一致,约有1/3的基因可能受校正策略影响。
这类分析非常有启发性。它告诉我们:
- 共同差异基因更稳妥。
- 只在某一参数下出现的基因,需要更谨慎解释。
- 可视化结果必须结合参数设置一起看。
如果你只看图,不看数据处理过程,很容易把技术噪音当成生物学发现。
6. 在线可视化后的下一步,应该怎么做
6.1 从图回到问题,做功能解释
差异分析不是终点。真正的目标是从图中找到可解释的生物学方向。常见下一步包括:
- GO富集分析。
- KEGG通路分析。
- 核心基因筛选。
- 预后模型构建。
- 外部队列验证。
课程结构里也清楚地把差异分析、GO/KEGG分析和预后模型分开,这正是规范做法。先看差异,再看功能,最后看临床意义。
6.2 用标准化流程提升复现性
对于科研人员来说,最怕的是“这次能出图,下次出不来”。标准化流程能显著减少这个问题。建议保留以下内容。
- 原始输入文件。
- 清洗后的样本表。
- 标准化后的表达矩阵。
- 差异分析参数。
- 图形脚本和输出结果。
这样无论是投稿、答辩还是组会汇报,都能快速复现。
6.3 解螺旋如何帮助你更快完成TCGA可视化
如果你希望把TCGA数据在线可视化真正落地,而不是停留在看图阶段,解螺旋可以帮助你把“数据下载、样本整理、差异分析、结果可视化”串成完整流程。
这类工具和课程体系的价值,在于减少重复操作,让你把时间集中在结果解释、机制挖掘和论文产出上。对于医学生、医生和科研人员来说,这意味着更快完成验证,更稳拿到可信图表。
总结Conclusion
TCGA数据在线可视化的核心,不是单纯画图,而是把样本清洗、标准化、差异分析和结果展示连成闭环。PCA用于看整体结构,火山图用于看差异分布,热图和箱线图用于验证单基因表现。
如果你想更高效地完成这套流程,可以借助解螺旋,把复杂步骤压缩成可复用的规范分析路径。这样你不仅能更快出图,也能让结果更可靠、更适合科研发表。
- 引言Introduction
- 1. 为什么TCGA数据在线可视化不能只看“图”
- 2. TCGA差异分析的标准流程
- 3. 在线可视化最常用的三类图
- 4. 零代码也能做,但必须懂差异分析逻辑
- 5. TCGA和GTEx合并时,为什么更要谨慎
- 6. 在线可视化后的下一步,应该怎么做
- 总结Conclusion