9
 分享
引言Introduction
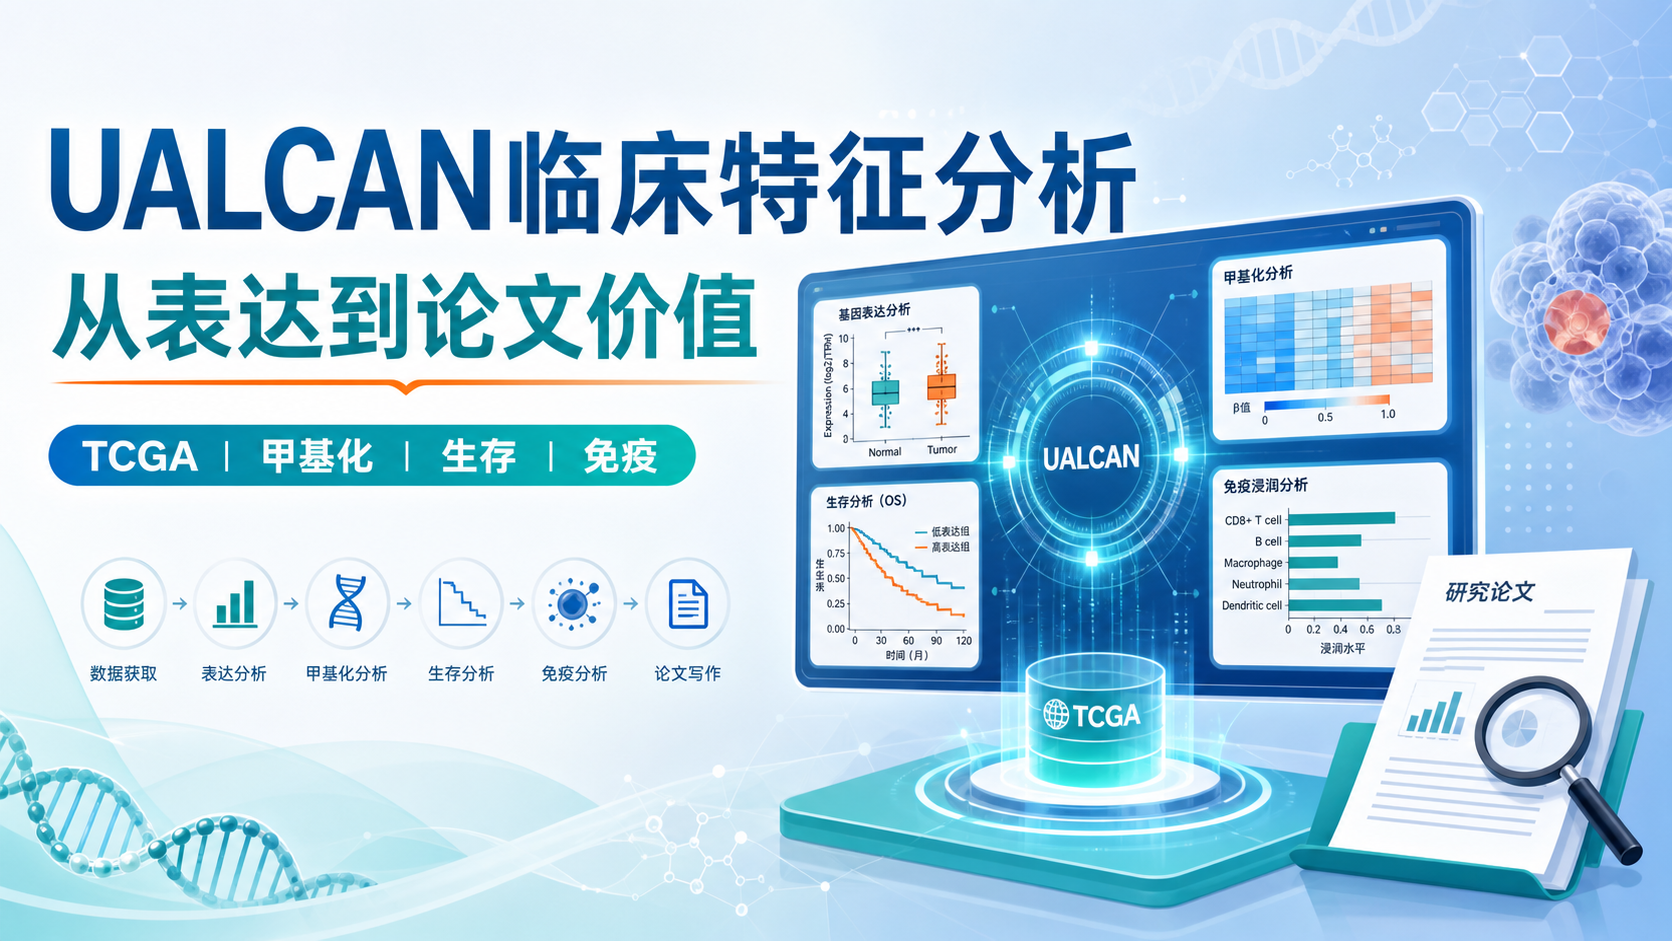
UALCAN是TCGA数据分析中最常用的在线工具之一。很多人会用它查表达,但真正有价值的,是把基因表达、甲基化、分型和临床特征 连起来看。对于医学生、医生和科研人员来说,这一步常常决定研究能否从“有差异”走向“有结论”。
1. 为什么UALCAN适合做临床特征分析
1.1 从“看表达”到“看临床意义”
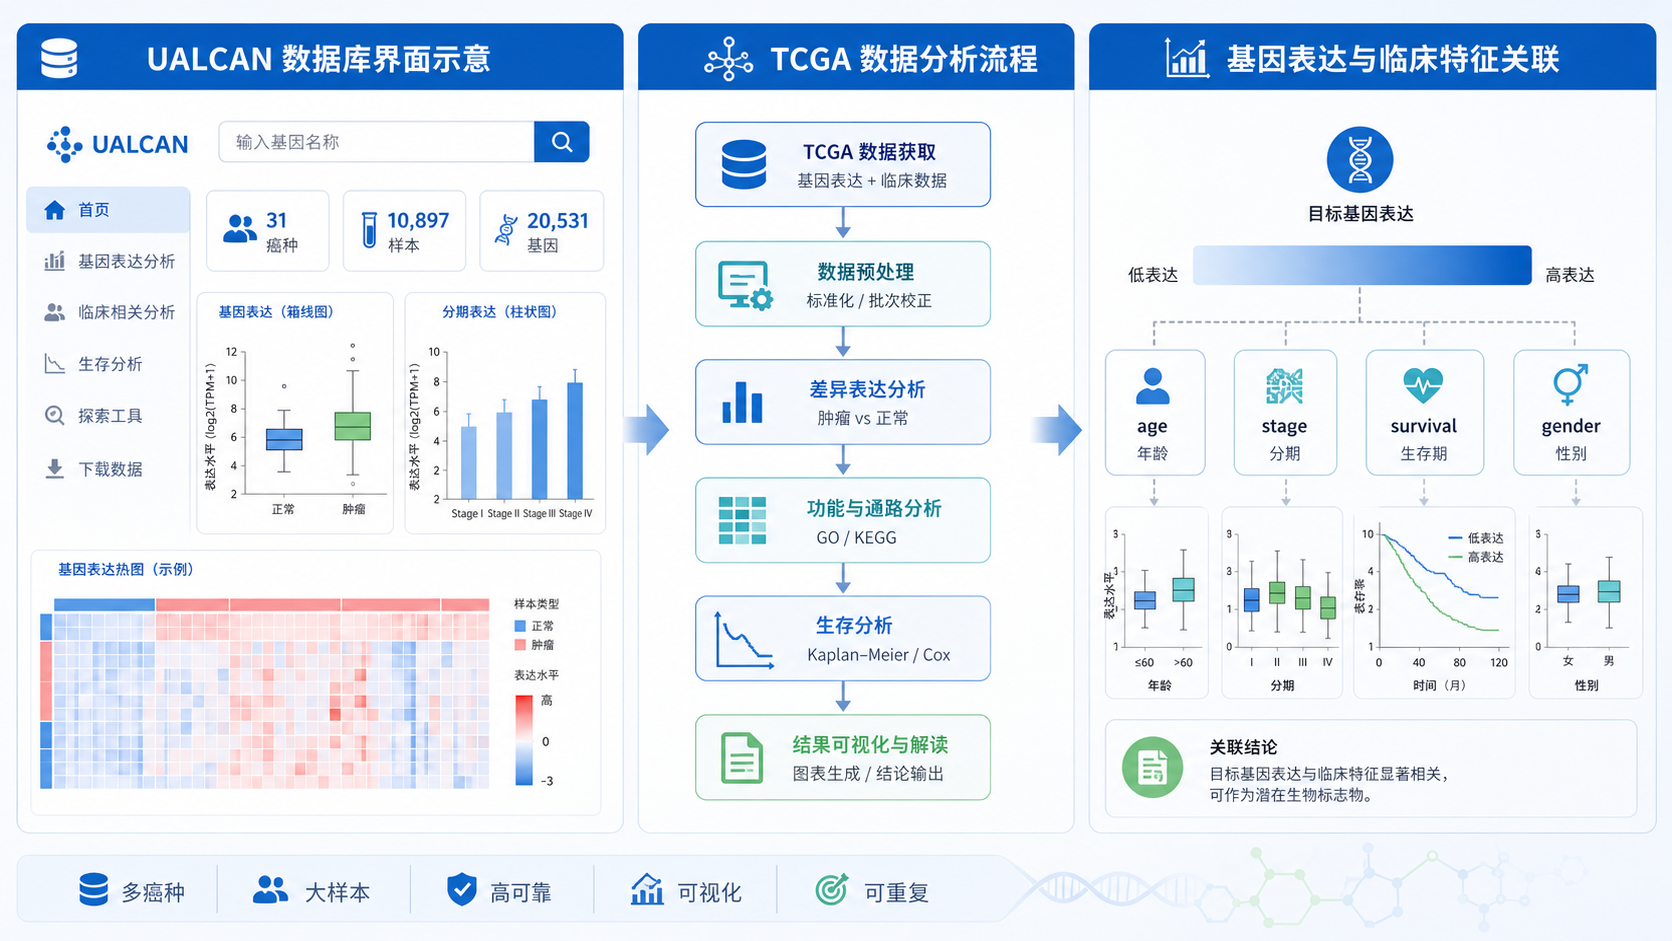
UALCAN的优势不只是可视化。它基于TCGA等公开队列,能直接把基因表达结果和肿瘤分期、分级、性别、年龄、TP53状态、种族、样本类型 等临床变量对应起来。
这类分析的价值在于,它能帮助研究者判断某个基因是否真的和疾病进展相关,而不是只停留在“肿瘤组高于正常组”的层面。如果一个基因在晚期、低分化或特定分子亚型中持续升高,临床解释力就会明显增强。
1.2 适合哪些研究问题
UALCAN临床特征分析常用于回答三类问题。
- 目标基因是否存在分期依赖性变化。
- 目标基因是否与生存、分化或分子亚型有关。
- 目标基因是否可能受到甲基化等表观遗传机制调控。
以Siglec-15为例,已有研究利用TCGA、GTEx、cBioPortal、UALCAN、Kaplan-Meier plotter、TISIDB和CIBERSORT等数据库,分析其泛癌表达、启动子甲基化、免疫浸润和预后价值,并在肺癌样本中通过RT-qPCR和免疫组化验证。这说明UALCAN更适合放在完整生信链条中使用,而不是孤立使用。
1.3 研究者最容易忽略的点
UALCAN显示的是数据库层面的关联,不等于因果关系。
因此,临床特征分析的正确定位是“假设生成”和“机制线索筛选” 。
常见误区包括:
- 只看P值,不看样本量。
- 只看一个癌种,不做交叉验证。
- 只做表达差异,不补充甲基化或预后分析。
这些问题会直接影响论文可信度。
2. UALCAN中临床特征分析的核心模块
2.1 TCGA Gene analysis是主入口
进入UALCAN后,优先选择TCGA模块中的TCGA Gene analysis 。这是最常用的入口,因为它支持表达、分型、生存及临床变量分析。
在这个界面中,研究者可以通过两种方式进入临床特征分析。
- 按癌种检索目标基因。
- 按功能基因集或输入基因列表检索。
对于单基因研究,建议先用癌种检索模式建立基础表达图,再进入临床特征分层。对于基因家族研究,可以直接使用功能基因集模式,提高效率。
2.2 临床特征分析能看什么
UALCAN在TCGA框架下常见的临床分层包括:
- 肿瘤分期。
- 肿瘤分级。
- 年龄。
- 性别。
- 种族。
- 组织学亚型。
- TP53突变状态。
其中,分期和分级最常用于判断基因是否与肿瘤进展相关 。例如,若某基因在stage I到stage IV中呈递增趋势,且趋势具有统计学意义,就提示其可能参与侵袭或转移过程。
2.3 甲基化分析是重要补充
UALCAN不仅能看表达,还能看启动子甲基化。
在上游知识库中,研究者已使用UALCAN查询癌与癌旁组织间Siglec-15启动子DNA甲基化数据,并结合R作图。
这一步很关键,因为表达变化不一定来自转录激活,也可能来自甲基化异常 。
如果一个基因表达升高,同时启动子甲基化降低,那么结果更符合表观遗传调控逻辑。对于机制讨论,这种证据链更完整。
3. 规范开展UALCAN临床特征分析的步骤
3.1 先明确变量,再选癌种
临床特征分析不能从“点哪里都行”开始。
正确顺序是:
- 明确研究问题。
- 选择癌种。
- 设定临床变量。
- 再看表达差异。
如果研究的是肺癌中的Siglec-15,就应先锁定肺腺癌或肺鳞癌,再进一步比较不同分期、分级和分子亚型。这样分析逻辑更清晰,也更容易写进论文结果部分。
3.2 读图时重点关注三件事
UALCAN输出图形通常较直观,但解读时建议盯住三个核心信息。
- 样本量。 少样本分层的结论要谨慎。
- 趋势方向。 是递增、递减还是无明显变化。
- 统计学意义。 不同分层之间是否存在显著差异。
如果某个癌种正常样本数少于10,UALCAN页面通常不会高亮显示。这种情况下,不建议强行下结论,应结合其他数据库或独立队列验证。
3.3 从表达走向生存和免疫
临床特征分析最好不要停在单一维度。
一个更完整的路径是:
- 表达差异。
- 临床分层。
- 生存分析。
- 免疫浸润分析。
- 必要时加甲基化验证。
例如,某些基因在晚期患者中高表达,同时与总生存缩短相关,进一步又和免疫细胞浸润变化相关,这样更容易构建出“临床表型-分子机制-预后”闭环。
4. UALCAN临床特征分析的结果如何写进论文
4.1 结果部分要写清楚“对象、变量、方向”
高质量结果描述不应只写“差异有统计学意义”。
建议明确写出以下信息:
- 分析对象是哪个癌种。
- 目标基因是什么。
- 比较了哪些临床变量。
- 差异方向如何。
- 是否存在统计学意义。
例如,可以写成:某基因在高分期组中表达高于低分期组,提示其可能与肿瘤进展相关。这样的表达更适合论文正文,也更符合E-E-A-T中的专业性要求。
4.2 讨论部分要避免过度推断
UALCAN给出的主要是关联结果,不是机制证明。
因此,讨论时建议采用稳健表述。
- 可以说“提示可能参与”。
- 可以说“与临床进展相关”。
- 不建议直接写“导致”“决定”“证明”。
如果有甲基化、IHC、RT-qPCR或外部队列支持,再进一步讨论机制会更稳妥。
这也是为什么很多高质量文章会把UALCAN作为起点,再接cBioPortal、TISIDB、Kaplan-Meier plotter和实验验证。
4.3 可复用的分析框架
如果你准备做一篇完整的生信文章,可以采用下面的框架:
- UALCAN查询目标基因在肿瘤和正常组织中的表达。
- 按分期、分级和临床亚型分层。
- 结合生存分析判断预后价值。
- 用启动子甲基化解释表达变化。
- 用免疫浸润结果补充生物学意义。
- 用实验或独立数据集验证。
这个框架适合单基因,也适合基因家族研究。
对于CDCA家族、Siglec-15或其他候选基因,这种路线都具有较强通用性。
5. 让UALCAN分析真正产生论文价值
5.1 不是“会点按钮”,而是会做问题设计
很多人卡在UALCAN,不是不会操作,而是不会定义问题。
真正有效的临床特征分析,核心是把数据库结果转成可写、可证、可扩展的研究问题。
比如:
- 这个基因是否提示更晚的临床分期。
- 这种变化是否在某一癌种中特别明显。
- 这种差异是否与启动子甲基化有关。
- 是否与免疫浸润改变同步出现。
这些问题一旦明确,后续写作、作图和补实验都会顺畅很多。
5.2 从数据库到文章,关键在证据链
UALCAN本身只是证据链中的一环。
高质量文章通常需要把以下内容串起来:
- TCGA表达差异。
- UALCAN临床分层。
- 生存分析。
- 甲基化或突变信息。
- 免疫浸润或功能富集。
- 外部样本验证。
只有这样,文章才不容易被审稿人认为“只是做了一个在线数据库截图”。
5.3 如果你想提高效率
如果你正在准备论文、课题或开题,建议直接采用成熟的数据库分析与写作工具,减少重复劳动。
像解螺旋 这类平台,可以帮助你更高效地梳理UALCAN临床特征分析、TCGA数据挖掘和结果呈现逻辑,把时间集中在科学问题本身,而不是反复调图和整理格式。
总结Conclusion
UALCAN的价值,不只是看单个基因是否上调,而是把TCGA中的表达、甲基化和临床特征联系起来,帮助研究者发现更有解释力的关联。对医学生、医生和科研人员来说,真正有意义的不是“看到差异”,而是“看到差异背后的临床线索” 。如果你希望更高效地完成UALCAN临床特征分析,并把结果组织成可发表的生信文章,可以借助解螺旋 提升选题、分析和写作效率。
- 引言Introduction
- 1. 为什么UALCAN适合做临床特征分析
- 2. UALCAN中临床特征分析的核心模块
- 3. 规范开展UALCAN临床特征分析的步骤
- 4. UALCAN临床特征分析的结果如何写进论文
- 5. 让UALCAN分析真正产生论文价值
- 总结Conclusion