11
 分享

引言Introduction
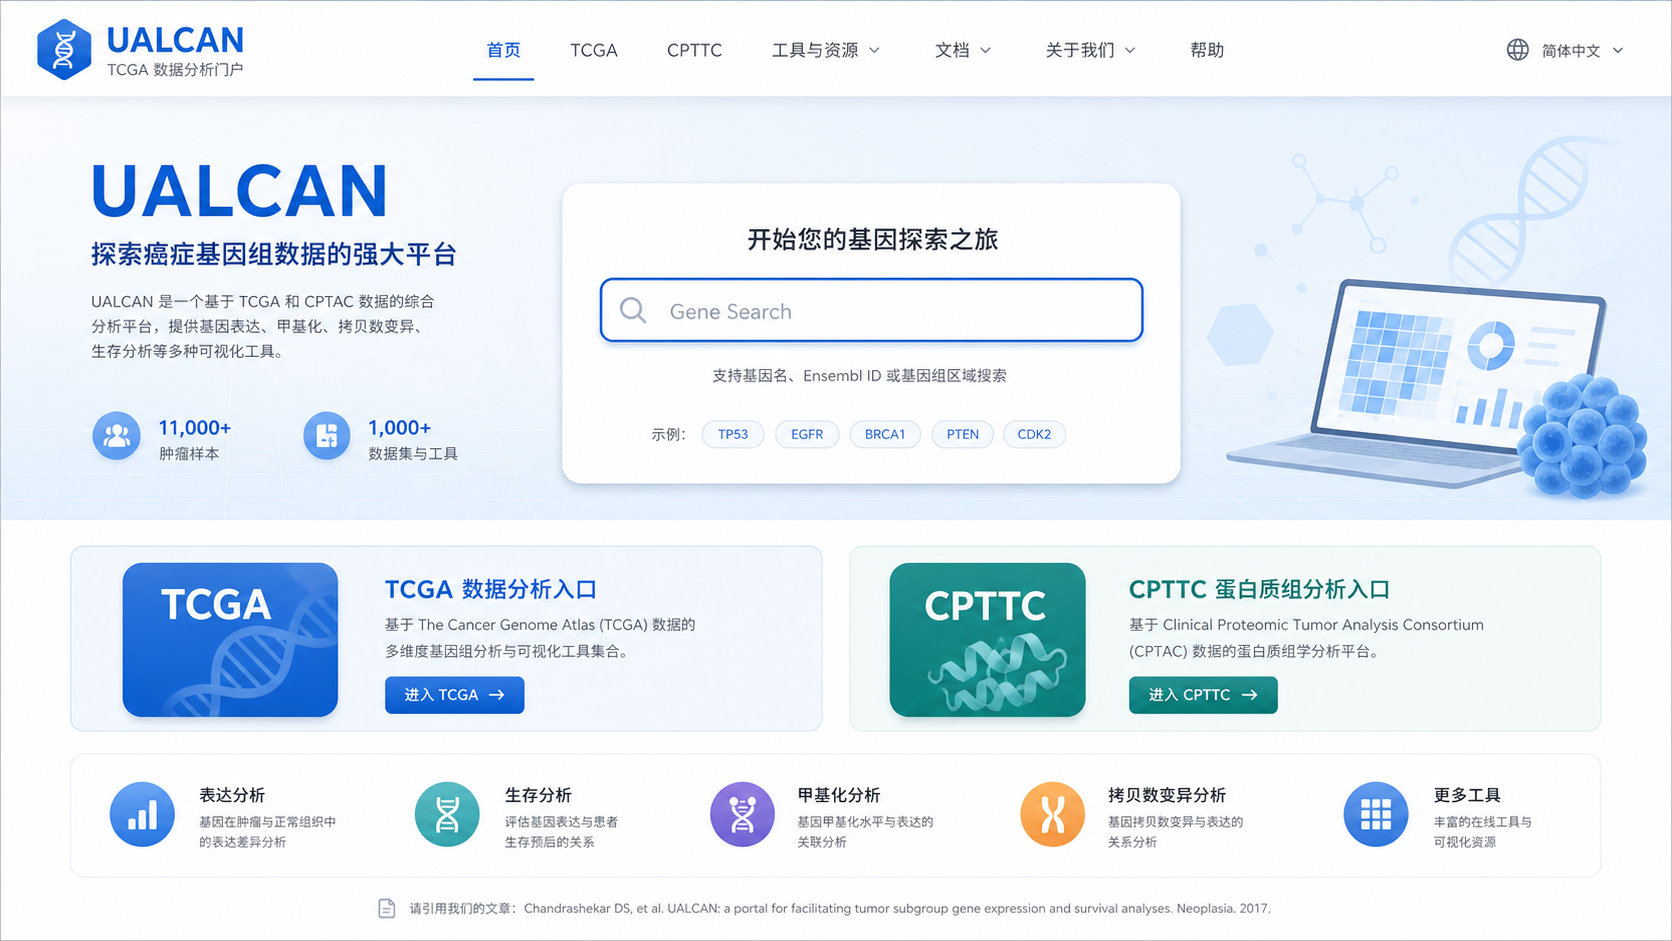
UALCAN数据库是做基因表达差异分析时非常实用的在线工具。它能直接调用TCGA、CPTAC、CBTTC等公开数据,适合医学生、医生和科研人员快速完成表达比较、生存关联和临床分层分析。如果你缺少本地代码环境,UALCAN可以显著降低数据分析门槛。
1. 为什么UALCAN适合做基因表达差异分析
1.1 直接连接公开队列,减少前处理成本
UALCAN最常见的价值,是把复杂的数据分析流程前置封装。用户无需自己下载原始矩阵,也不必先完成标准化、分组和批次处理,就能直接查看差异表达结果。对于课程设计、课题预实验和论文补充分析,这一点非常高效。
它支持的公开癌症组学数据包括TCGA、MET500、CPTAC和CBTTC。 其中,TCGA适合常规肿瘤研究,CPTAC更偏向蛋白组学分析,CBTTC则可用于儿科脑肿瘤相关研究。对于想快速验证候选基因的人来说,这类数据库非常省时。
1.2 适合多层级验证,不止看mRNA
UALCAN不只是看转录水平。它还可以做蛋白表达、磷酸化分析,以及启动子甲基化相关分析。也就是说,一个候选基因可以同时从表达、蛋白和表观遗传三个层面被验证。 这对论文结果的完整性很重要。
如果你的研究已经完成转录组分析,接下来通常需要补充机制线索。UALCAN正好适合做这一步。它能帮助你判断,一个基因的异常表达是否可能与甲基化调控、蛋白丰度变化有关,而不只是停留在“差异显著”这一层。
2. UALCAN数据库的核心分析入口
2.1 TCGA Gene analysis是最常用模块
在主页面点击“TCGA”,再进入“TCGA Gene analysis”,即可开始基因表达差异分析。这个模块是UALCAN最常用的入口,尤其适合肿瘤研究。用户可以输入单个基因,也可以输入一组基因进行批量分析。
需要注意的是,TCGA miRNA analysis和TCGA lncRNA analysis并不显示功能基因集检索模式。 如果你的目标是做功能基因集分析,应优先进入TCGA Gene analysis。
2.2 功能基因集检索更适合课题设计
UALCAN支持两种功能基因检索方式。第一种是按Gene class检索,第二种是直接输入基因符号列表。对于课题设计、通路筛选和候选基因集验证,这两种方式都很实用。
例如,你可以选择“Cell cycle pathway and related genes (KEGG)”这类功能基因集,快速查看相关基因在不同癌种中的表达和生存信息。这种“先通路、后基因”的方式,特别适合从机制层面建立研究假设。
2.3 CBTTC适合儿科脑肿瘤相关分析
如果研究对象是儿科脑肿瘤,可直接在主页面点击“CBTTC”。UALCAN已整合CBTTC数据进行分析,右侧下拉菜单通常只有“pediatric brain cancer”这一项。输入基因后点击“Explore”,即可进入结果页面。
这类分析页面的逻辑与TCGA类似,包括RNA表达、蛋白表达和磷酸化分析。对于儿童脑肿瘤这类公共数据相对有限的疾病,UALCAN能提供非常直接的补充分析路径。
3. 基因表达差异分析的标准操作流程
3.1 单基因分析步骤
UALCAN进行基因表达差异分析的操作很简单,核心步骤如下。
- 打开UALCAN主页。
- 点击“TCGA”或对应数据入口。
- 进入“TCGA Gene analysis”。
- 输入目标基因符号。
- 选择癌种数据集。
- 点击“Explore”查看结果。
以CD274、HIF1A、CSF1R、GAPDH为例,输入后即可得到不同癌种中的表达比较结果。对于初学者来说,这种一键式流程非常适合快速上手。
3.2 多基因列表分析更适合预后和通路研究
如果你已经筛出一组差异基因,可以直接批量输入。系统支持用英文输入法的逗号分隔基因名。不要用空格分隔,否则结果无法正常显示。 这一步虽然简单,但很容易出错。
多基因输入后,UALCAN会生成更完整的分析界面。你可以在同一页面看到表达结果、外部链接,以及后续可扩展的生存信息和临床相关内容。对于需要做“候选基因筛选-功能验证-临床关联”整套流程的人,这个模式效率很高。
3.3 结果页面通常包含三类信息
进入结果页后,UALCAN通常会展示以下内容。
- RNA表达分析结果。
- 蛋白表达分析结果。
- 磷酸化分析结果。
此外,还会提供外部链接,便于跳转到GeneCards、PubMed、HPA、GTEx等数据库。这种设计的好处是,用户可以在一个页面内完成初筛,并迅速扩展到其他证据源。
4. 如何解读UALCAN的表达差异结果
4.1 先看分组,再看方向和统计意义
UALCAN展示的表达差异结果,本质上是肿瘤组与正常组,或不同临床亚型之间的比较。阅读时应优先关注三点。
- 分组是否明确。
- 表达方向是上调还是下调。
- 差异是否具有统计学意义。
只有同时满足“分组清晰、方向明确、统计成立”,结果才适合进入下一步验证。 如果样本量太少,尤其是正常样本少于10的癌种,页面可能不会高亮显示,需要谨慎解读。
4.2 结合临床亚型看结果更有价值
UALCAN的一大优势,是能把表达差异放到临床亚型中看。比如年龄、分期、分级、分子亚型等。很多基因在总体上差异并不强,但在某个分期或某个亚型中非常明显。
这对临床研究尤其重要。因为真正有价值的生物标志物,往往不是“所有人都一致变化”,而是“在特定临床背景下更稳定、更显著”。 UALCAN正适合做这种精细化分层。
4.3 用外部数据库交叉验证,提升可信度
虽然UALCAN很适合初筛,但正式写论文时,最好配合其他数据库做交叉验证。例如:
- HPA,用于蛋白和免疫组化图像补充。
- GEPIA2,用于不懂代码的人做联合分析。
- KM Plotter,用于生存分析。
一个稳妥的策略是,先用UALCAN发现差异,再用HPA或GEPIA2补证,最后用KM Plotter看预后关联。 这样证据链更完整,也更符合E-E-A-T思路。
5. 常见应用场景与实用建议
5.1 课题设计阶段,用于快速筛选候选基因
在课题设计初期,很多人最缺的是“从哪里开始”。UALCAN可以帮助你从大批候选基因中快速筛出更值得继续研究的对象。尤其是当你已经有转录组结果,但还没决定重点基因时,它很实用。
比如,你可以先输入一组差异基因,查看它们在目标癌种中的表达趋势,再结合生存和临床变量筛选优先级。这比盲目挑基因更高效,也更容易形成明确研究假设。
5.2 论文补充分析阶段,用于完善图表链条
很多稿件审稿时会被问到:你的基因是否有蛋白层面的支持,是否与临床分期相关,是否有外部数据库验证。UALCAN可以部分回应这些问题。
对于已经完成转录组分析的课题,UALCAN常用于补充以下内容。
- 肿瘤与正常组织的表达比较。
- 不同分期或亚型中的差异。
- 蛋白表达或磷酸化变化。
- 启动子甲基化相关分析。
这类补充图能明显提高结果的完整度。
5.3 儿科肿瘤和公共数据有限疾病尤其值得用
并不是所有疾病都能轻易拿到高质量组织样本,尤其是儿科肿瘤、罕见病和临床样本不足的研究。此时,UALCAN这类公共数据库的价值更高。它可以作为实验数据不足时的重要补充。
如果你的疾病没有免疫组化图片,HPA可补图;如果需要临床相关和多组学分析,UALCAN很合适。对很多没有条件建立完整实验体系的项目来说,数据库分析是重要的证据来源。
6. 用UALCAN做分析时要注意的限制
6.1 数据库结果不能替代实验验证
UALCAN基于公开数据库,适合发现趋势,但不能直接替代实验。它能说明“存在相关性”,不能直接证明“因果关系”。这一点在写论文时必须保持严谨。
因此,建议将UALCAN结果定位为:
- 候选基因筛选工具。
- 公共数据验证工具。
- 临床相关性补充工具。
真正的机制结论仍需依赖细胞、组织或动物实验。
6.2 结果解释要考虑样本量和癌种差异
不同癌种的数据规模差异很大,结果不能机械套用。尤其在样本量偏小的情况下,统计波动会更明显。对某些癌种,表达显著并不等于生物学意义明确,仍需结合背景文献判断。
所以在使用UALCAN时,建议始终遵循一个原则:先看数据质量,再看统计结果,最后看生物学合理性。
6.3 选择与研究问题匹配的入口
如果你要做肿瘤表达分析,优先TCGA。
如果你要看蛋白层面,关注CPTAC。
如果你研究儿科脑肿瘤,直接看CBTTC。
入口选对了,后续分析会顺很多。 这也是很多人使用数据库时最容易忽略的一点。
总结Conclusion
UALCAN数据库的优势,在于它把复杂的公共组学分析变成了可视化、可快速验证的流程。对于基因表达差异分析,它既能做单基因比较,也能支持功能基因集、临床分层、多组学和外部链接扩展。如果你需要在短时间内完成高质量的初筛和证据补充,UALCAN是非常值得掌握的工具。
在实际研究中,建议把UALCAN作为“发现问题”的起点,再结合HPA、GEPIA2、KM Plotter等数据库做交叉验证。这样你的结论会更稳,更适合写进论文和课题汇报。如果你希望系统学习这套分析思路,可以进一步关注解螺旋,获取更完整的数据库实操与科研写作支持。
- 引言Introduction
- 1. 为什么UALCAN适合做基因表达差异分析
- 2. UALCAN数据库的核心分析入口
- 3. 基因表达差异分析的标准操作流程
- 4. 如何解读UALCAN的表达差异结果
- 5. 常见应用场景与实用建议
- 6. 用UALCAN做分析时要注意的限制
- 总结Conclusion