23
 分享
引言Introduction
MHC结合预测是新抗原筛选和个体化免疫治疗中的关键步骤。如果预测偏差大,后续疫苗设计和T细胞应答分析都会失真。 对医学生、医生和科研人员来说,真正的难点不在“有没有突变”,而在“这个肽段能不能被HLA/MHC有效呈递”。
1. MHC结合预测为何成为精准免疫学核心
1.1 从“突变”走向“可呈递抗原”
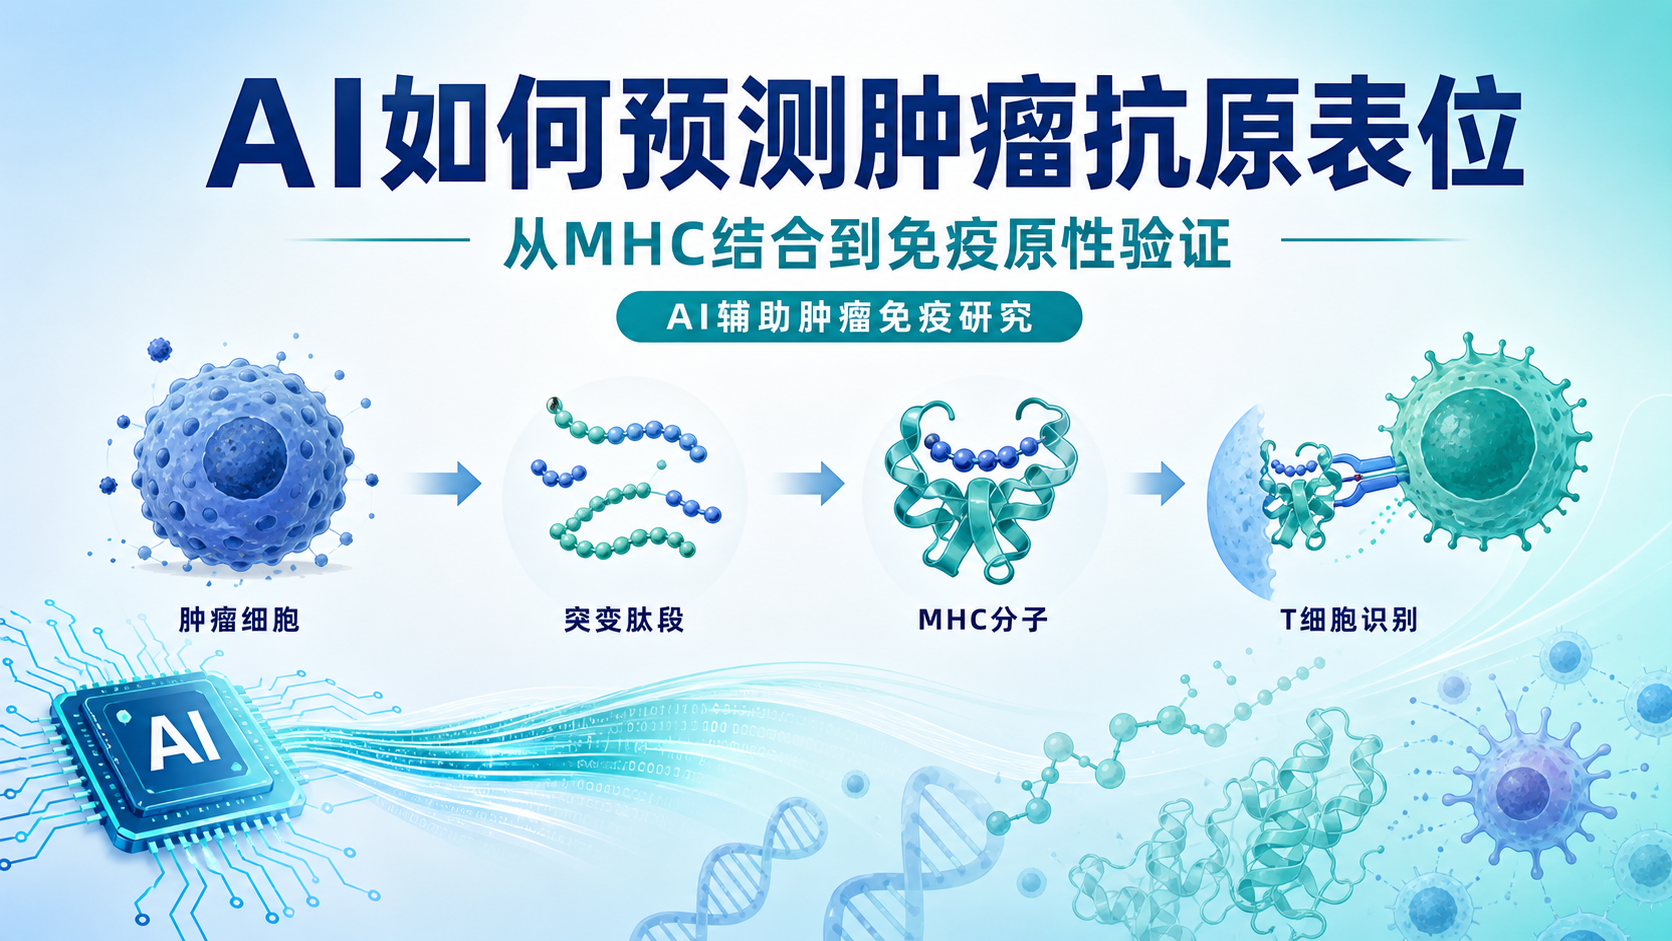
肿瘤体细胞突变很多,但并不是每个突变都能成为有效靶点。要进入免疫识别链条,抗原必须经过加工、切割、转运,并最终与MHC分子结合。因此,MHC结合预测本质上是在回答一个更临床的问题:候选肽段能否真正被呈递到细胞表面。
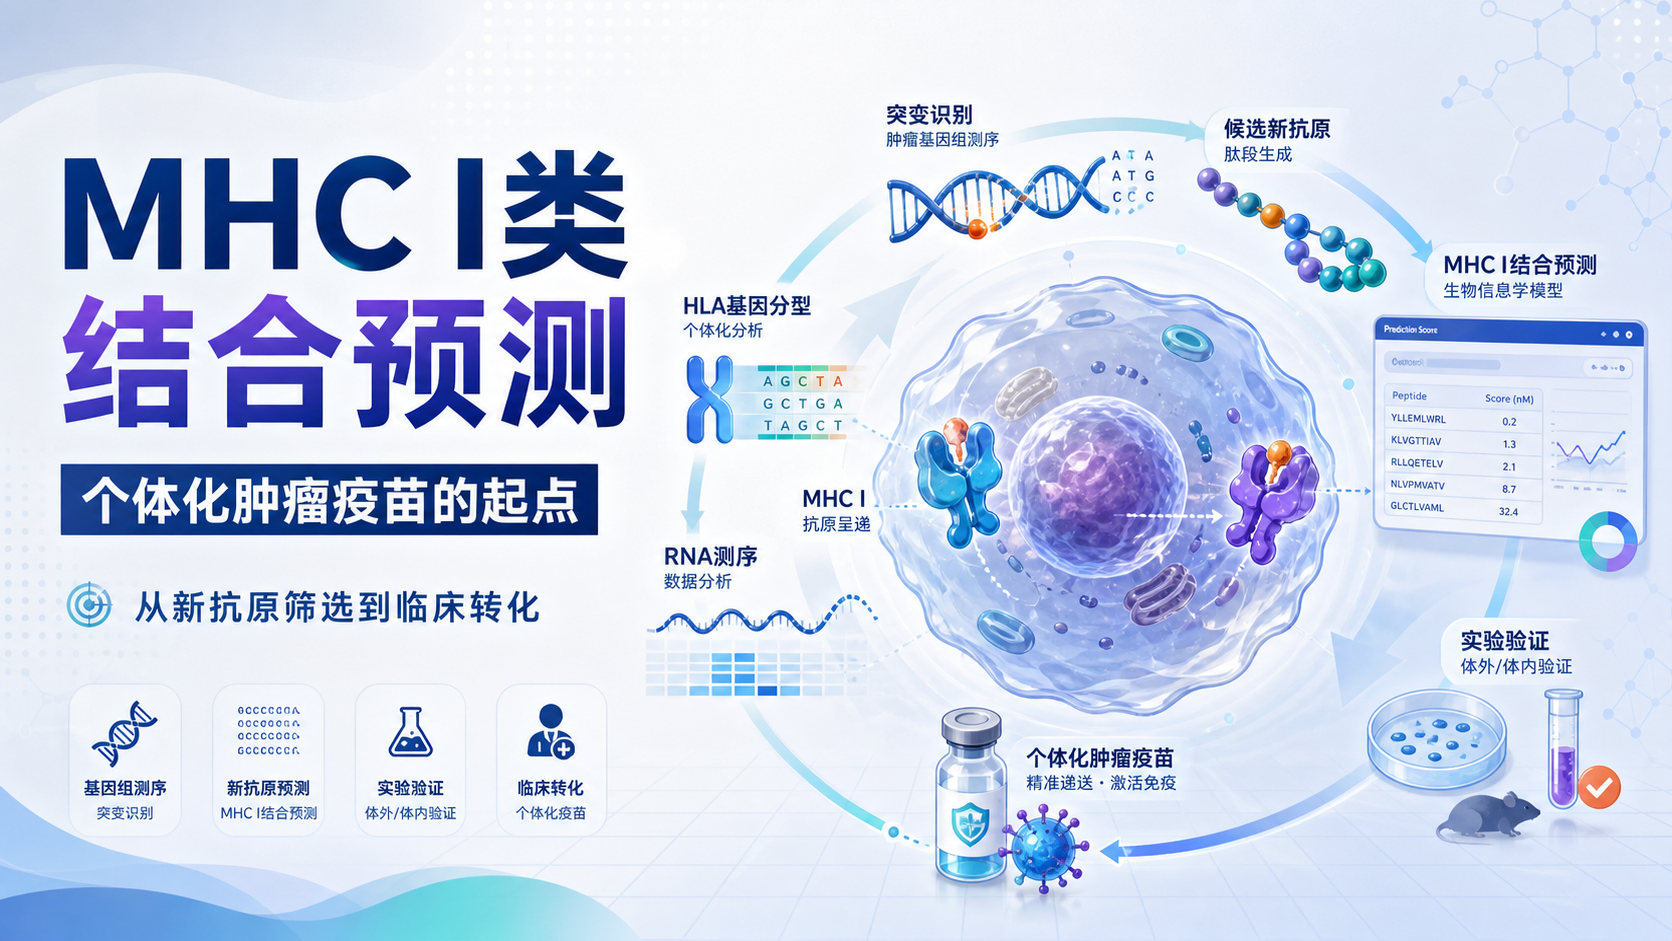
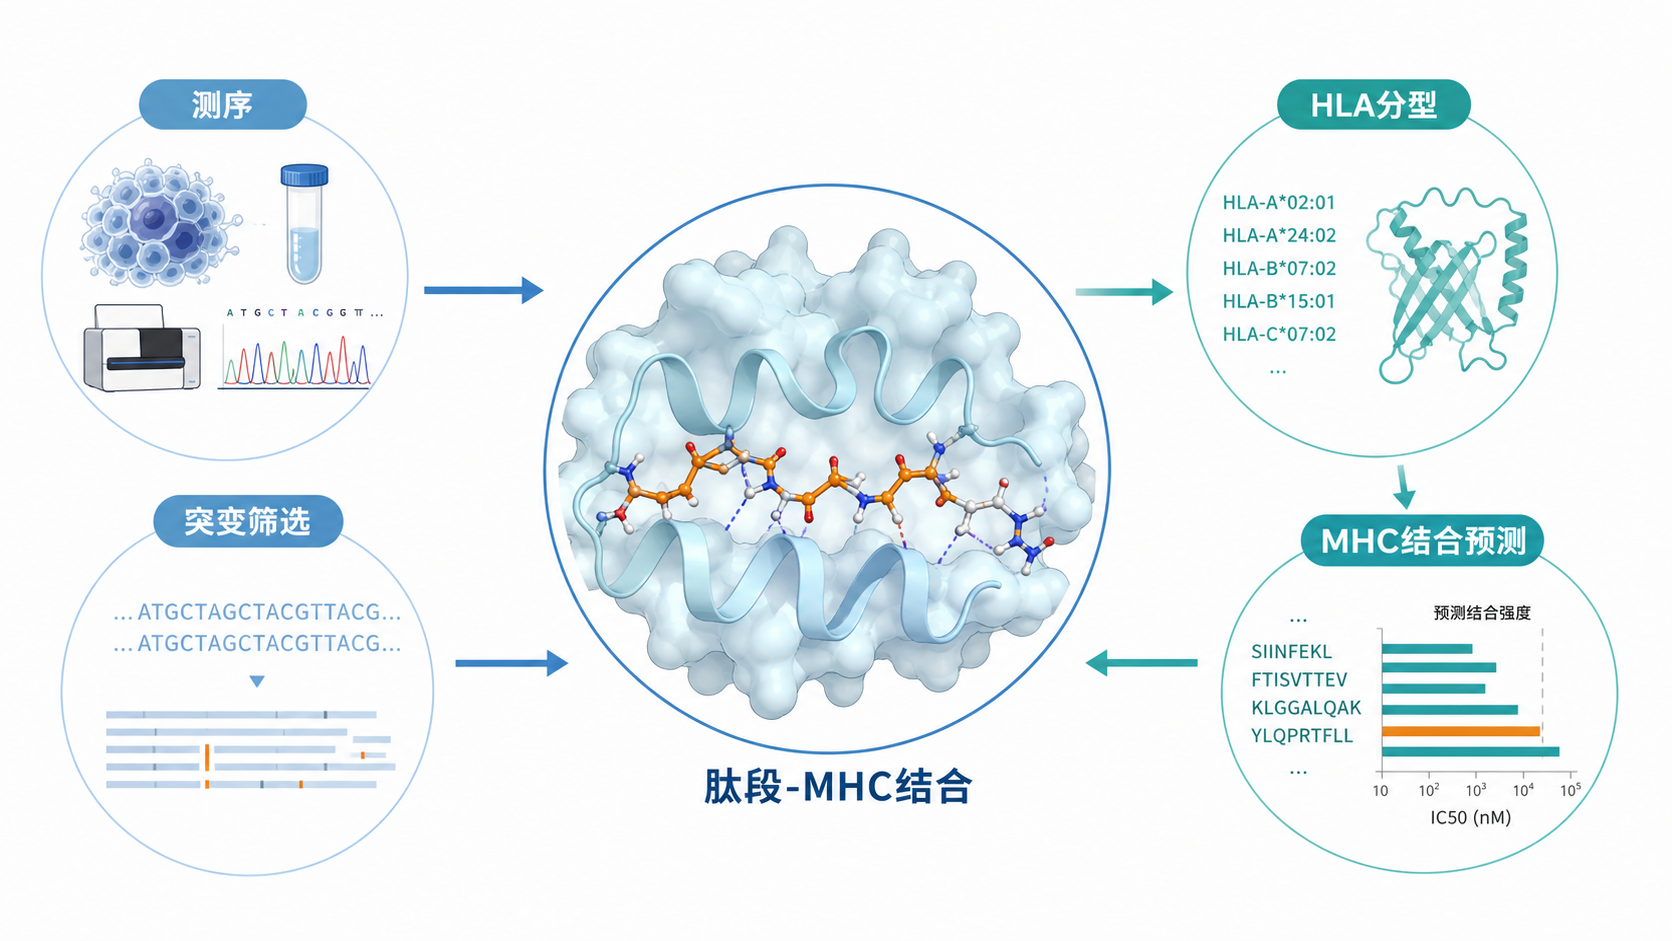
在肿瘤新抗原研究中,这一步决定了筛选效率。WES或RNA测序可找到大量变异位点,但真正进入疫苗设计或T细胞治疗候选库的,往往只是少数高可信肽段。研究流程通常包括DNA变异检测、RNA表达确认、HLA分型,再进入结合亲和力预测。这个顺序不能颠倒。
1.2 MHC与HLA:同一体系下的人类命名
在人体中,MHC通常对应HLA系统。经典I类分子主要包括HLA-A、HLA-B、HLA-C,II类分子则包括HLA-DR、HLA-DQ、HLA-DP等。HLA高度多态,是MHC结合预测必须纳入个体化信息的根本原因。
不同等位基因的结合口袋差异明显。一个肽段对HLA-A*02:01亲和力高,不代表对HLA-B或其他亚型也成立。也正因为如此,精准免疫学更强调“患者特异”的预测,而不是通用结论。
2. 预测对象:从新抗原到HLA表位
2.1 新抗原、肿瘤相关抗原与肿瘤特异性抗原
新抗原通常指由体细胞突变产生、在正常组织中不表达的异常肽段。它们相比传统肿瘤相关抗原更不易触发免疫耐受,因此更适合用于个体化治疗。这是新抗原在肿瘤疫苗和细胞治疗中受到重视的关键原因。
与之相比,肿瘤相关抗原如MUC1、HER2、PSA、MAGE类抗原,往往在正常组织中也有低水平表达,或属于癌睾抗原。这类靶点可用,但免疫耐受和脱靶风险更需要谨慎评估。临床上,靶点“肿瘤特异性”越高,理论上越利于提升治疗窗。
2.2 MHC I类和II类预测的差异
MHC I类主要呈递8至11个氨基酸的短肽,常用于CD8+ T细胞识别。MHC II类多呈递13至25个氨基酸的较长肽段,与CD4+ T细胞应答关系更紧密。两类分子的结合规则不同,不能用同一套参数简单替代。
在肿瘤免疫研究中,I类预测更常用于新抗原优选,因为它直接关联细胞毒性T细胞杀伤。II类预测则更适合辅助评估免疫原性,尤其是在疫苗设计中,需要同时考虑辅助性T细胞支持。
3. MHC结合预测的研究流程与关键技术点
3.1 标准流程:从测序到候选肽段
一个较完整的研究流程通常包括以下几步:
- 肿瘤样本与配对正常样本进行测序。
- 识别体细胞突变、融合和结构变异。
- 在转录组层面确认突变是否表达。
- 进行HLA分型。
- 将突变肽段输入预测模型,评估MHC结合亲和力。
- 综合表达量、克隆性、加工可行性和亲和力筛选候选抗原。
这个流程的核心不是单点结果,而是多层过滤。只有“存在、表达、可呈递、可结合”的肽段,才有进入实验验证的意义。
3.2 影响预测准确性的几个变量
MHC结合预测并不等于真实免疫原性。其准确性受多种因素影响,至少包括:
- HLA分型是否准确。
- 突变肽是否真实表达。
- 肽段加工和蛋白酶体切割是否合理。
- 转运过程是否顺利。
- 亲和力是否足以稳定呈递。
亲和力高不等于免疫原性高。 这是很多初学者容易混淆的地方。实际研究中,预测结果必须结合表达证据、肿瘤克隆性和实验验证,否则容易产生假阳性。
4. 当前研究前沿:从规则预测到深度学习
4.1 传统算法的基础价值
早期的MHC结合预测主要依赖motif、位置权重矩阵和统计学习模型。这类方法在规则明确的场景中仍有价值,尤其适合解释性较强的分析。对于某些特定等位基因,传统模型仍能提供稳定参考。
但传统方法的局限也很清楚。它对稀有HLA亚型、长肽处理和复杂加工环节的刻画有限。因此,研究前沿已经从“只看结合位点”转向“整合加工、呈递和免疫原性”的多维建模。
4.2 深度学习推动预测升级
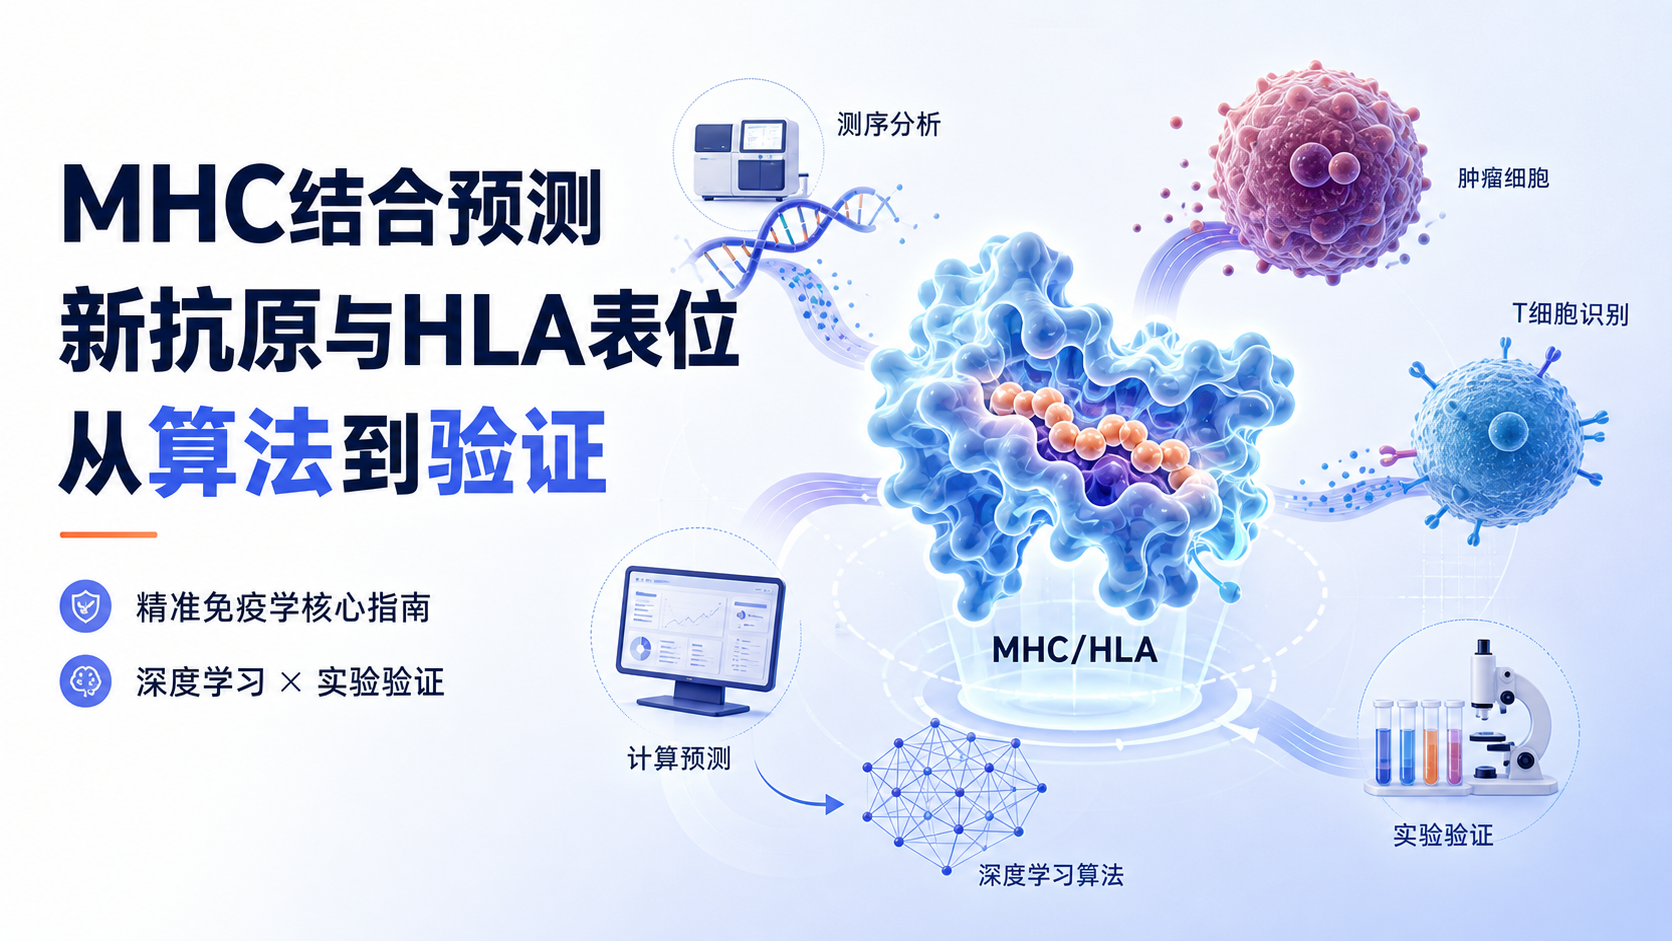
近年来,基于神经网络和大规模免疫肽组数据的模型不断出现。这类方法能同时学习肽序列特征、HLA序列特征以及上下文信息。相比单纯亲和力打分,深度学习模型更接近真实生物过程。
研究趋势主要体现在三点:
- 从亲和力预测扩展到呈递预测。
- 从单一肽段序列扩展到肽段加工链条。
- 从静态打分扩展到患者特异模型。
这意味着未来的MHC结合预测,不只是在判断“能不能结合”,而是在判断“能不能被加工、被呈递、被免疫系统识别”。
5. 实验验证与临床转化的现实要求
5.1 计算预测不能替代湿实验
在高质量研究中,MHC结合预测只是第一步。后续仍需通过体外结合实验、免疫肽组学、四聚体染色、ELISPOT或T细胞激活实验验证。没有验证的预测结果,最多只能算候选清单。
对于临床转化而言,验证尤其重要。因为疫苗设计、TCR筛选和细胞治疗都要求更高的可信度。预测模型可以缩小范围,但不能独立承担治疗决策。
5.2 从研究到产品:数据质量决定落地效率
在实际项目中,数据质量往往比算法名字更重要。测序深度不足、样本污染、HLA分型误差、表达量阈值设置不合理,都会直接影响最终候选抗原。很多“预测失败”,本质上是前端数据不合格。
这也是为什么规范化流程很关键。尤其是肿瘤研究,肿瘤纯度、克隆异质性、样本配对完整性,都会影响MHC结合预测的结果解释。没有标准化输入,就很难得到可信输出。
6. 面向科研与转化的实用建议
6.1 研究设计时优先考虑的三个问题
如果你正在做相关课题,建议先回答这三个问题:
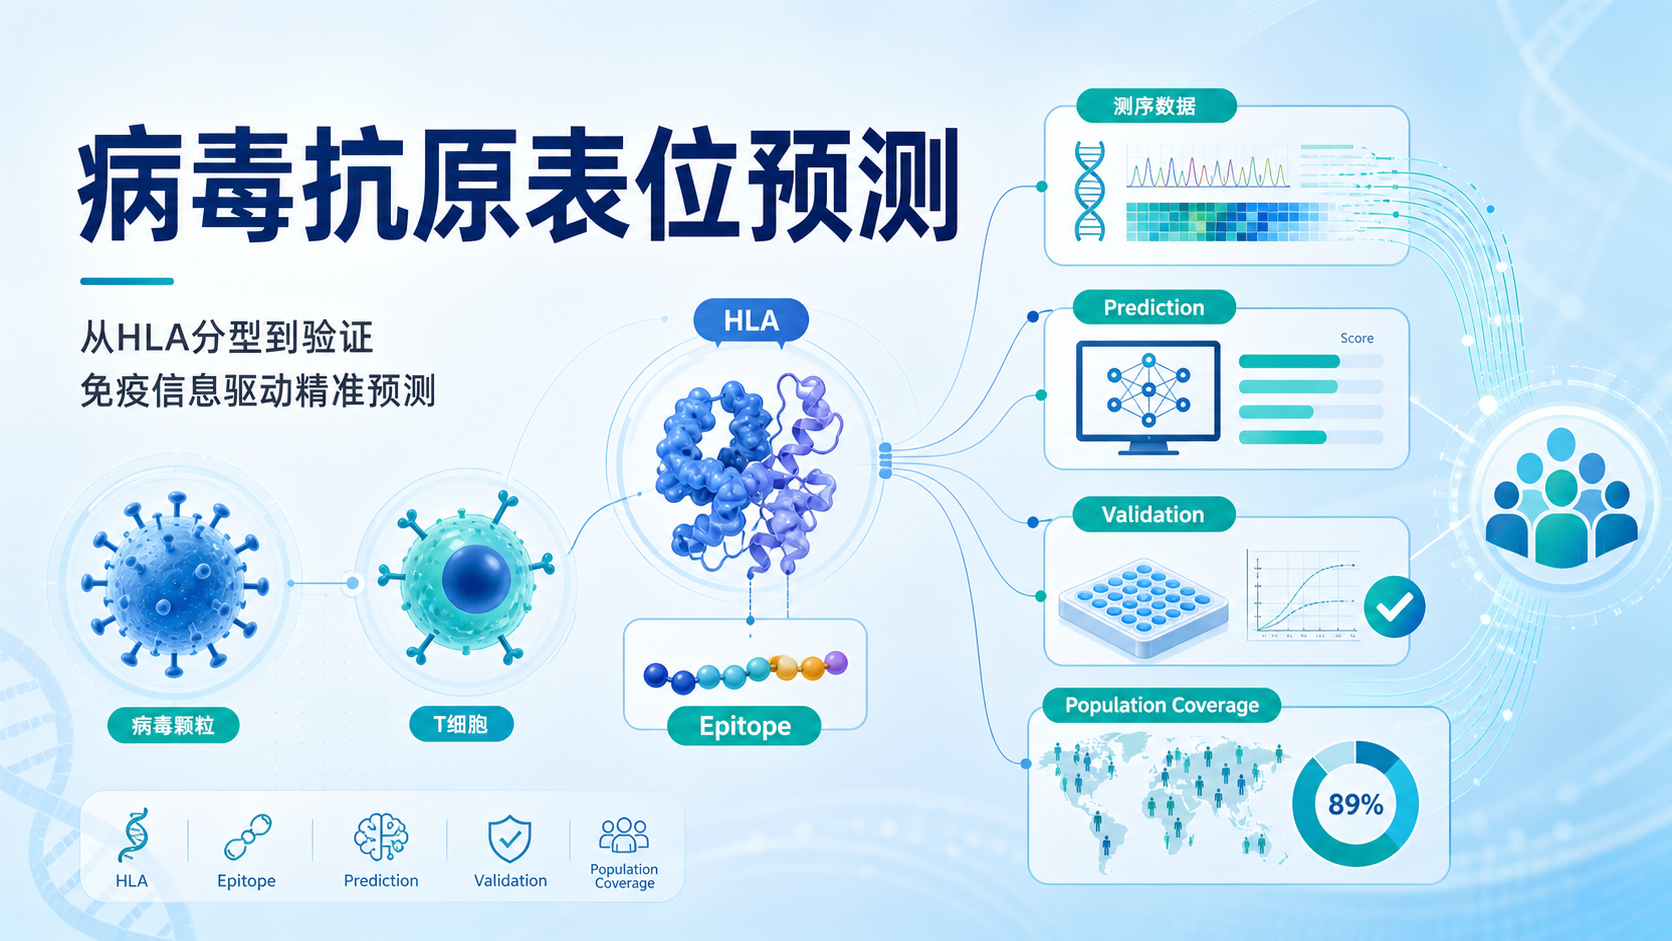
- 你的抗原来源是什么,突变、融合还是病毒相关抗原。
- 你的HLA分型是否可靠,是否覆盖主要等位基因。
- 你的候选肽是否有RNA表达和克隆性证据。
这三点决定了后续工作质量。只做亲和力打分,论文容易浅;只做表达筛选,候选抗原又可能不具备呈递能力。把“变异、表达、HLA、结合”连成闭环,才是标准研究思路。
6.2 对解螺旋这类科研服务平台的实际价值
对于需要快速推进课题的研究者来说,MHC结合预测的难点往往不在“有没有工具”,而在“怎么把流程做完整”。从测序结果整理、候选肽筛选,到HLA分型整合与结果可视化,都需要稳定的方法学支持。解螺旋可以帮助研究者更高效地完成这类标准化分析,减少前处理错误,把时间集中到机制解释和实验验证上。
总结Conclusion
MHC结合预测已经成为精准免疫学、肿瘤新抗原发现和个体化治疗设计的基础环节。它不是单纯的算法问题,而是连接测序数据、HLA多态性、抗原加工和免疫应答的核心枢纽。真正有价值的结果,必须同时满足“有突变、能表达、可结合、可验证”。
如果你正在开展肿瘤免疫、新抗原或疫苗相关研究,建议把MHC结合预测放在规范流程中系统推进。需要更高效地完成分析和结果整理时,也可以结合解螺旋 的科研支持能力,提升课题推进效率与结果可信度。
- 引言Introduction
- 1. MHC结合预测为何成为精准免疫学核心
- 2. 预测对象:从新抗原到HLA表位
- 3. MHC结合预测的研究流程与关键技术点
- 4. 当前研究前沿:从规则预测到深度学习
- 5. 实验验证与临床转化的现实要求
- 6. 面向科研与转化的实用建议
- 总结Conclusion