4
 分享
引言Introduction
RCT系统综述里,最耗时的通常不是写结论,而是初筛、全文复筛和数据提取 。文献多、标准细、人工复核压力大,任何一步出错都会影响最终证据质量。Workbuddy工作台把这些环节做成可执行流程,适合想提速但又不能牺牲严谨性的研究者。
1. RCT系统综述为什么最耗时间
1.1 初筛和复筛本身就是高重复劳动
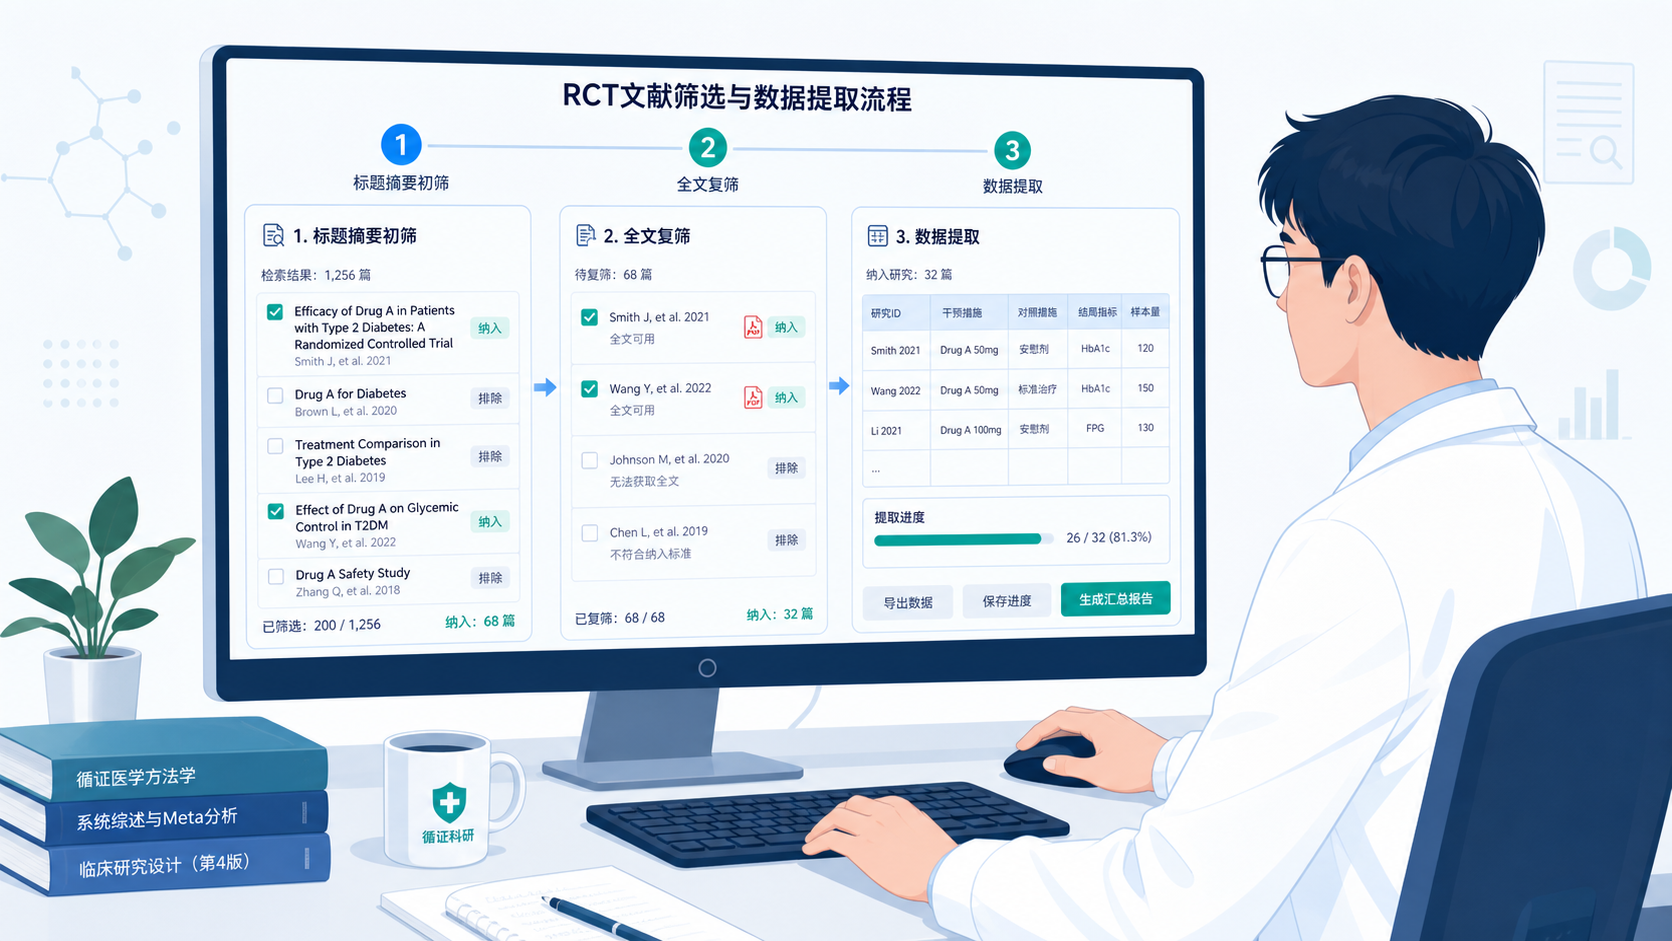
RCT系统综述的第一步,是从标题和摘要里快速判断是否符合研究问题。第二步,是进入全文后再做一次更严格的核对。这两个环节都要求双人独立筛选 ,并记录冲突解决过程。
这意味着,筛选不是“看一遍就完”。而是要反复确认研究设计、干预、对照、结局和人群是否符合纳排标准。文献量一大,时间成本会迅速上升。
1.2 数据提取比想象中更费工
很多人低估了数据提取的工作量。真正麻烦的地方,不是把结果抄下来,而是从全文中摘出所有关注的 outcome,再整理成统一表格。
经验丰富的研究者,一篇文章的数据提取可能也要花约1小时。 如果纳入文章数量多,手工整理会明显拖慢整个项目节奏。
因此,系统综述的瓶颈通常不是“有没有论文”,而是“能不能快速、准确地把论文变成可分析的数据”。
2. Workbuddy工作台如何拆解RCT筛选流程
2.1 先搭框架,再做筛选
Workbuddy工作台的思路是先把研究问题结构化。用户输入选题关键词后,AI可生成PICOS、纳排标准和检索式。
这一步的价值在于,它把原本需要反复讨论的研究框架先落到文本上,方便后续筛选统一口径。但生成结果必须人工校对。 尤其是纳排标准,既有主观性,也最容易出现临床原则性错误。
2.2 双人独立筛选仍然是核心
AI能帮忙提速,但不能替代方法学要求。对于RCT系统综述,初筛和全文复筛仍建议采用双人独立筛选 。
实际操作中,可以按以下流程执行:
- 两位研究者分别完成标题摘要初筛。
- 将结果比对,记录一致与分歧。
- 对分歧文献进入全文复筛。
- 全文复筛仍由双人独立完成。
- 最终由第三方或共识会议解决冲突。
这个流程的关键不在形式,而在可追溯性。以后写方法学部分时,也能清楚交代筛选决策路径。
2.3 非RCT研究可被前置排除
如果纳排标准明确只纳入RCT,Workbuddy工作台可对非RCT类型研究设置排除策略。
这对RCT综述很重要,因为很多检索结果会混入队列研究、病例对照研究或综述类文献。前置排除能减少无效劳动,提升初筛效率。
但前提仍然是标准定义清楚。标准模糊,AI就只能“尽量猜”,而不能真正替你完成方法学判断。
3. 数据提取为什么最适合先用AI辅助
3.1 从全文到表格,AI能先做粗加工
数据提取的难点,在于全文信息分散。研究对象、干预细节、样本量、主要结局、次要结局、随访时间,常常分布在摘要、结果、表格和补充材料里。
Workbuddy工作台支持上传全文PDF,AI会先把PDF转换成文本或markdown,再提取数据。它的优势不是“自动替你定稿”,而是先完成大部分机械整理。
3.2 AI提速明显,但人工复核不可省
在多篇文章并行处理时,AI的效率优势更明显。它可以同时批量提取多篇文献的数据,减少重复录入时间。
不过,PDF转换和结构化抽取本身也需要时间,特别是当一次检索到的文献很多时,初筛和数据提取两个节点都会变慢。
因此,正确的策略不是完全依赖AI,而是把AI定位为“第一轮整理工具”,再由研究者人工复核关键字段。这样既能提速,也能守住准确性。
3.3 数据提取也应双人独立
和筛选一样,数据提取最好也采用双人独立。原因很简单。不同研究者对同一篇文章的结局界定、单位换算和缺失值处理,可能不一致。
双人独立提取能降低以下风险:
- 遗漏重要结局。
- 误读数值或方向。
- 把亚组数据当成总体数据。
- 把不同随访时间的数据混在一起。
对于RCT综述,数据提取错误往往比筛选错误更难被发现。 所以,前期复核越严,后面统计越稳。
4. Workbuddy工作台在真实项目中的使用要点
4.1 检索式要按数据库分别生成
Workbuddy工作台会为不同数据库生成不同格式的检索式。这一点很重要,因为不同平台的语法规则并不一致。
对于跨数据库检索,研究者不能把一套检索式直接复制到所有平台。需要逐个确认字段、逻辑符和截词规则。
检索式的质量,直接决定后续筛选压力。 前面检索不准,后面初筛就会膨胀。
4.2 当前支持范围有边界
根据现有工作台能力,它目前纳入了四个数据库的检索结果,但暂不支持中国知网、万方等没有开放API的中文数据库。
这意味着,如果研究问题需要覆盖中文文献,仍要额外安排人工补检。对方法学写作来说,也要如实说明数据库范围,避免遗漏检索来源。
4.3 手动补充和PDF上传很关键
Workbuddy工作台允许手动补充文献,也支持上传全文PDF,用于全文复筛和数据提取。
这对临床研究团队很实用,因为很多项目并不是“检索后自动结束”,而是需要在筛选过程中持续补文献、补全文、补信息。
真正高效的工作流,不是完全自动化,而是把人工最耗时的部分交给AI先处理。
5. 怎样把提速和质量同时做稳
5.1 先规范,再提速
如果纳排标准不清楚,再快的工具也只能放大错误。建议在正式筛选前先完成三件事:
- 明确PICOS。
- 明确RCT定义和排除条件。
- 先做少量试筛,统一判断口径。
这样做的收益很高。因为一旦口径统一,后续双人筛选和数据提取的分歧都会减少。
5.2 把AI放在合适的位置
AI最适合做的,是重复性强、格式化程度高的工作,例如初步归类、表格整理和批量抽取。
AI不适合直接替代的,是主观判断强、临床语境复杂的决策,例如纳排标准解释、边界病例判断和最终冲突裁定。
换句话说,AI负责提效,研究者负责把关。 这个分工最符合系统综述的实际需求。
5.3 让流程可记录、可追溯
无论是初筛、复筛还是数据提取,最好都保留版本记录。包括:
- 初筛排除理由。
- 全文复筛冲突记录。
- 数据提取差异与修正痕迹。
- 最终纳入研究清单。
这不仅便于组内协作,也有利于后续撰写方法学部分和应对审稿意见。对于科研团队来说,可追溯性就是可信度的一部分。
总结Conclusion
RCT系统综述的核心瓶颈,始终是文献初筛和数据提取 。Workbuddy工作台把PICOS生成、检索式构建、双人筛选、全文上传和数据抽取串成流程,能显著减少机械劳动。但它不是替代方法学,而是帮助研究者更快进入规范流程。
如果你的项目也面临文献多、筛选慢、提取累的问题,建议把AI用于提速,把人工用于复核。想进一步提升系统综述效率,可以了解解螺旋 提供的研究支持方案,让Workbuddy工作台更好地服务你的RCT筛选与数据提取工作。
- 引言Introduction
- 1. RCT系统综述为什么最耗时间
- 2. Workbuddy工作台如何拆解RCT筛选流程
- 3. 数据提取为什么最适合先用AI辅助
- 4. Workbuddy工作台在真实项目中的使用要点
- 5. 怎样把提速和质量同时做稳
- 总结Conclusion