2
 分享
引言Introduction
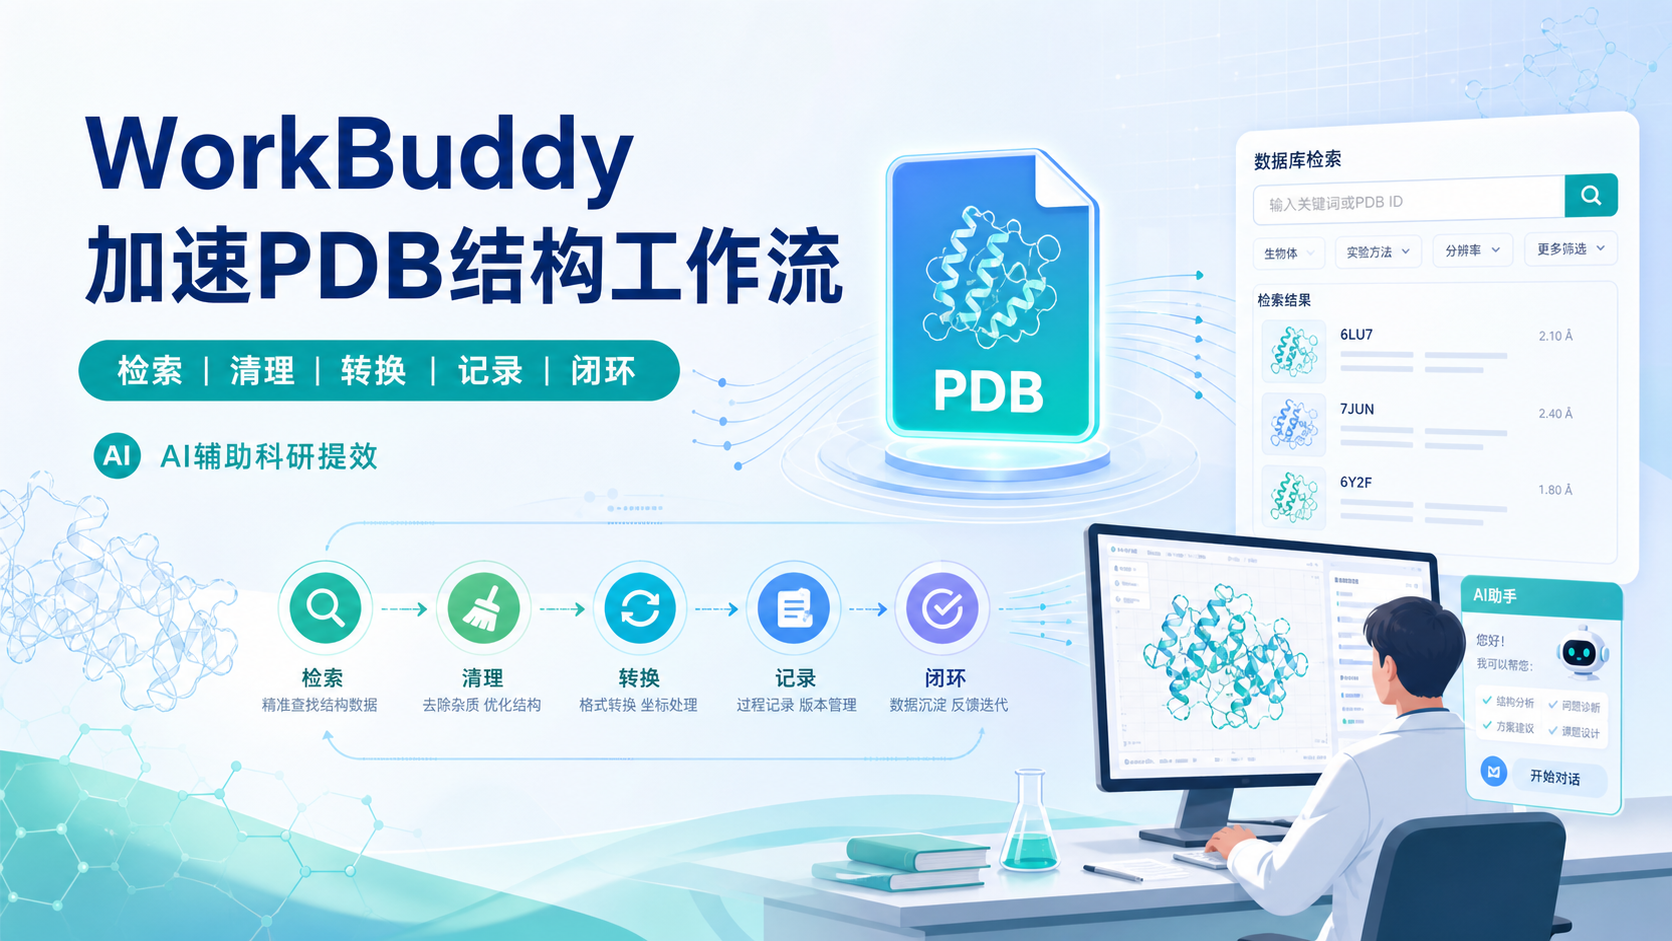
PDB结构读写看似基础,实则最耗时间。找结构、筛选分辨率、清理水分子、导出格式,任何一步出错都会拖慢分子对接和课题设计。WorkBuddy把文献、数据库和文件处理串起来后,很多重复工作可以明显提速。 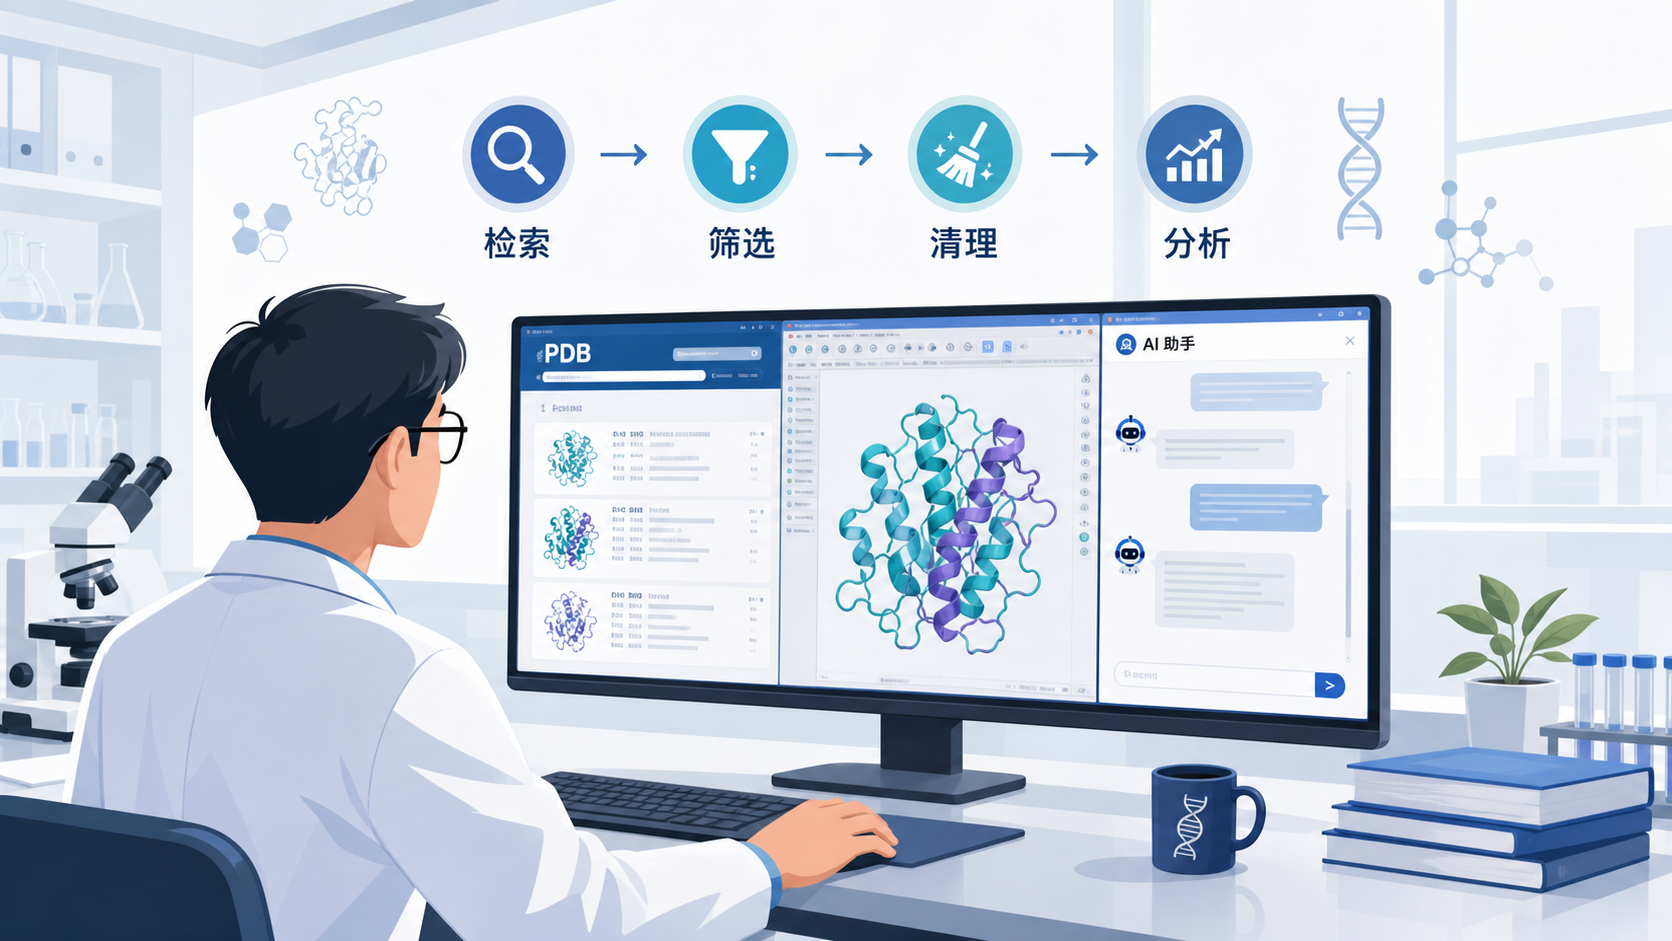
1. 为什么PDB结构读写是科研效率瓶颈
1.1 结构文件多,筛选成本高
在生物医学科研中,PDB文件常用于分子对接、结构分析和机制研究。问题不在于“有没有结构”,而在于“能不能快速找到合适结构 ”。同一个靶蛋白,PDB数据库里往往有多个条目。研究者需要综合物种、分辨率、是否含配体、是否覆盖结合位点等信息判断。
以c-Src为例,在PDB数据库中检索后可得到大量结构条目。若再限定为Homo sapiens,条目数会明显减少。这说明筛选不是简单下载,而是一个需要多条件判断的过程。
1.2 清理和转换步骤容易出错
PDB读写还涉及格式转换。常见流程包括:
- 下载PDB结构。
- 删除水分子、重复链、非必要小分子。
- 加氢。
- 导出PDBQT或其他对接格式。
每一步都可能出错。比如,水分子默认通常会被删除,但如果水在配体识别中起关键作用,就不能简单去除。这类判断依赖结构背景和文献证据,不能机械操作。
1.3 传统流程高度依赖人工
过去很多操作要在PDB、UniProt、Discovery Studio、PyMOL、ADT之间来回切换。对于医学生、医生和科研人员来说,时间成本很高。尤其是当你要同时处理多个靶点、多条结构链和不同配体时,人工效率会进一步下降。
WorkBuddy的价值就在这里。它可以帮助你把“找结构、查文献、整理方案、记录操作”放在一个工作流里处理。效率提升的本质,不是替你做科研,而是减少无效切换。
2. WorkBuddy如何辅助PDB结构检索与判断
2.1 从数据库入口开始提效
PDB数据库是生物大分子三维结构的核心资源,包含原子坐标、结构因数、参考文献等信息。科研人员常用关键词检索PDB ID、蛋白名称或作者信息。Uniprot则更适合补充蛋白功能、物种信息和结构链接。
在实际操作中,WorkBuddy可帮助你快速整理:
- 蛋白名称与别名。
- 物种筛选条件。
- 已知结构来源。
- 相关文献线索。
对研究者而言,最快的不是打开数据库,而是快速判断“该选哪一个结构”。
2.2 用结构质量指标做初筛
PDB条目筛选时,分辨率是重要参考。通常情况下,分辨率数值越小,结构越清晰,原子定位越准确 。例如1.31 Å的结构,通常比2.5 Å结构更适合后续分析。但这不是唯一标准。
还要看:
- 结构是否包含目标结合位点。
- 是否有共晶配体。
- 序列覆盖是否完整。
- 结构是否与研究物种一致。
如果结构分辨率高,但缺少关键结合区域,仍然不适合直接用于对接。 这时就需要结合文献和UniProt信息综合判断。WorkBuddy能把这些判断信息串起来,减少反复比对的时间。
2.3 结合位点判断不能只看表面分数
在Discovery Studio中,可以通过“Define Site→From Receptor Cavities”预测多个结合位点。示例中可得到多个候选位点,再逐一比对是否与原有配体位置一致。若原蛋白已含共晶配体,优先选择与其一致的位点。
真正决定对接是否可靠的,不只是软件自动预测,而是结合已知配体、文献和结构背景做判断。 WorkBuddy适合在这里发挥作用。它可以协助你汇总位点信息、文献证据和实验假设,避免遗漏关键上下文。
3. WorkBuddy如何提升PDB清理、导出和记录效率
3.1 结构预处理要标准化
以PDB结构预处理为例,常见步骤包括去除水分子、删除重复链、保留必要配体,再进行加氢和格式导出。PyMOL和Discovery Studio都可完成部分任务,但关键在于流程标准化。
建议按以下顺序处理:
- 打开原始PDB文件。
- 检查链、配体和水分子。
- 删除不需要的部分。
- 加氢。
- 导出PDB或PDBQT文件。
标准化流程的意义在于减少人为差异,提升实验可重复性。
3.2 加氢和格式转换是对接前提
晶体结构中常缺少氢原子坐标。原因很直接,氢原子电子少,电子密度弱,不易被解析。但在分子对接中,极性氢对静电作用计算很重要,所以必须补上。
在ADT中,导入受体后可进行加氢,再导出PDBQT供AutoDock或Vina使用。对于PDB格式文件,通常选择noBondOrder;若是mol2格式,则用withBondOrder。这类细节如果处理错了,会直接影响后续打分结果。
3.3 WorkBuddy适合做“操作记录器”
科研中最容易浪费时间的,不只是执行步骤,还有“回忆步骤”。很多人做完一次对接,隔几天就忘了:
- 选了哪个PDB条目。
- 删除了哪些链。
- 位点中心坐标是多少。
- 最终文件命名是什么。
WorkBuddy的一个现实价值,是帮你把这些过程整理成可追溯记录。你可以把结构选择依据、坐标、导出格式、软件版本都记录下来。这会直接提升课题复现性,也方便组内协作。
4. 从PDB到课题设计,WorkBuddy如何形成闭环
4.1 不只是“读文件”,而是“读出科研问题”
PDB结构文件本身不是终点。它常常是课题设计的起点。比如,通过已知蛋白结构和配体结合位点,可以进一步思考:
- 该配体是否可能影响酶活性。
- 是否存在竞争性结合。
- 是否可以作为机制研究切入点。
- 能否模仿已有结构设计新课题。
高质量科研不是把文件处理完,而是把结构信息转化为可验证假设。
4.2 WorkBuddy适合辅助文献和结构联动
上游知识库中的典型场景已经说明,WorkBuddy可以用于:
- 查询文件和文献。
- 根据文献推断分子来源。
- 让AI辅助设计方案。
- 复盘已有实验链。
对于需要做分子对接、机制验证、突变体设计和 rescue 实验的研究者,“文献证据 + 结构证据 + 实验路线”三者联动非常关键。 WorkBuddy的优势就是把这些信息放在同一工作流里。
4.3 对医生和科研人员都更实用
临床医生做科研,往往时间有限。学生和青年科研人员,则常被文件处理和软件切换消耗精力。WorkBuddy的价值在于,让你更快完成基础工作,把时间留给真正重要的问题:
- 靶点是否合理。
- 结构是否可靠。
- 结合位点是否成立。
- 课题假设是否足够清晰。
这比单纯提升“点鼠标速度”更重要。
5. 实际使用建议:如何把WorkBuddy融入PDB工作流
5.1 建议建立固定模板
建议你在每次处理PDB结构时,固定记录以下内容:
- 目标蛋白名称。
- PDB编号。
- 物种来源。
- 分辨率。
- 是否含配体。
- 结合位点坐标。
- 最终导出文件名。
这样做的好处是,后续写文章、写方法学、做汇报时都能直接调用。模板化记录能显著减少重复劳动。
5.2 让AI做辅助,不要替代判断
需要明确的是,AI不能替代专业判断。尤其在以下情况中必须人工确认:
- 水分子是否应保留。
- 金属离子是否是结构必需。
- 选择哪个结合位点更合理。
- 结构覆盖是否足够。
WorkBuddy更适合做“辅助决策”和“流程整理”。最终判断仍应以结构证据和文献依据为准。
5.3 用解螺旋把流程落地
如果你希望把PDB结构读写、文献检索、方案整理和操作记录真正串起来,可以借助解螺旋的产品和服务来减少重复劳动。 它更适合帮助你把零散步骤变成规范流程,把经验沉淀成可复用模板。对于要长期做结构生物学、分子对接和机制研究的人来说,这种效率提升非常实际。
总结Conclusion
PDB结构读写看似是基础操作,实则决定了后续对接、机制分析和课题设计的质量。筛选结构、判断位点、清理文件、加氢导出,每一步都需要准确且可追溯。 WorkBuddy的核心价值,是把数据库查询、文献证据和文件处理放到同一工作流中,减少切换成本,提升科研效率。
如果你正在做分子对接、结构分析或课题设计,建议把标准化流程建立起来。也可以进一步了解解螺旋 ,让WorkBuddy式的高效科研流程真正服务于你的实验设计与论文产出。
- 引言Introduction
- 1. 为什么PDB结构读写是科研效率瓶颈
- 2. WorkBuddy如何辅助PDB结构检索与判断
- 3. WorkBuddy如何提升PDB清理、导出和记录效率
- 4. 从PDB到课题设计,WorkBuddy如何形成闭环
- 5. 实际使用建议:如何把WorkBuddy融入PDB工作流
- 总结Conclusion