19
 分享
引言Introduction
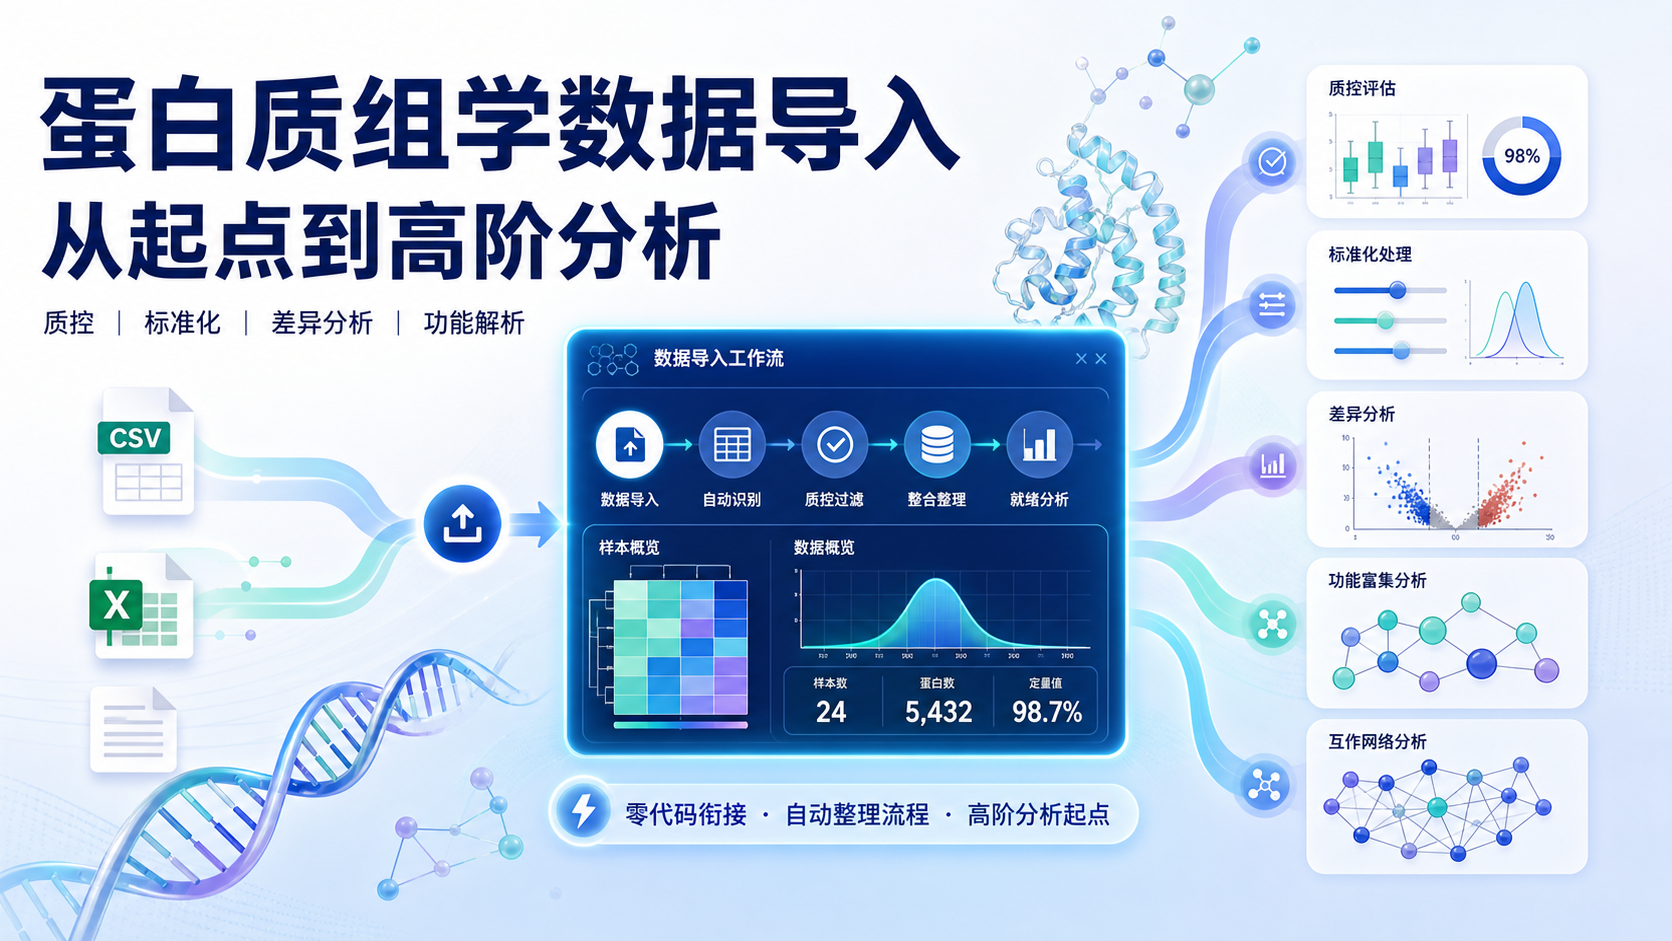
蛋白质组学数据常见问题不是“不会分析”,而是“导入就卡住”。格式不统一、缺失值太多、分组信息混乱,会直接影响后续差异分析、富集分析和可视化结果。如果第一步没做好,后面再复杂的统计方法也很难补救。
1. 为什么蛋白质组学数据导入是高阶分析的起点
1.1 导入环节决定数据能否进入正确流程
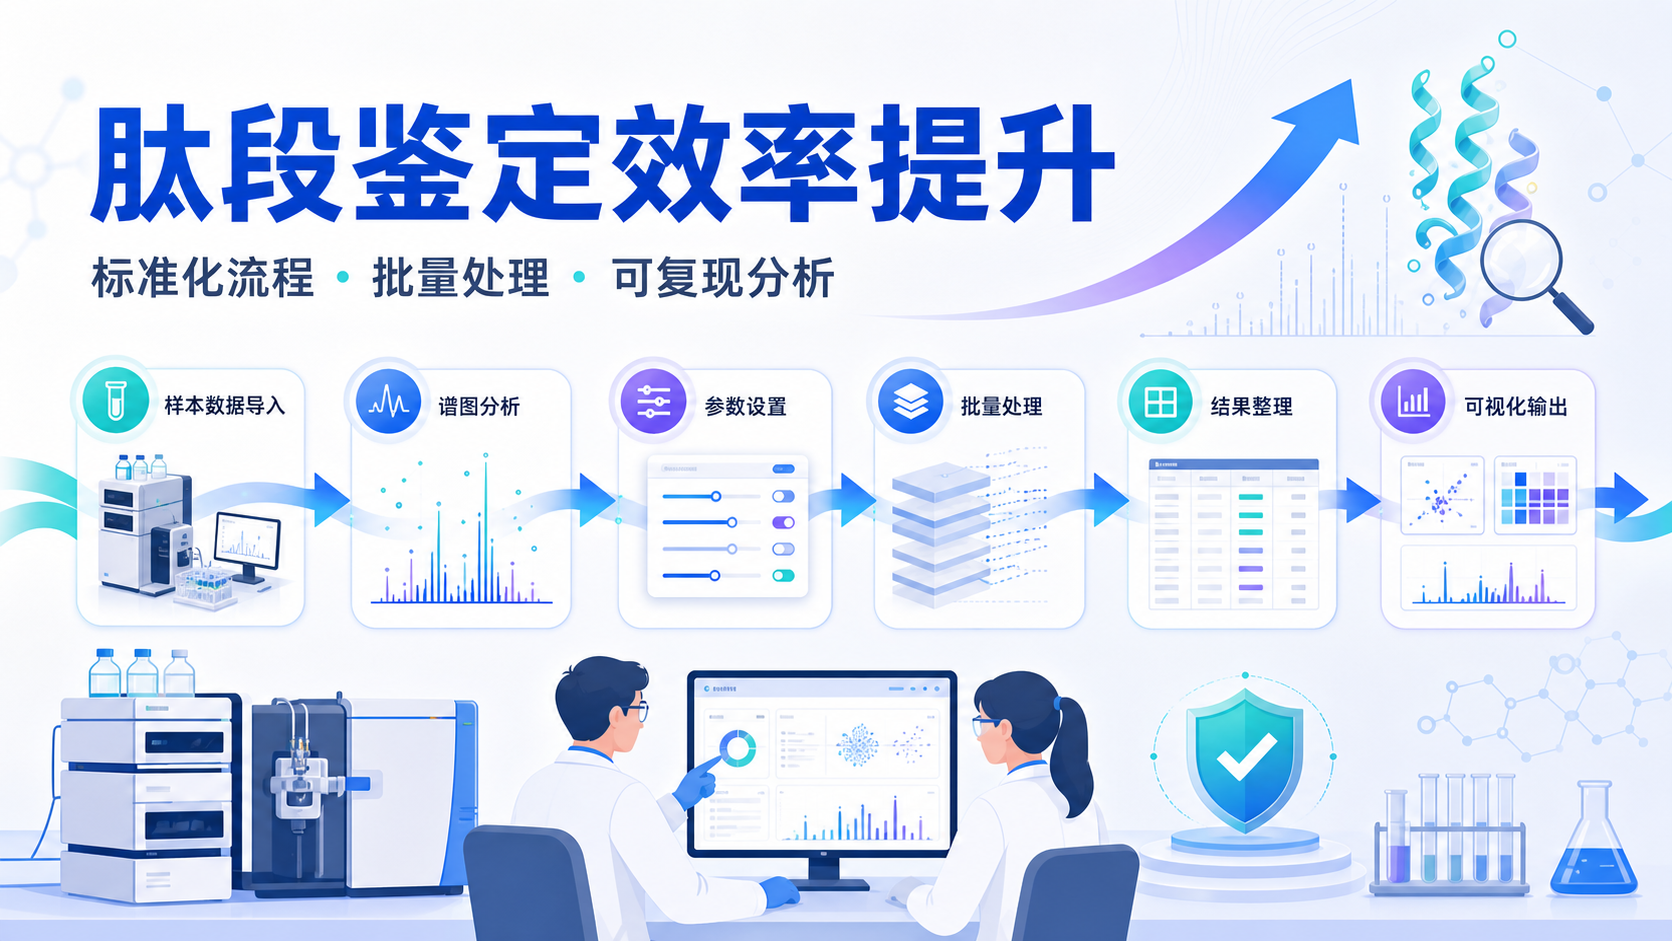
蛋白质组学分析通常从原始质谱数据处理开始,再进入格式转换、搜库鉴定、定量、差异筛选和下游分析。对科研人员来说,真正耗时的,往往不是统计本身,而是把数据整理成可分析的结构。
导入前如果没有统一表头、样本名和蛋白ID,后续工具就无法稳定识别数据。
这也是为什么很多项目在进入差异分析前,就已经因为格式问题反复返工。
1.2 常见痛点集中在三类
在实际项目里,蛋白质组学数据导入最常见的问题有三类。
- 原始结果来自不同平台,列名不一致。
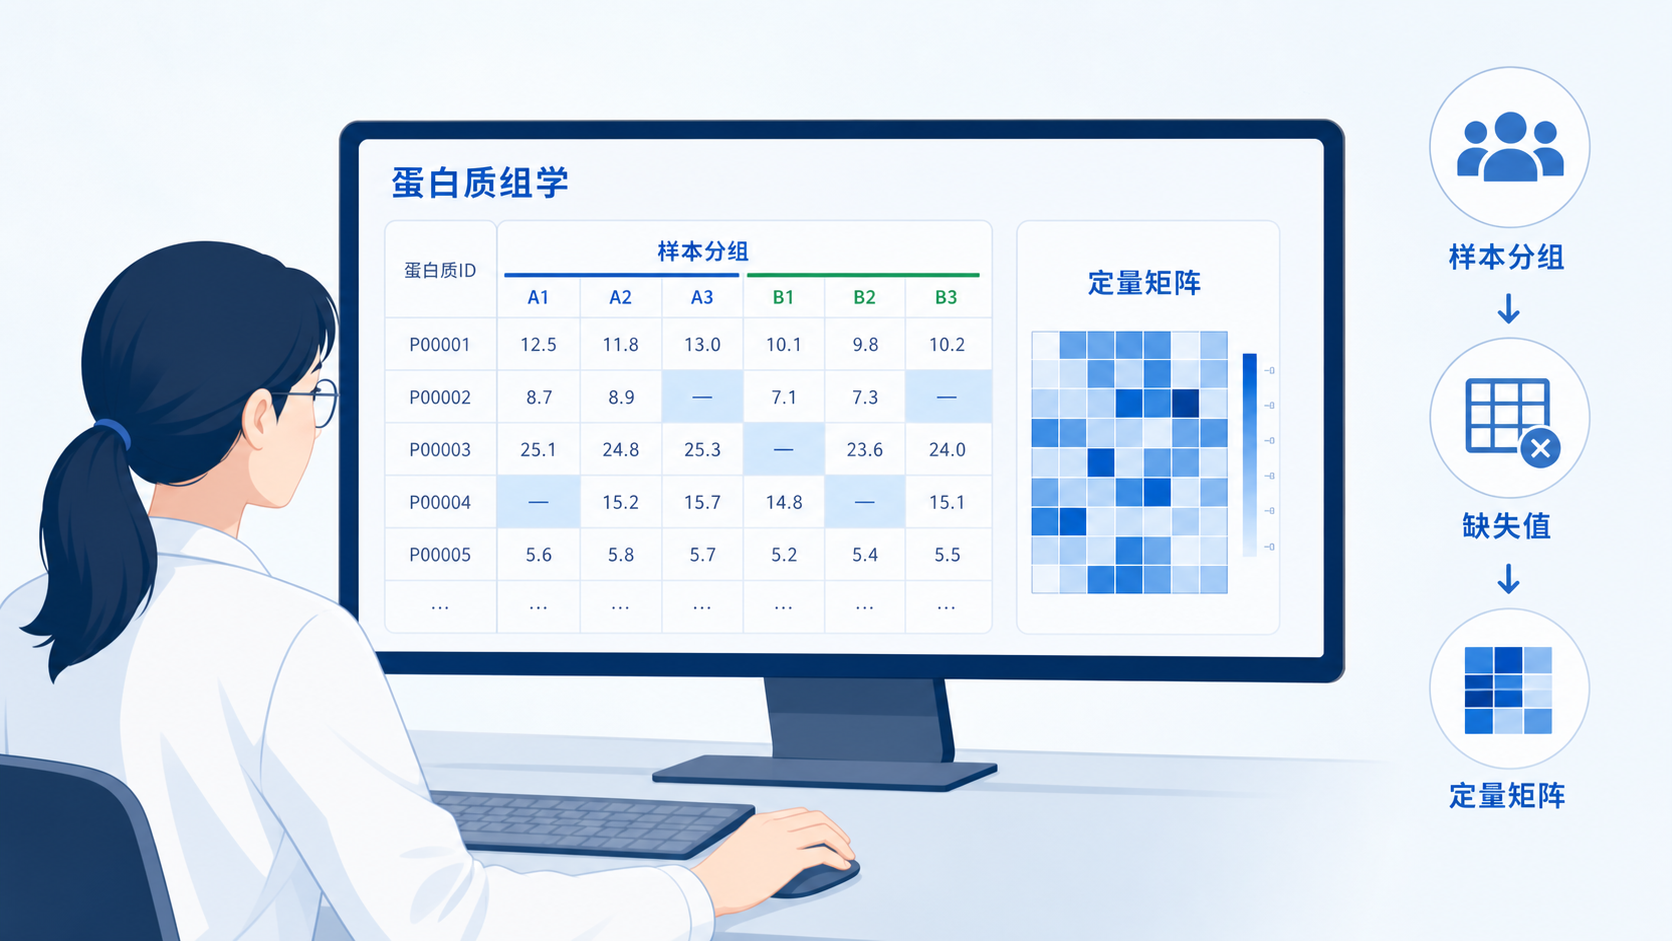
- 定量矩阵存在大量缺失值。
- 分组信息、批次信息、重复样本信息没有同步整理。
这些问题会直接影响 PCA、聚类图、火山图和富集分析的可信度。导入不是机械上传,而是分析质量控制的第一道关口。
1.3 WorkBuddy的价值在于把复杂流程前置整理
如果能在导入阶段完成标准化整理,就能显著减少后续分析的返工。对于医学生、医生和科研人员来说,这一点尤其重要,因为研究时间往往被样本处理、统计验证和作图占满。
WorkBuddy一键导入的核心价值,就是让蛋白质组学数据进入统一流程。先把数据“接得住”,才能谈高阶分析。
2. 蛋白质组学数据导入前需要先确认什么
2.1 先确认数据来源和格式
不同软件导出的结果格式并不完全一致。课程中提到的常见输入来源包括 MaxQuant 和 IsobarQuant 的定量结果。对于下游分析工具来说,关键不是文件名,而是字段是否可被正确识别。
导入前建议重点核对以下内容。
- 行名是否为蛋白名称或蛋白ID。
- 列名是否为样本名称。
- 是否保留定量值。
- 是否保留分组变量。
- 是否保留必要的实验注释信息。
样本名和蛋白ID一旦混乱,后续差异分析和可视化都会出错。
2.2 必须处理缺失值,但不能随意填补
蛋白质组学数据中缺失值很常见。原因可能是低丰度蛋白未被检出,也可能是采集波动或样本质量问题。不同类型的缺失值,处理思路也不同。
常见处理方式包括。
- 数据过滤。
- 缺失值插补。
- 基于统计分布的填补方法。
- 随机森林法填补缺失值。
在 DEP 等工具中,缺失值处理已经成为标准流程的一部分。关键不是“有没有缺失”,而是“缺失是否被合理处理”。
2.3 统一分组信息,才能做准确比较
差异分析的前提是分组明确。无论是病例组和对照组,还是不同处理条件、不同时间点,分组信息都必须在导入阶段定义清楚。
如果分组不准确,后续的 t-test、ANOVA、火山图和热图都会失真。
导入阶段的分组准确性,直接决定统计学结论是否成立。
3. 从导入到分析,标准流程应该怎么走
3.1 数据预处理先于差异分析
蛋白质组学分析一般先做预处理,再做统计比较。课程中的流程很清晰。
- 原始质谱数据处理。
- 数据格式转换。
- 搜库鉴定蛋白质。
- 蛋白质定量。
- 差异蛋白质筛选。
- GO、KEGG、蛋白互作网络等下游分析。
如果预处理不规范,差异分析得到的“显著蛋白”可能只是技术偏差。
3.2 质控是判断数据能不能继续往下走的依据
导入完成后,第一步应看数据是否稳定。常见质控图包括。
- PCA图。
- 样本相关性图。
- 箱线图。
- 散点图。
- 层次聚类图。
这些图不是装饰,而是判断数据是否离群、样本是否聚类合理的重要证据。
PCA和聚类结果正常,才说明数据进入了可分析状态。
3.3 标准化让不同样本处于同一尺度
蛋白质组学数据常受上样量、仪器响应和批次影响。标准化的作用,是把数据重新缩放到可比较的尺度上。课程中提到的常用方法包括 Z-score。
标准化的目标很明确。
让不同样本之间的比较更接近真实生物差异,而不是技术波动。
没有标准化,很多“差异”其实只是测量偏差。
4. 导入后如何衔接差异分析和功能解析
4.1 差异分析要基于明确阈值
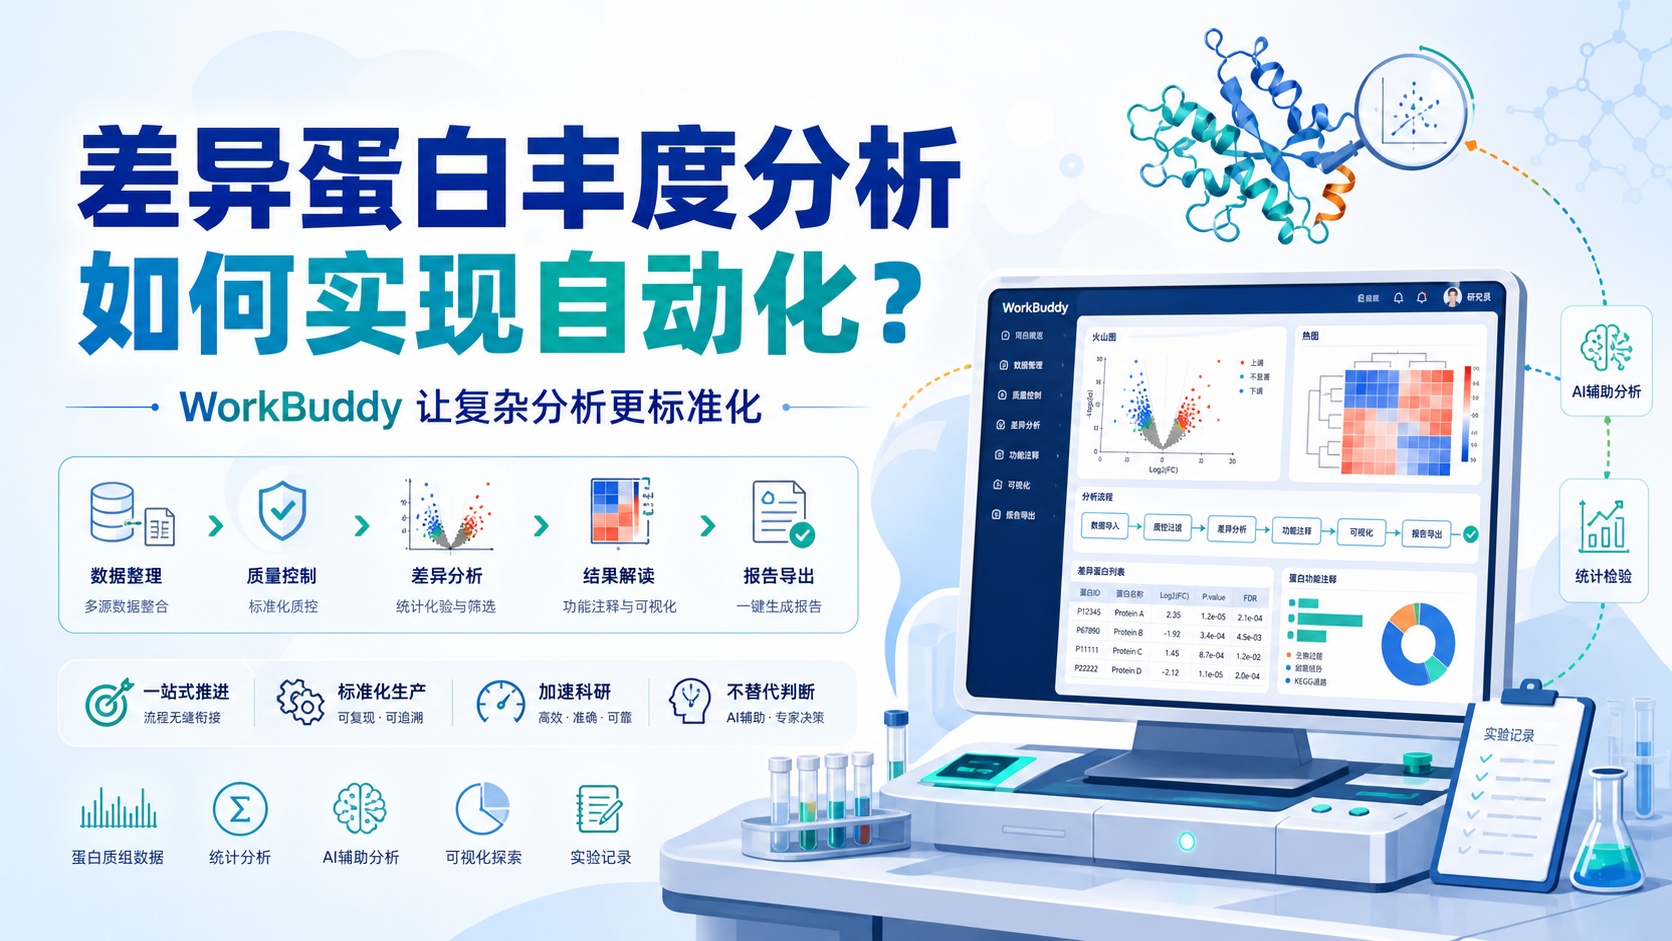
导入和预处理完成后,才能进入差异分析。常见方法包括 t-test 或 ANOVA。筛选时通常会结合倍数变化和显著性阈值。
常见输出包括。
- 差异蛋白列表。
- 火山图。
- 热图。
- 象限图。
- 箱线图。
差异分析的重点,不只是找出变化,更是解释变化是否可靠。
4.2 富集分析回答“这些蛋白意味着什么”
差异蛋白筛选后,下一步通常是 GO 和 KEGG 富集分析。课程知识库中明确指出,GO 可用于分析生物过程、细胞组分和分子功能,KEGG 可帮助理解通路层面的变化。
这一步的价值在于把蛋白列表转化为生物学问题。
例如,差异蛋白是否集中于炎症反应、代谢通路或细胞骨架重塑。
没有富集分析,蛋白列表只是列表。
4.3 互作网络和生存分析提升文章深度
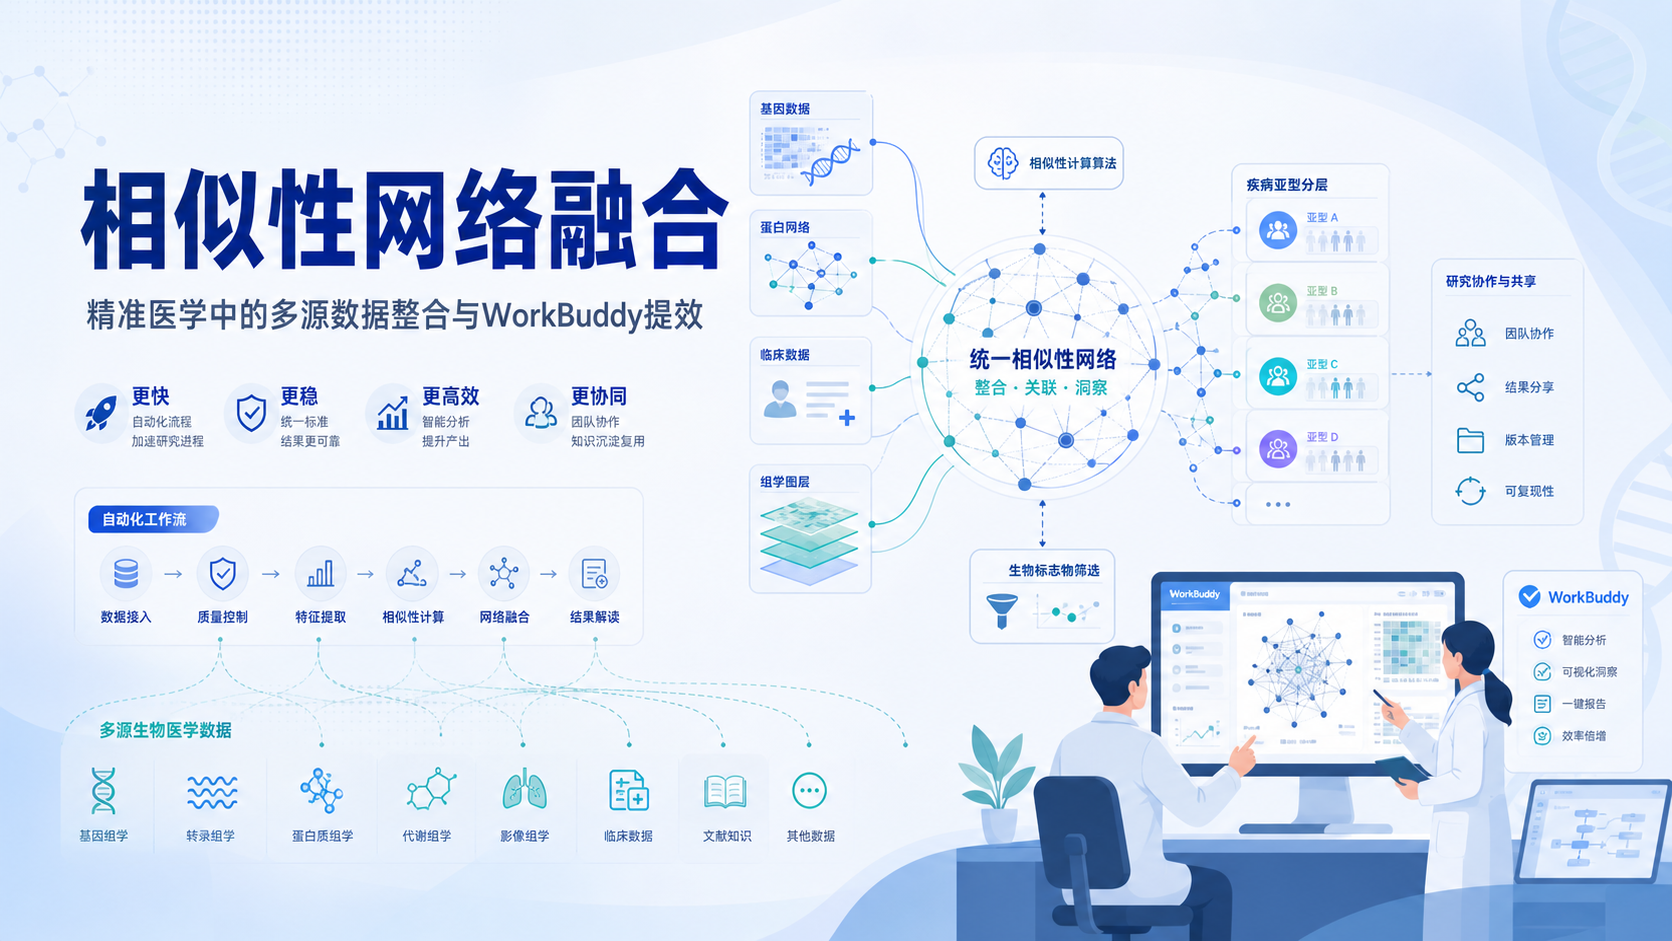
如果研究目标是机制或转化医学,单纯差异分析还不够。可以进一步做蛋白互作网络分析,或者在肿瘤等场景中做生存分析。
可用的分析思路包括。
- 蛋白互作网络。
- 小分子-蛋白互作网络。
- Kaplan-Meier 生存曲线。
- log-rank 检验。
- Cox比例风险回归。
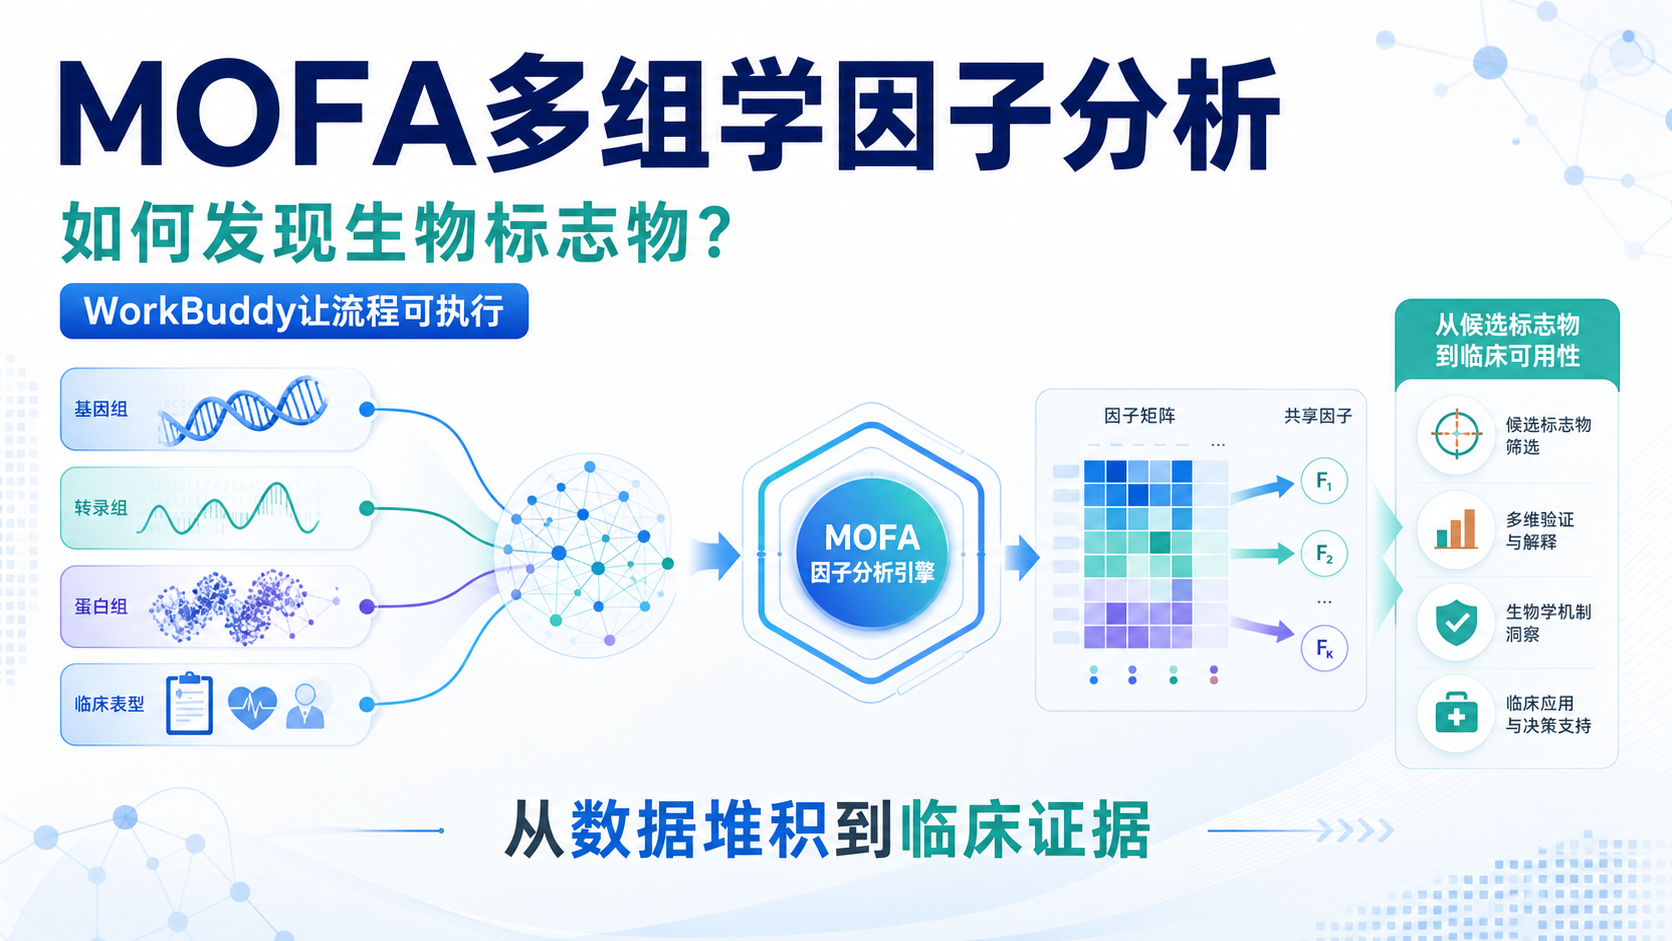
这些分析能把蛋白质组学结果从“发现”推进到“解释”和“验证”。
5. WorkBuddy如何帮助你把导入变成高效起点
5.1 一键导入的真正意义是减少重复劳动
很多研究者并不缺数据,缺的是把数据快速整理成可分析格式的能力。WorkBuddy一键导入的优势,就在于把这一步标准化,减少反复手工修改表格的时间。
对于高通量项目来说,这种效率提升非常现实。
你不必在文件格式、字段命名和分组表之间来回切换。
导入越稳,后面的分析越快,结果越可复现。
5.2 让零代码和高阶分析之间无缝衔接
课程中提到的 DEP 工具已经体现出一个趋势。前端操作尽量简单,但底层仍保留统计分析的严谨性。WorkBuddy的定位也是如此。它更像是一个把复杂流程打通的入口。
这意味着你可以更专注于科学问题,而不是格式修正。
当数据完成一键导入后,后续的标准化、差异分析、富集分析和可视化就能顺畅衔接。
真正有价值的工具,不是替你思考,而是让你少犯低级错误。
5.3 对医学生、医生和科研人员更友好的地方
临床和基础研究场景都强调时间效率。对医学生来说,论文训练周期短,反复清洗数据会严重拖慢进度。对医生和科研人员来说,项目并行多,数据导入必须稳定。
WorkBuddy的优势在于把蛋白质组学数据导入标准化。
这能帮助用户更快进入差异分析和功能解释阶段。
当导入环节被简化,研究者才能把精力放在实验设计和生物学解释上。
总结Conclusion
蛋白质组学分析的难点,往往不在统计模型,而在最前面的数据导入。只有先完成格式统一、缺失值处理、分组整理和基础质控,后续的差异分析、GO/KEGG富集、互作网络和生存分析才有可靠基础。WorkBuddy一键导入蛋白质组学数据,正是把这一关键入口标准化,帮助你更快进入高阶分析。 如果你希望减少整理时间、提升分析效率,并让结果更可复现,可以进一步了解解螺旋的 WorkBuddy。
- 引言Introduction
- 1. 为什么蛋白质组学数据导入是高阶分析的起点
- 2. 蛋白质组学数据导入前需要先确认什么
- 3. 从导入到分析,标准流程应该怎么走
- 4. 导入后如何衔接差异分析和功能解析
- 5. WorkBuddy如何帮助你把导入变成高效起点
- 总结Conclusion