15
 分享
引言Introduction
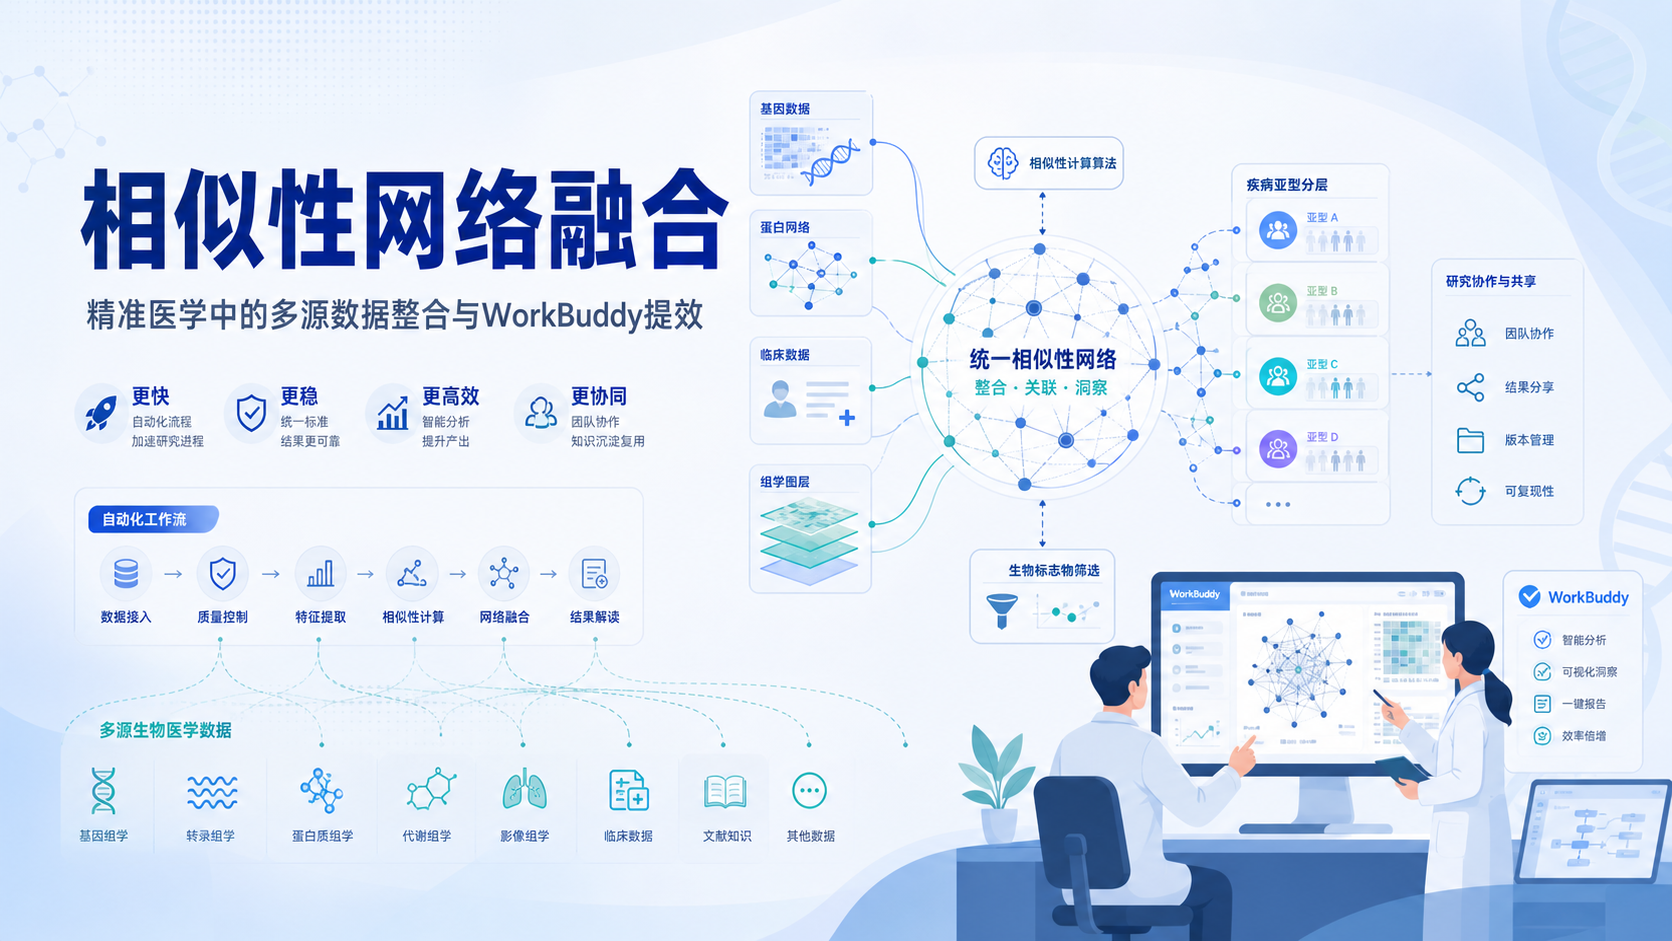
科研人做相似性网络融合,最耗时的不是建模,而是数据整理、特征整合和流程反复调参。很多课题卡在多组学异构数据难以统一,最后只能停留在“能做”,却很难稳定产出。WorkBuddy把这类长流程自动化后,能明显降低方法门槛,加快精准医学发现。 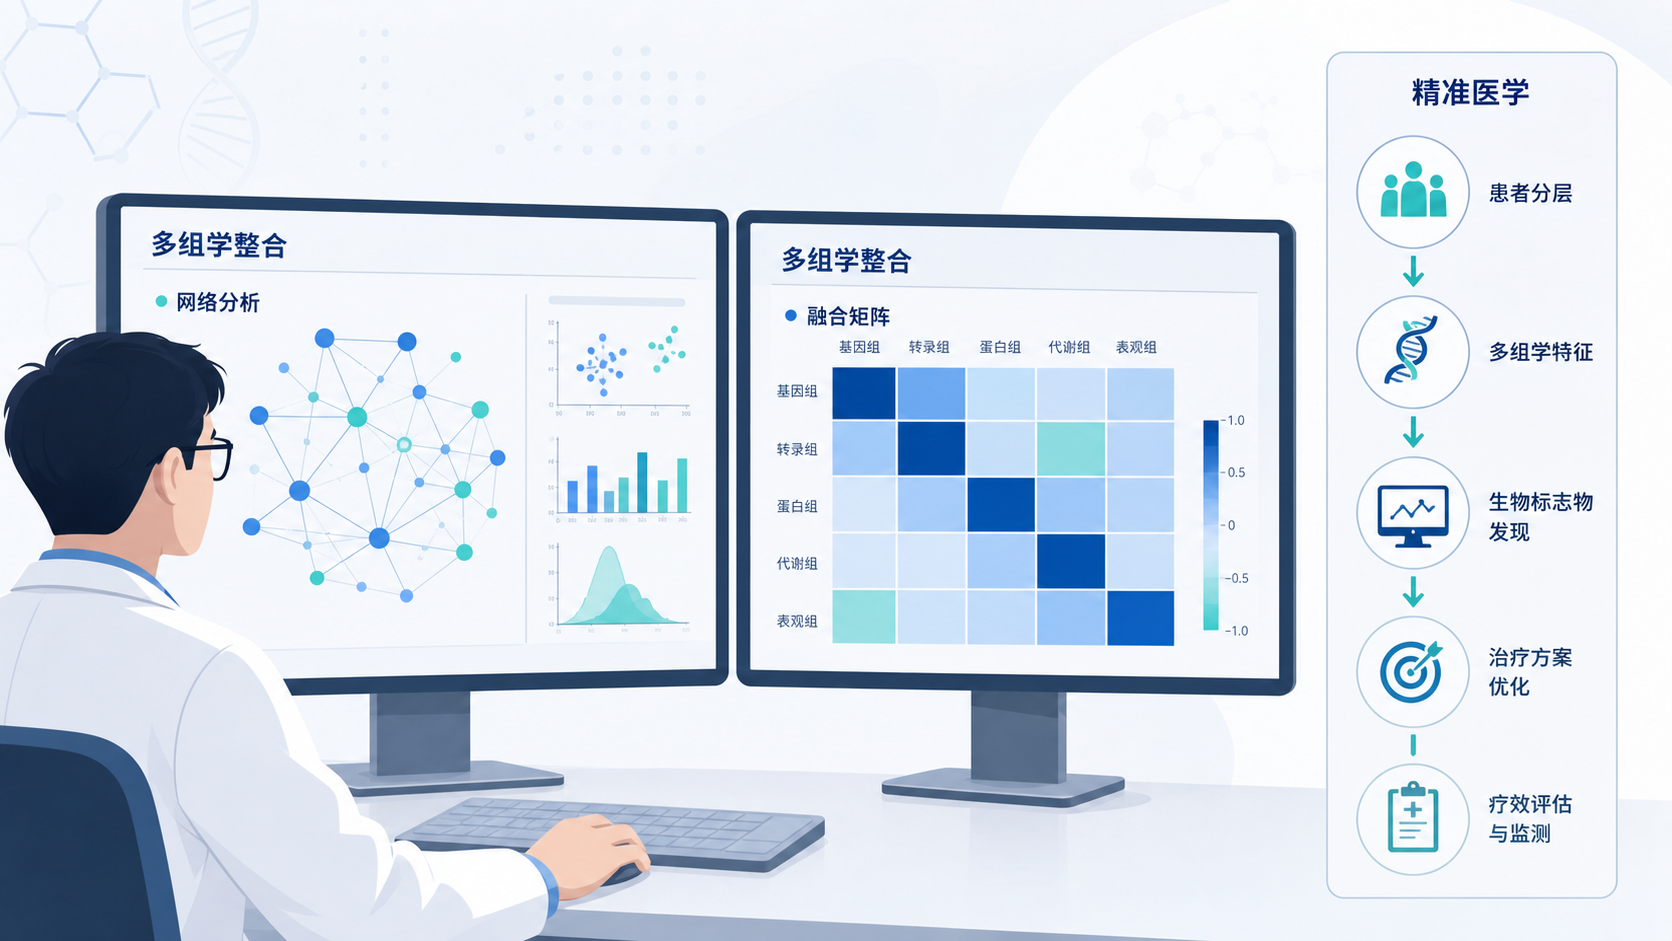
1. 什么是相似性网络融合
1.1 核心概念与适用场景
相似性网络融合,常用于多组学整合分析。它的目标很明确。把来自不同数据源的“相似关系”整合为一个更稳健的网络。
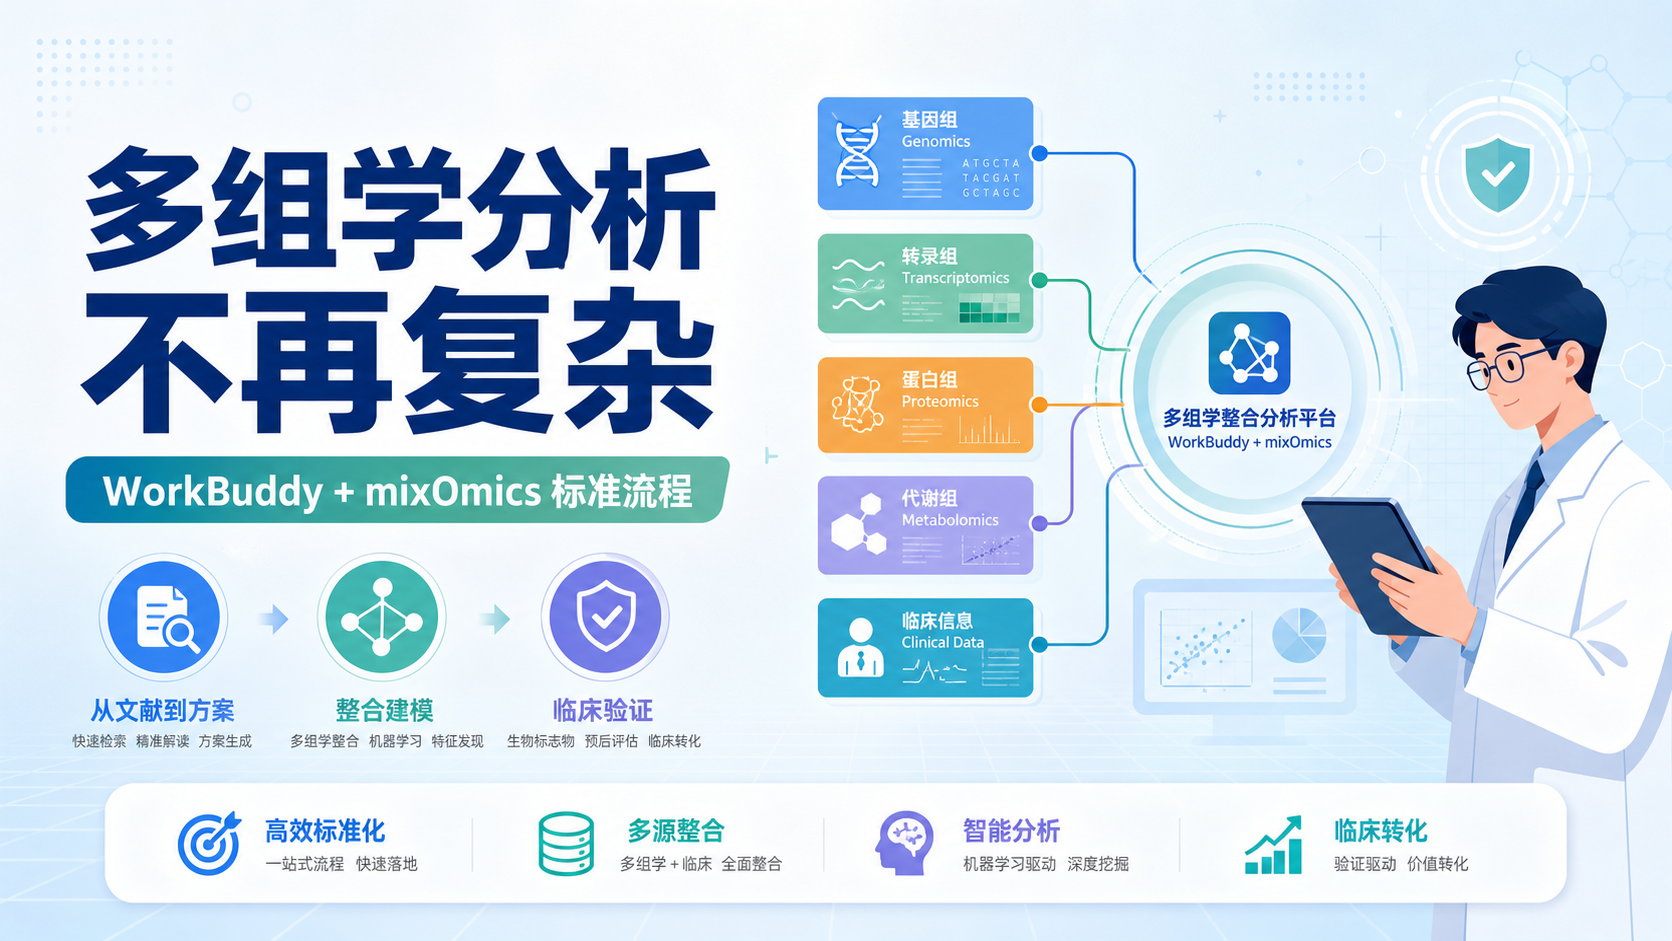
在精准医学中,数据往往来自基因表达、甲基化、突变、临床表型或影像特征。单一数据容易受噪声影响,多视角融合后,信息更完整。
相似性网络融合适合回答这类问题。
- 哪些样本在多组学层面更接近。
- 哪些分子亚群与预后、分型相关。
- 哪些患者可能共享相同疾病机制。
- 哪些标志物更适合用于诊断或分层。
它的价值不在于“更复杂”,而在于“更接近真实生物学结构”。
1.2 为什么精准医学需要它
精准医学强调分层,而不是平均。传统分析常把样本简单分成病例组和对照组,或者按单一指标做差异分析。但真实世界中,疾病异质性很强。
同一种肿瘤,不同患者的驱动机制可能完全不同。相似性网络融合可以把这种差异显性化,帮助研究者识别稳定亚型。
对医学生和科研人员来说,这类方法尤其适合以下方向。
- 肿瘤分型。
- 生存预后分层。
- 药物反应预测。
- 多组学联合标志物筛选。
如果你的课题已经有多组学数据,但还停留在单维度分析,融合网络通常能提供更高的信息密度。
2. 相似性网络融合的研究流程
2.1 从多源数据到统一网络
相似性网络融合的第一步,是将不同数据转化为可比较的相似性矩阵。
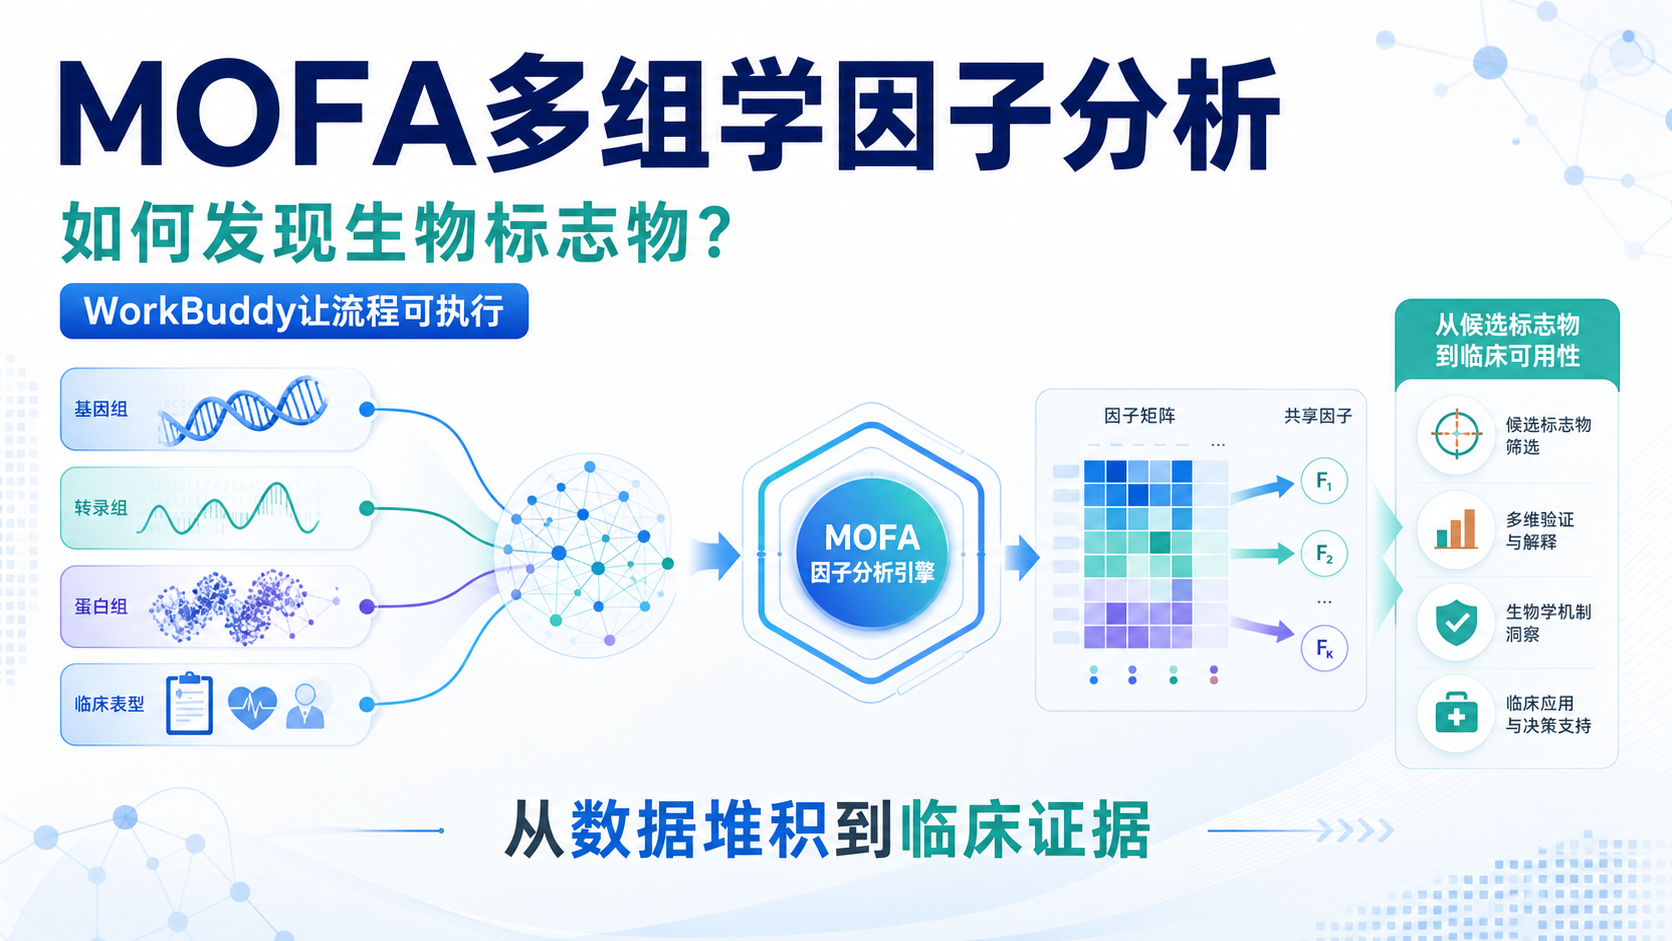
例如,基因表达可以反映转录层面的接近程度,甲基化可以反映表观遗传层面的接近程度,临床特征则可用于补充分层信息。
通常流程包括以下步骤。
- 数据预处理和标准化。
- 为每一种数据构建相似性网络。
- 在多个网络之间迭代融合。
- 得到统一的样本关系图谱。
- 基于融合网络做聚类、分型或下游分析。
真正难的是第1到第4步的连续衔接。
这也是很多课题停在半路的原因。流程长,工具多,参数也多。手工操作很容易出错。
2.2 融合之后做什么分析
融合网络不是终点。它只是把“样本之间的关系”先理清楚。后续通常要接上更具体的科研问题。
常见下游分析包括:
- 无监督聚类,识别分子亚型。
- 预后分析,比较不同亚型的生存差异。
- 差异表达分析,寻找亚型相关基因。
- 功能富集分析,解释生物学机制。
- 机器学习建模,构建诊断或风险评分。
如果融合结果不能回到临床问题,就很难形成高质量论文。
所以,最好的策略是让网络融合直接服务于诊断、分型、预后或疗效预测。
3. WorkBuddy如何提升相似性网络融合效率
3.1 自动化长流程,减少重复劳动
相似性网络融合的痛点,不只是算法本身,而是整套分析流程过长。
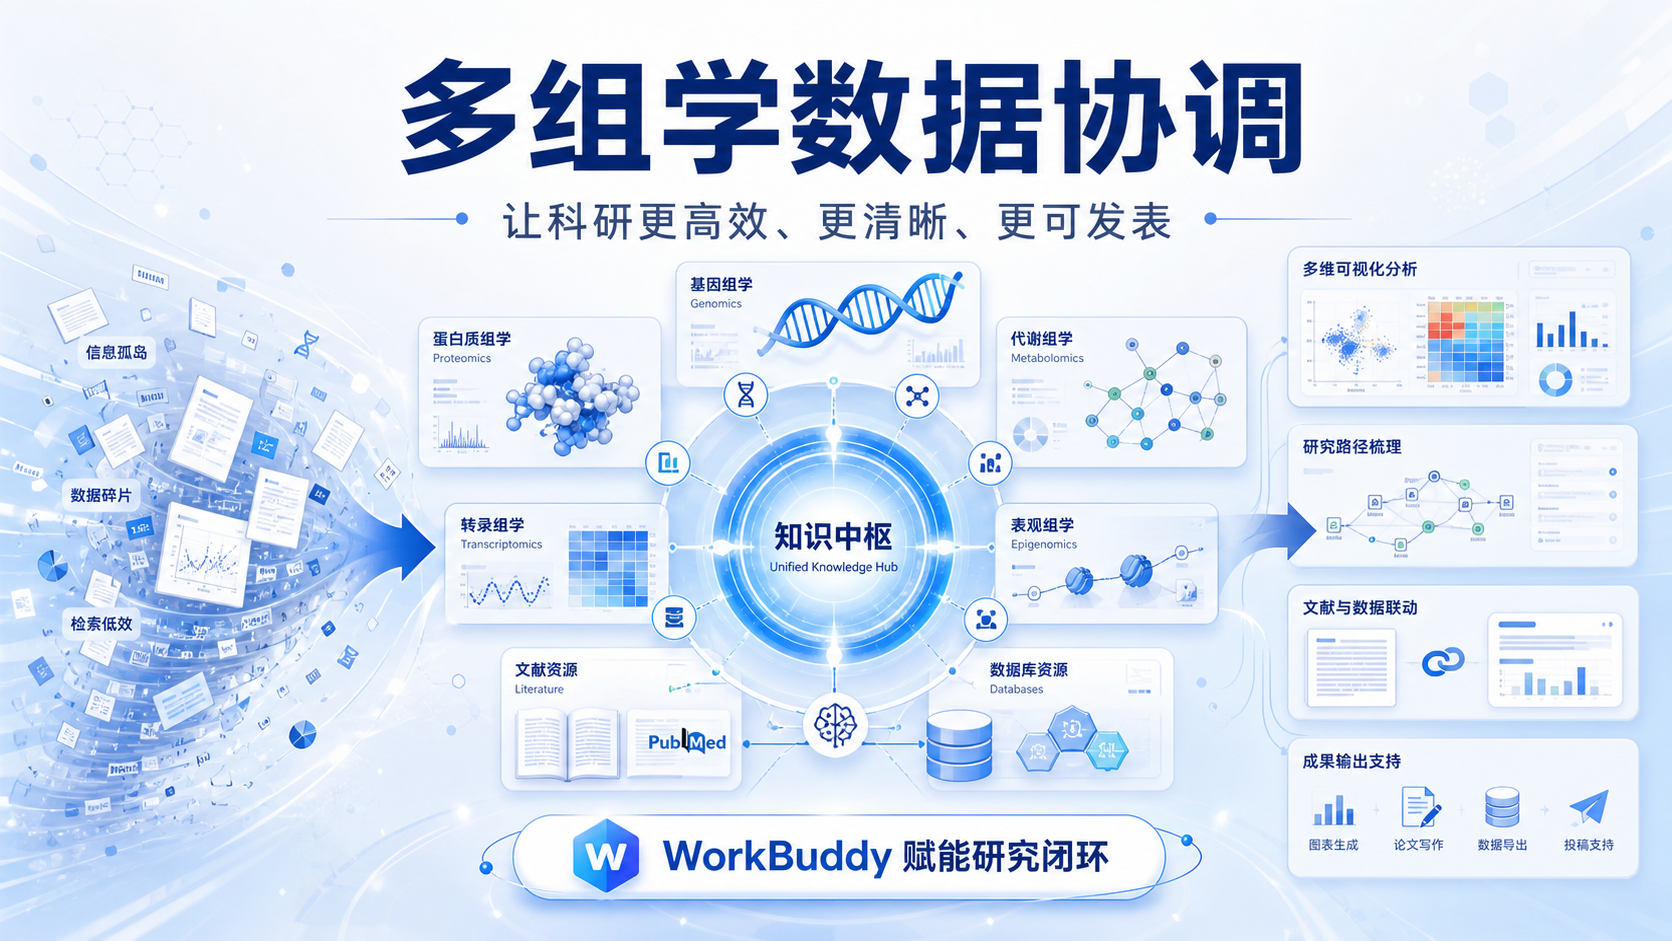
很多团队在数据准备、代码拼接、结果整理上消耗了大量时间。WorkBuddy的优势就在这里。它能把文献检索、流程梳理、分析步骤组织起来,减少重复性工作。
对于文献计量学和多组学研究,WorkBuddy工作站里已经有全自动模块 。这意味着研究者不必从零搭建每一步。
先把基础流程跑通,再逐步优化,是更现实的科研路径。
3.2 从“会做”到“做快、做稳”
科研效率的差异,往往不在于有没有想法,而在于能否稳定复现。
WorkBuddy更适合做这类长链条任务。
- 文献梳理。
- 分析套路提炼。
- 研究路径拆解。
- 多步流程串联。
- 输出初版研究方案。
这对研究生尤其有价值。因为很多人不是不会分析,而是卡在“下一步该做什么”。
WorkBuddy的意义,是把复杂任务拆成可执行模块。
从实际应用看,这类自动化工具对科研节奏的帮助很明显。尤其在多组学、网络分析、分型建模这些场景里,时间成本常常比计算成本更高。
4. 相似性网络融合在精准医学中的实际价值
4.1 更适合发现疾病亚型
精准医学的关键是分层。
相似性网络融合常用于发现隐藏亚型,因为它不是只看单一特征,而是综合多种相似关系。
比如,两个患者在基因表达上接近,但在甲基化层面不同。单一分析可能忽略这种复杂性。融合后,样本分群会更接近真实疾病结构。
这对肿瘤、免疫疾病和代谢性疾病研究都很重要。
亚型一旦稳定,后续就能接预后、免疫浸润、药物敏感性等分析。
这也是很多高水平论文常见的逻辑链。
4.2 有助于提高标志物筛选质量
标志物筛选最怕“假阳性多,泛化差”。
如果只靠单一组学,很容易得到一批看起来显著、但实际不稳定的候选分子。融合网络可以先把样本结构分清,再在分型基础上筛选特征基因。
常见做法包括:
- 融合后比较不同亚型的差异基因。
- 结合生存数据筛选核心分子。
- 进一步构建风险模型或诊断模型。
- 用外部队列验证稳定性。
这类策略比单纯做差异分析更容易形成有解释力的结论。
5. 研究者如何借助WorkBuddy落地这类课题
5.1 适合哪些人先用起来
如果你是医学生、医生或科研人员,且手里已经有多组学或临床分层数据,WorkBuddy可以作为很好的起点。
尤其适合以下情况。
- 想做文献计量学研究。
- 想整理相似性网络融合相关的分析套路。
- 想快速搭建多组学研究框架。
- 想把长流程分析自动化。
对大多数人来说,等功能未必比先用起来更有效。
先把工作站跑通,往往比等待更能推进课题。
5.2 用工具解决“流程卡住”的问题
很多科研项目不是缺数据,而是缺流程。
WorkBuddy的价值,在于把复杂分析变成可执行步骤。你可以先完成文献提炼,再进入数据分析和结果组织。这样更容易形成完整课题链条。
如果你现在正在做相似性网络融合,建议优先关注三件事。
- 数据是否已经标准化。
- 是否有明确的临床终点。
- 融合后能否直接连接论文主线。
这三点决定了课题能不能从分析走向发表。
最后,如果你希望更高效地完成文献计量学、网络融合和多组学分析,可以直接尝试解螺旋 提供的WorkBuddy工作站。它的价值,不只是帮你跑流程,更是帮你把复杂科研任务拆解成可落地的步骤,减少试错,提升课题推进速度。
总结Conclusion
相似性网络融合,是精准医学里非常实用的多组学整合方法。它能帮助研究者识别疾病亚型、筛选稳定标志物,并进一步连接预后和机制分析。
但它也有明显门槛,流程长,步骤多,重复劳动重。WorkBuddy的作用,就是把这些长流程自动化、结构化,让研究者把时间用在真正重要的问题上。
如果你正在做相关课题,或者想用更高效的方式切入文献计量学和多组学研究,建议尽早试用解螺旋 的WorkBuddy工作站。先把流程跑起来,往往比等待更快接近结果。
- 引言Introduction
- 1. 什么是相似性网络融合
- 2. 相似性网络融合的研究流程
- 3. WorkBuddy如何提升相似性网络融合效率
- 4. 相似性网络融合在精准医学中的实际价值
- 5. 研究者如何借助WorkBuddy落地这类课题
- 总结Conclusion