11
 分享
引言Introduction
HLAII类结合预测,是肿瘤新抗原、疫苗设计和免疫治疗中最容易被低估的一步。很多项目卡在这里,不是因为没有突变,而是因为候选肽能否真正被HLA II类分子呈递,仍然缺少足够可靠的判断 。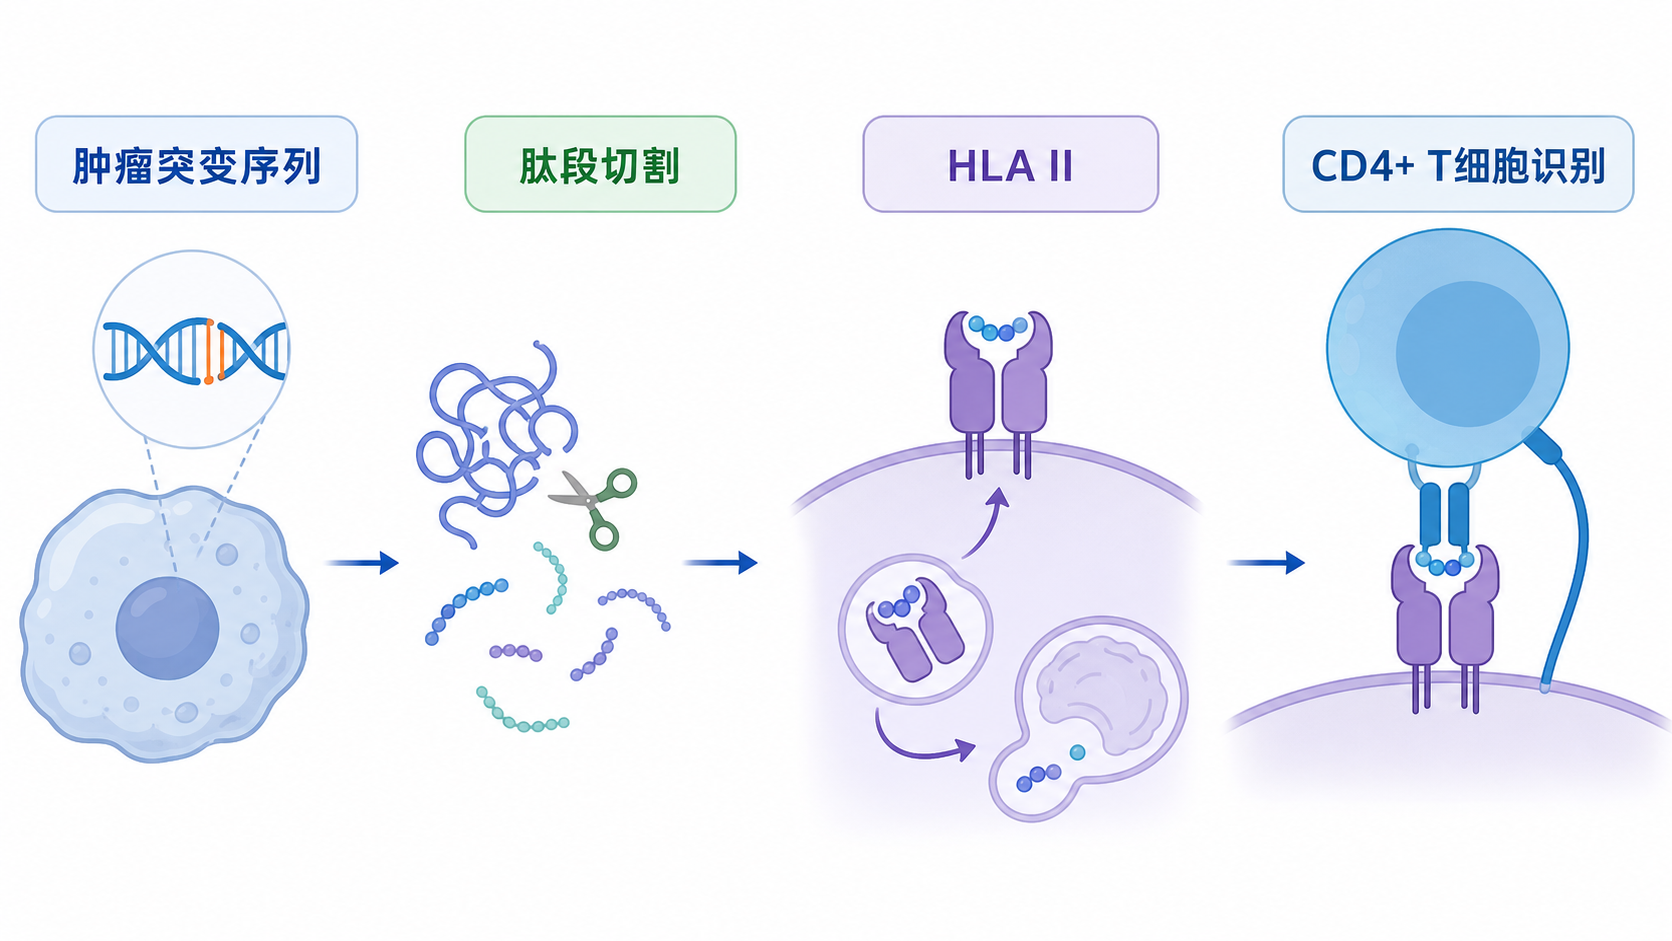
1. HLA II类结合预测为什么重要
1.1 不是所有突变都能成为抗原
肿瘤体细胞突变很多,但真正能进入免疫识别链条的很少。原因很直接。抗原形成要经过多个环节,包括蛋白表达、加工、切割、装载和呈递。只有能稳定结合HLA II类分子的肽段,才有机会被CD4+ T细胞识别。
HLA II类分子主要包括HLA-DR、HLA-DQ和HLA-DP。它们负责呈递外源性抗原,也可参与肿瘤微环境中的抗原呈递。对肿瘤新抗原研究来说,这一步决定了候选肽能否进入后续免疫验证。
1.2 预测的价值在于缩小实验范围
实验室通常不可能对所有突变逐一做功能验证。WES、RNA-seq、HLA分型之后,候选肽数量仍然很大。HLAII类结合预测的核心作用,就是把“海量候选”压缩成“可实验验证的少量优先对象”。
这一点在个体化肿瘤疫苗开发中尤其关键。因为时间窗口有限,患者等不起。若预测效率低,后续验证成本就会明显上升。
1.3 需要区分HLA I类与HLA II类
很多初学者会把两者混在一起。实际上,HLA I类和HLA II类在表达细胞、肽长偏好和免疫作用上都不同。
- HLA I类更常用于预测8到11个氨基酸长度的肽段。
- HLA II类更偏好较长肽段,常见为13到25个氨基酸。
- HLA II类结合槽更开放,锚定位点也更复杂。
因此,HLA II类结合预测不能直接套用HLA I类的思路。
2. HLA II类结合预测依赖哪些基础数据
2.1 输入数据通常来自三类信息
完整的肿瘤新抗原分析通常需要三类数据:
- DNA突变数据,常见为VCF文件。
- RNA表达数据,用于确认突变是否表达。
- HLA分型结果,用于明确患者具体携带的等位基因。
没有准确的HLA分型,结合预测就失去前提。 因为HLA II类分子高度多态,不同等位基因的结合偏好不同。
2.2 HLA分型精度决定下游结果
在实际分析中,HLA分型至少要到四位分型。原因在于,低分辨率结果会混淆等位基因差异,进而影响肽段亲和力预测。对于肿瘤新抗原研究,分型错误会直接带来假阳性或假阴性。
可用于分型的软件很多,但各有局限。比如有的软件准确率高,却配置复杂,耗时较长。也有的软件结果清晰、速度快,但支持范围有限。选择软件时,关键不是“能不能跑”,而是“结果能不能稳定用于后续预测”。
2.3 HLA II类预测对样本质量要求更高
HLA II类分子在不同组织和免疫细胞中的表达差异较大。若RNA质量差,或者测序深度不足,表达确认和分型结果都会受影响。对科研人员来说,这意味着流程设计必须前置质量控制,而不能把问题留到最后。
3. HLA II类结合预测的核心原理
3.1 本质是估计“肽与分子是否匹配”
HLAII类结合预测,本质上是在判断一个肽段与某个HLA II类分子是否具有足够高的结合亲和力。预测值越好,说明该肽段越可能被稳定装载到HLA分子上。
但需要强调,高亲和力不等于一定免疫原性 。它只是必要条件,不是充分条件。后续还取决于抗原加工、T细胞库、免疫抑制环境等因素。
3.2 HLA II类结合槽具有开放性
与HLA I类相比,HLA II类结合槽更开放,因此可以容纳更长的肽段。真正参与结合的通常是其中一段核心9肽区域,而两侧氨基酸会影响稳定性和构象。
这也是HLA II类预测更复杂的原因。同一条长肽,可能因为核心位点不同,呈现出完全不同的结合结果。
3.3 预测方法主要基于数据库和机器学习
当前主流工具多数依赖已知实验数据训练模型,再对新肽段进行打分。常见思路包括:
- 已知结合肽与非结合肽的模式学习。
- 基于序列特征的概率建模。
- 结合亲和力和处理偏好的综合评分。
这类方法的优势是快,适合高通量筛选。局限是,它们依赖数据库质量。当遇到罕见等位基因或新型肽段时,准确性会下降。
4. 结果解读时最容易忽视的几个问题
4.1 不能只看一个分数
很多人拿到预测结果后,只盯着IC50或rank值。这样不够。HLA II类结合预测的结果解读,至少要同时看以下几项:
- 结合亲和力。
- 相对排名。
- 所属HLA等位基因。
- 肽段长度与核心结合区。
- 突变位点是否位于核心区。
如果突变位点不在核心结合区,即使分数不错,也未必值得优先验证。
4.2 多等位基因背景会增加复杂度
一个个体通常携带多个HLA II类等位基因。一个肽段可能对某一等位基因强结合,但对另一种完全不结合。因此,分析时不能只看单个等位基因,而要结合患者整体HLA背景进行判断。
在实际项目中,常见策略是优先筛选“多个等位基因都可能结合”的候选肽。这样更有利于提高命中率。
4.3 预测结果必须回到生物学语境
不是所有高分肽都适合作为候选抗原。还要看:
- 突变是否真实表达。
- 蛋白是否有足够丰度。
- 是否存在剪接异常或转录本偏差。
- 是否位于更容易加工的蛋白区域。
脱离表达和加工背景,只看结合分数,结论往往不稳。
5. 从序列到机制,如何建立更完整的分析框架
5.1 先做候选肽提取,再做优先级排序
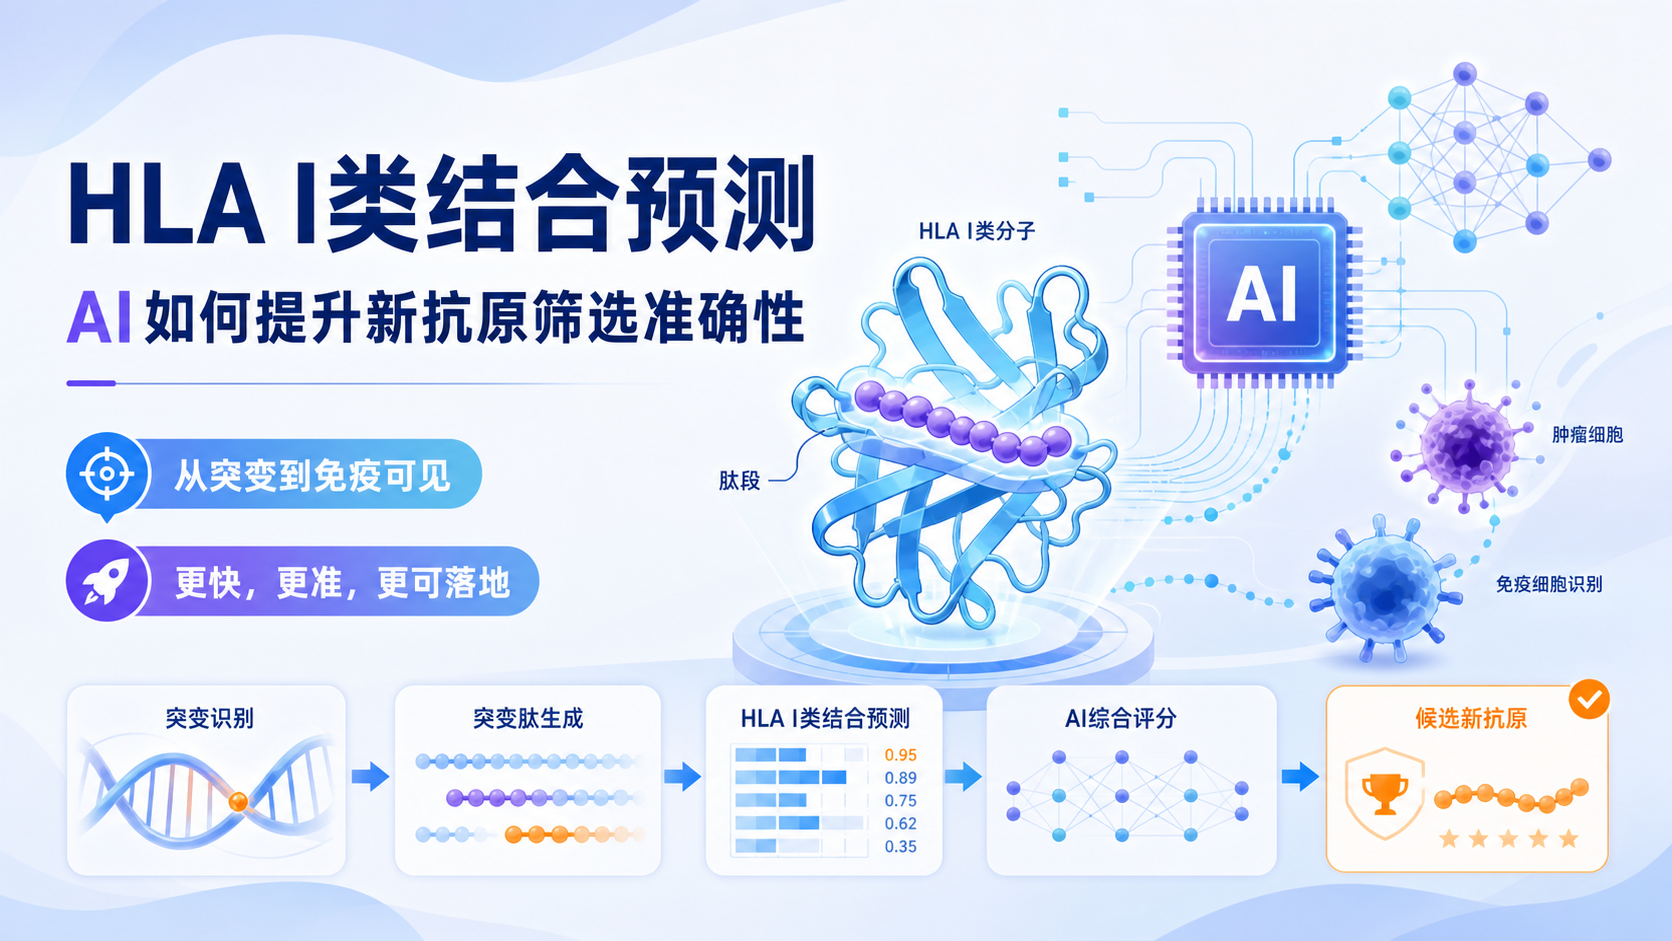
标准流程通常是:
- 从VCF中提取体细胞突变。
- 结合RNA数据确认表达。
- 生成变异肽段序列。
- 输入患者HLA II类分型结果。
- 进行结合预测和排序。
- 进入实验验证。
这个流程看似简单,但每一步都影响最终结果。真正高质量的分析,不是把所有工具都跑一遍,而是建立一个可解释的优先级体系。
5.2 机制层面要回答三个问题
如果想把预测结果写进论文或课题设计,建议至少回答三个问题:
- 这个突变是否会产生新的肽段。
- 这个肽段是否能被HLA II类分子稳定结合。
- 这个复合物是否可能引发CD4+ T细胞反应。
这三个问题连在一起,才构成完整机制链条。单独一个“高亲和力”并不够。
5.3 实验验证要围绕预测结果设计
常见验证方向包括:
- 合成肽结合实验。
- 体外T细胞刺激实验。
- ELISpot或流式检测。
- 免疫原性验证。
如果前期预测质量高,实验就更聚焦,成本也更可控。HLA II类结合预测的真正价值,不只是算分,而是为实验提供明确方向。
6. 研究中如何提高HLA II类结合预测的可靠性
6.1 选对工具比盲目堆工具更重要
不同软件在准确性、速度、适用数据类型和HLA覆盖范围上差异很大。对于科研人员来说,最重要的是明确你的输入数据是什么,输出要服务于什么问题。
- RNA-seq项目,优先考虑适用于转录组的工具。
- WES或WGS项目,先确保分型准确。
- 如果目标是肿瘤新抗原,优先关注可解释性和文献支持。
6.2 结果要结合文献和已知机制
对HLA II类结合预测而言,结果不是孤立数字。要结合已有免疫学知识、肿瘤类型、突变背景和样本来源综合判断。尤其在新抗原研究中,“预测命中”不等于“临床有效” ,这一步必须保持严谨。
6.3 工具链要尽量标准化
研究中最常见的问题,不是没有数据,而是流程不统一。输入格式、版本差异、HLA命名规范、参数设置,都会影响结果可重复性。建议在课题组层面建立标准流程,减少人工干预。
如果你希望更快搭建可复用的分析流程,解螺旋可以帮助整理从分型、突变筛选到结合预测的完整链路,减少重复试错,把时间留给真正的机制验证。
总结Conclusion
HLAII类结合预测的意义,不只是筛出几个分数高的肽段,而是把序列信息转化为可验证的免疫机制线索。它依赖准确的HLA分型、可靠的突变表达信息和合理的结果解读。只有把预测、表达和机制三者连起来,候选新抗原才真正有研究价值。
如果你正在做肿瘤新抗原、免疫治疗或HLA相关项目,建议尽早建立标准化分析流程。需要更高效地推进分型和预测工作,可以关注解螺旋 ,把复杂流程交给更稳妥的工具链。
- 引言Introduction
- 1. HLA II类结合预测为什么重要
- 2. HLA II类结合预测依赖哪些基础数据
- 3. HLA II类结合预测的核心原理
- 4. 结果解读时最容易忽视的几个问题
- 5. 从序列到机制,如何建立更完整的分析框架
- 6. 研究中如何提高HLA II类结合预测的可靠性
- 总结Conclusion