

 12
 分享

引言Introduction
疾病通路分析常见的问题,不是数据不够,而是分析套路不清、步骤不统一、结果难复现 。对医学生、医生和科研人员来说,最耗时的往往不是作图,而是从海量通路中快速定位、整理并形成可执行的分析路径。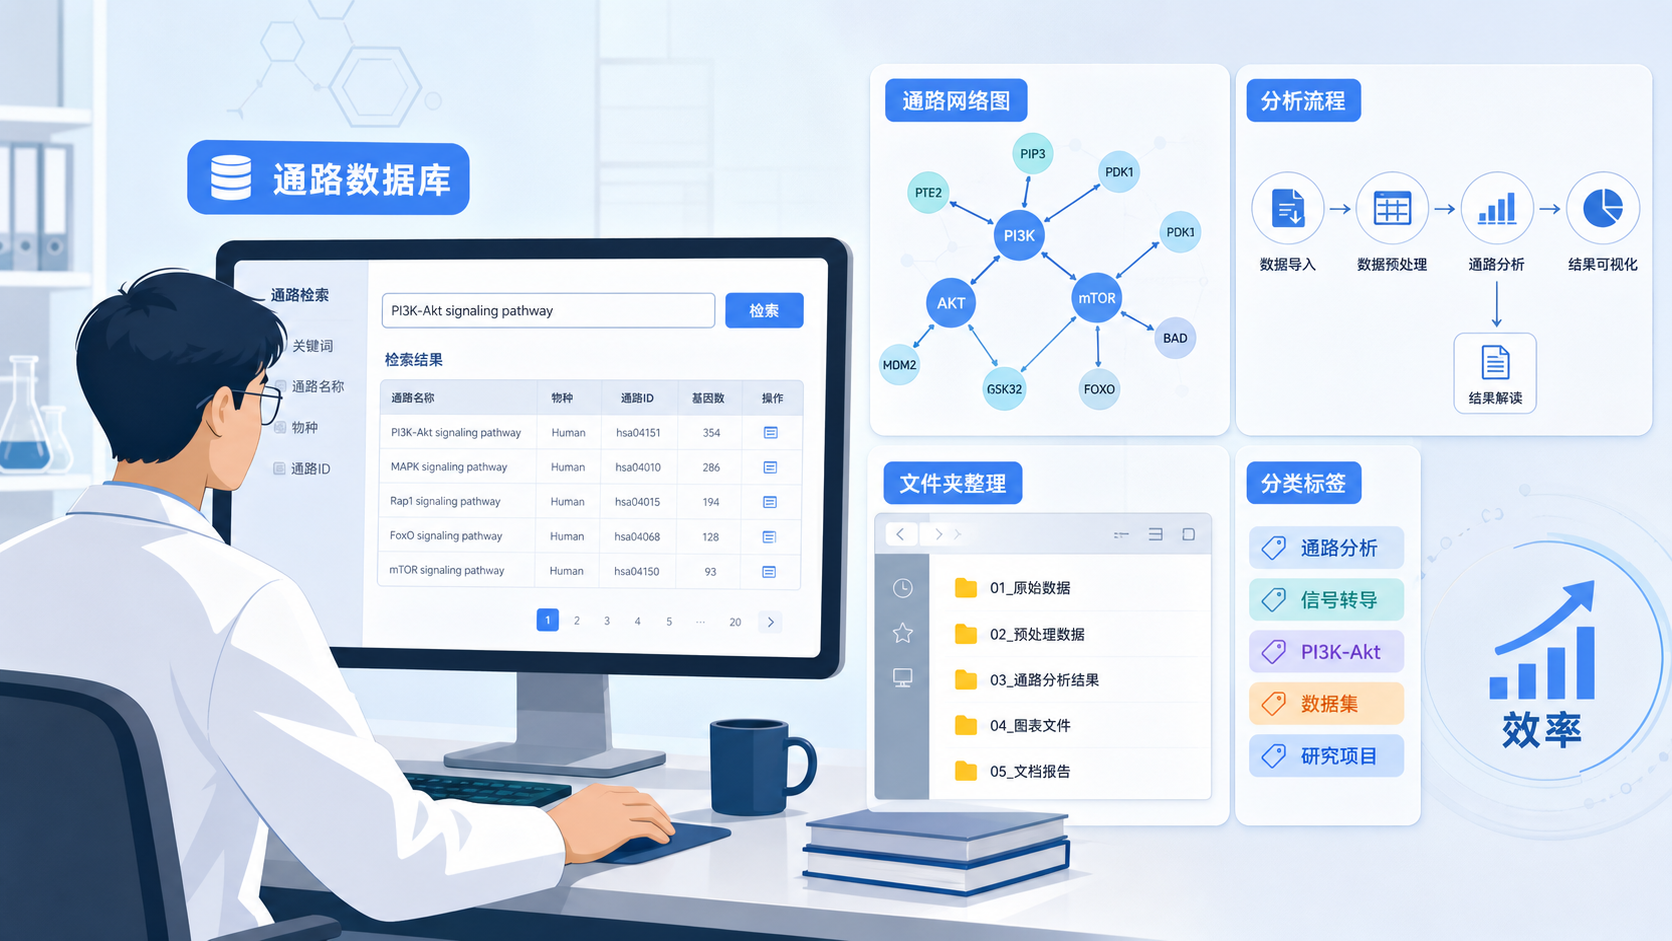
1. 为什么疾病通路分析总卡在“套路”这一步
1.1 通路分析难,不在“会不会查”,而在“怎么组织”
疾病通路研究本质上是在回答一个问题。某个疾病表型背后,哪些通路在驱动,哪些分子在连接,哪些结果适合展示。
但现实中,很多人会陷入两类困境。第一,数据库查了很多,却不知道该优先看哪条通路。第二,找到了通路,却不知道后续该做哪些图、哪些分析。
这也是为什么初学者常常“看懂了单张图,却拼不出完整故事”。通路分析不是单点检索,而是一个链条。通常包括:
- 疾病或表型定义。
- 核心通路筛选。
- 关键分子梳理。
- 数据映射与可视化。
- 结果整合与复现。
真正有价值的不是某一张图,而是一整套可复制的分析模板。
1.2 传统做法的问题,是每一步都要重新开始
很多研究者在做通路分析时,会反复经历同样的动作。先找文献,再查数据库,再人工整理通路,再手动筛图。这个过程并不低效在“操作”,而低效在“重复”。
尤其当研究对象换成不同疾病时,原有经验常常不能直接迁移。比如肿瘤、炎症、代谢病,通路选择逻辑不同,展示重点也不同。若没有固定套路,就会出现:
- 图做了很多,但彼此之间没有逻辑衔接。
- 结果能展示,但难以形成研究框架。
- 后续复现时,步骤依赖个人记忆,稳定性差。
因此,通路分析的核心能力,不只是查数据库,而是提炼分析套路。
2. WikiPathways能解决什么,不能解决什么
2.1 WikiPathways的优势,是开放、可下载、适合快速定位
WikiPathways是一个开放式协同平台,面向生物学模型的收集、传播与可视化。它的一个明显优势是通路页面结构清晰,支持图解、描述、引用、下载、版本历史以及成分基因和蛋白列表 。
对于需要快速了解疾病相关通路的人来说,这类结构非常友好。
从学习和研究角度看,WikiPathways适合做三件事:
- 快速浏览通路全貌。
- 对照基因或蛋白列表。
- 下载通路图用于后续分析或汇报。
资料中提到,WikiPathways收录了超过20个物种的通路 ,并包含超过1000个代谢产物通路 。这意味着它并不只是“能看图”,而是可以作为初步通路检索和可视化的入口。
2.2 但WikiPathways本身,不负责替你形成分析方案
需要客观看待的是,数据库本身提供的是资源,不是结论。
它能告诉你某条通路长什么样,涉及哪些基因,能否下载,但它不会自动告诉你:
- 这篇疾病研究最应该优先分析哪条通路。
- 哪些图适合组成文章逻辑。
- 哪些步骤可作为标准化模板复现。
换句话说,WikiPathways擅长“提供通路材料”,不擅长“自动生成研究套路”。
这正是很多人卡住的地方。素材有了,结构没有。
2.3 为什么疾病通路研究需要“图谱思维”
疾病通路分析不是单纯找一个pathway名称,而是把疾病表型、信号分子、上下游关系和功能结果串起来。
一个成熟的分析框架,通常至少要回答以下问题:
- 疾病核心异常是什么。
- 哪条通路最可能参与。
- 关键节点有哪些。
- 这些节点在数据中是否可验证。
- 最终如何落到机制图或功能模型。
如果没有图谱思维,数据库检索再多,也只是零散信息。
3. WorkBuddy如何把通路分析变成可执行流程
3.1 WorkBuddy的价值,是把经验固化成skill
在通路分析场景里,WorkBuddy的优势不在“替代思考”,而在于把已有分析思路固化为可调用的skill 。
这意味着,一旦你把套路定义清楚,就可以让系统按同一套逻辑反复执行,而不是每次从头整理。
这一点对科研非常关键。因为疾病通路分析最怕两件事:
- 每次项目都重新设计流程。
- 团队成员之间步骤不一致,结果无法横向比较。
有了work flow 思维,研究就更接近“标准化生产”。同类项目可以沿用同一个分析框架,只替换疾病名称、数据集和关注通路。
3.2 标准化套路,通常包含哪些环节
如果把疾病通路分析拆成一个可复用流程,常见结构可以是:
- 输入疾病名称或表型。
- 筛选相关通路。
- 识别候选核心基因。
- 生成通路图和分析图。
- 整理输出文件夹。
- 保留可复现的分析记录。
这种流程的好处很直接。它把“人脑中的经验”变成“机器可执行的步骤”。
对于做论文复现、课题预实验、基金准备的人来说,这比单次作图更重要。
3.3 为什么这类方式更适合团队协作
科研不是个人作战。一个课题常常涉及不同成员,不同人负责数据处理、通路注释、图形整理和结果撰写。
如果没有统一套路,最常见的问题就是:
- 同一疾病在不同人手里输出格式不统一。
- 图的风格不一致,难以合并成整篇文章。
- 新成员上手慢,培训成本高。
而当WorkBuddy把分析套路固化后,团队就能围绕同一个模板工作。这会显著降低沟通成本,也更利于后期扩展。
4. 用WikiPathways抓取分析套路,关键看哪些步骤
4.1 先明确疾病,再看通路,不要反过来
很多人习惯先看通路,再决定能不能套到疾病上。这样容易跑偏。更稳妥的方式是,先定义疾病表型,再从WikiPathways中筛选相关通路。
原因很简单,疾病研究的逻辑是“问题导向”,不是“通路导向”。
建议按以下顺序执行:
- 明确疾病名称和研究表型。
- 浏览对应通路分类。
- 结合基因列表和注释信息筛选。
- 下载通路图进行二次整理。
- 形成自己的通路分析框架。
先疾病,后通路,最后才是图。
这个顺序更接近真实的论文写作逻辑。
4.2 利用通路页面信息,快速判断是否值得深入
WikiPathways的通路页面通常能提供图解、描述、引用和成分列表。对于初筛来说,这些信息足够判断一条通路值不值得继续深入。
重点看三项:
- 通路与疾病是否匹配。
- 关键基因是否集中。
- 图是否适合后续展示。
如果一条通路只有名称相关,但基因关系松散,通常不适合作为核心分析主线。
相反,如果通路中已经能看到较清晰的节点结构,且与疾病表型对应明显,就适合进入下一步。
4.3 将“筛选通路”转化为“分析模板”
真正高效的做法,不是每次重新理解数据库,而是把筛选逻辑保存下来。
例如可以固定记录:
- 疾病类别。
- 候选通路名称。
- 关键节点。
- 下载图类型。
- 后续验证方式。
这样下次遇到同类疾病,直接调用已有模板即可。这就是从“找图”升级到“建套路”。
5. WorkBuddy+WikiPathways的组合,适合什么研究场景
5.1 适合通路初筛、机制整理和课题预演
这个组合最适合三类工作。
第一,通路初筛 ,快速从疾病名称定位候选通路。
第二,机制整理 ,把分散的文献线索整理成一条主线。
第三,课题预演 ,在正式实验前先搭建分析框架。
对于医学生和科研人员来说,这种组合的价值在于提高前期效率。它并不取代实验,也不替代文献阅读,而是帮助你更快进入“有结构的思考”。
5.2 适合需要复现和规范输出的项目
如果你的项目涉及多次重复分析,或者需要在不同疾病间保持统一风格,标准化流程尤其重要。
例如同一类癌症、炎症或代谢研究,可以使用近似的分析骨架,只替换输入对象和通路列表。
这类场景下,WorkBuddy更像一个执行器,WikiPathways更像一个资源池。两者结合后,研究者得到的是:
- 更快的筛选速度。
- 更稳定的输出格式。
- 更强的复现性。
5.3 对文章、汇报和基金都更友好
好的通路分析,不只是给自己看。
它最终要服务论文、答辩、课题汇报和基金申请。一个逻辑清楚、步骤标准、图形统一的流程,会直接提升表达质量。
在评审视角里,结构清楚往往比信息堆砌更重要。
因为结构清楚意味着你的研究问题明确,方法有依据,结果可复现。
6. 结论:把通路资源变成可复用的研究能力
6.1 总结核心逻辑
疾病通路分析的难点,不在数据库不够,而在于缺少稳定的分析套路 。
WikiPathways可以提供开放、可下载、信息完整的通路资源。WorkBuddy则更适合把这些经验整理为可执行的skill,帮助研究者把分析过程标准化、模块化、可复现化。
当通路资源和分析套路结合,疾病机制研究的效率会明显提升。
这对医学生、医生和科研人员都很关键,尤其适合需要快速产出、反复验证和规范展示的项目。
6.2 如果你希望把通路分析做成稳定流程,可以借助解螺旋
如果你的痛点是反复查库、重复整理、结果难复现,那么更适合把分析过程交给标准化工具去承接。通过解螺旋,你可以更高效地把疾病通路分析整理成可调用、可复现、可输出的研究流程。
这能帮助你少走弯路,更快把数据库资源转化为论文思路和汇报结果。
- 引言Introduction
- 1. 为什么疾病通路分析总卡在“套路”这一步
- 2. WikiPathways能解决什么,不能解决什么
- 3. WorkBuddy如何把通路分析变成可执行流程
- 4. 用WikiPathways抓取分析套路,关键看哪些步骤
- 5. WorkBuddy+WikiPathways的组合,适合什么研究场景
- 6. 结论:把通路资源变成可复用的研究能力